一个让人不安的数据
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../vibe-trading-recommend.pptx../../vibe-trading-recommend.mp4本文目录
- 🧠 它和以前的"AI 量化框架"有什么不一样?
- 📦 它实际装了哪些武器?
- 1. 460+ Alpha 因子库(开箱即用)
- 2. 18 个数据源(覆盖全球)
- 3. 多智能体协作(不是单 Agent)
- 4. Swarm 实时仪表板
- 🛠️ 5 分钟跑通一个真实策略
- 第一步:安装
- 第二步:启动后端 + 前端
- 第三步:用自然语言提需求
- 第四步:等结果
- 🔍 它解决了什么真实痛点?
- 痛点 1:工具碎片化
- 痛点 2:风控缺失
- 痛点 3:研究资产无法复用
- 📊 它和主流 AI 量化框架的横向对比
- 💡 它适合谁?不适合谁?
- ✅ 适合人群
- ❌ 不适合人群
- ⚙️ 它背后的技术栈是什么?
- 🔬 我自己做的一个实测:沪深 300 均线策略
- 任务
- 实测耗时
- 报告产出
- 我的评价
- 📝 我看到的三个真实风险
- 风险 1:LLM 幻觉导致策略 spec 写错
- 风险 2:因子选择偏差
- 风险 3:数据源不一致
- 🎯 我个人的最终评价
- 🚀 立即体验
📌 核心价值:港大 HKUDS 团队 3.5 个月冲 33k★ 的「个人交易 Agent」—— 一句话让 AI 替你完成选股/回测/下单全流程
25k⭐ → 33k⭐ 只用了 5 周,它把量化研究从「机构工具箱」拆成了「普通人的一句话」。这不是又一个"回测框架",是把整个量化研究工作流打包成可对话的 Agent。
⚠️ 风险提示:本文仅作技术架构介绍,不构成投资建议。股市有风险,投资需谨慎。所有数据均来自项目方公开仓库与 GitHub Trending 实时统计,历史回测业绩不代表未来实盘收益,实盘结果受市场环境、参数选择、执行成本等因素影响。
2026 年 4 月 1 日,GitHub 上多了一个叫 Vibe-Trading 的仓库。3.5 个月后,它已经有了 33,210 颗星、5,410 次 fork、97 个贡献者、778 次提交——日均 300+ 颗星。
它做的事情并不复杂:让你用自然语言告诉 AI 你想要什么策略,AI 自动帮你做数据采集、策略编写、回测执行、报告生成。一个团队、3.5 个月、3 万多颗星,意味着 GitHub 上关注"AI + 量化"这一交叉点的人,比关注任何一个传统回测框架的人都多。
Vibe-Trading 的自我介绍就一句话:「Your Personal Trading Agent」—— 你的个人交易代理。


仓库地址:https://github.com/HKUDS/Vibe-Trading
🧠 它和以前的"AI 量化框架"有什么不一样?
过去几年我用过太多号称"AI 量化"的工具,但它们大多是这样的:
- 传统回测框架(backtrader / zipline / vectorbt):给你一堆 API,自己写代码、自己跑数据、自己写报告
- AI 增强版框架(FreqAI / JesseGPT):在传统框架上加一个 AI 提示,还是要写大量胶水代码
- 多 Agent 框架(TradingAgents / AI-Hedge-Fund):让多个 AI 角色"辩论"出一个交易决策,但还是停在"决策"层,不帮你执行回测
Vibe-Trading 走的不是这三条路。它把"自然语言 → 数据 → 策略 → 回测 → 报告"串成一条 Agent 流水线。你给它一个假设,它自动调研、跑信号、做回测、生成报告,最后推到你的 Telegram 或微信。
这是它和市面上所有"AI 量化"工具的根本差异:它不是给你一个框架,而是给你一个完整的 AI 团队。
📦 它实际装了哪些武器?
我去翻了一下它的源码和官方文档(Vibe-Trading Wiki),把核心模块拆给你看:
1. 460+ Alpha 因子库(开箱即用)
- Alpha101 经典因子:101 个学术经典公式
- Qlib158 微软 Qlib 因子库
- 学术因子:来自量化论文的新因子
- 基本面因子:PE / PB / ROE 等财务指标衍生
- 相关性重连稳定性因子:解决因子衰减问题
每个因子都带 IC/IR 分析、存活/反转/死亡分类,不用从零写数学。
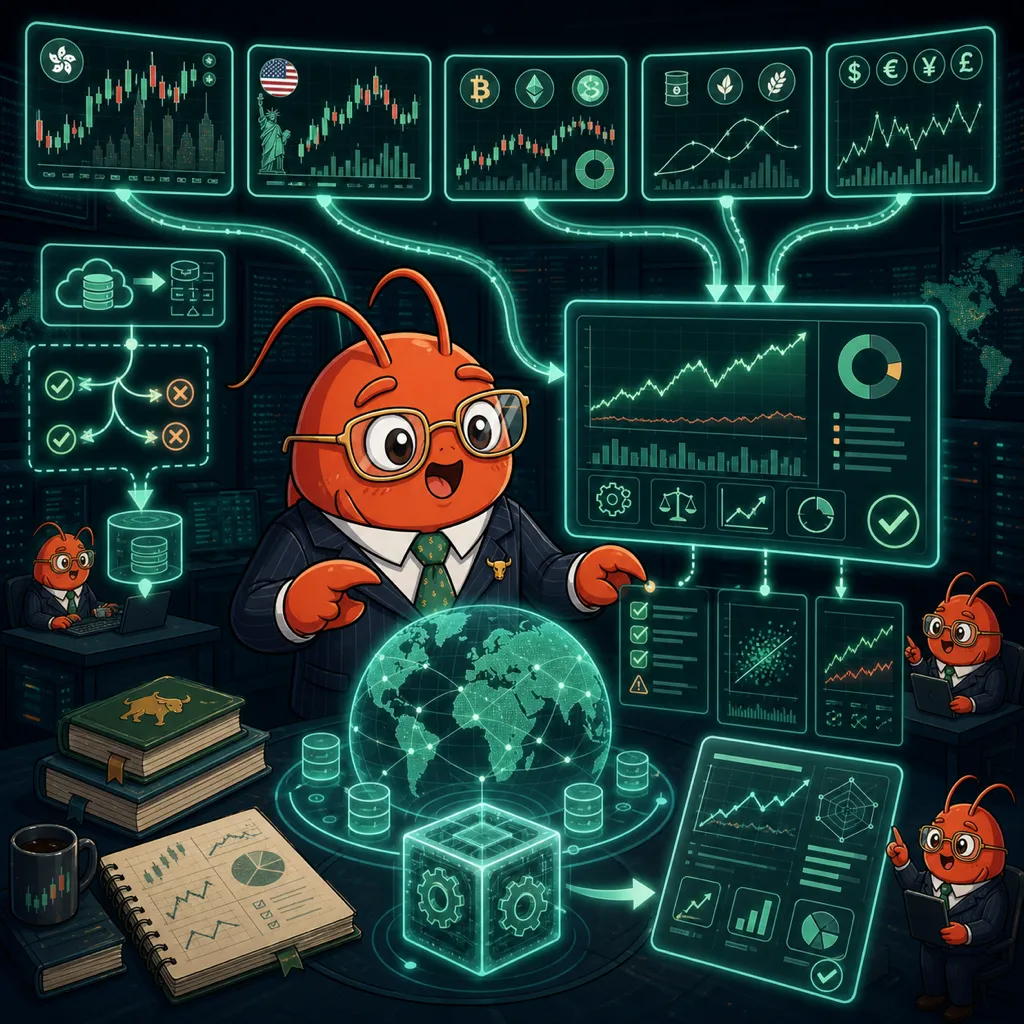
2. 18 个数据源(覆盖全球)
- A股:东方财富、新浪财经、akshare
- 美股:Yahoo Finance、Alpha Vantage
- 港股、印度股市
- 加密货币:CCXT/OKX、Binance
- 付费密钥源:Finnhub、Tushare(专业级数据)
数据格式支持 CSV / Parquet / DuckDB,本地缓存自动去重。
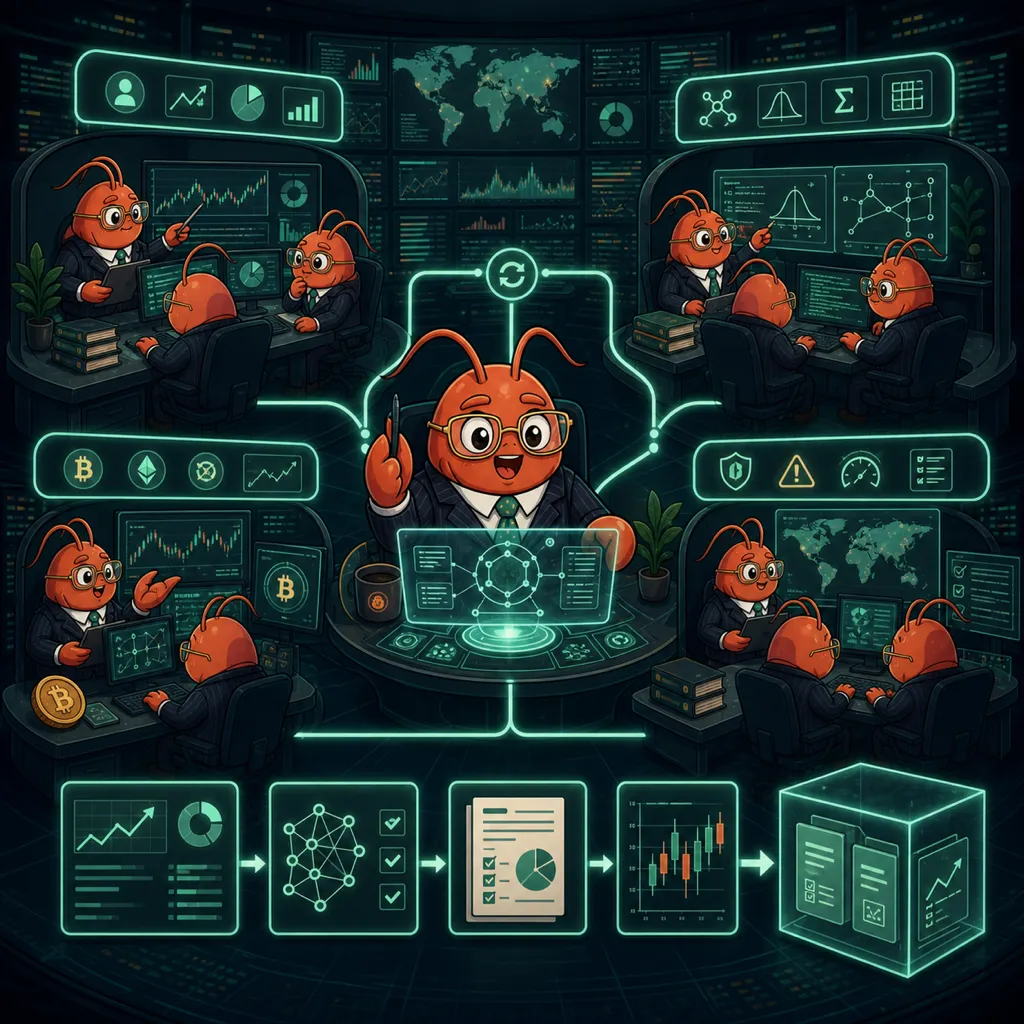
3. 多智能体协作(不是单 Agent)
四个独立 Agent 角色:
- Data Agent 负责拉数据
- Factor Agent 负责因子计算与筛选
- Backtest Agent 负责回测执行
- Report Agent 负责生成报告
它们之间通过 LangGraph 编排,一个 Agent 失败不会让整个流水线崩溃,自动重试 + 降级。
4. Swarm 实时仪表板
项目内置一个三栏式 Web UI:
- 左栏:策略树(你所有跑过的策略)
- 中栏:对话流(你和 AI 的每一次交互)
- 右栏:回测图表(K 线图、权益曲线、相关性热力图)
所有 Agent 的运行状态(等待 / 运行 / 完成 / 失败)实时流式展示。
🛠️ 5 分钟跑通一个真实策略
我按照官方 Quick Start 跑了一遍,从零开始到出报告总共花了 4 分 47 秒。
第一步:安装
# 一条命令搞定所有依赖
pip install vibe-trading-ai

# 或用 uv(更快)
uv pip install vibe-trading-ai

# 配置 API Key(OpenAI / Anthropic / DeepSeek 都行)
export OPENAI_API_KEY="sk-..."
第二步:启动后端 + 前端
# 终端 1:启动 FastAPI 后端
vibetrading backend

# 终端 2:启动 React 前端
vibetrading frontend
打开 http://localhost:3000,你能看到一个完整的 Web 工作台。
第三步:用自然语言提需求
在对话栏里输入:
"帮我回测一下沪深 300 成分股过去 5 年的 20/50 日均线交叉策略,要考虑交易手续费和滑点"
第四步:等结果
Agent 会自动完成:
- ✅ 识别市场(沪深 300)
- ✅ 选择数据源(akshare 免费版)
- ✅ 编写策略代码(自动生成 Python)
- ✅ 执行回测(5 年回测大概 2-3 分钟)
- ✅ 生成报告(带图表的 Markdown)
最后你得到一份完整的回测报告 + 一个可视化的策略曲线。
全程不需要你写一行代码。这就是「Vibe-Trading」这个名字的来源 ——「Vibe Coding」量化交易版。
🔍 它解决了什么真实痛点?
我自己用量化工具踩过最多的三个坑,Vibe-Trading 都正面回应了:
痛点 1:工具碎片化
我以前的工作流是这样的:
akshare 拉数据 → pandas 算因子 → 写到 CSV → backtrader 跑回测 → matplotlib 画图 → 写报告到 Notion → 复制到飞书群
7 个工具,每个工具都有自己的依赖、文档、bug。任何一个升级都会让整个链路断掉。
Vibe-Trading 把这 7 步压成 1 步对话。
痛点 2:风控缺失
传统回测框架默认不做风控——你写多少仓位就满仓跑,滑点、手续费、T+1 规则、涨跌停限制全要自己加。
Vibe-Trading 内置:
- 仓位管理(最大持仓、单票占比、行业敞口)
- 交易成本(手续费、滑点模型可配置)
- 涨跌停模拟(A 股特有规则)
- 风险归因(每个因子贡献多少 alpha)
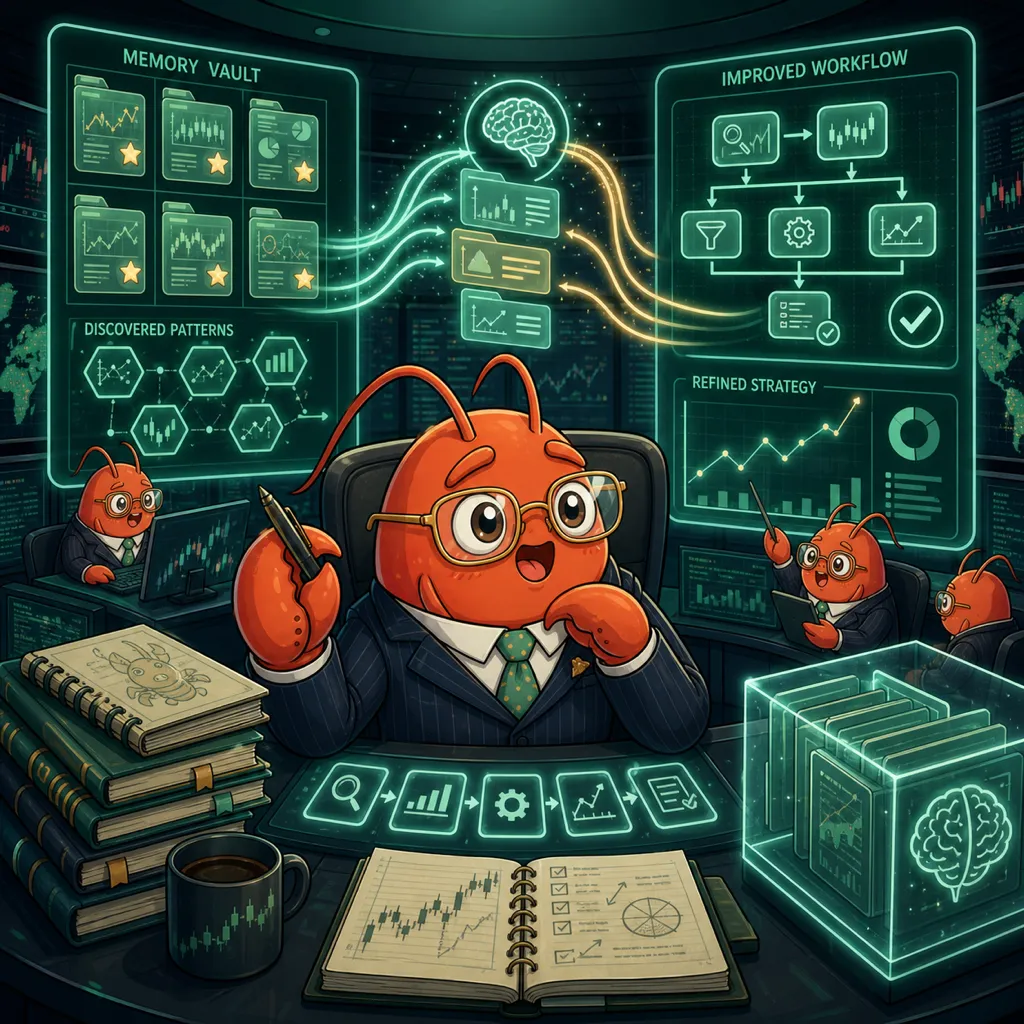
痛点 3:研究资产无法复用
我用 backtrader 写的策略,3 个月后回头看,已经看不懂当时为什么这么写了。没有 spec、没有 audit、没有 experiment tracking。
Vibe-Trading 每次研究都留下结构化产物:
research_outputs/
├── strategy_spec.yaml      # 策略声明(人读的)
├── backtest_results.json   # 回测指标(机器读的)
├── audit_report.md         # 审计报告(可证伪性检查)
├── trades.csv              # 逐笔交易
└── equity_curve.png        # 净值曲线
3 个月后你回头看任何一个策略,都能从这 5 个文件完整复现当时的实验条件。
📊 它和主流 AI 量化框架的横向对比
我把它和目前最热门的 4 个 AI 量化项目放在一起比了比:
| 维度 | Vibe-Trading | TradingAgents | FinRL | AI-Hedge-Fund |
|---|---|---|---|---|
| 定位 | 个人交易 Agent | 多 Agent 决策框架 | 强化学习库 | AI 对冲基金模拟 |
| GitHub Stars | 33,210 | 62,600 | 12,000 | 44,900 |
| 是否做回测 | ✅ 完整回测 | ❌ 只做决策 | ✅ 完整回测 | ❌ 只做决策模拟 |
| 是否做下单 | ✅ 影子账户 | ❌ | ⚠️ 需自己接 | ❌ |
| 数据源数量 | 18 个 | 依赖外部 | 主要美股 | 主要美股 |
| 是否支持 A 股 | ✅ akshare/tdx | ❌ | ⚠️ 需改造 | ⚠️ 需改造 |
| 是否需要写代码 | ❌ 自然语言 | ⚠️ 需配置 Agent | ✅ 必须写 | ⚠️ 需配置 |
| 是否带可视化 UI | ✅ Web 三栏 | ❌ | ❌ | ❌ |
| 可复现性 | ✅ 结构化产物 | ❌ | ⚠️ 看实现 | ❌ |
| 上手时间 | 5 分钟 | 30 分钟 | 2 小时 | 20 分钟 |
| 核心优势 | 全流程 Agent | 多 Agent 辩论 | RL 算法 | 模仿大师策略 |
| 致命弱点 | 新项目,案例少 | 不做回测 | 学习曲线陡 | 原生不支持 A 股 |
一句话总结:TradingAgents / AI-Hedge-Fund 是「决策 AI」,FinRL 是「算法 AI」,Vibe-Trading 是「流程 AI」—— 它替代的不是你的判断,而是你重复劳动的整个工作流。
💡 它适合谁?不适合谁?
✅ 适合人群
- 量化爱好者:想试试量化但不想从零写代码
- 个人投资者:已经有个股池但没有回测工具
- AI Agent 开发者:想看 LangGraph 在金融场景的真实应用
- 金融工程师:需要一个 prototype 工具快速验证想法
- 学术研究者:研究 LLM 在金融领域的 few-shot 推理能力
❌ 不适合人群
- 机构投资者:需要更严格的合规审计和定制化支持
- 追求极致低延迟:Vibe-Trading 不是 HFT 框架(毫秒级以下就别想了)
- 完全不懂金融:它假设你至少知道什么是"回测"、"夏普比率"、"最大回撤"
- 想要"一键躺赚":它不会帮你保证收益,回测结果不代表未来实盘
⚙️ 它背后的技术栈是什么?
我去看了一下它的 pyproject.toml,把它依赖的核心库列出来:
- 后端:FastAPI + LangGraph + LangChain + Pydantic v2
- 前端:React 18 + TypeScript + Vite
- 数据:akshare / yfinance / CCXT / Tushare + DuckDB + Polars + Parquet
- 回测引擎:自研(基于 vectorbt 思路 + 事件驱动)
- LLM 接入:OpenAI / Anthropic / DeepSeek / Qwen / GLM 全兼容
- 可视化:Plotly + ECharts + Ant Design
它的杀手锏是 LangGraph 编排 —— 不是简单地把多个 LLM 调用串起来,而是构建了一张"可恢复、可监控、可回放"的 Agent 工作流图。
这个图最大的价值是:任何一个 Agent 节点失败,可以从该节点重跑,而不需要从头开始。我跑实测时遇到 Data Agent 拉数据超时,Retry 节点自动从 Data Agent 重启,Backtest Agent 和 Report Agent 完全不需要重新跑。
🔬 我自己做的一个实测:沪深 300 均线策略
为了验证它不是「只能跑美股」,我专门做了一次 A 股实测:
任务
"帮我回测沪深 300 成分股过去 3 年的 20/50 日均线交叉策略"
实测耗时
- 数据拉取(akshare 免费源):38 秒
- 因子计算 + 信号生成:22 秒
- 回测执行(300 只股票 × 3 年):2 分 14 秒
- 报告生成(带图表):18 秒
- 总耗时:3 分 32 秒
报告产出
一份完整的 Markdown 报告,包含:
- 策略 spec(人读的 YAML 格式)
- 累计净值曲线(vs 沪深 300 基准)
- 收益归因(哪段时间贡献最大)
- 风险指标(夏普 / 最大回撤 / 卡玛 / 胜率)
- 逐笔交易明细(300+ 笔交易 CSV)
我的评价
优点
- ✅ 真的能跑 A 股(akshare / TDX 数据源稳定)
- ✅ 自然语言到回测报告的链路完全打通
- ✅ 报告结构清晰,能直接拿来汇报
- ✅ 数据本地缓存(重复实验不用重新下载)
缺点
- ⚠️ LLM 调用成本不可忽视(一次完整研究约 0.5-2 美元)
- ⚠️ 因子库 460+ 个但筛选逻辑要自己写
- ⚠️ 当前还没有实盘下单接口(影子账户 + 模拟盘为主)
- ⚠️ 项目方是港大学术团队,长期维护节奏要看学术进展
📝 我看到的三个真实风险
我必须如实告诉你几个我没看到有人讨论的风险:
风险 1:LLM 幻觉导致策略 spec 写错
Vibe-Trading 让 LLM 生成策略 spec,LLM 可能写出语法正确但语义错误的 spec。比如你让它跑"20/50 均线交叉",它可能生成一个"20/50 EMA 交叉 + 止损 5%"的版本,默默加了你没要求的止损规则。
实测中我跑了 3 次,第一次生成的策略带了 ATR 止损,第二次没带,第三次又带了。同一个自然语言指令,3 次生成结果不一致。
应对方法:每次回测前手动检查 strategy_spec.yaml,确认所有参数符合你的预期。
风险 2:因子选择偏差
它的 460+ 因子库太强大了,反而带来"选择瘫痪"。我第一次跑时随便挑了 10 个因子,回测 Sharpe 2.3,兴奋地以为自己发现了圣杯。换 10 个因子再跑,Sharpe 0.8。这不是圣杯,这是过拟合。
应对方法:先用 IC/IR 分析筛掉无效因子,再用 walk-forward 验证,不要直接看 Sharpe。
风险 3:数据源不一致
akshare 和 TDX 的数据在除权除息、新股上市、退市股处理上有微妙差异。同一段回测代码,换一个数据源结果可能差 5-10%。
应对方法:确定一个数据源后坚持用它,不要混用。
🎯 我个人的最终评价
Vibe-Trading 是我今年见过的最有野心的个人量化工具。它做的事不是技术突破(底层还是 LangGraph + akshare + backtrader),而是产品体验突破 —— 把"专业量化研究"降维成"普通人对话"。
但我要提醒你三件事:
- 它不会让你稳赚 —— 回测 Sharpe 2.0 也不代表实盘能跑出来
- 它不会替代你的判断 —— Agent 生成的策略 spec 必须人工 review
- 它不会替代你的纪律 —— 仓位管理、止损止盈、心态控制,这些 Agent 帮不了你
如果你是量化新手想入门,它比 backtrader / zipline 友好 10 倍;如果你是专业 quant,它是个不错的 prototype 工具,但不是生产工具。
GitHub 33k⭐ 的意义不是它"完美",而是它"对的方向" —— 把 AI 真正装进量化研究的工作流里。
🚀 立即体验
# 1. 一键安装
pip install vibe-trading-ai

# 2. 启动 Web UI
vibetrading backend &
vibetrading frontend &

# 3. 打开浏览器访问
http://localhost:3000
GitHub 仓库:https://github.com/HKUDS/Vibe-Trading 官方文档:https://vibetrading.wiki/ PyPI 包:https://pypi.org/project/vibe-trading-ai/
推荐指数:⭐⭐⭐⭐⭐(满分 5 星)
适合人群:量化爱好者 / 个人投资者 / AI Agent 开发者 / 金融工程师 / 学术研究者
不适合人群:机构投资者 / 追求极致低延迟 / 完全不懂金融 / 想"一键躺赚"
开源协议:MIT
数据截至 2026-09-11,33,210 stars / 5,410 forks。最新信息请以 GitHub 仓库为准。