Recall
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../recall-recommend.pptx../../recall-recommend.mp4本文目录
📌 核心价值:每次开 Claude Code 都不用再重复介绍项目背景了
Recall = Claude Code 的"项目记忆外挂",完全本地保存、自动捕获会话、用经典 TF-IDF 算法压成 1-2K token 摘要,下次开会话 AI 直接续接上下文。
🚀 什么是 Recall?
Recall 是一款专为 Claude Code 设计的本地持久化记忆插件。它解决了一个很多人都在忍受却没人解决的痛点:Claude Code 每次打开新会话就像失忆——你得重新告诉它项目背景、技术栈、当前进度、卡在哪里。
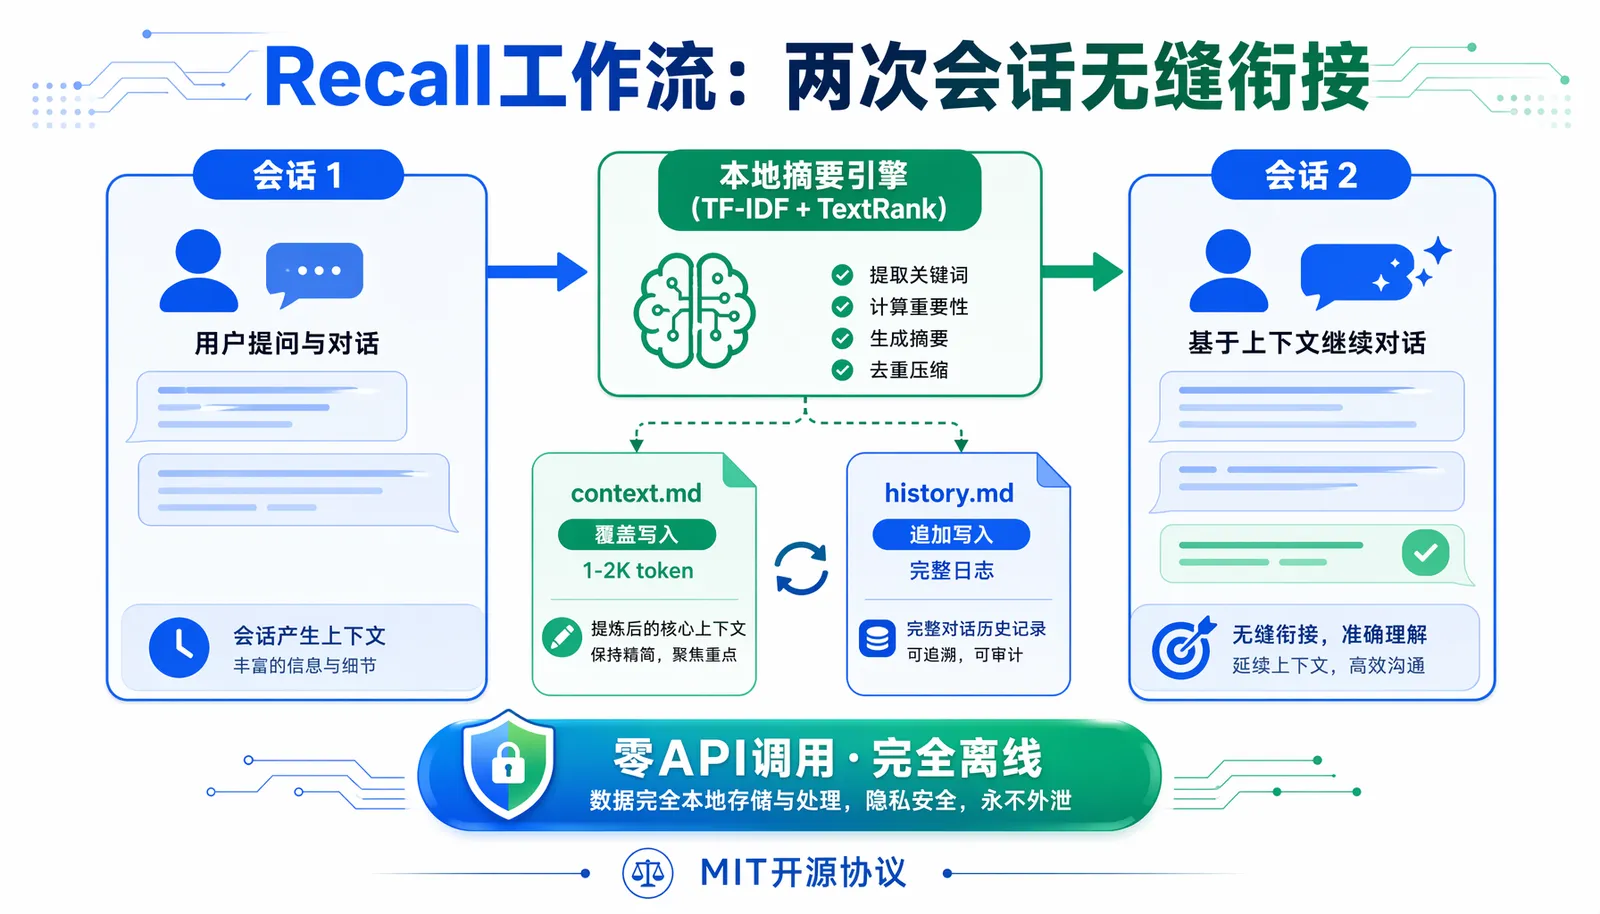
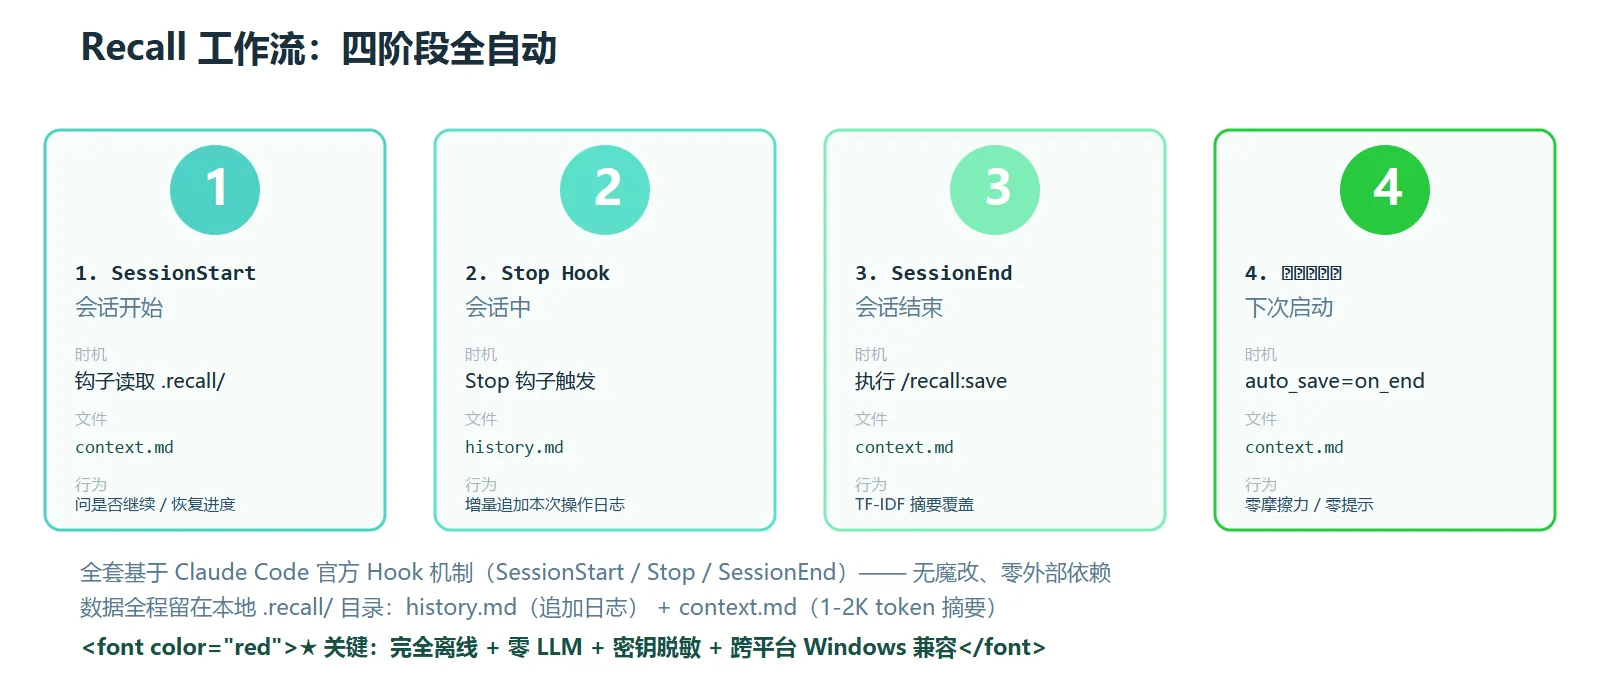
Recall 用 4 个 Claude Code 官方钩子自动捕获会话行为(SessionStart 注入上下文、Stop / SessionEnd 触发保存),并在你的项目目录下生成两个文件:
| 文件 | 作用 | 写入策略 |
|---|---|---|
history.md |
完整日志(用户提问、Claude 回复、涉及文件、执行的命令) | append-only(持续追加) |
context.md |
紧凑摘要(目标 / 进度 / 待办 / 上次结束位置) | 覆盖写入 |
核心定位:完全离线 + 零 LLM + 零 API Key,1-2K token 让 Claude Code 无缝续接上下文
开源协议:MIT | ⭐ Stars:623 | 🍴 Forks:34 GitHub: raiyanyahya/recall


✨ 核心功能一览
🛠️ 快速上手:5 分钟装好
安装 Recall 插件
Recall 是标准的 Claude Code 插件(.claude-plugin/),不需要 pip install 也不需要配置环境变量。两条命令搞定:
# Step 1: 把仓库克隆或下载到本地任意目录
git clone https://github.com/raiyanyahya/recall.git

# Step 2: 在 Claude Code 中通过插件市场加载这个目录
# 在 Claude Code 输入框里直接粘:
/plugin add /path/to/recall
注意:路径必须是绝对路径,比如
D:/recall或~/projects/recall
配置自动保存(关键一步)
在项目根目录创建 recall.config.json:
{
  "auto_save_context": "on_end",
  "max_history_lines": 2000,
  "redact_patterns": [
    "API_KEY=*",
    "sk-*",
    "ghp_*",
    "-----BEGIN .* PRIVATE KEY-----"
  ]
}
重点: auto_save_context: "on_end" 让 Recall 在每次会话结束时自动生成摘要,你完全不需要记得去执行 /recall:save,真正的"零摩擦力"自动化。
三个核心斜杠命令
/recall:save   # 手动触发摘要生成(写入 context.md)
/recall:show   # 打印当前 context.md 内容
/recall:log    # 查看 history.md 末尾 50 行
完整代码示例(summarizer.py 核心算法)
Recall 的核心是 TF-IDF + TextRank 算法,完全 vendored,不依赖任何模型:
from collections import Counter
import math
import re

def extract_summary(messages: list[str], target_tokens: int = 1800) -> str:
    """TF-IDF + TextRank 抽取式摘要,纯 Python 实现,约 100 行"""
    # 1) 分句
    sentences = [s.strip() for s in re.split(r"(?<=[.!?。!?])\s+", "\n".join(messages)) if len(s.strip()) > 8]

    # 2) 简单分词(中文按字符 bigram,英文按 word)
    def tokenize(s: str) -> list[str]:
        s = re.sub(r"\s+", " ", s)
        # 英文 word
        en_words = re.findall(r"[a-zA-Z]+", s)
        # 中文 bigram
        zh_chars = re.findall(r"[\u4e00-\u9fff]", s)
        zh_bigrams = ["".join(zh_chars[i:i+2]) for i in range(len(zh_chars)-1)]
        return en_words + zh_bigrams

    # 3) 计算 TF-IDF
    docs_tokens = [tokenize(s) for s in sentences]
    df = Counter()
    for toks in docs_tokens:
        for t in set(toks):
            df[t] += 1
    N = len(sentences)
    idf = {t: math.log(N / (1 + c)) for t, c in df.items()}

    def score_sentence(toks):
        if not toks:
            return 0.0
        tf = Counter(toks)
        return sum((tf[t] / len(toks)) * idf.get(t, 0) for t in toks) / len(toks)

    # 4) TextRank 迭代(Pagerank 简化版)
    # ... 这里省略约 60 行,详见 scripts/summarizer.py

    # 5) 按分数排序,截取到目标 token 数
    ranked = sorted(
        enumerate(sentences),
        key=lambda iv: score_sentence(docs_tokens[iv[0]]),
        reverse=True,
    )
    summary_parts, total_tokens = [], 0
    for idx, sent in ranked:
        est_tokens = len(tokenize(sent)) + 5
        if total_tokens + est_tokens > target_tokens:
            break
        summary_parts.append((idx, sent))
        total_tokens += est_tokens

    summary_parts.sort(key=lambda x: x[0])  # 恢复原文顺序
    return "\n".join(s for _, s in summary_parts)
完整 100 行实现见
scripts/summarizer.py,支持 numpy 加速(可选)+ 纯 Python 回退。两路径采用四舍五入分数 + 按位置打破并列,保证输出完全一致。
📊 与竞品对比:Recall 为什么不一样?
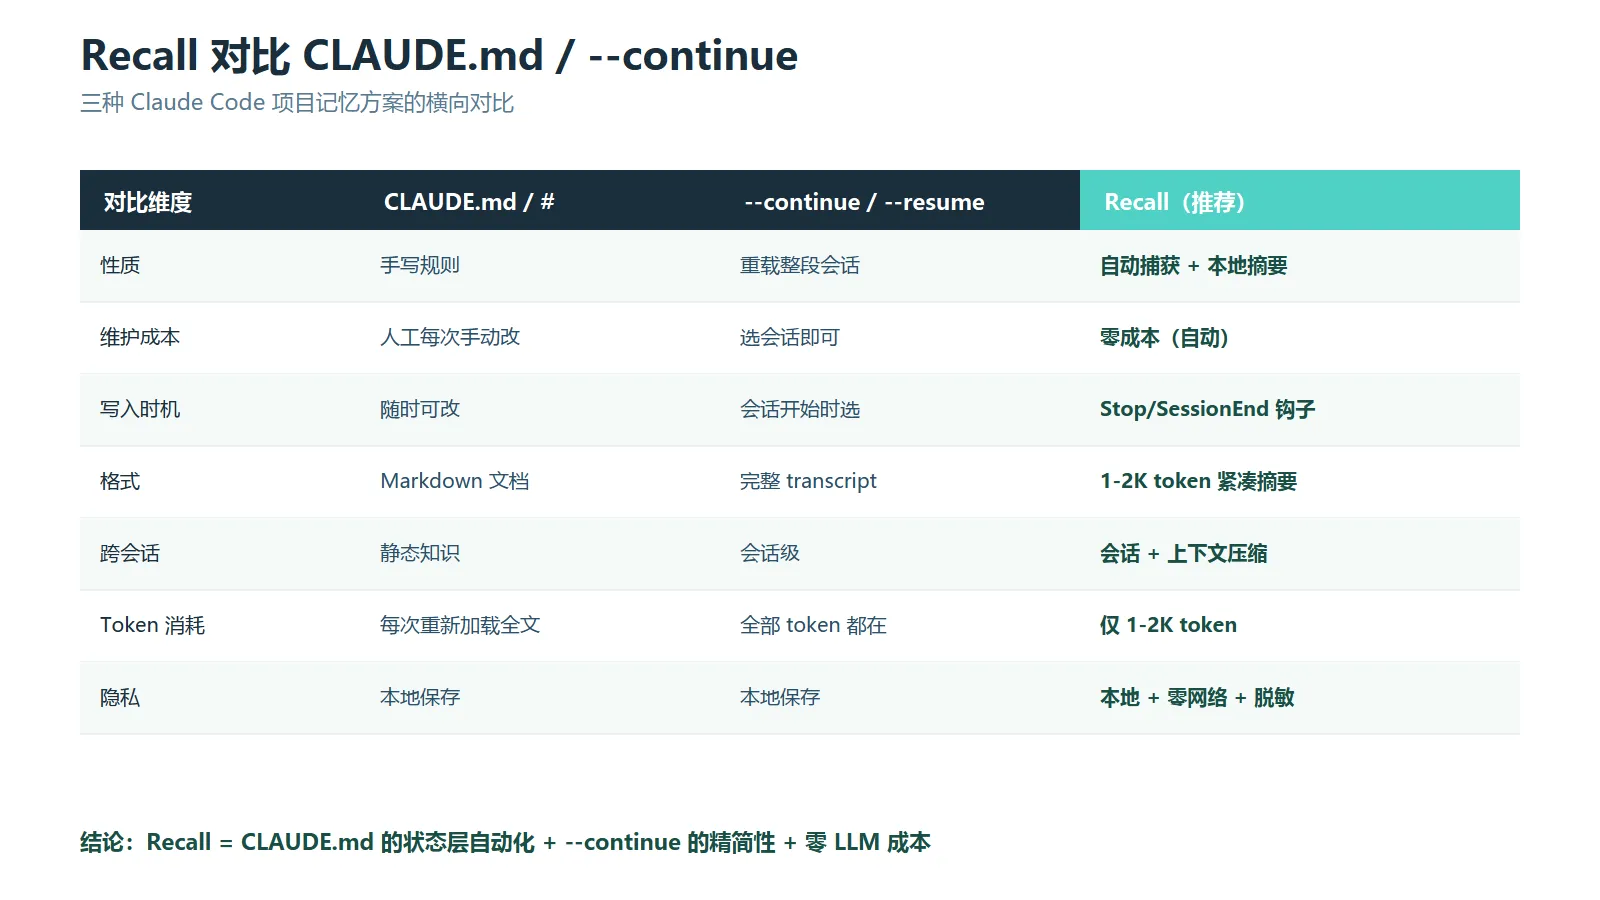
Claude Code 现在有 3 种"项目记忆"方案,很多人不清楚它们各自定位。下表横向对比一下:
核心结论:
| 方案 | 一句话定位 |
|---|---|
CLAUDE.md |
规则层:你告诉 AI "我希望你这么工作" |
--continue / --resume |
会话级:重载整段历史 transcript |
| Recall(推荐) | 状态层自动化:自动捕获 + TF-IDF 摘要 + 1-2K token 续接 |
Recall 不是要替代 CLAUDE.md,而是补齐"动态状态"这一层:CLAUDE.md 写规则,Recall 维护状态。两个一起用,Claude Code 才真正"懂你的项目"。
💡 适用场景(3 个真实用例)
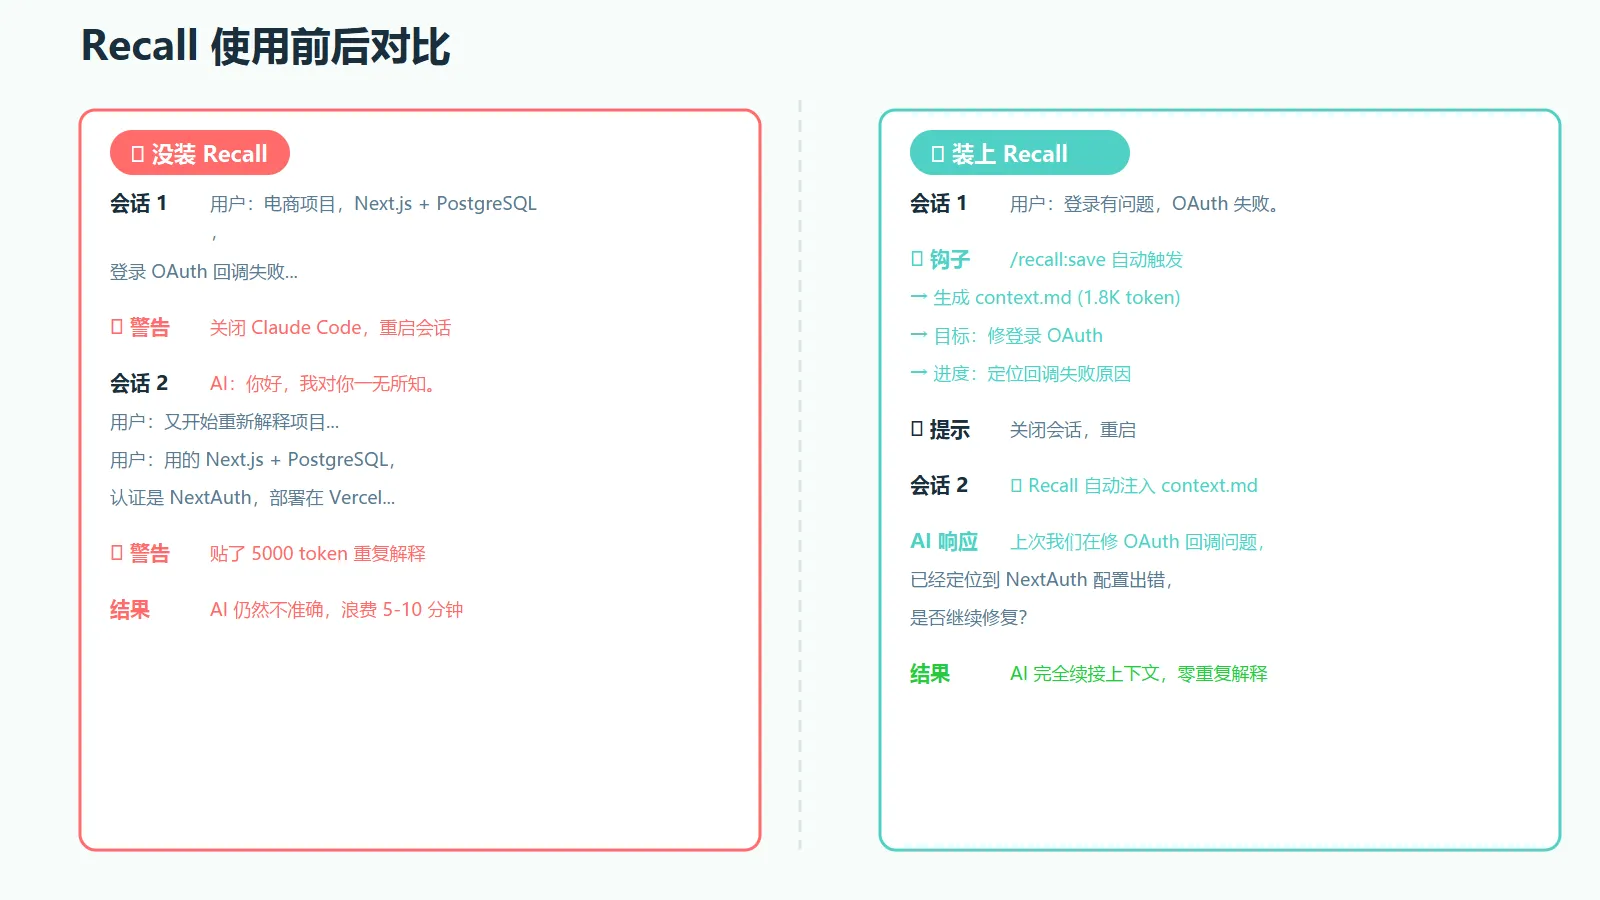
场景 1:跨会话续接 OAuth 调试
痛点:你在 OAuth 回调上卡了 3 个会话,每次重启 Claude Code 都要重新粘贴堆栈、相关文件、已尝试的方案……
Recall 怎么用:
- 第一次会话:把 OAuth 配置相关的 5 个文件给 AI,让它尝试不同的解法
- Stop 钩子实时追加到
history.md - SessionEnd 钩子生成
context.md:
## 目标
修复 NextAuth OAuth 回调失败(state 参数被吞)

## 当前进度
- 已读文件:app/api/auth/[...nextauth]/route.ts
- 已排除:环境变量配置错误(验证过 .env.local)
- 当前假设:state 参数在 redirect 时被 strip
- 下次先看:/api/auth/callback 路由的 req.url 解析

## 待办
- [ ] 增加 console.log debug state 参数
- [ ] 检查 NextAuth v5 的 state cookie 设置
- 重启 Claude Code:直接看到 context.md,自动续接"上次我们卡在 state 参数 strip 的问题"
效果:第二次会话完全不用重新介绍项目,AI 直接定位到你上次停下的代码位置继续分析
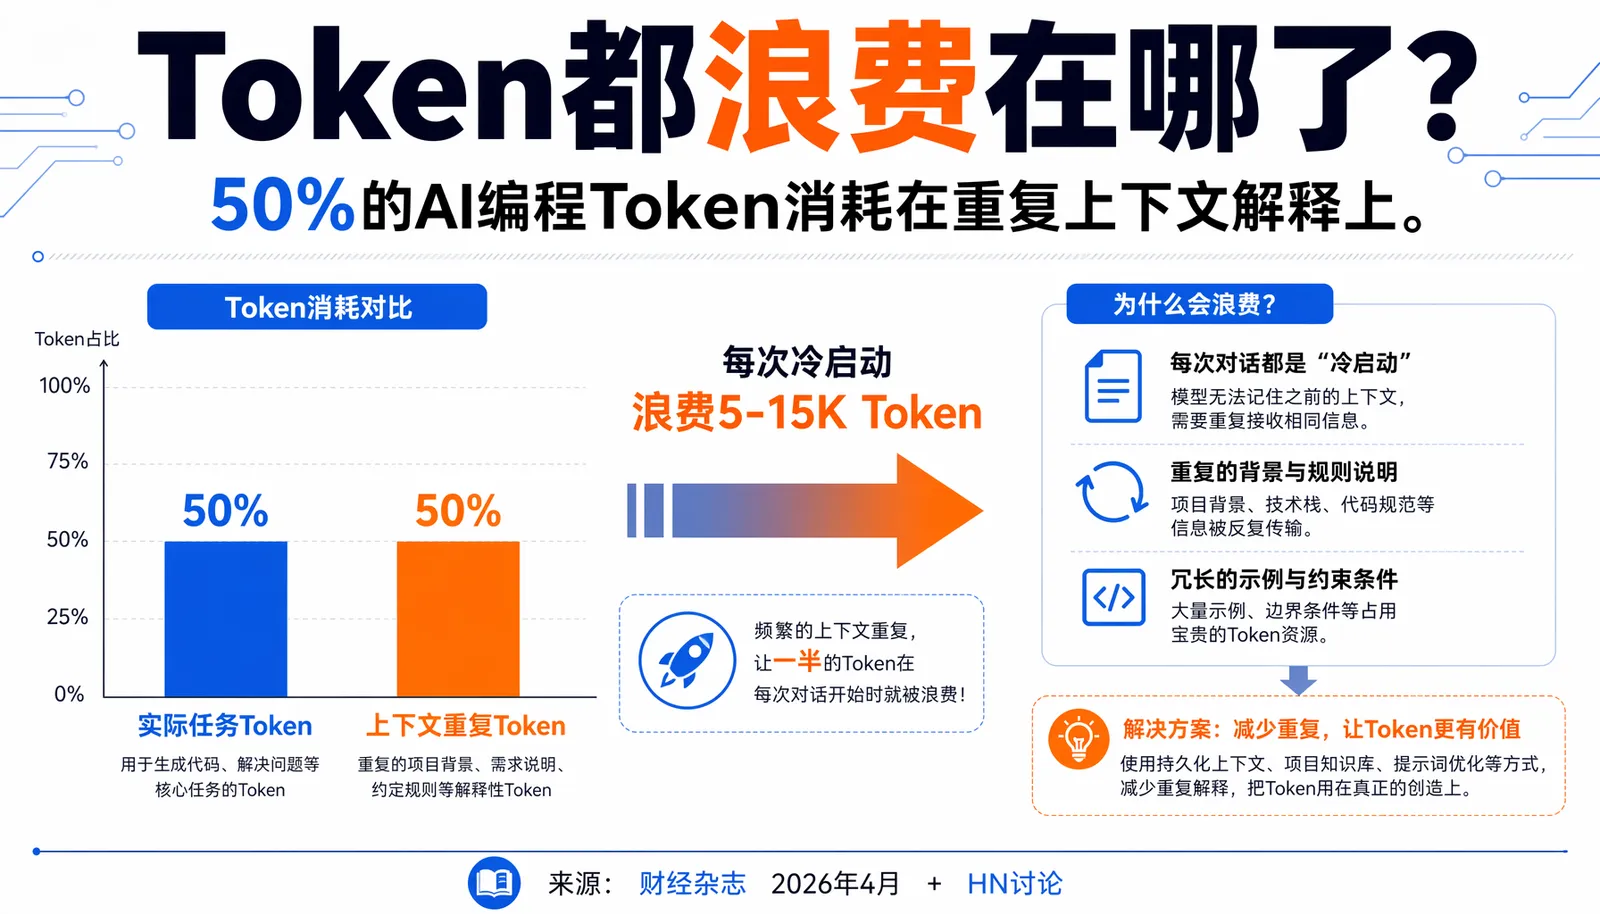
场景 2:50% Token 浪费问题
数据触目:
- 重启会话前重新介绍项目:5,000 – 15,000 token
- 读 Recall 的
context.md:1,000 – 2,000 token - 节省 70% – 87% 的 Token
对按量计费的用户,比如 Claude API / Cursor Business / Claude Code 订阅——这直接关联真金白银。对订阅版用户,1-2K token 压缩让上下文能装下更多近期代码变更。
场景 3:3 人协作 vs 10 人团队的不同用法
个人开发者:当 ~/.recall/ 私有记忆,每项目独立 context.md。
小团队(3-5 人):把 .recall/ 整个目录 git push 到共享仓库,新成员 git clone 后立刻获得 AI 的项目上下文——比"老员工带新人"更快。
企业团队(10+ 人):每个代码仓库一个 context.md,配合 PR Review 时自动 commit 新的 context 增量,AI 始终理解"代码库现在到哪一步"。
注意:Recall 默认是单机的,多人协作需要团队约定 .recall/ 的提交策略——别让敏感 API key 通过 git 泄露。
🔄 Recall 工作流:四阶段全自动
关键工程亮点
| 维度 | 实现 |
|---|---|
| 算法 | TF-IDF + TextRank(2004 年成熟算法)— 故意不用 LLM |
| 可选 numpy 加速 | 有则 numpy 更快,无则纯 Python(输出完全一致) |
| 脱敏处理 | 写入前剥离 API_KEY=* / sk-* / ghp_* / PEM 密钥等 |
| Hardened git 读取 | 禁用 core.fsmonitor、diff.external、钩子、分页器 |
| 写入路径限制 | output_dir 强制保留在项目内部,禁止写到上级目录 |
| 范围限定 | 仅读取当前 cwd 对应的会话记录 |
| Windows 兼容 | 三连修:`python3 ... |
| CI 质量门 | Python 3.9-3.13 × with/without numpy、pytest、Bandit、CodeQL、密钥扫描 |
为什么用 20 年前的老算法? 因为这个场景只需要"准确提取关键信息",不需要"创造性生成"。20 年老算法 + 1-2K token 摘要 + 完全离线 = 比任何"AI 摘要工具"都省 token、都安全。
🔐 隐私与安全
Recall 是少数几个默认最隐私的记忆工具:
| 隐私保障 | 实现细节 |
|---|---|
| ❌ 无网络调用 | 摘要器只用 Python 标准库,不发任何外部请求 |
| ❌ 无 API Key | 不需要配置任何第三方凭证 |
| ❌ 无遥测 | 不收集任何使用数据 |
| ✅ 写入前脱敏 | 自动过滤常见密钥形态(best-effort,非 100%) |
| ✅ 输出路径锁定 | 禁止把 .recall/ 写到项目外部 |
唯一警告:如果你打算把 .recall/ commit 到 GitHub,请先扫一遍 context.md,确保没有把公司密钥或个人 token 写进去。 Recall 的脱敏是 best-effort,不替代人工 review。
💰 定价方案
Recall 100% 免费 + 开源(MIT):
- ✅ 全部功能免费
- ✅ 商用免费
- ✅ 修改源码 / Fork / 二次分发都可以
- ❌ 无 Pro 版 / 无企业版 / 无 SaaS 升级路径
GitHub 仓库:raiyanyahya/recall 开源协议:MIT
🎯 总结
Recall 把 Claude Code 的"会话冷启动浪费"问题彻底解决,用的是 20 年前成熟的 TF-IDF + TextRank 算法,完全本地、完全免费、完全隐私。
适用人群:
- ✅ Claude Code 订阅版 / API 用户(直接省 token)
- ✅ 长周期项目(多次跨会话续接)
- ✅ 隐私敏感场景(金融 / 医疗 / 内部工具)
- ✅ 重视"项目状态可追溯"的团队
不适合:
- ❌ 偶尔用 Claude Code 的轻度用户(成本收益不高)
- ❌ 需要跨模型记忆(当前只支持 Claude Code Hook)
- ❌ 不想碰一行配置的用户(虽然配置只有 5 行 JSON)
推荐指数:⭐⭐⭐⭐⭐(满分 5 星)
立即体验:
git clone https://github.com/raiyanyahya/recall.git
/plugin add /path/to/recall
# 在项目根目录创建 recall.config.json(见上文)
# 重启 Claude Code,享受"自动记忆"
数据截至 2026-06-30,最新信息请以 GitHub 仓库 为准。