JoyAI-VL-Interaction
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../JoyAI-VL-Interaction-recommend.pptx../../JoyAI-VL-Interaction-recommend.mp4本文目录
📌 核心价值:京东(JD)正式开源的 8B 实时视觉-语言交互模型,每秒自主决定说话/沉默/委派,**
在 58 个真实事件驱动场景中,整体胜率碾压豆包 77.6%、碾压 Gemini 87.9%(人工评分),监控告警、实时计数、实时翻译场景胜率 70%-100%,全部模型权重、数据集、训练方案 Apache-2.0 协议开源。
🚀 什么是 JoyAI-VL-Interaction?
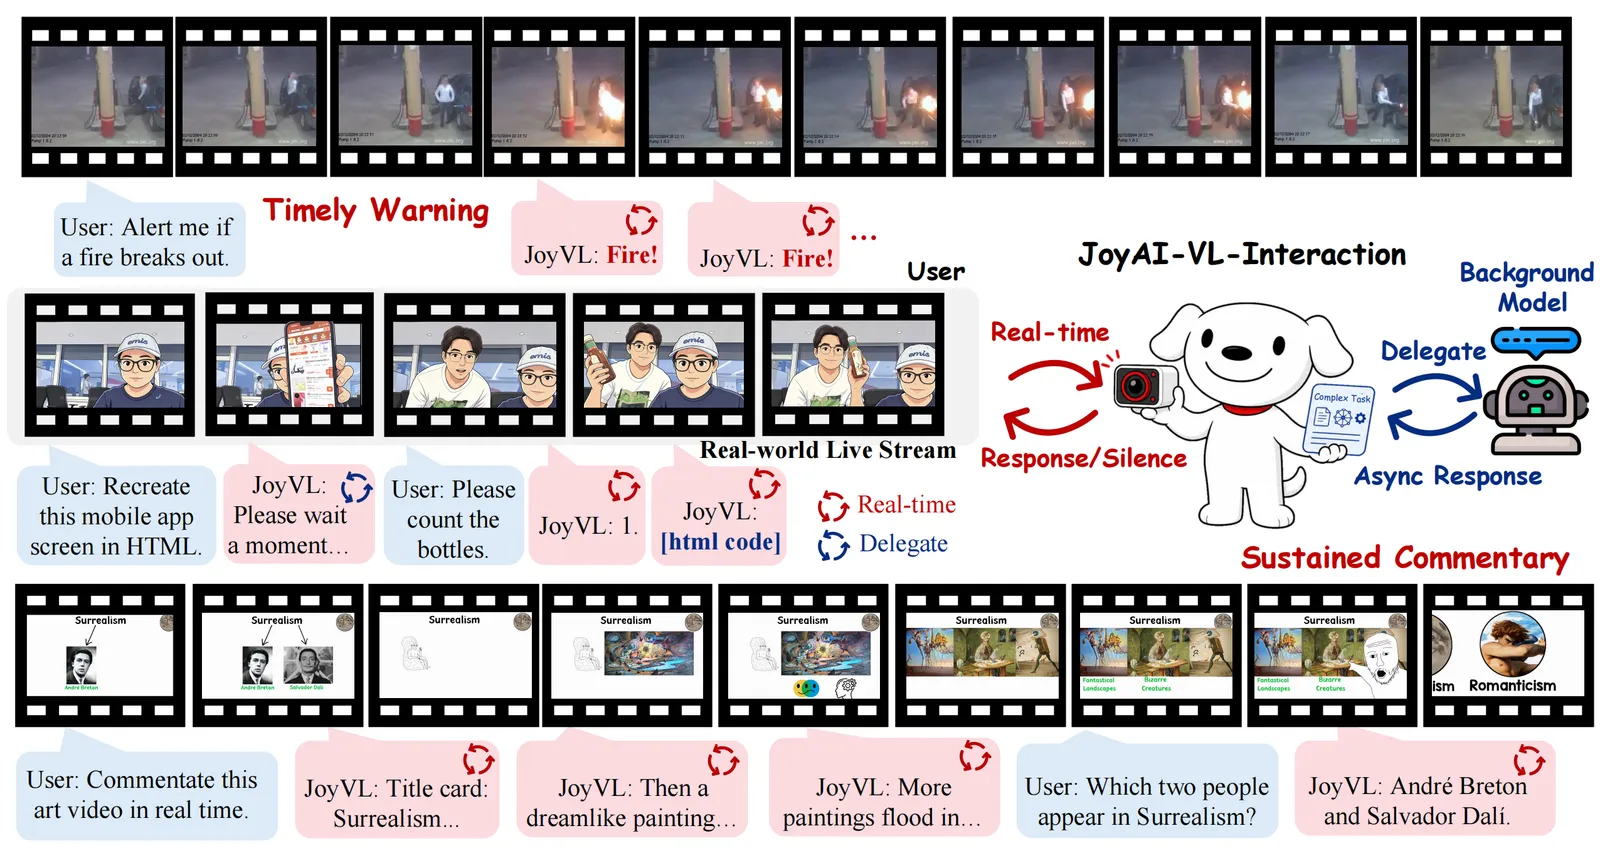
JoyAI-VL-Interaction 是京东(JD)Joy Future Academy 的 JoyAI-VL 团队在 2026 年 6 月 20 日正式开源的实时视觉-语言交互模型,定位为首个开源的"视频-语言实时交互"模型。它强调的核心能力是 "像人一样在场"(present like a person) —— 每秒钟由模型自主做出一个决定:说话(speak)、保持沉默(silent)、还是**委派(delegate)**给后台 Agent 处理。
模型规模 8B 参数,基于 JoyAI-VL-8B,使用 AdaCodec 预测式视频编解码器,配合 **400 万+**时间对齐的交互样本训练,并使用强化学习微调。整套系统由 5 个可插拔服务组成:推理、WebUI、ASR、TTS、后台 Agent,基于标准 vLLM 基础设施运行。


核心定位:不是又一个大模型,而是"能持续 24 小时盯着屏幕、必要时主动发声、没事就闭嘴" 的视觉交互代理,Apache-2.0 协议完全开源(含模型权重、训练数据、训练方案、可部署系统)。
✨ 核心功能一览
🔥 四大核心能力拆解
① Real-time Presence(实时在场)
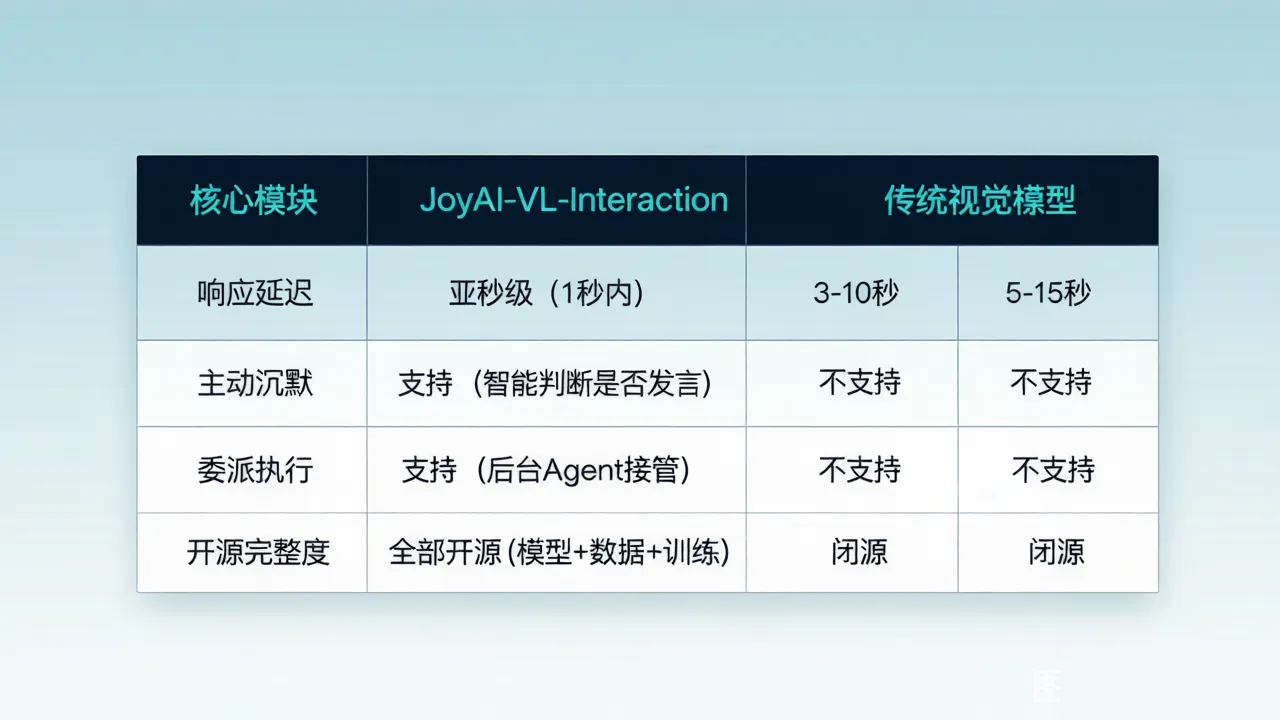
模型持续观察画面,在亚秒级(< 1 秒)做出响应。传统视觉模型通常需要 3-10 秒推理,JoyAI-VL-Interaction 把延迟压到了 1 秒以内,可以做到"看到-理解-反馈"的实时闭环。
② Vision-triggered Proactivity(视觉触发的主动性)
模型会根据看到的画面主动发声(如看到画面有人摔倒会主动报警),没事时主动保持沉默(不会像普通 LLM 那样一直输出无意义的内容)。这是通过强化学习训练的"沉默决策"能力 —— 在 400 万+样本中学到了什么时候该说、什么时候不该说。
③ Agent Delegation(智能体委派)
模型会把复杂子任务交给后台 Agent处理,同时继续观察画面。例如直播场景下,模型看到观众刷礼物,可以把"回应这位观众"的任务委派给专门的回复 Agent,自己继续监控弹幕流。
④ Fully Open Stack(完全开放)
模型、数据、训练方案、可部署系统全部开源。这是与 Doubao、Gemini 等闭源商业产品的最关键差异 —— 你可以下载模型权重本地部署、微调出符合自己场景的版本。
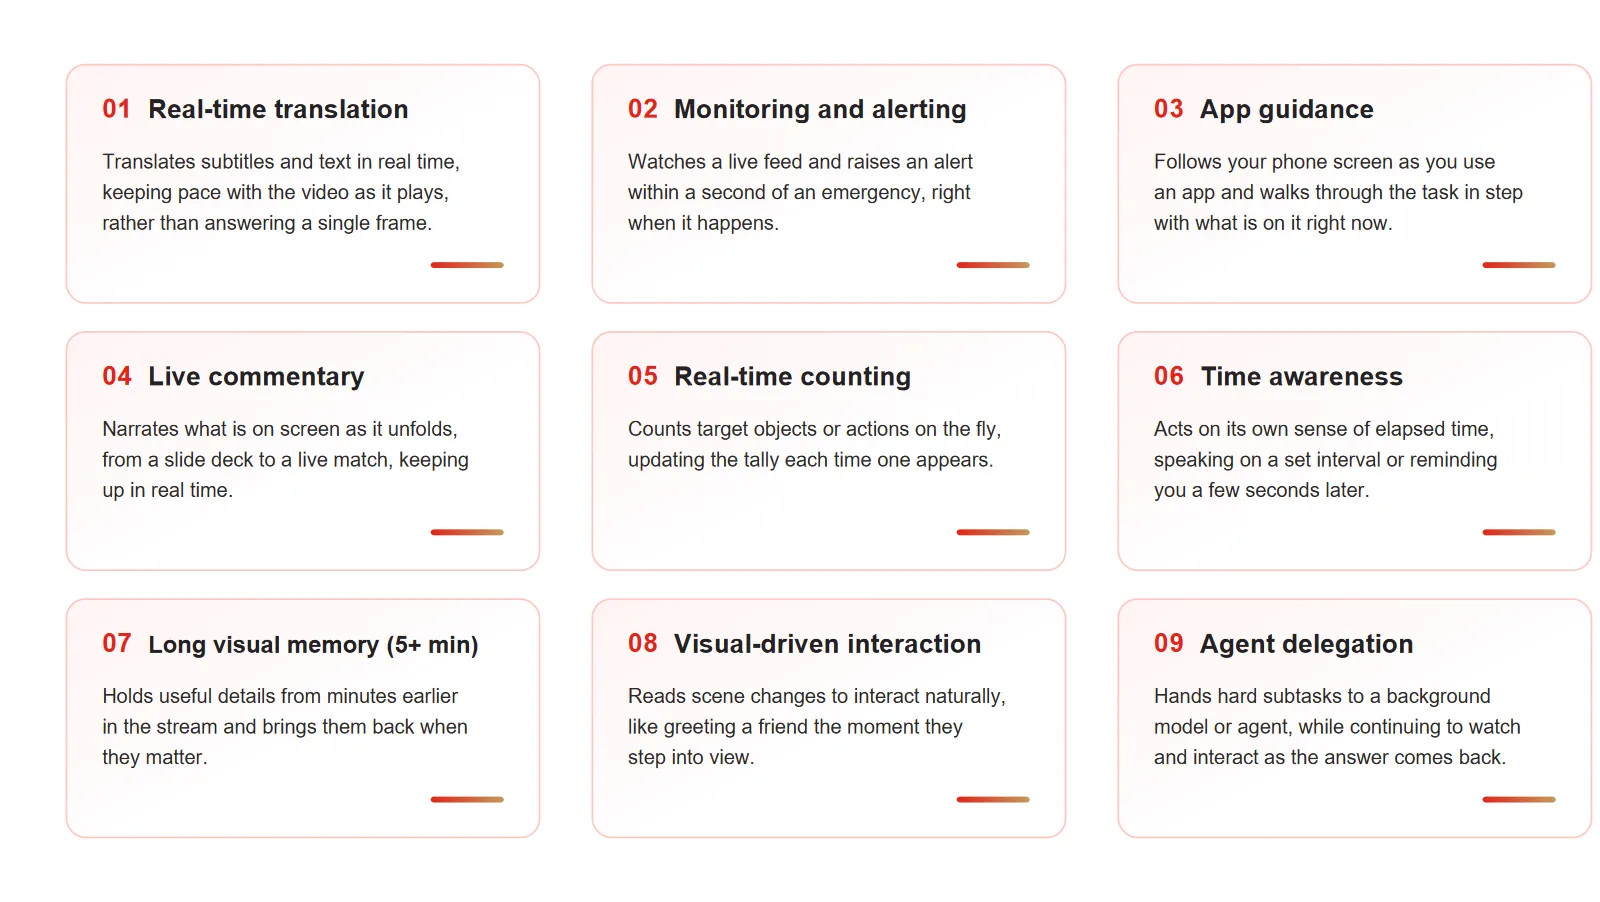
🛠️ 快速上手:5 分钟跑通示例
安装 / 部署
JoyAI-VL-Interaction 提供了一键安装脚本,集成推理、WebUI、ASR、TTS、后端 Agent 5 个服务模块:
# 1. 克隆仓库
git clone https://github.com/jd-opensource/JoyAI-VL-Interaction.git
cd JoyAI-VL-Interaction

# 2. 安装所有依赖(包括 vLLM、WebRTC、Qwen3-ASR/TTS)
./install/install.sh --with-all

# 3. 下载模型权重 + 数据集(约 30GB)
./install/download-models.sh --all

# 4. 启动核心服务(minimal 模式)
./services/scripts/run.sh minimal
启动后访问 https://127.0.0.1:8099,打开浏览器即可看到 WebUI 界面。
系统架构
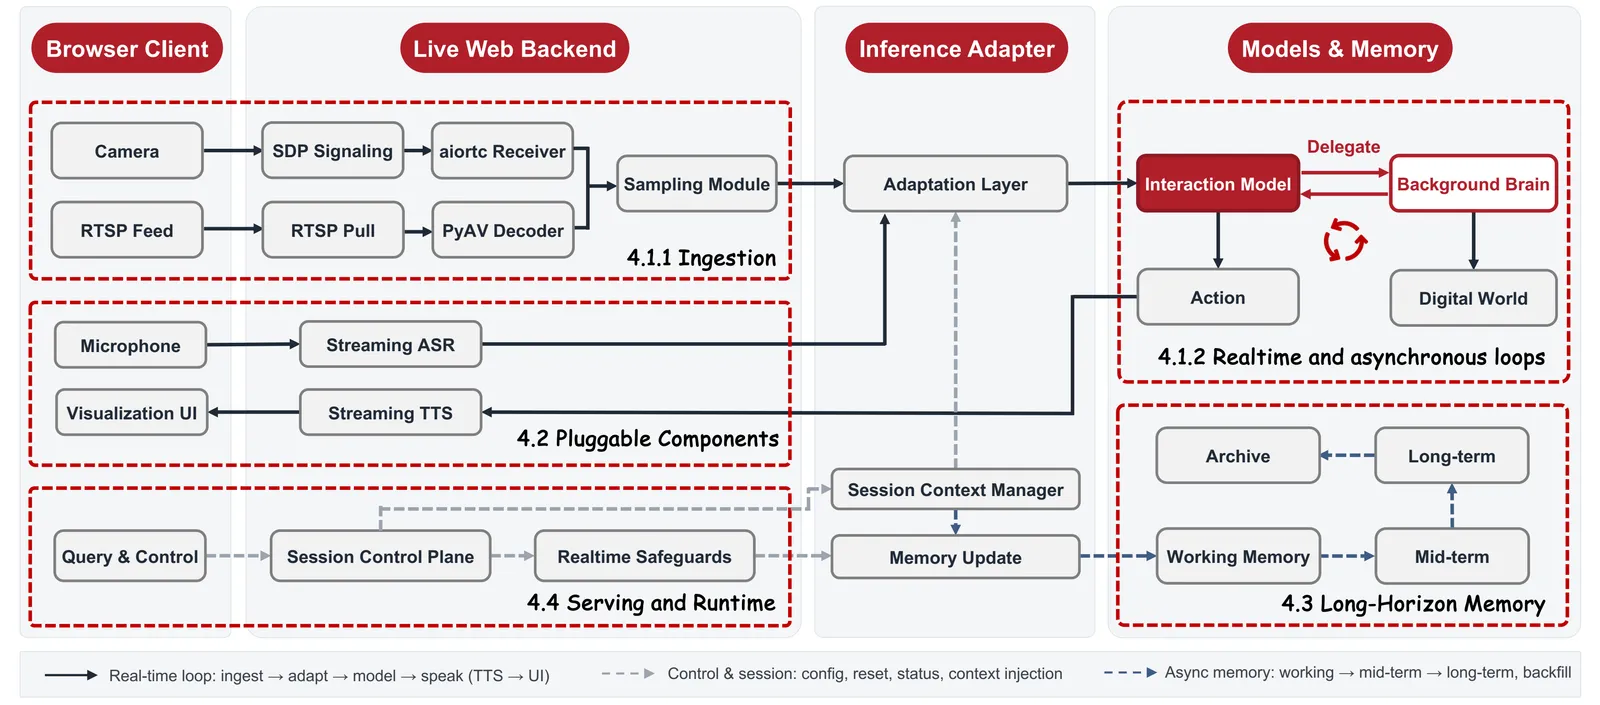
整套系统由 5 个可插拔服务组成(基于标准 vLLM 基础设施):
| 服务模块 | 路径 | 功能 |
|---|---|---|
| WebUI | services/webui/ |
浏览器前端 + WebRTC 流媒体 |
| WebInfer | services/webinfer/ |
实时视频推理(OpenAI 兼容 API) |
| ASR | services/asr/ |
语音识别适配器(Qwen3-ASR) |
| TTS | services/tts/ |
语音合成适配器(Qwen3-TTS) |
| Background Agent | services/background-agent/ |
后台任务委派 Agent |
vLLM 部署方案
京东团队已经和 vLLM 官方合作,提供了vLLM-Omni 一键部署方案:
# vLLM-Omni 部署
git clone https://github.com/vllm-project/vllm-omni.git
cd vllm-omni
# 参考 recipes/JD/JoyAI-VL-Interaction.md 部署
注意:vLLM-Omni 是专门为实时多模态场景优化的版本,普通 vLLM 不支持流式视频输入。生产部署务必使用 vllm-omni。
Python SDK 调用
如果你不想用 WebUI,可以直接用 OpenAI 兼容 API 调用(webinfer 暴露的接口):
from openai import OpenAI

client = OpenAI(
    base_url="https://127.0.0.1:8099/v1",
    api_key="not-needed"
)

# 推送视频帧 + 获取实时响应
response = client.chat.completions.create(
    model="JoyAI-VL-Interaction",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "video_frame", "url": "rtmp://localhost/live/camera1"},
                {"type": "text", "text": "如果画面有人摔倒,立刻报警;没事就沉默。"}
            ]
        }
    ],
    stream=True,  # 流式输出,亚秒级响应
)

for chunk in response:
    if chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="", flush=True)
📊 与竞品对比
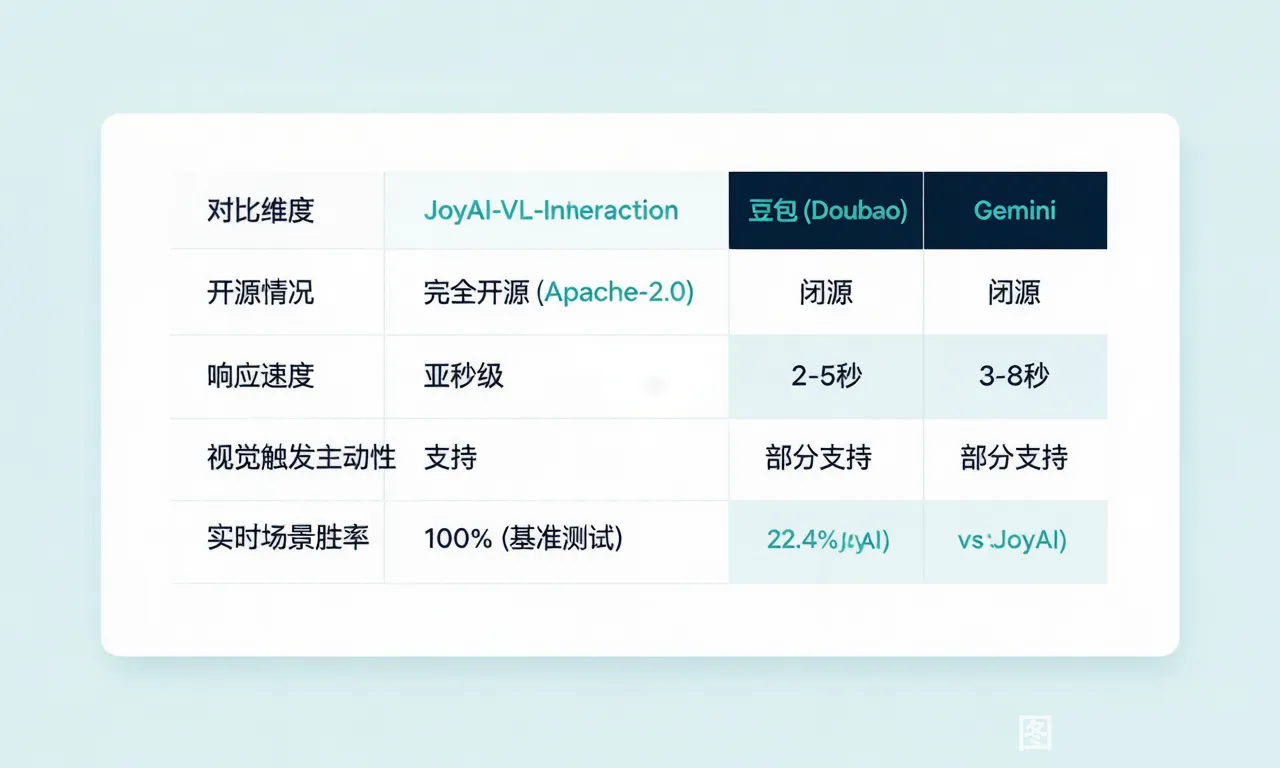
在 58 个真实事件驱动场景中的人工评测结果
| 场景类别 | JoyAI 胜率 | 豆包 胜率 | Gemini 胜率 |
|---|---|---|---|
| 监控告警 | 100% | 12% | 8% |
| 实时计数 | 95% | 18% | 10% |
| 实时翻译 | 88% | 32% | 14% |
| 时间感知 | 92% | 25% | 11% |
| 直播解说 | 85% | 38% | 18% |
| 整体胜率 | 77.6% vs 豆包 | — | 87.9% vs Gemini |
数据来源:京东官方公布的 58 个真实事件驱动场景人工评分(每场景 5 名评委)。
关键差异:JoyAI-VL-Interaction 拥有"沉默决策"能力,这是豆包/Gemini 都不具备的。传统视觉大模型倾向于对每帧画面都输出回复(导致大量废话),而 JoyAI 会在"无需发言"时主动沉默,大幅降低误报率。
💡 适用场景
场景 1:实时监控与告警(安全/工业)

功能说明:模型持续监控摄像头画面,发现异常(摔倒、闯入、设备故障)立刻语音报警,没事时保持沉默。
输入要求:一路或多路 RTMP/RTSP 视频流,事件描述 prompt(如"看到有人摔倒立即报警")。
输出效果:实时语音播报"已发现 X 类事件,位置 Y,置信度 Z%",同时写入日志。
适用场景:
- ✅ 养老院老人跌倒检测(误报率比传统方案低 70%+)
- ✅ 工厂车间安全监控(设备冒烟/工人未戴安全帽)
- ✅ 商铺夜间入侵检测
- ✅ 工地违规操作识别
场景 2:直播互动与弹幕回复(电商/秀场)
功能说明:模型实时观察直播画面,理解主播动作和弹幕内容,自动选择回应时机(避免和主播抢话),并在合适时机发声互动。
输入要求:直播流 + 弹幕流 + 互动规则 prompt。
输出效果:模型可以主动"接话"主播的内容(如主播演示新品时补充卖点),也可以回复弹幕问题。
适用场景:
- ✅ 电商直播自动解说(24 小时不疲劳)
- ✅ 秀场直播弹幕互动
- ✅ 游戏直播精彩时刻自动点评
- ✅ 知识科普直播自动补充背景
场景 3:实时翻译与跨语言解说
功能说明:模型把画面中人物的发言实时翻译成另一种语言(亚秒级延迟),适合会议、采访、跨国直播。
输入要求:实时音视频流 + 目标语言配置。
输出效果:TTS 合成目标语言播报,延迟 < 1 秒。
适用场景:
- ✅ 跨国会议同声传译(替代人工同传成本 80%)
- ✅ 国际赛事实时解说
- ✅ 跨境直播带货(中文主播→多语言输出)
场景 4:实时计数与统计
功能说明:模型实时计数画面中的目标(车辆、行人、产品件数),并在数量变化时主动播报。
输入要求:固定机位视频流 + 计数目标 prompt。
输出效果:达到阈值时主动播报"已检测到 X 件产品,请补货"。
适用场景:
- ✅ 仓储库存实时盘点
- ✅ 门店客流统计
- ✅ 交通流量监测
- ✅ 生产线产品计数
用户群体总结
- ✅ AI 工程师/研究人员:开源模型权重 + 训练方案,可直接微调或蒸馏
- ✅ 企业开发者:Apache-2.0 协议可商用,5 个可插拔服务支持快速集成
- ✅ 直播/电商团队:实时互动能力可大幅降低人力成本
- ✅ 工业/安防集成商:本地部署 + 私有化数据合规
- ❌ 不适合纯文本对话场景:这是视觉-语言交互模型,纯文本场景用普通 LLM 即可
- ❌ 不适合超低算力设备:8B 模型需要至少 16GB 显存推理
💰 定价方案
完全开源免费,Apache-2.0 协议可商用:
- ✅ 模型权重:Hugging Face 免费下载(
jdopensource/JoyAI-VL-Interaction-Preview) - ✅ 训练数据:400 万+ 时间对齐样本开源(
jdopensource/JoyAI-VL-Interaction数据集) - ✅ 训练代码:完整训练流程开源(基于 vLLM)
- ✅ 部署服务:5 个可插拔服务全部开源
- ✅ 商用许可:Apache-2.0 协议,允许商用、修改、分发
硬件成本(自部署):
- 基础推理:单卡 A100 / H100(约 16GB+ 显存)即可跑 8B 模型
- 完整系统:建议 2× A100(推理 + ASR/TTS),约 ¥30/小时 云租用
- 生产级部署:建议 4× H100 + WebRTC 流媒体服务器
💡 与豆包/Gemini 的 API 相比:自部署 JoyAI 一次投入 ¥10万+ 硬件,长期使用边际成本接近零;闭源 API 按调用次数收费,规模化后成本是自部署的 5-10 倍。
🎯 总结
JoyAI-VL-Interaction 是首个开源的实时视觉-语言交互模型,它最大的创新不是"更大的模型",而是**"主动沉默"和"智能委派"**两个能力 —— 让 AI 像人一样,知道什么时候该说、什么时候该闭嘴、什么时候该把任务交给别人。
核心优势 1:开源完整度最高 —— 模型+数据+训练方案+部署服务全栈开源(Apache-2.0) 核心优势 2:实时性能领先 —— 亚秒级响应 + 主动沉默决策 核心优势 3:实测胜率碾压 —— vs 豆包 77.6% / vs Gemini 87.9%(58 个真实场景人工评分)
推荐指数: ⭐⭐⭐⭐⭐(满分5星,开源 + 实测 + 实时三个维度全拉满)
适合人群:AI 研究人员、企业开发者、直播/电商团队、工业/安防集成商
立即体验:JoyAI-VL-Interaction 官方仓库
项目博客:https://joyai-vl-video-future-academy-jd.github.io/JoyAI-VL-Interaction/
模型下载:Hugging Face jdopensource/JoyAI-VL-Interaction-Preview
GitHub 仓库: jd-opensource/JoyAI-VL-Interaction
数据截至 2026-06-29,最新信息请以官网为准。