MiniMax H3 今天开源:2K 不靠超分,声音不是后期配的,但最关键那块没给
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../minimax-h3-recommend.pptx../../minimax-h3-recommend.mp4本文目录
title: MiniMax H3 今天开源:2K 不靠超分,声音不是后期配的,但最关键那块没给 author: yesai
MiniMax H3 今天开源:2K 不靠超分,声音不是后期配的,但最关键那块没给
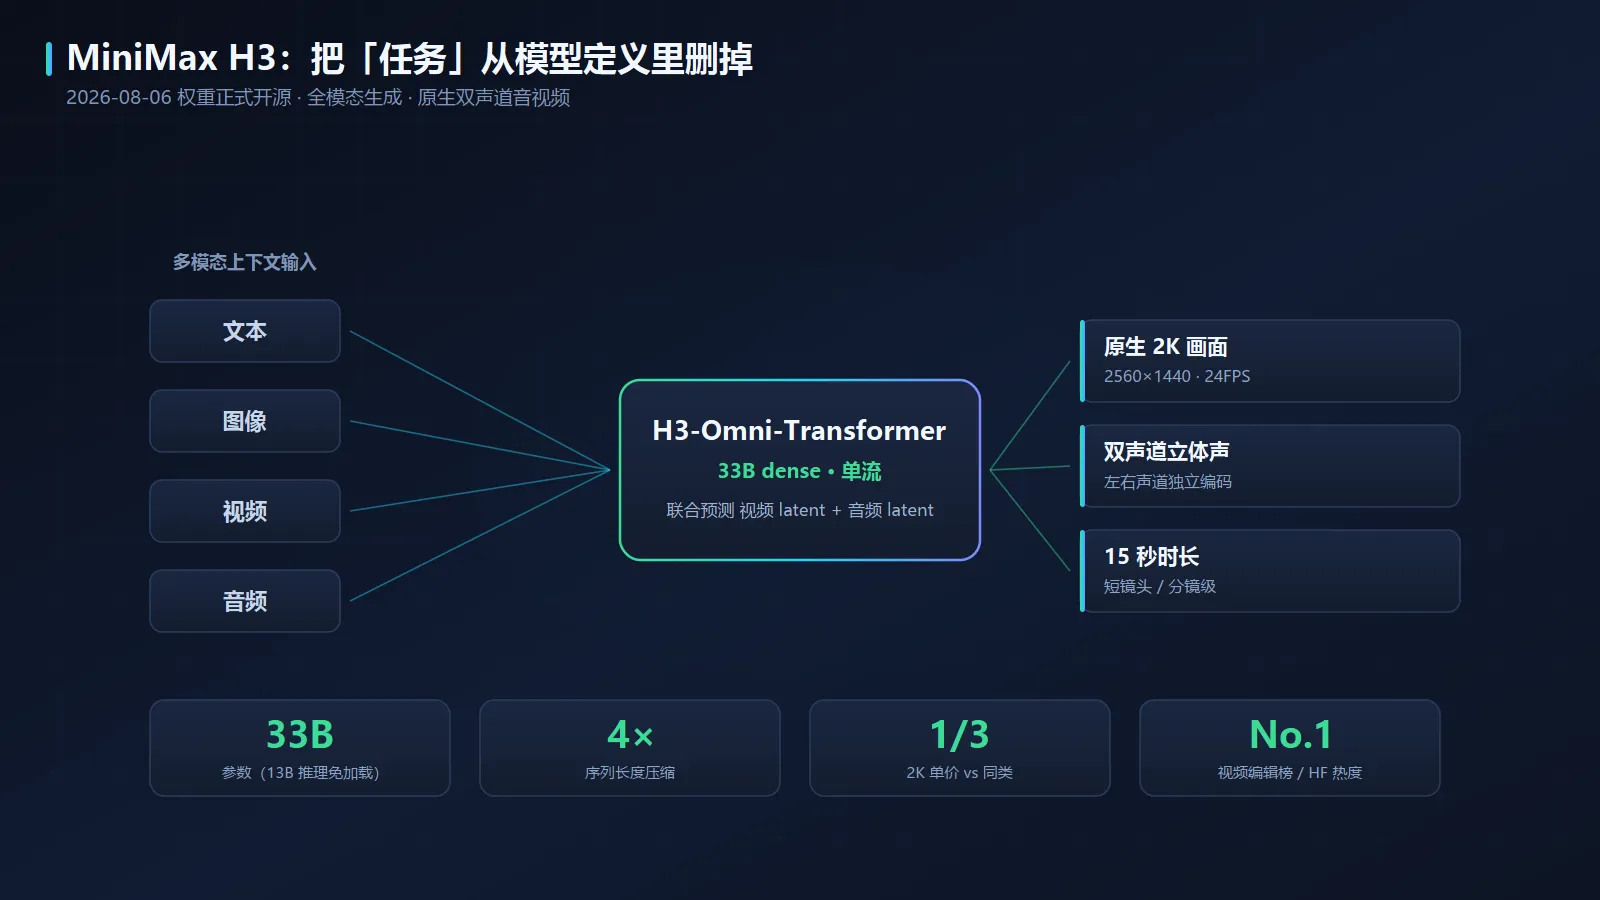
当所有视频模型都在卷画质的时候,H3 卷的是另一件事:把「任务」这个词从模型定义里删掉。
为什么这篇值得写
8 月 6 日凌晨,MiniMax 把 H3 的模型权重推上了 GitHub(MiniMax-AI/MiniMax-H3,最后一次 push 停在 05:33)。在此之前,这家公司已经开源过三代 M 系列文本模型,但视频生成模型一直捂着——H3 是它第一个开源的多模态生成模型。
消息本身不算意外,7 月 31 日发布时官方就说了「未来几天开放权重」。真正值得写的是三件事:
- 它在 Artificial Analysis 的视频编辑榜上排全球第一,HuggingFace 热度冲到第一,压过了 DeepSeek V4 Flash;
- 它的技术选择反常识——2K 分辨率不接超分模块,音频不是后期配的,这两件事都和行业默认做法反着来;
- 它的「开源」需要打个折扣——最影响最终质量的那一层,这次没给。
第三点尤其值得说清楚。很多号会把「开源」两个字直接当成结论发出去,但真正要用这个模型的人,需要知道自己拿到的是完整的车,还是一台缺了导航的车。
先看图:H3 到底改了什么
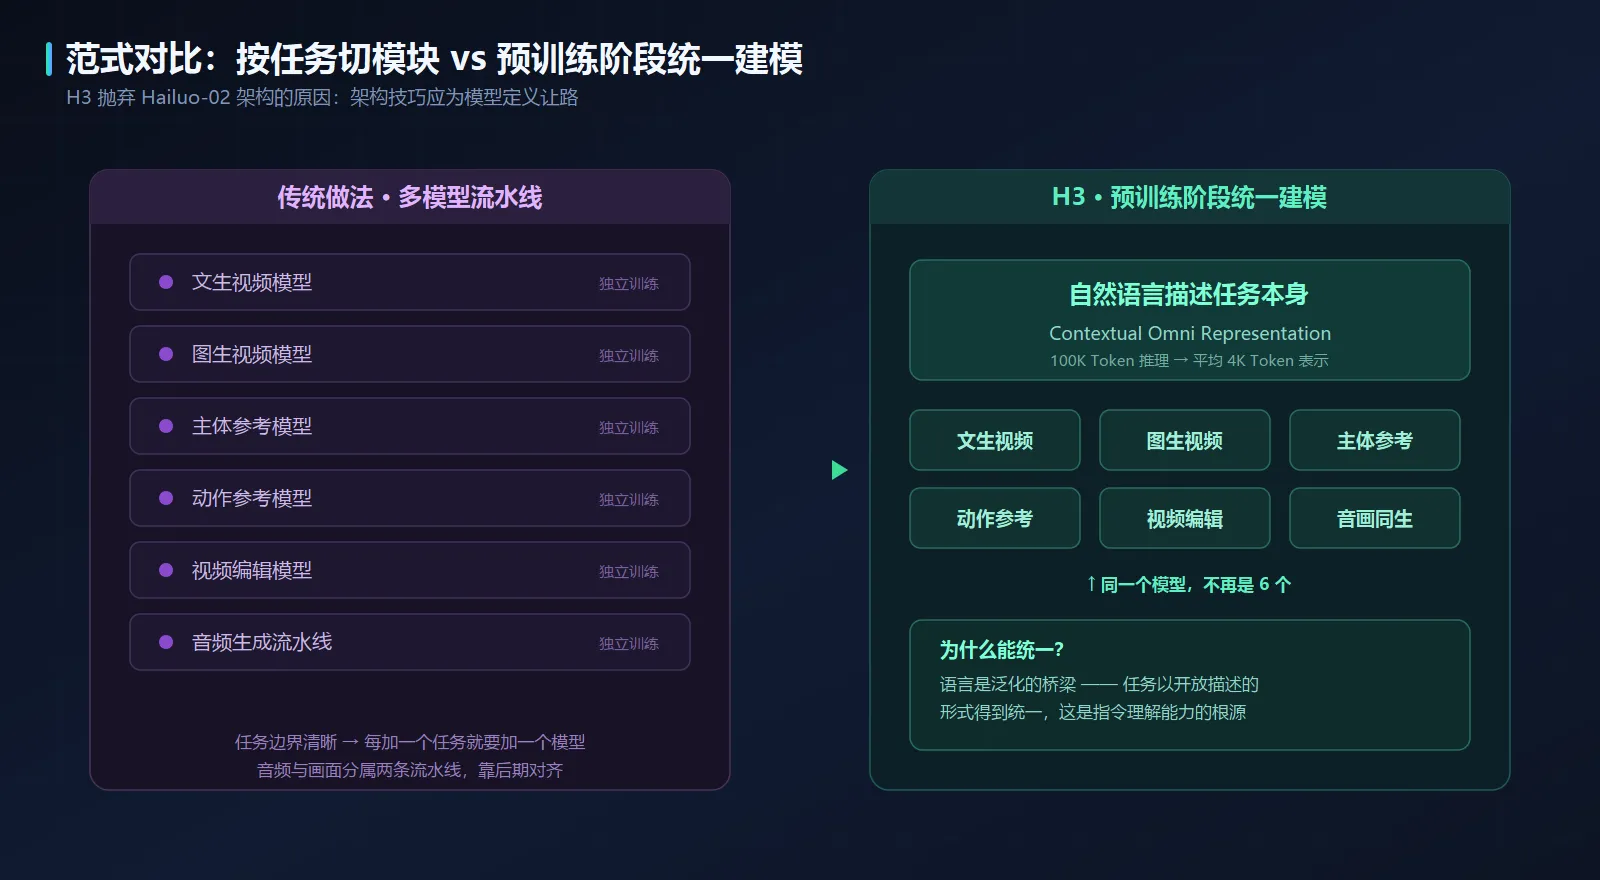
过去两年,视频生成模型的标准做法是按任务切模块:文生视频一个模型,图生视频一个模型,主体参考、动作参考、视频编辑各自再来一个,音频通常是另一条流水线,最后拼在一起。
H3 的做法是在预训练阶段就把这些任务统一建模,用自然语言去描述任务本身,而不是为每种任务单独养一个专家模型。
官方博客里有一句话点得很准:
「语言是泛化的桥梁,任务以一种开放描述的形式得到统一,这是 H3 广泛的指令理解能力的根源。」
翻译成人话:以前你得先想清楚「我要做的是文生视频还是视频编辑」,然后去找对应的模型;现在你只需要把素材和想法一起丢给它,剩下的它自己判断。
更有意思的是,官方明确说抛弃了上一代 Hailuo-02 架构——理由是那套架构虽然带来过显著优势,但在「任务泛化」这个新目标下会引入额外复杂度。原话是「架构技巧应为模型定义让路」。一家公司主动放弃自己验证过的架构优势,这个决定本身就说明他们对这条路的判断有多确定。
拆开看:四个模块各自在干什么
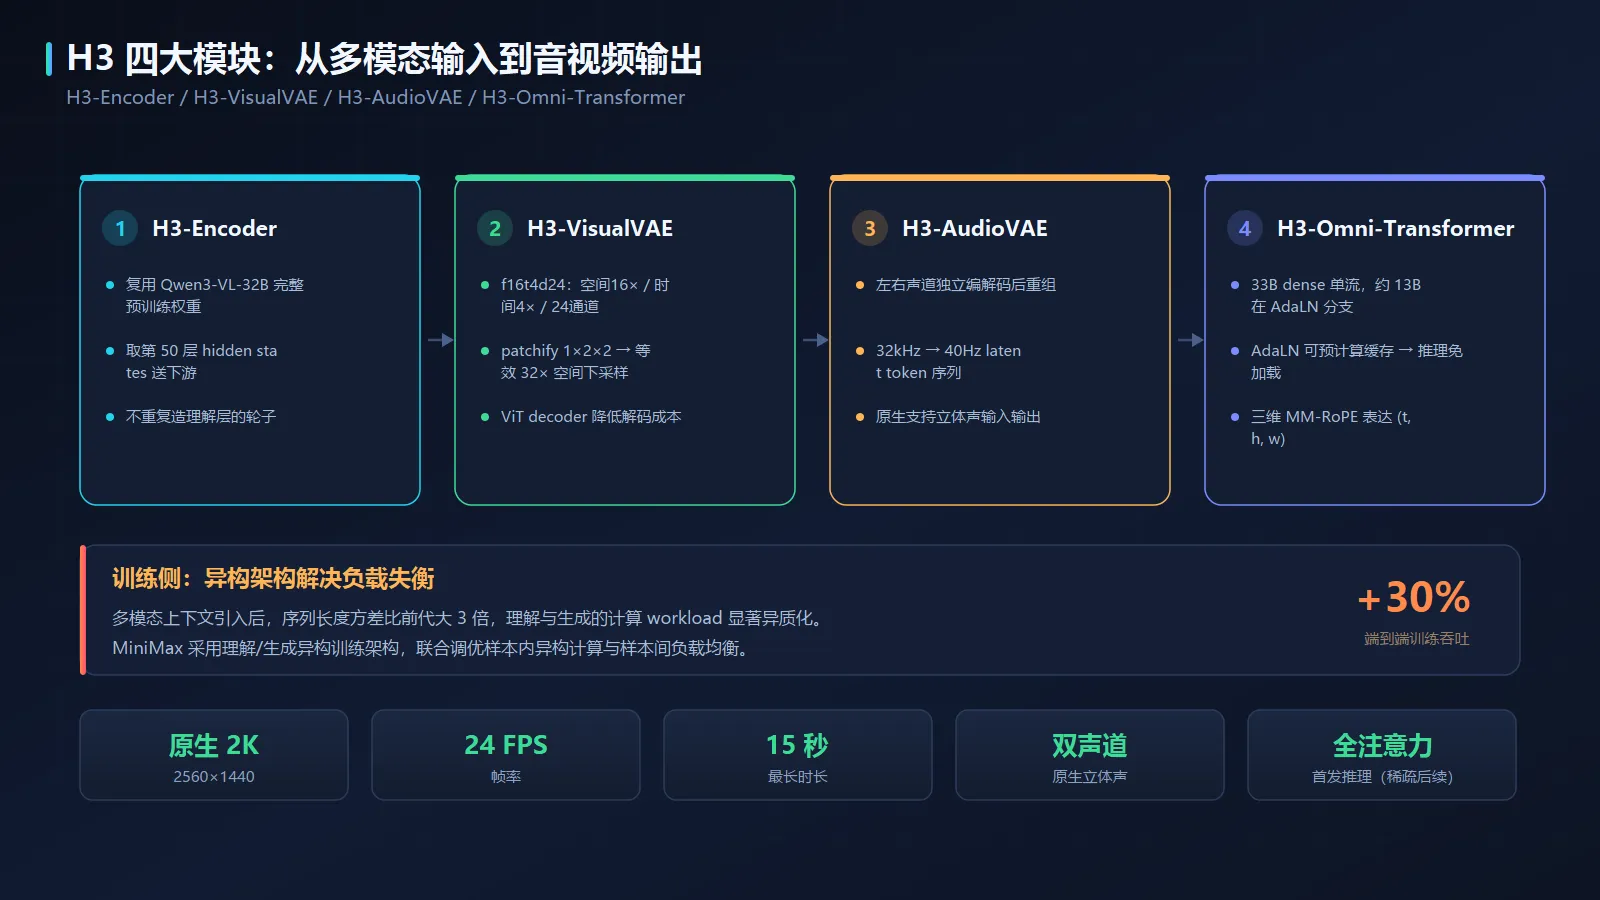
H3 的技术栈可以拆成四块,每一块都有值得单独说的点。
H3-Encoder:直接用了 Qwen3-VL-32B
这块最省事也最实在——H3-Encoder 用的是 Qwen3-VL-32B 的完整预训练权重,把它第 50 层的 hidden states 喂给下游的 Omni-Transformer。
不重复造理解层的轮子,直接站在成熟视觉语言模型的肩膀上,这是个务实的工程判断。
H3-VisualVAE:4 倍序列压缩是 2K 的前提
视觉侧的自编码器叫 H3-VisualVAE,参数记法是 f16t4d24:
| 维度 | 压缩倍率 | 说明 |
|---|---|---|
| 空间(f16) | 16× | 单帧分辨率方向压缩 |
| 时间(t4) | 4× | 帧序列方向压缩 |
| latent 通道(d24) | 24 | 潜空间维度 |
进 Transformer 之前,视觉 latent 还会按 1 × 2 × 2(时间×高×宽)再做一次 patchify。两步叠加下来,进入 Transformer 的视觉 token 相当于做了 32 倍空间下采样,时间方向保持 4 倍。
这套压缩带来了 4 倍的序列长度收益。序列短了,训练和推理成本直接下降——这也是 H3 能把 2K 分辨率做成默认输出而不是高价选配的技术前提。
另外一个细节:encoder 训练完之后,官方又单独训了一个基于 ViT 的 decoder,目的是降低解码成本、同时再提一提重建质量。
H3-AudioVAE:声音不是配上去的
这是最容易被忽略、但体感差别最大的一块。
H3-AudioVAE 用同一套编码器/解码器分别独立处理左右声道,解码后再重新组合,因此原生支持立体声输入输出。每个声道把 32 kHz 音频压成时间频率 40 Hz 的 latent token 序列。
关键在于:Omni-Transformer 是联合预测视频 latent 和音频 latent 的,不是先生成画面再配音。这意味着画面里的动作和声音天然对齐,而不是靠后期时间轴去对。
H3-Omni-Transformer:33B 里有 13B 推理时不用加载
主干是一个 33B 参数的 dense 单流 Transformer,设计上刻意做得简洁:
- 注意力层和 FFN 层不含任何模态专属结构,模态相关的参数只出现在输入/输出层和 AdaLN 分支;
- 三维 MM-RoPE(多模态旋转位置编码)负责表达时间和两个空间维度
(t, h, w)的位置关系; - 33B 里约 13B 参数在 AdaLN 相关分支上——而 AdaLN 的调制输出可以预计算并缓存,所以纯推理部署时这部分不需要加载。
最后这条是实打实的部署红利:账面 33B,实际推理时的显存压力要小得多。官方之所以把完整权重都放出来,是为了支持微调等二次开发。
还有一个训练侧的数字:因为引入多模态上下文,H3 的序列长度方差比前代大了 3 倍,理解和生成两部分的计算负载显著异质化。MiniMax 用了理解与生成异构的训练架构,联合调优单样本异构计算和样本间负载均衡,端到端训练吞吐提升了近 30%。
反常识点:2K 不靠超分,靠自己重画一遍
这是我认为 H3 最有意思的一个设计。
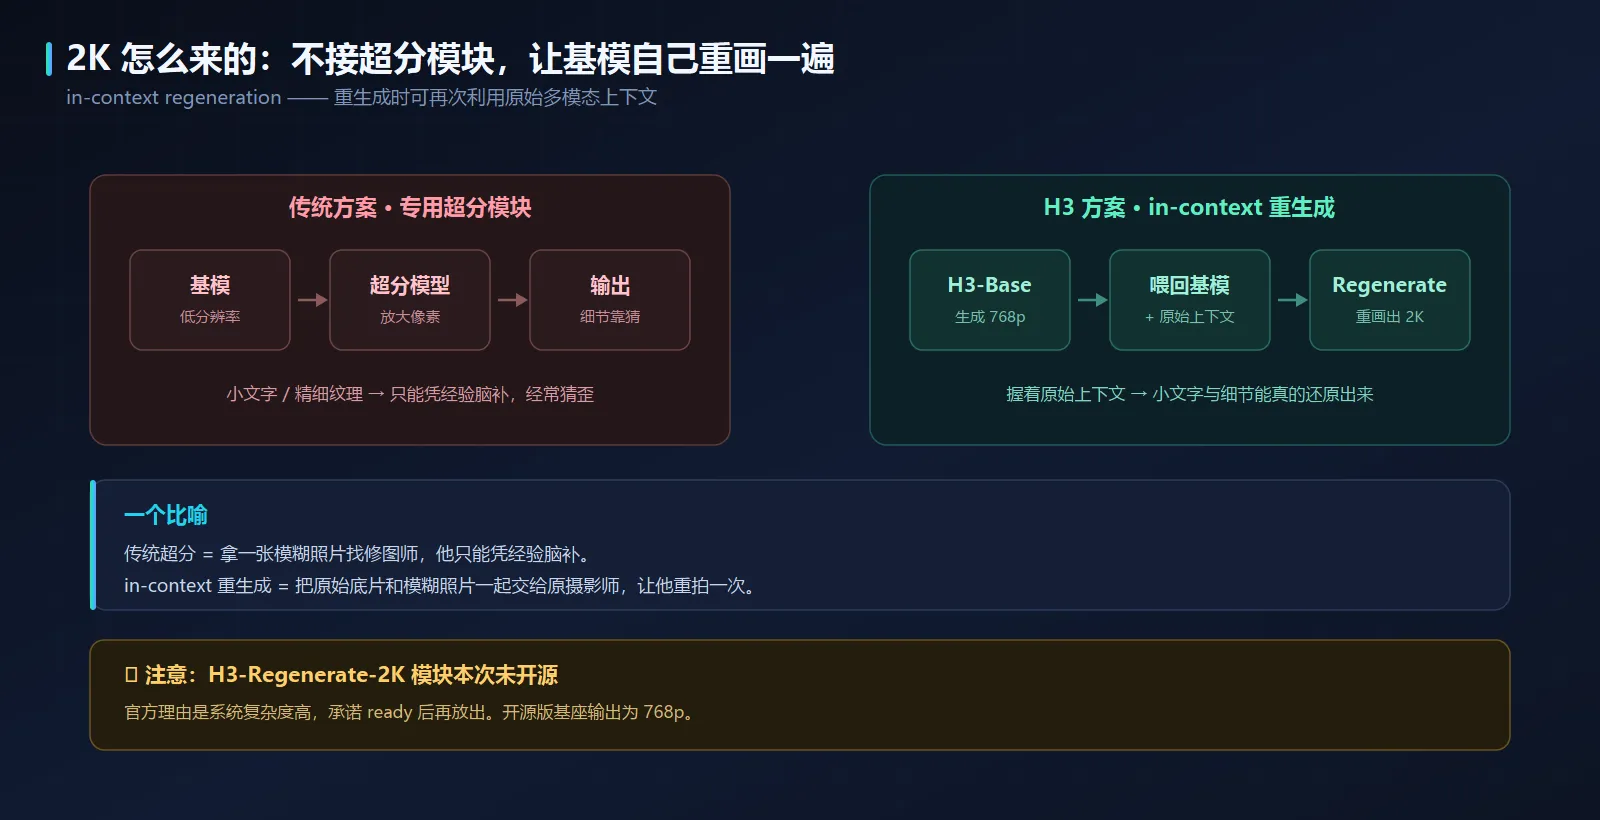
行业默认做法是:基模生成低分辨率,后面接一个专用超分模块放大。H3 没这么干,而是让基模对自己的低分辨率结果做 in-context 的重新生成。
具体分两段:
- H3-Base:拿中间表示生成 768p 的音视频;
- H3-Regenerate-2K:把 768p 结果连同原始上下文一起喂回模型,重新生成 2K 版本。
好处有两个。第一,能最大限度复用基模已有的生成能力,不用再养一个超分模型。第二——也是更关键的——重生成时可以再次利用原始的多模态上下文信息。
官方举了个很实在的例子:画面里的小文字和精细细节,传统超分只能靠「猜」去还原,经常猜歪;而 in-context 重生成因为手里握着原始上下文,能真的还原出来。
用一个比喻:传统超分像是拿着一张模糊照片找人修图,修图师只能凭经验脑补;in-context 重生成则是把原始底片和模糊照片一起交给原摄影师,让他重拍一次。
必须说清楚:开源了什么,没开源什么
这部分是我认为最需要独立成节讲的。H3 开源了,但开源的边界需要说清楚。
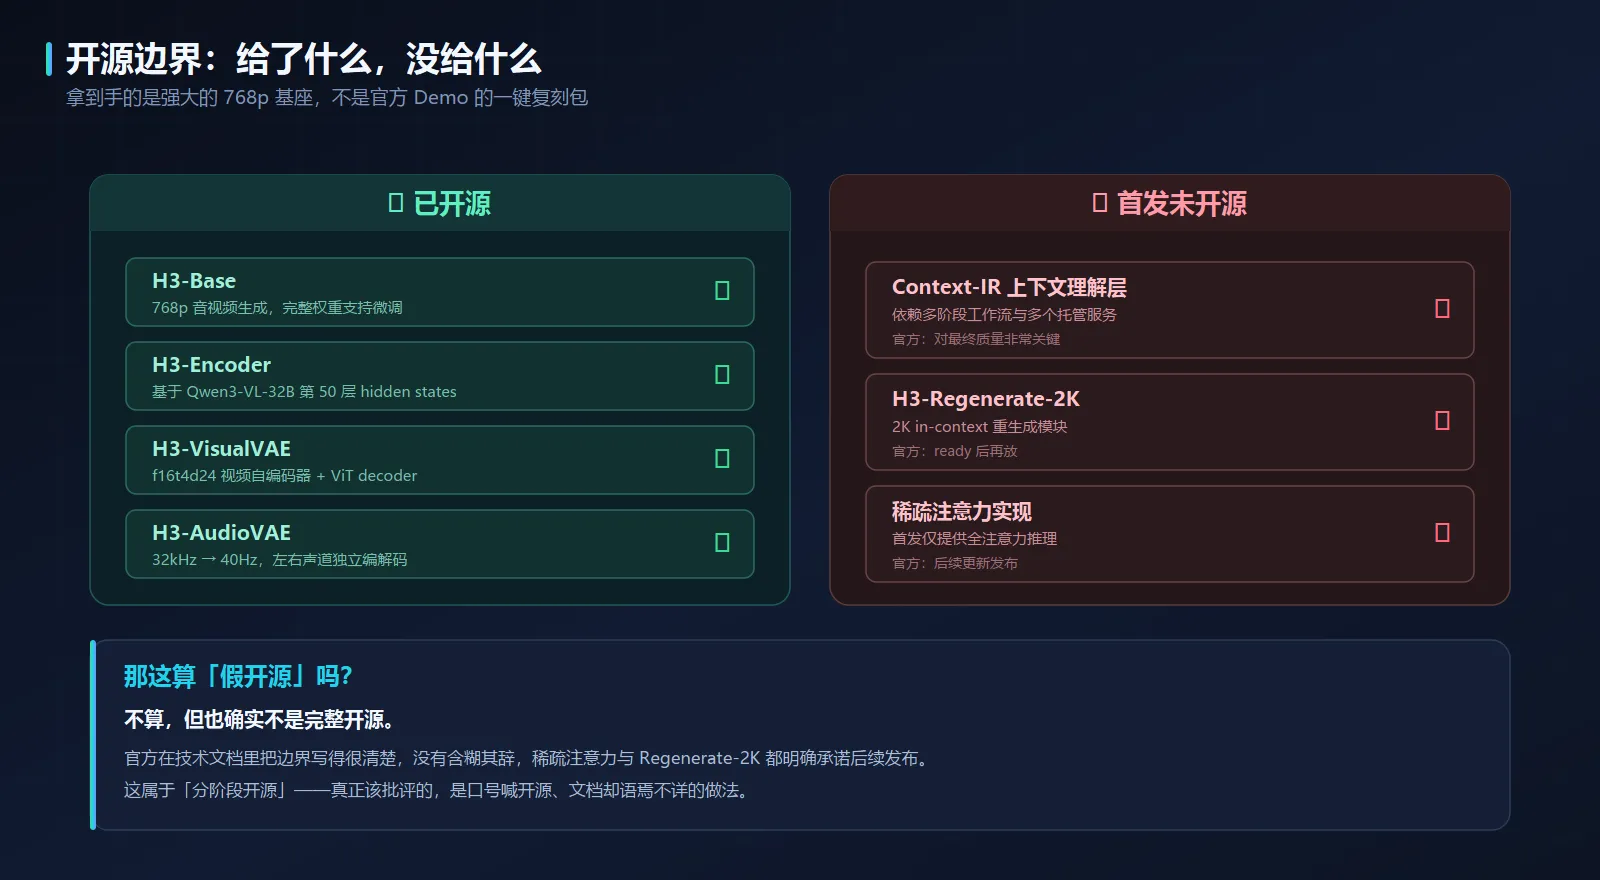
| 模块 | 是否开源 | 说明 |
|---|---|---|
| H3-Base(768p 音视频生成) | ✅ 已开源 | 完整权重,支持微调 |
| H3-Encoder | ✅ 已开源 | 基于 Qwen3-VL-32B |
| H3-VisualVAE / H3-AudioVAE | ✅ 已开源 | 视觉 + 音频潜空间编解码 |
| Context-IR(上下文理解层) | ❌ 未开源 | 依赖多阶段工作流和多个托管模型服务 |
| H3-Regenerate-2K | ❌ 未开源 | 系统复杂度高,官方称「ready 后再放」 |
| 稀疏注意力实现 | ❌ 未开源 | 首发只提供全注意力推理,后续更新 |
其中 Context-IR 的缺席最需要注意。官方给的理由是它依赖多阶段工作流和多个托管模型服务,不好独立开源;替代方案是提供 API,或者你照着官方的 Prompting Guidance 自己搭一套上下文处理系统。
但官方自己也强调:Context-IR 对最终质量非常关键,强烈建议接进流水线。
这意味着什么?你下载权重可以跑通 768p 生成,但想复现官方演示里那种效果,得自己补上理解层。
那这算不算「假开源」?我的判断是:不算,但也确实不是完整开源。
理由是官方在技术文档里把边界写得很清楚,没有含糊其辞,也没有等用户下载完才发现缺东西。稀疏注意力和 Regenerate-2K 都明确承诺后续发布。这属于「分阶段开源」,在大模型领域并不罕见——真正该批评的是那种口号喊开源、文档却语焉不详的做法。
不过对使用者来说,预期管理很重要:拿到手的是一个强大的 768p 生成基座,不是官方 Demo 的一键复刻包。
成本这件事,为什么值得单独提
H3 官方定价 2K 分辨率 0.8 元/秒,这个数字大约是业内同类旗舰视频模型的三分之一;768P 分辨率下不到对手的 1/2。
为什么能便宜这么多?答案回到前面那个 4 倍序列压缩:
序列长度 ↓ 4×  →  注意力计算量 ↓(约平方级收益)
                →  训练成本 ↓
                →  推理成本 ↓
                →  单价可以打下来
再叠加 33B 里 13B 推理不加载、异构训练架构提升 30% 吞吐,成本优势是架构层面挣出来的,不是补贴出来的。这一点和某些靠烧钱压价的打法有本质区别——架构效率带来的降价是可持续的。
另外官方提到,H3 在设计初期就考虑了多款国产芯片的兼容性,24 小时内有超百家国内外合作伙伴完成首日适配接入。
几个能力边界,先说在前面
在决定要不要上手之前,这几个数字最好先记住:
| 项目 | 参数 |
|---|---|
| 最高分辨率 | 2K(2560×1440) |
| 最长时长 | 15 秒 |
| 帧率 | 24 FPS |
| 音频 | 原生双声道立体声 |
| 首发推理 | 仅全注意力(稀疏注意力后续更新) |
| 开源基座输出 | 768p(2K 需 Regenerate 模块) |
15 秒这个长度决定了它现在最适合的是短镜头、单场景、素材级生成,而不是长叙事。想做完整片子,仍然需要在外层做分镜和拼接。
谁该现在就去看看它
按使用场景做个判断,比笼统说「很强」有用:
| 你是谁 | 建议 | 理由 |
|---|---|---|
| 视频生成方向的研究者 | 强烈建议 | 全模态统一建模 + 双 VAE 联合预测,是很好的研究基座,权重完整可微调 |
| 想做多模态产品的团队 | 建议先用 API | 开源版缺 Context-IR,直接自建成本不低,先用 API 验证再定 |
| 内容创作者 | 看 15 秒够不够 | 短素材、分镜级生成完全够用;长片仍需外层编排 |
| 只想跑个 demo 的爱好者 | 可以试 768p | H3-Base 权重完整,能跑通,别期待官方演示级画质 |
| 有国产算力适配需求的企业 | 值得跟进 | 官方明确做过多款国产芯片兼容 |
本文重点回顾
- 8 月 6 日凌晨,MiniMax H3 权重正式开源,这是该公司第一个开源的多模态生成模型;
- 核心变化是「任务边界消失」——文生视频、图生视频、视频编辑、音频生成在预训练阶段就统一建模,用自然语言描述任务;
- 音频不是后期配的,Omni-Transformer 联合预测视频和音频 latent,双声道原生对齐;
- 2K 不靠超分,而是把 768p 结果连同原始上下文喂回基模做 in-context 重生成,能还原超分「猜不出来」的小文字细节;
- 33B 参数里约 13B 在 AdaLN 分支,纯推理部署不需要加载;
- 4 倍序列压缩是成本优势的根,2K 单价约为同类的 1/3;
- 开源有边界:Context-IR、Regenerate-2K、稀疏注意力这三块首发没给,官方承诺后续;
- 对使用者最实际的一句话:你拿到的是一个强大的 768p 基座,不是官方 Demo 的一键复刻包。
延伸阅读
- MiniMax 官方技术博客:
minimaxi.com/blog/minimax-h3 - GitHub 仓库:
github.com/MiniMax-AI/MiniMax-H3 - HuggingFace 模型页:搜索
MiniMax-H3 - Artificial Analysis 视频模型榜单(视频编辑项)