跑分第三却把价格打穿地板:Meta 的 Muse Code 凭什么让 Claude Code 紧张
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../muse-code-recommend.pptx../../muse-code-recommend.mp4本文目录
跑分第三却把价格打穿地板:Meta 的 Muse Code 凭什么让 Claude Code 紧张
当所有人都在卷跑分,Meta 选择把价格打穿地板。跑分不是第一没关系——它把编程 Agent 的标价,压到了竞品的零头。
为什么这篇值得写?
2026 年 8 月 5 日,扎克伯格亲自在 X 上官宣:Meta 第一款终端编程智能体 Muse Code 开放测试。它跑在全新的 Muse Spark 1.2 模型上,一行命令装好,对标 Claude Code 和 Codex。
但真正有意思的不是"Meta 终于出招了"。而是它的打法:公开跑分只排第三,价格却直接打到第一。在 Claude Code、Codex 把编程 Agent 变成工程师标配的当下,Meta 用一种很"老钱"的方式切入——不跟你比谁更聪明,跟你比谁更便宜、更不容易崩。
如果你正在用或准备用 AI 编程工具,这篇文章能帮你搞清楚三件事:Muse Code 到底强在哪、它和 Claude Code 差在哪、以及"便宜"背后藏着什么代价。
它是什么:Meta 的第一款编程 Agent
Muse Code 是一个跑在终端里的编程智能体。它接管的是软件研发的全流程:先规划改动、再写代码、最后跑测试验证结果。官方把它叫作 "an agent for your most complex coding workstreams"。
它底层是 Muse Spark 1.2——一个和 Agent 框架**一起训练(co-trained)**出来的模型,不是拿现成模型套个壳。这一点很关键,后面会展开。
它支持多 Agent 协同:面对大任务,系统会拆出独立的子智能体,在隔离的 git worktree 里并行干活,互不踩对方的本地副本。Meta 在发布时演示了同时给一款游戏开发 6 项功能,彼此没有代码冲突。
反常识:跑分第三,价格第一
先看跑分。Meta 自报的 Muse Spark 1.2 成绩如下(注意:这些是厂商自测,独立复现尚未完成,先当上限看):
| 基准测试 | Muse Spark 1.2 | Claude Opus 5 | GPT-5.6 | DeepSWE v1.1 |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 82.9% | 86.7% | 81.8% | 59.3% |
| DeepSWE v1.1 | 59.3% | 65.0% | 64.8% | — |
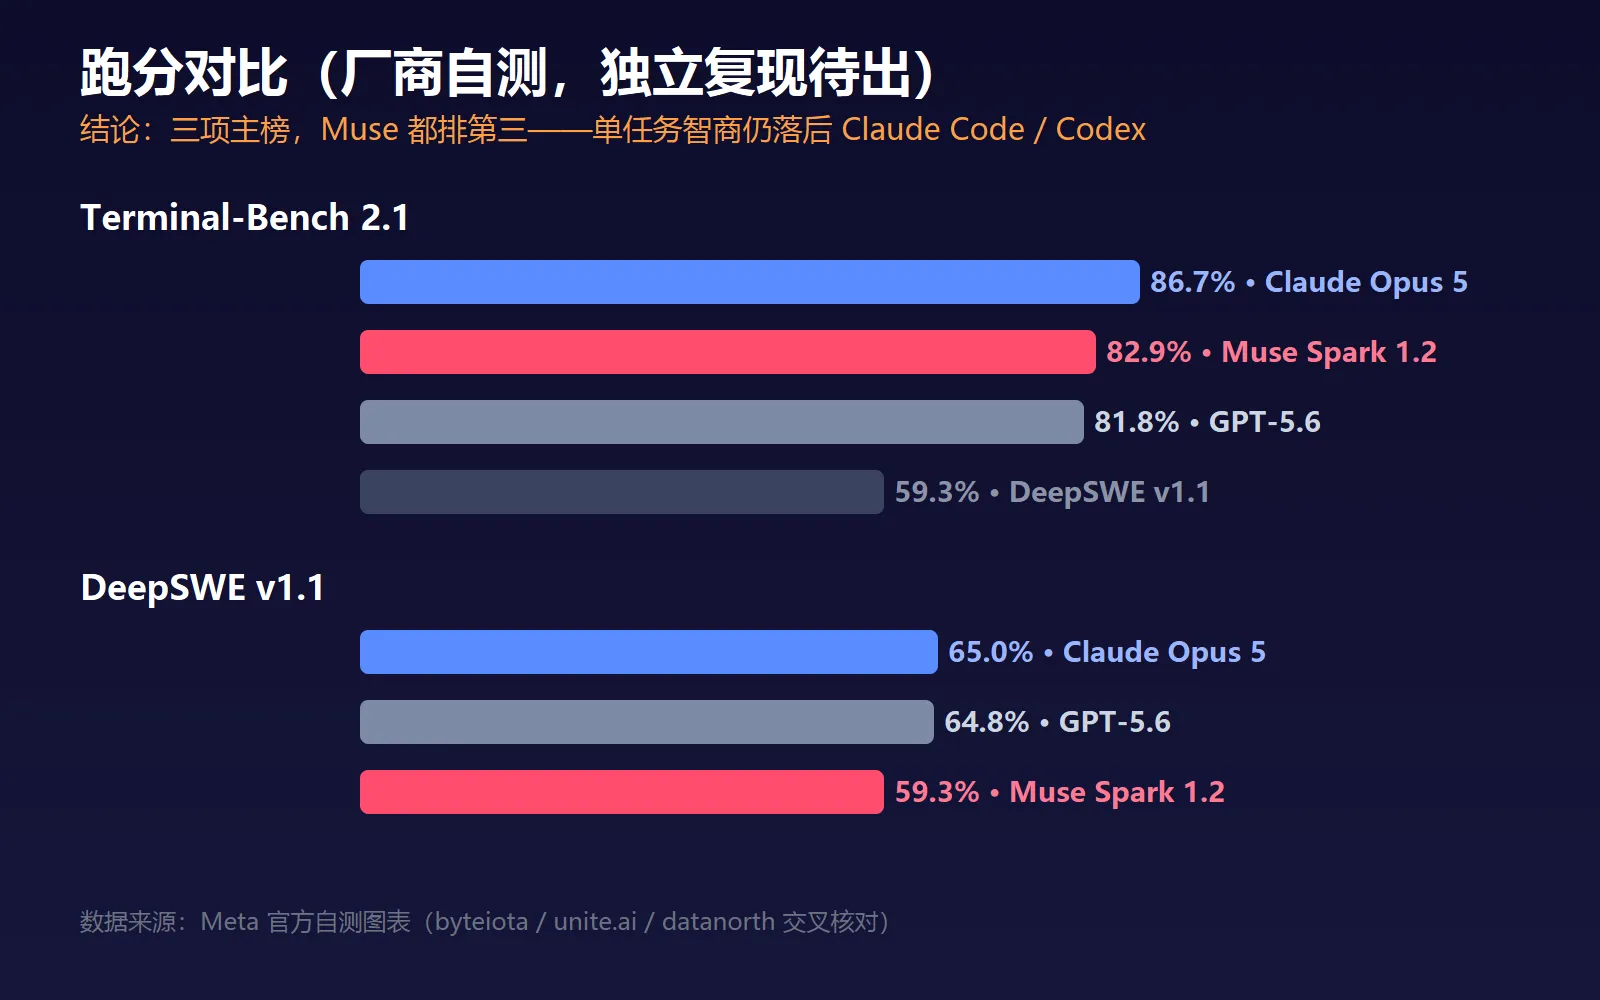
结论很直白:三项主榜,Muse 都排第三。如果只盯着跑分,Claude Code 和 Codex 现在都更强。TechCrunch 也直言,Muse Code 真正的技术差异化不在分数,而在架构。
但一转到价格,局势立刻反转:
| 档位 | 输入 / 百万 token | 缓存输入 | 输出 / 百万 token | 备注 |
|---|---|---|---|---|
| 标准档 | $1.25 | $0.15 | $4.25 | 数据不用于训练 |
| 贡献者档 | $0.10 | $0.002 | $0.20 | Meta 可用你的数据训练 |
| Muse Code(每任务成本) | — | — | ≈ $0.58 | VentureBeat 测算 |
| Claude Code / Opus 4.8(每任务) | — | — | ≈ $0.82 | VentureBeat 测算 |
| Codex(每任务) | — | — | ≈ $5.57 | VentureBeat 测算 |
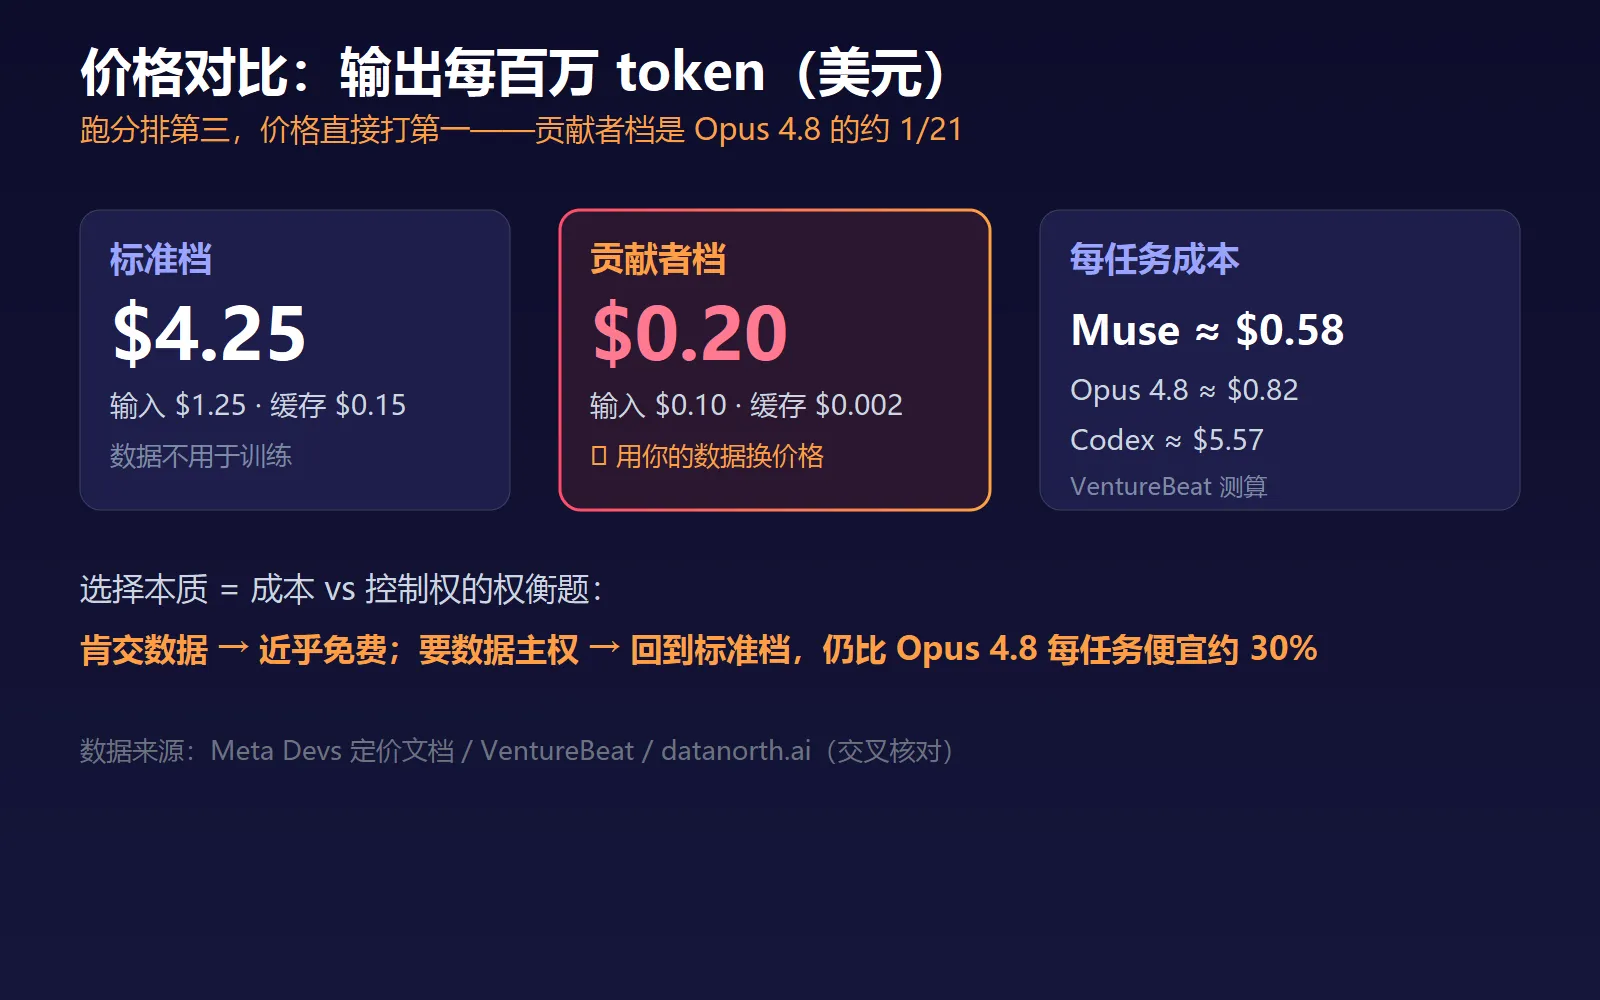
VentureBeat 按"每个解决的任务"算总账:标准档下 Muse Code 平均每任务 $0.58,比 Opus 4.8 的 $0.82 还便宜;贡献者档更是打到 $0.20/百万输出,相当于 Opus 4.8 的约 1/21。扎克伯格的策略说白了就是:性能拼不过,就把价格打成地板价。
3 分钟上手:一行命令装好
安装只需要一行:
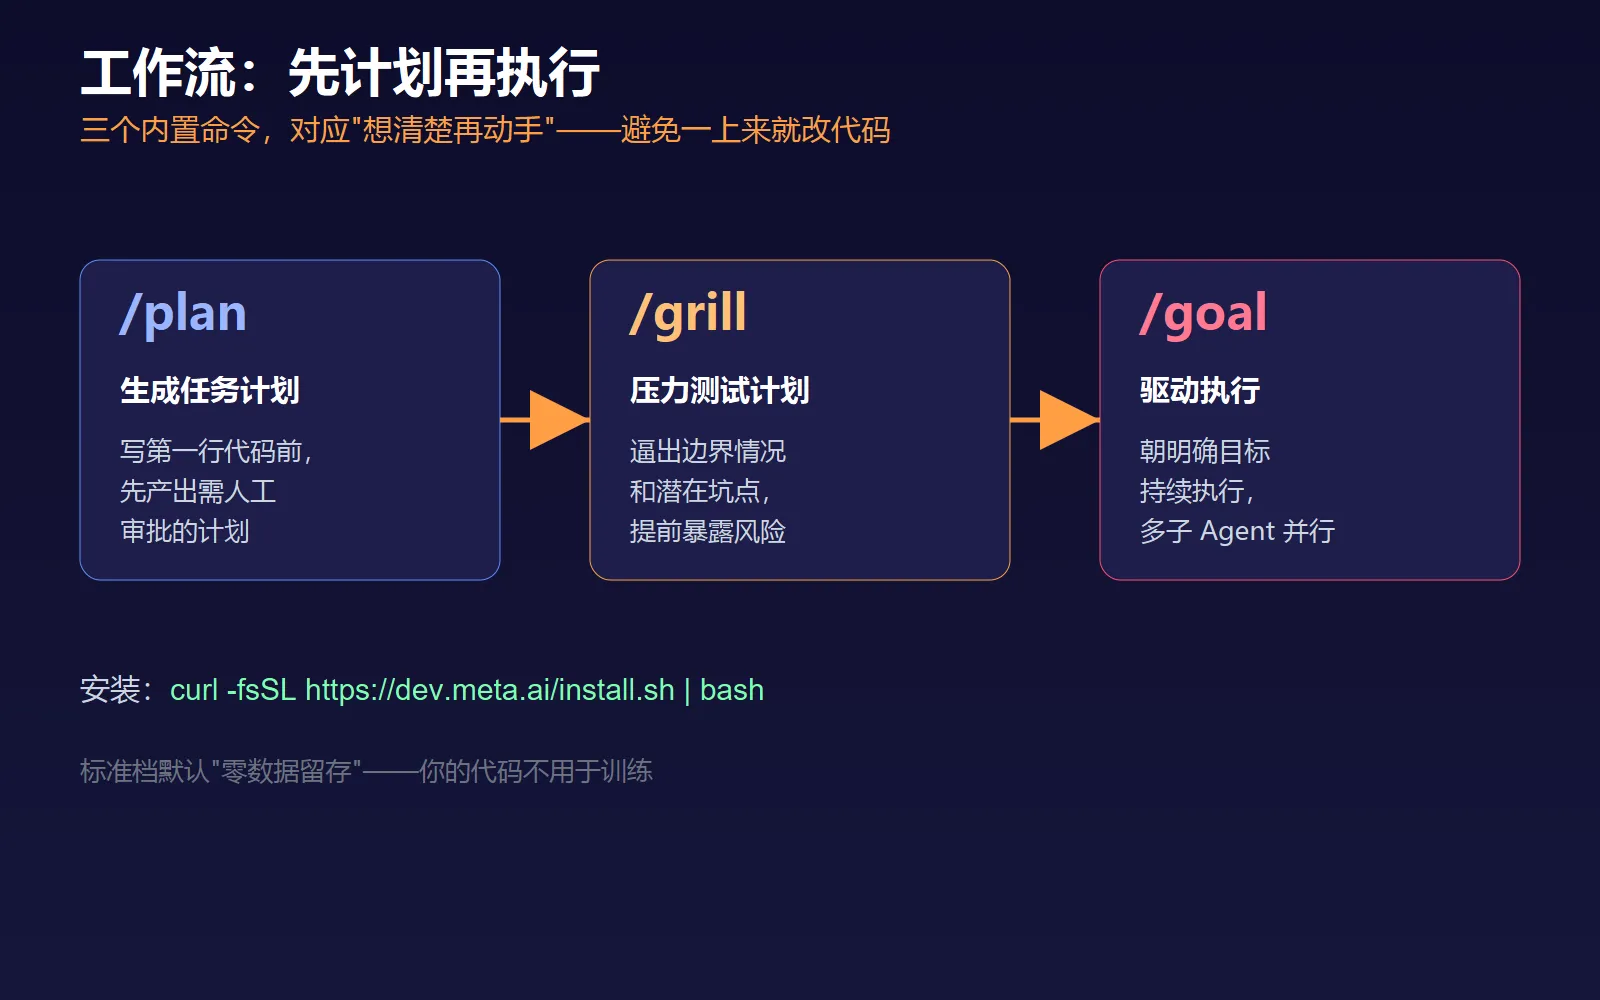
curl -fsSL https://dev.meta.ai/install.sh | bash
装好后,Muse Code 自带三个工作流命令,对应"先想清楚再动手":
/plan:在写第一行代码前,先生成一份需要人工审批的任务计划;/grill:对这份计划做"压力测试",逼出边界情况和坑;/goal:驱动 Agent 朝一个明确目标持续执行。
它还带一个"零数据留存"开关——标准档默认不收集你的代码用于模型迭代。这对企业客户是核心卖点。
核心一:模型和 Agent 一起练(co-trained)
大多数编程 Agent 是"通用模型 + 外部脚手架":模型是别人的,Agent 框架自己写,两者靠 prompt 和工具调用勉强咬合。
Muse Code 不一样。Muse Spark 1.2 是和 Agent 框架联合训练出来的。Meta 的说法是,这种配对带来更好的工具调用、更少的重试、更高质量的产物——因为模型在训练时就已经"知道"Agent 会怎么用它。这就像给司机配了一辆按他驾驶习惯调校的车,而不是随便租一辆。
代价是:模型权重不开放,没有 HuggingFace 仓库,也没有自托管路径。Llama 时代"下载权重自己跑"的习惯,到了 Muse 家族不再适用。
核心二:崩溃可续跑——这才是真护城河
这是 Muse Code 最值得开发者记住的一点。
它维护一份本地只追加(append-only)事件日志:每一次模型调用、工具运行、审批、编辑,都在执行前写进日志。Agent 中途崩了——网络断了、机器重启了、任何意外——它都能从断点精确恢复(replay-exact and restart-safe)。
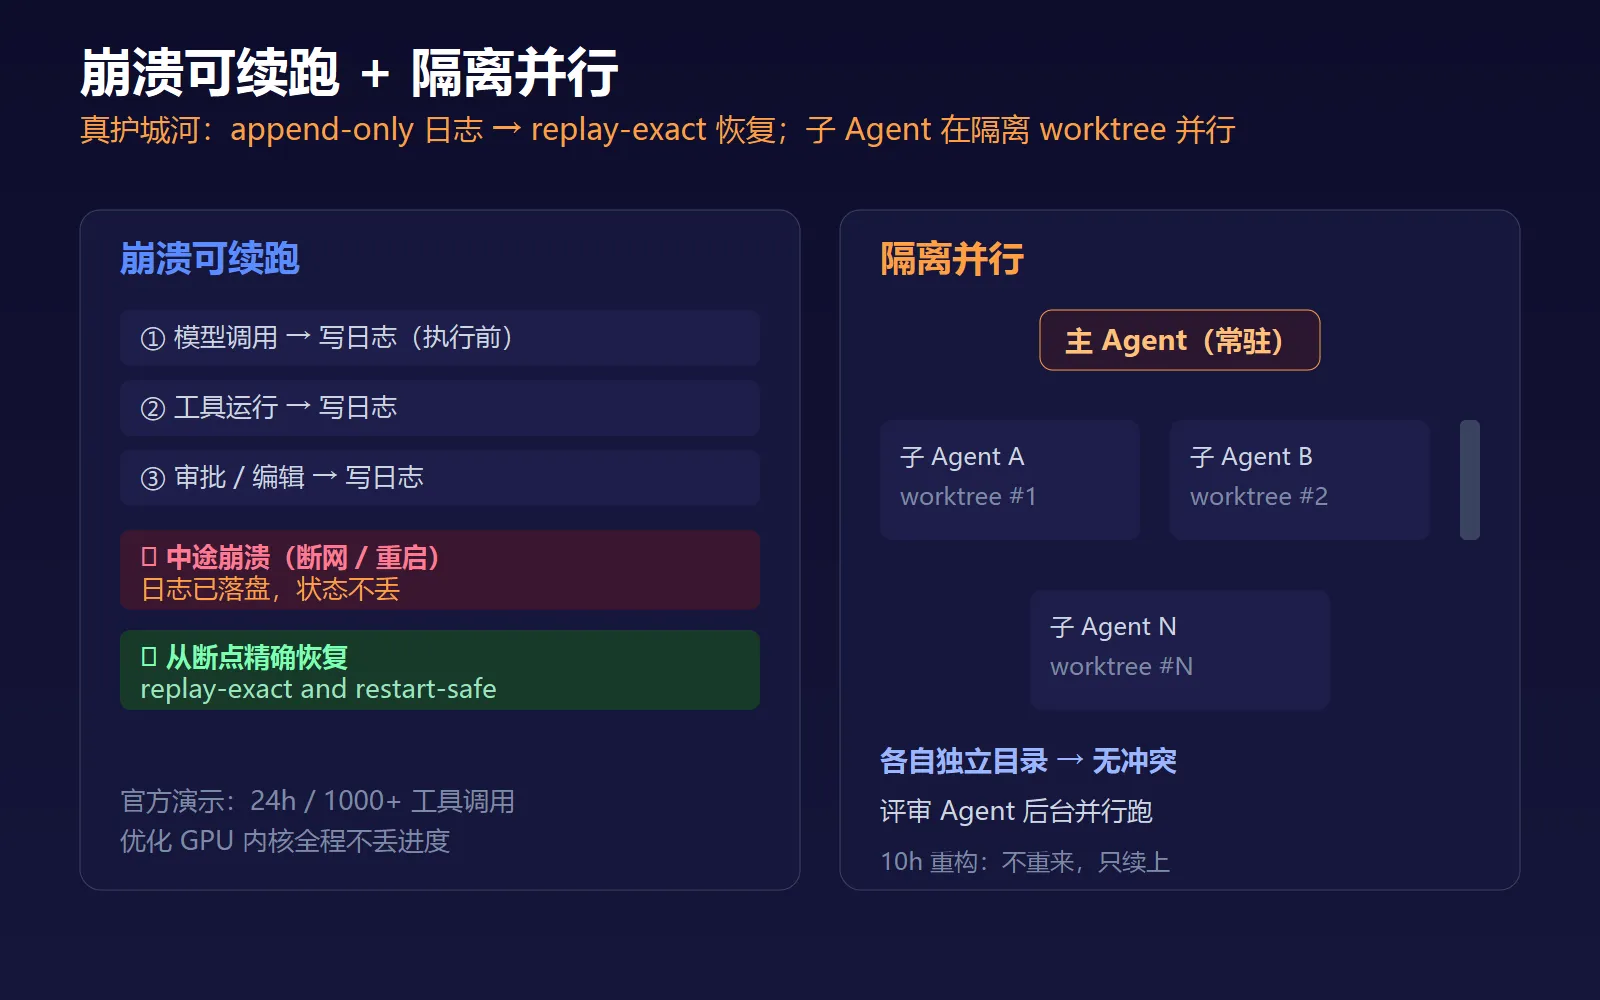
为什么这重要?因为竞品在每次任务交接时,往往重新收集上下文;而 Muse Code 跑的是常驻异步后台 Agent,整个会话期间持续积累上下文。10 分钟的小任务,这点差距无所谓;但跑 10 小时的重构,差距就是"崩了重来"和"崩了续上"的天壤之别。
TechCrunch 把这套"崩溃安全运行时"评价为 Muse Code 区别于对手的技术边缘。它还有个隐藏价值:那份只追加日志本身就是一份合规审计轨迹——在受监管的工作流里,能追溯 Agent 每一步干了什么,不是加分项,是刚需。
核心三:多个子 Agent 在隔离工作区并行
大任务下,Muse Code 会拆出独立子智能体,在隔离的 git worktree 里并行实现,评审 Agent 同时在后台跑。因为每个子 Agent 有自己独立的工作目录,不会动你的本地副本,所以天然避免冲突。
这正是它敢说"同时开发 6 项功能无冲突"的底气。对动辄几十万行、多模块的工程,这种隔离并行比单 Agent 串行快得多,也更安全。
真实案例:24 小时优化 GPU 内核
Meta 发布了一个很有说服力的案例:用 Muse Code 对 NVIDIA Hopper GPU 的 KDA 和 MLA 内核做迭代优化,跑超过 1000 次工具调用、最长 24 小时,全程可恢复。模型自己写了、编译了、profiled 了,并逐步改进内核——而且中途任何中断都能续上。
这不是 benchmark 分数,是真实长任务的工程能力演示。对做底层优化、编译器、推理加速的团队,这种"跑一整天不丢进度"的特性,比多 3 分跑分实用得多。
反转:权重不开放,"便宜"靠数据换
文章写到这里,必须泼盆冷水,否则就是软文。
Muse Code 的"便宜"有两个前提,你得想清楚:
- 权重闭源。没有 HF、不能自托管、不能微调。你用的是 Meta 的 API,不是你自己的模型。Llama 时代的"开源自由"在 Muse 家族不存在。
- 贡献者档用数据换价格。每百万输出 $0.20 的诱人低价,交换条件是 Meta 可以用你发过去的数据训练未来的模型。你写的是什么代码、归谁所有,在选这个档位前要想清楚。标准档不收集数据,但价格贵 21 倍。
所以选择本质是一道成本 vs 控制权的权衡题:肯交数据 → 近乎免费;要数据主权 → 回到 $4.25/百万输出的标准档,仍然比 Opus 4.8 每任务便宜,但不再是"地板价"。
开发者怎么选?
给你一个速查判断:
- 跑长任务、怕崩、要审计轨迹 → Muse Code 的崩溃续跑是硬优势,优先试。
- 纯比智商、要最强单任务表现 → 现阶段 Claude Code / Codex 跑分仍领先,Muse 排第三。
- 极度在意数据主权 → 选标准档,别碰贡献者档;或者继续用可自托管的开源方案。
- 想压成本 → 标准档每任务已比 Opus 4.8 便宜约 30%;贡献者档便宜到夸张,但交数据。
重点回顾
- Meta 第一款编程 Agent Muse Code 已开放测试,底层是 Muse Spark 1.2,一行命令装好。
- 跑分排第三,但价格打第一:标准档 $4.25/百万输出,贡献者档 $0.20,每任务成本约 $0.58。
- 真护城河是崩溃可续跑(append-only 日志 + replay-exact)+ 常驻 Agent 积累上下文 + 隔离 worktree 并行。
- 模型和 Agent 联合训练,工具调用更顺,但权重闭源、不能自托管。
- "便宜"的代价:贡献者档用你的数据换价格,选之前想清楚 IP 归属。
延伸阅读
- Meta 官方 Muse Code 产品页与 Muse Spark 1.2 benchmark 图(厂商自测,独立复现待出)
- VentureBeat:Muse Spark 每任务成本对比分析
- TechCrunch:Muse Code 崩溃安全运行时评测
- unite.ai / datanorth.ai:Muse Spark 1.2 定价与可用性详解
一句话收尾:Meta 没在跑分上赢,但它可能先在账面上赢了——对一个跑一整天的重构任务来说,不崩、便宜、能追溯,往往比多 3 分跑分更值钱。