【字节开源】LatentSync:基于潜在扩散模型的AI唇形同步框架
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../latentsync-recommend.pptx../../latentsync-recommend.mp4本文目录
【字节开源】LatentSync:基于潜在扩散模型的AI唇形同步框架
开源地址:bytedance/LatentSync | 5,779 ⭐ | 948 🍴 | 协议:Apache-2.0 | 语言:Python
字节跳动联合北京交通大学开源的端到端唇形同步框架,采用音频条件潜在扩散模型技术,无需中间 3D 表示或 2D 特征点,直接从音频生成完美口型同步的视频。
适用场景
场景一:多语言视频本地化配音
将原视频中的外语配音替换为中文或其他语言,LatentSync 自动生成匹配新语言的唇形动作,让译制片级别的本土化制作变得轻而易举。
核心流程:上传原视频 → 输入目标语言音频 → LatentSync 生成唇形同步视频 → 下载成品
技术亮点:LatentSync 1.5 版本特别优化了中文视频支持,中文口型准确度显著提升。
场景二:虚拟主播与数字人口播视频
为虚拟数字人主播生成自然流畅的口型同步,无需逐帧手调口型动画,大幅降低虚拟直播内容制作成本。
适用人群:知识博主、企业培训讲师、教育内容创作者、直播带货主播
效率对比:传统流程需动画师逐帧绘制口型序列,LatentSync 只需上传录制好的视频 + 音频,数分钟即可生成。
场景三:影视后期配音与动画对口型
电影配音演员录制对白后,通过 LatentSync 可将配音演员的真实口型迁移至屏幕角色上,避免昂贵的后期唇形修正工序。
传统流程痛点:好莱坞电影后期配音后需逐帧修改角色口型,费用高昂且耗时数周。
LatentSync 方案:上传角色视频 + 配音音频,自动完成口型匹配,分辨率可达 512×512。
场景四:游戏 NPC 对话动画
游戏开发团队可使用 LatentSync 为 NPC 角色生成与对话语音完全匹配的口型动画,替代传统的关键帧口型动画制作。
应用场景:RPG 角色扮演游戏、视觉小说、互动式剧情游戏
优势:一次性录制语音后自动生成口型动画,支持大量 NPC 对话内容的高效批量生产。
上手指南
快速体验
- Gradio Web 界面:
python gradio_app.py # 启动本地 Web 界面
- 命令行推理:
./inference.sh --video input.mp4 --audio audio.wav --output output.mp4
环境要求
| 组件 | 最低要求 | 推荐配置 |
|---|---|---|
| GPU 显存 | 8 GB (1.5 版) / 18 GB (1.6 版) | 24 GB+ |
| CUDA | 12.1+ | 12.4+ |
| Python | 3.10 | 3.10.13 |
| 硬盘 | 20 GB(含模型) | 50 GB+ |
| 视频分辨率 | 256×256 | 512×512 |
安装步骤
# 1. 克隆仓库
git clone https://github.com/bytedance/LatentSync.git
cd LatentSync

# 2. 创建 conda 环境
conda create -n latentsync python=3.10.13
conda activate latentsync

# 3. 安装依赖
pip install -r requirements.txt
conda install -c conda-forge ffmpeg

# 4. 下载预训练权重
huggingface-cli download chunyu-li/LatentSync \
  --local-dir checkpoints --exclude "*.git*" "README.md"
竞品对比
主流唇形同步工具对比
| 维度 | LatentSync | Wav2Lip | MuseTalk | SadTalker |
|---|---|---|---|---|
| 技术路线 | 潜在扩散模型 | GAN | 扩散模型 | 关键点驱动 |
| 开源状态 | ✅ 开源 (Apache-2.0) | ✅ 开源 | ✅ 开源 | ✅ 开源 |
| 最低显存 | 8 GB | 4 GB | 12 GB | 6 GB |
| 输出分辨率 | 512×512 | 256×256 | 512×512 | 256×256 |
| 中文支持 | 1.5 版优化 | 有限 | 有限 | 有限 |
| 时间一致性 | TREPA 技术 | 一般 | 较好 | 一般 |
| 部署难度 | 中等 | 简单 | 中等 | 简单 |
| 最新版本 | 1.6 (2025-06) | 稳定 | Beta | Alpha |
LatentSync 1.5 vs 1.6 版本对比
| 维度 | 1.5 版 | 1.6 版 |
|---|---|---|
| 训练分辨率 | 256×256 | 512×512 |
| 时间一致性优化 | 时间层 | TREPA + 时间层 |
| 中文视频支持 | 已优化 | 进一步优化 |
| Stage 2 显存需求 | 30 GB / 20 GB 高效版 | 20 GB 高效版 |
| 适用场景 | 快速部署、低显存 | 高质量输出、专业制作 |
技术架构
LatentSync 采用音频条件潜在扩散模型,其核心架构如下:
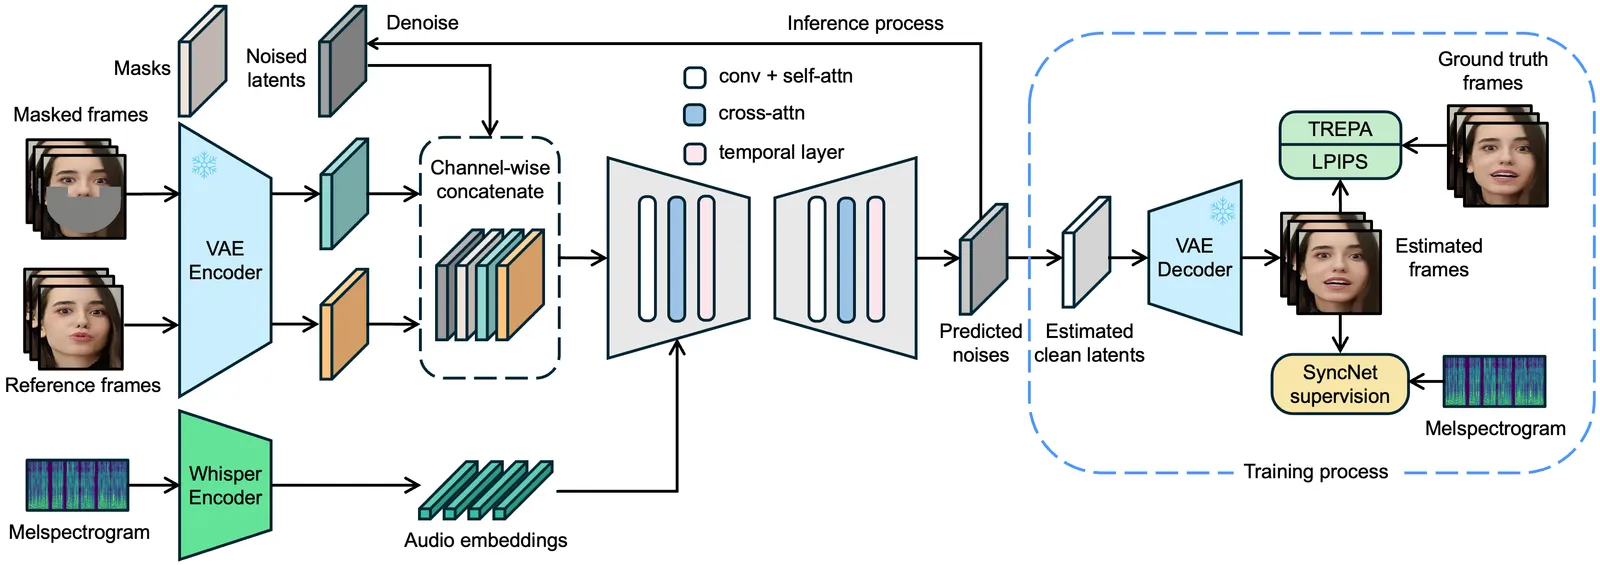
四大核心技术:
音频条件潜在扩散模型:以音频为条件,直接在潜在空间建模复杂的视听关系,无需中间 3D 表示或 2D 特征点
Stable Diffusion 赋能:利用 Stable Diffusion 强大的生成能力,直接捕捉复杂的视听关联,使生成的唇部运动更自然、逼真
TREPA(时间表示对齐):通过 VideoMAE-v2 提取时间表示,计算连续帧之间的时间距离作为损失,增强时间一致性,减少闪烁
SyncNet 监督:训练时用预训练的 SyncNet 对生成视频进行监督,确保唇形同步准确度
定价与获取
| 版本 | 价格 | 说明 |
|---|---|---|
| 开源版 | 免费 | GitHub 仓库,本地部署,需自备 GPU |
| Web 在线版 | 免费试用 + 付费订阅 | latentsync.org 提供云端服务,免费版本可能有排队 |
总结
LatentSync 代表了当前开源唇形同步技术的最高水平——端到端的潜在扩散模型方案,无需中间表示,直接学习音视频关联性。其核心优势在于生成质量高(512×512 分辨率)、时间一致性佳(TREPA 技术)、中文支持好(1.5 版专项优化)。
对于追求高质量口型同步效果的专业制作团队,LatentSync 是目前最佳选择。配合 Gradio Web 界面,部署门槛已经大幅降低,即使是非深度学习背景的开发者也能轻松上手。