Lanshu Create AI Presenter Video
本文目录
📌 核心价值:一张授权人像 + 一段文案,让 AI Agent 全自动产出带字幕、口型校准的数字人口播视频,而且不绑定任何付费服务商。
做口播、做知识短视频,最怕两件事:要么真人天天出镜累,要么买 HeyGen 这类会员月月扣 29 美元。今天这个开源 Skill,把「脚本→配音→数字人→字幕→剪辑→验收」整条流水线交给 Codex 这类本地 Agent,环境里有什么视频和语音能力就用什么,换模型不用改一行代码。
🚀 什么是 Lanshu Create AI Presenter Video?
lanshu-create-ai-presenter-video 是开发者「岚叔」刚开源(2026-08-20)的一个面向 Codex 的通用数字人视频制作 Skill,目前 GitHub 已冲到 851⭐、MIT 协议。
它解决的核心痛点很直接:你只给一个主题或一份文案,再给一张经过授权的清晰成年人像,剩下的配音、人物生成、口型校准、字幕与关键词动效、剪辑、渲染和质量验收,全部由 Agent 按一套固定 SOP 跑完。
核心定位:提供商中立——项目源码不绑定任何服务商、模型名称或私有接口,环境里有什么能力就用什么。
换句话说,它不像 HeyGen、D-ID 那样把你锁在自家云端按时长收费,而是一个「视频生产 SOP」,装进 Codex / OpenCode / Cursor 这类支持本地 Skill 的 Agent 环境就能反复用。
✨ 核心工作流:6 个阶段一条龙
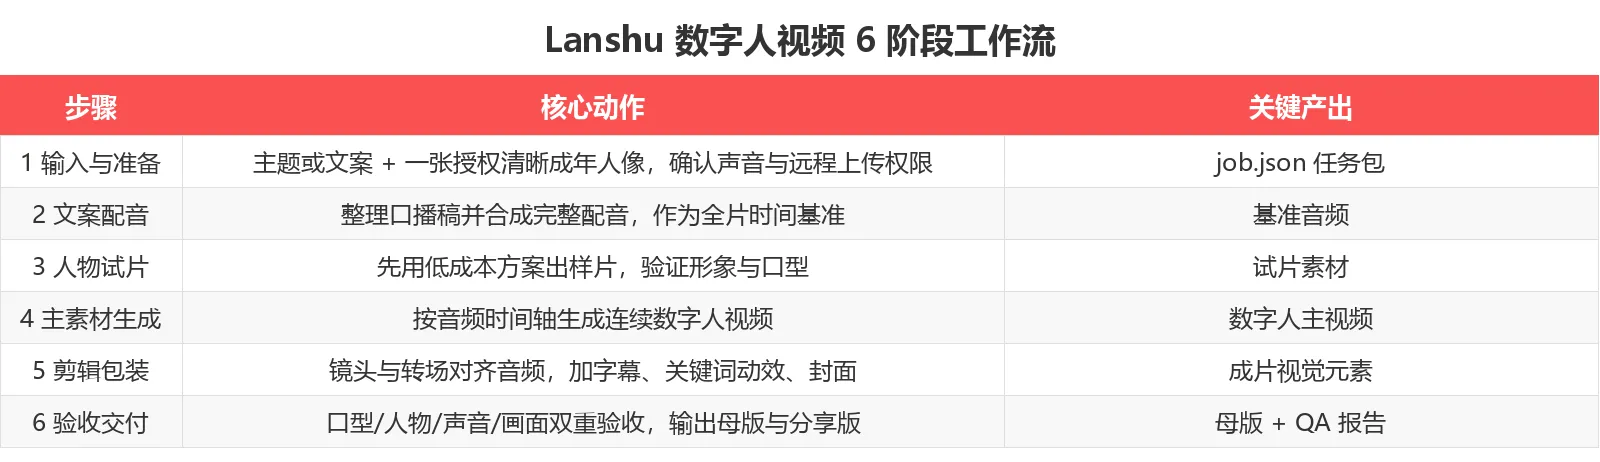
整条流水线最妙的一点是:完整配音是全片的时间基准。人物视频、字幕、镜头、关键词与转场全部按同一条音频定位,从根本上减少口型漂移和片段衔接问题。
- 输入与准备:主题/文案 + 授权人像,确认声音与远程上传权限,生成
job.json任务包。 - 文案配音:整理口播稿并合成完整配音,作为全片时间基准。
- 人物试片:先用低成本方案出样片,验证形象与口型。
- 主素材生成:按音频时间轴生成连续数字人视频。
- 剪辑包装:镜头转场对齐音频,加实时字幕、关键词动效和封面。
- 验收交付:口型、人物、声音、画面双重验收,输出母版、分享版和 QA 报告。
🛠️ 快速上手:5 分钟装好
它是标准 Codex Skill,安装就是一条 clone:
git clone https://github.com/cclank/lanshu-create-ai-presenter-video.git \
  ~/.codex/skills/lanshu-create-ai-presenter-video
装好后,可以先初始化一个标准任务目录,把人像和主题喂进去:
SKILL_DIR=~/.codex/skills/lanshu-create-ai-presenter-video

python3 "$SKILL_DIR/scripts/init_job.py" \
  --job-dir ~/Videos/my-presenter-video \
  --presenter-image ~/Pictures/presenter.png \
  --topic "视频主题" \
  --duration 60 \
  --aspect 9:16 \
  --rights-confirmed \
  --adult-presenter-confirmed

# 补全 job.json 中的人工检查与远程上传许可后再预检
python3 "$SKILL_DIR/scripts/preflight.py" ~/Videos/my-presenter-video/job.json
也可以直接在对话里说:「使用 $lanshu-create-ai-presenter-video,把这份文案和人物图做成一条 16:9、30 秒、有实时字幕的数字人讲解视频。」
注意:运行前必须确认 Python 3.9+、FFmpeg/ffprobe 已装,并且环境里至少有一种可调用的视频生成、语音生成与口型同步能力——它是「指挥官」,不是「工厂」。
📊 跟商业数字人工具比,它强在哪?
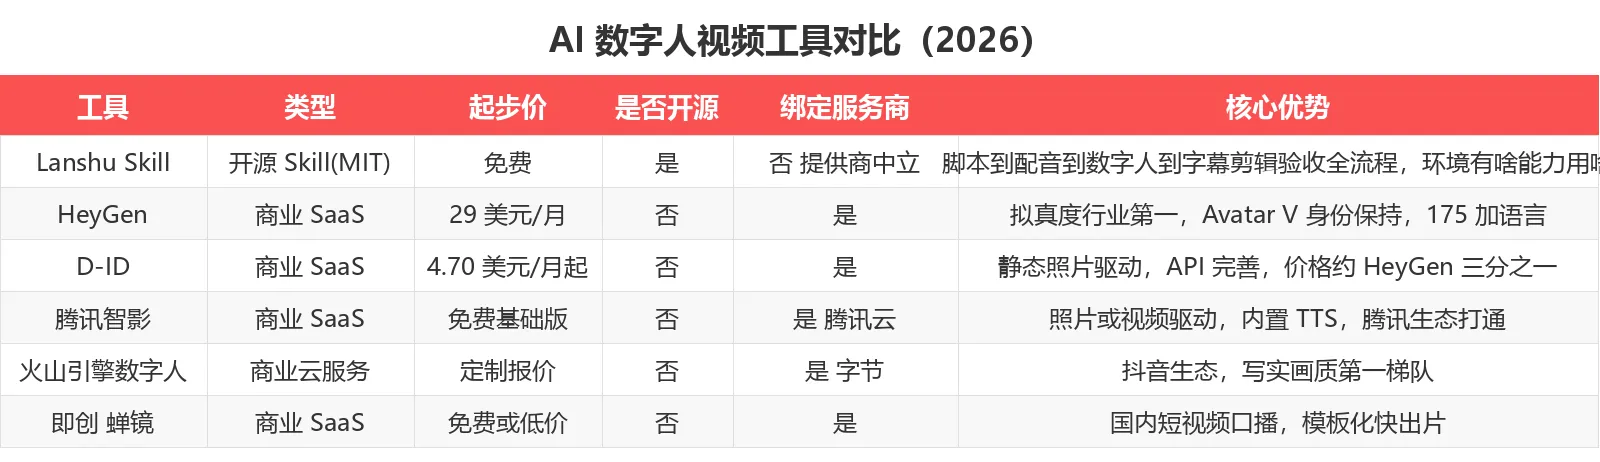
一眼看清定位:HeyGen、D-ID、腾讯智影、火山引擎这些都是商业 SaaS/云服务,绑定自家模型按时长或订阅收费;而 Lanshu 是 MIT 开源、提供商中立的 Skill——你已有的 Agent 能力和账号直接复用,没有平台抽成。
最大卖点:不绑定服务商,换模型不动代码;还内置质量门禁,保障产出可交付。
代价是它不是开箱即用的网页工具:需要本地 Agent 环境 + FFmpeg + 至少一种生成能力。所以它更适合「已经有 Agent 工作流、想批量标准产出口播视频」的创作者和团队,而不是纯小白。
💡 最少要准备什么?默认怎么出片?
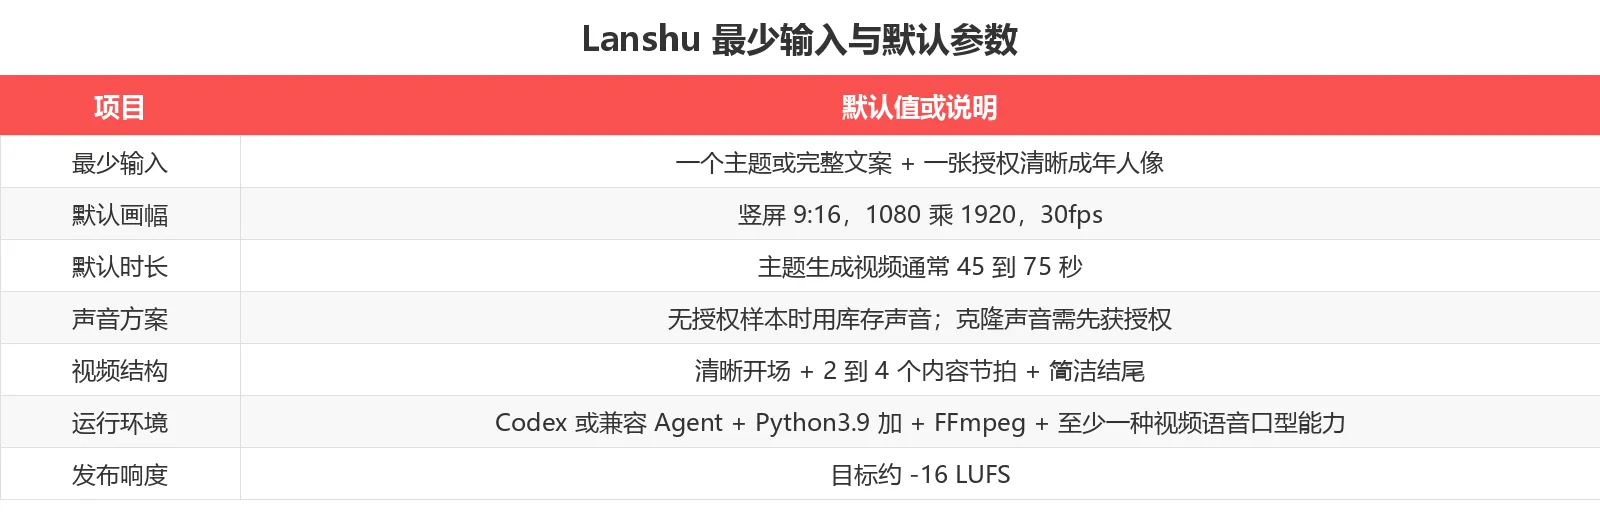
- 最少输入:一个主题或完整文案 + 一张授权清晰成年人像。可选声音样本、B-roll、品牌素材、目标平台、横竖屏、时长、风格等。
- 默认画幅:竖屏 9:16、1080×1920、30fps,主题生成视频通常 45–75 秒。
- 结构:清晰开场 + 2–4 个内容节拍 + 简洁结尾,发布响度目标约 -16 LUFS。
下面是它能产出的成片效果概念——数字人讲解员配上实时字幕和关键词高亮:
🎯 适用人群与优劣势
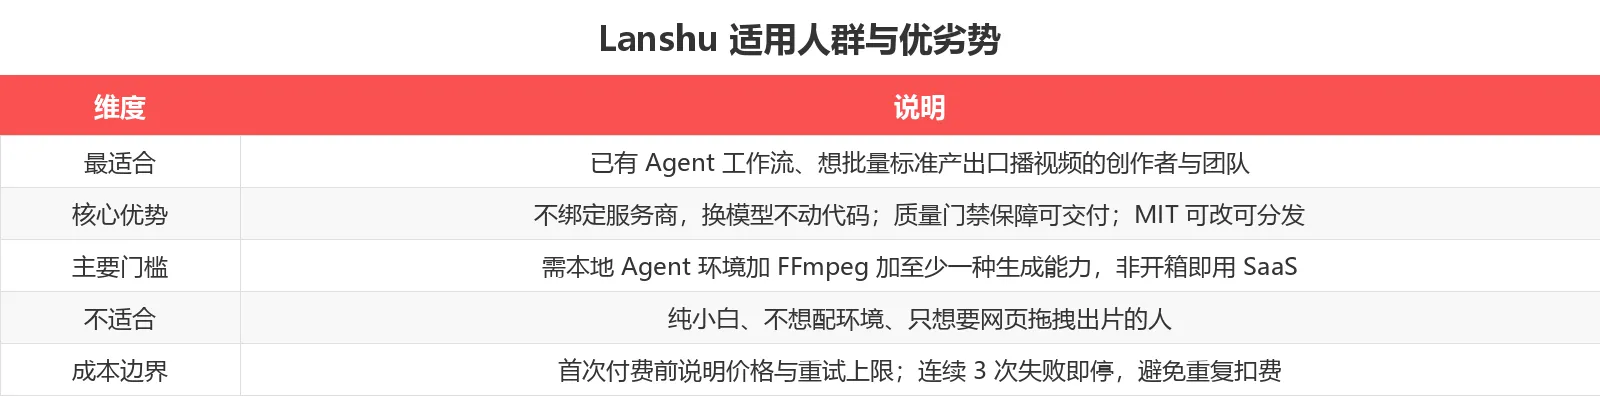
成本边界很克制:首次付费生成前必须说明上传内容、时长、价格依据和重试上限;任务中断优先查已有任务 ID 避免重复扣费;连续三个付费候选失败就停止。
- ✅ 最适合:已有 Codex/OpenCode 等 Agent 工作流、需要批量、标准化产出口播视频的创作者与团队。
- ✅ 核心优势:提供商中立、MIT 可改可分发、质量门禁保障交付。
- ❌ 不适合:纯小白、不想配环境、只想要网页拖拽出片的人。
在安全上它也做得到位:远程上传前确认图片使用权和成年人物状态,克隆声音前确认声音授权,仓库不保存任何 API 密钥和用户素材。
💰 定价与开源协议
完全免费开源:MIT License,可以自由使用、修改和分发。你只需要为自己实际调用的视频/语音/口型能力按对应服务商付费——这也意味着没有平台抽成,用多少付多少。
新用户建议:先用库存声音 + 低成本试片跑通一条 30 秒样片,确认形象和口型满意后再上主素材,避免一上来就烧高价额度。
🎯 总结
如果你已经在用 Codex / Cursor / OpenCode 这类 Agent 工具,又苦于数字人视频要么真人累、要么会员贵,这个开源 Skill 值得一试:它把整套视频生产流程工程化、可复用,还把「不绑定服务商」写进了设计基因。
推荐指数: 4.5 / 5(四星半,扣半星是因为需要一定本地环境配置,非纯小白友好)
适合人群: 有 Agent 工作流的创作者、自媒体团队、需要做批量标准口播视频的人
立即体验: GitHub 仓库
数据截至 2026-08-25,最新信息请以官网为准。