深度技术解读:stockstrategylab —— LLM 驱动的 A 股三层多智能体量化研究工作台
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../media/stock_strategy_lab.pptx../media/stock_strategy_lab.mp4本文目录
深度技术解读:stock_strategy_lab —— LLM 驱动的 A 股三层多智能体量化研究工作台
📌 核心价值:把单资产择时、资产池预算、组合融合三件事拆成三个独立的 LLM 智能体,每层都能闭环迭代,让 AI 像真实投研团队一样跑量化策略。
一句话总结:基于 DeepAgents 框架的 A 股专属量化研究系统,三层多智能体(信号层 → 预算层 → 组合层)各自独立运行又可串联,支持 MiniQMT/AKShare 数据,全程 CLI 交互、可介入调整、会话持久化。
⚠️ 风险提示:本文仅作技术交流,不构成投资建议。量化策略存在显著风险,回测结果不代表未来收益。A 股市场受政策、T+1、涨跌停等多重约束,任何开源工具都需先在模拟环境充分验证再考虑实盘。
🚀 什么是 stock_strategy_lab?
stock_strategy_lab 是面向 A 股、ETF 与指数研究的多智能体量化策略工作台,由开发者 adennng 在 GitHub 开源(⭐32,仓库根目录无显式 LICENSE,请联系作者 lizheng202601@163.com 确认商用授权)。它的核心不是"又一个回测框架",而是把多智能体协作模式工程化地搬到量化研究里,让 LLM 真正参与到策略编写、回测评估、复盘归因、迭代优化的完整闭环。
项目最新一次提交在 2026-08-15,主体代码 1249 KB,采用 Python 3.11+ 编写,依赖 DeepAgents/LangChain 框架。仓库内置 30+ 类信号构件(趋势动量、通道突破、均值回归、波动率状态、量价过滤、多周期确认、防御降仓等)和完整的预算层、组合层策略库,扩展策略时改 skill 文档而无需动 Python 主代码——这是它与传统量化框架最大的差异。
核心定位:让"AI 写策略、AI 改参数、AI 自己复盘"成为可工程化复现的标准化工作流,而不是 chat 一下就完事的脚本玩具。
✨ 核心功能一览
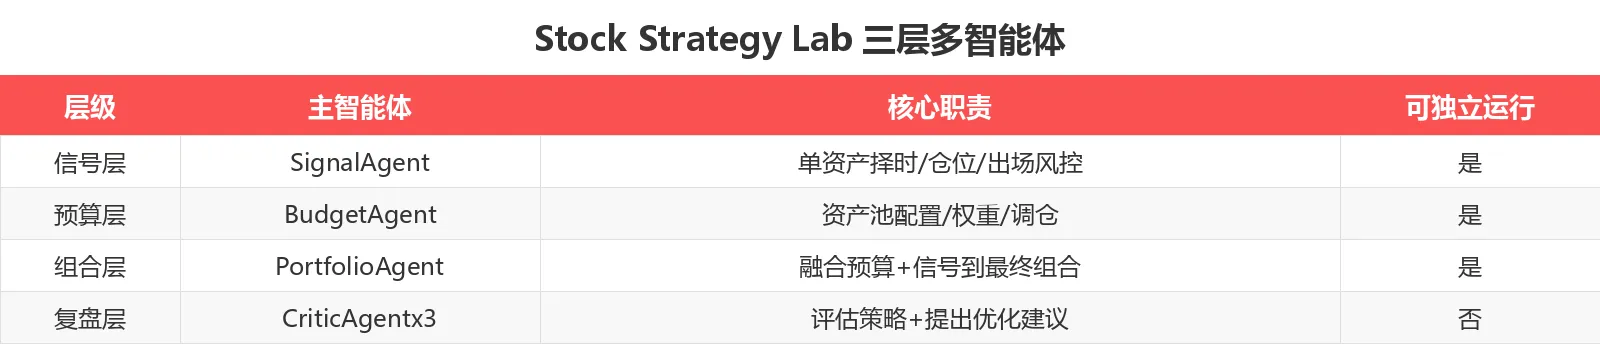
项目的"三层 + 复盘"结构不是噱头,而是基于"投研团队实际分工"的工程化抽象:
- 信号层 SignalAgent:回答"单个资产什么时候买、买多少、什么时候降仓"。内置 RegimeSwitchingAlpha(不同市场状态切换)+ MultiTimeframeAlpha(多周期确认)+ Filters(辅助过滤)+ ExitPolicy(出场风控)+ PositionMapper(仓位映射)+ StateRules(状态纪律)六个可组合模块,覆盖 30+ 类信号构件。
- 预算层 BudgetAgent:回答"一组资产之间资金怎么分"。内置 UniverseGate(资产准入)+ AssetScorer(资产打分)+ AllocationEngine(预算分配)+ RiskOverlay(风险覆盖)+ RebalanceScheduler(调仓节奏)+ ConstraintProjector(约束投影)+ Diagnostics(诊断输出)七个组件,覆盖趋势轮动、低波防御、均衡配置、集中进攻、风险预算、相关性约束六大策略簇。
- 组合层 PortfolioAgent:回答"信号强弱 + 预算权重怎么融合"。支持"信号主导 + 预算约束"、"预算主导 + 信号修正"、"闲置资金再分配"、"市场阶段切换融合"等多种融合逻辑,并通过 LLM 自行探索最优组合公式。
- 复盘子智能体 CriticAgent:每个主智能体都对应一个独立 CriticAgent,专门负责多维度归因(哪些市场阶段好、哪些阶段差、回撤来源、换手率、资金利用率),把复盘结论写回智能体记忆,下次自动规避已踩过的坑。
🛠️ 快速上手:5 分钟跑通三层流程
安装与配置
git clone https://github.com/adennng/stock_strategy_lab
cd stock_strategy_lab
python -m venv .venv
.\.venv\Scripts\activate     # Windows
python -m pip install --upgrade pip
pip install -e ".[quant,agents,data,dev]"
配置 LLM 与数据源
复制 .env.example 到 .env,填入你的 LLM API Key 和 MiniQMT 路径:
DEEPSEEK_API_KEY=your_key_here
DEEPSEEK_BASE_URL=https://api.deepseek.com
DEEPSEEK_MODEL=deepseek-v4-pro

QMT_USERDATA=D:\国金QMT交易端\userdata_miniqmt
QMT_ACCOUNT_ID=your_account
跑信号层:单资产策略生成
python -m strategy_lab.cli init
python -m strategy_lab.cli signal chat
进入交互式 CLI 后,用自然语言提出任务:
> 请为 512880.SH(证券 ETF)生成单资产策略。
> 数据范围 2015-01-01 到 2025-12-31 日线数据。
> 目标优先提高夏普比率,同时控制最大回撤。
> 请自主获取数据、画像分析、编写策略、回测、复盘并迭代,最后选择最终策略。
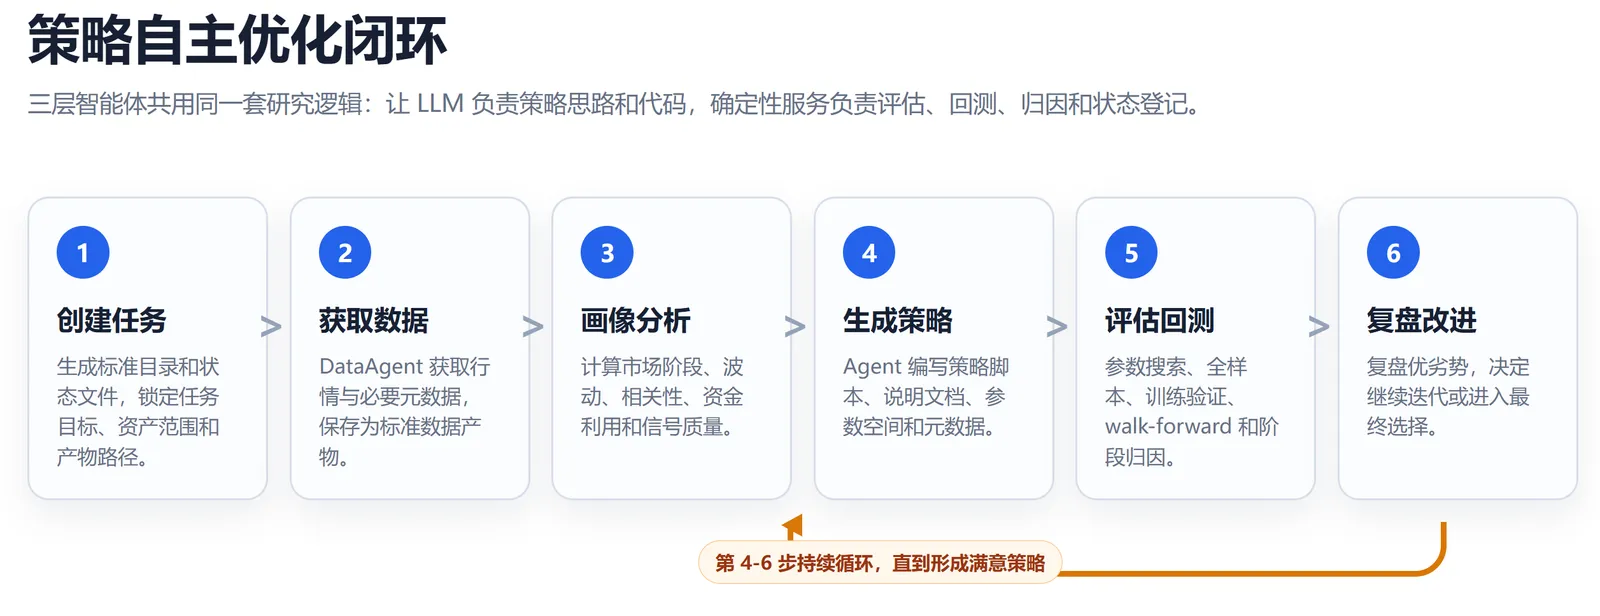
SignalAgent 会自动完成:创建任务目录 → DataAgent 取数 → 数据切分 → 市场画像 → 阅读策略 skill → 编写候选策略 → 回测评估 → CriticAgent 复盘 → 多轮迭代 → 最终选择。
关键能力:每轮 attempt 都独立保存到 attempts/{attempt_id}/,包含策略脚本、参数空间、train/validation/walk-forward 回测、阶段归因、复盘报告,全流程可追溯。
串联预算层与组合层
# 预算层读取多个信号层结果
python -m strategy_lab.cli budget chat
> 请基于 artifacts/signal_runs 下所有已完成最终策略选择的信号层 run,
> 创建预算层任务,训练多资产轮动策略。

# 组合层读取预算层最终结果
python -m strategy_lab.cli portfolio chat
> 请基于 artifacts/budget_runs/{budget_run_id} 创建组合层任务,
> 探索预算+信号融合策略,最后选择最终组合策略。
📊 与同类 AI 量化平台对比
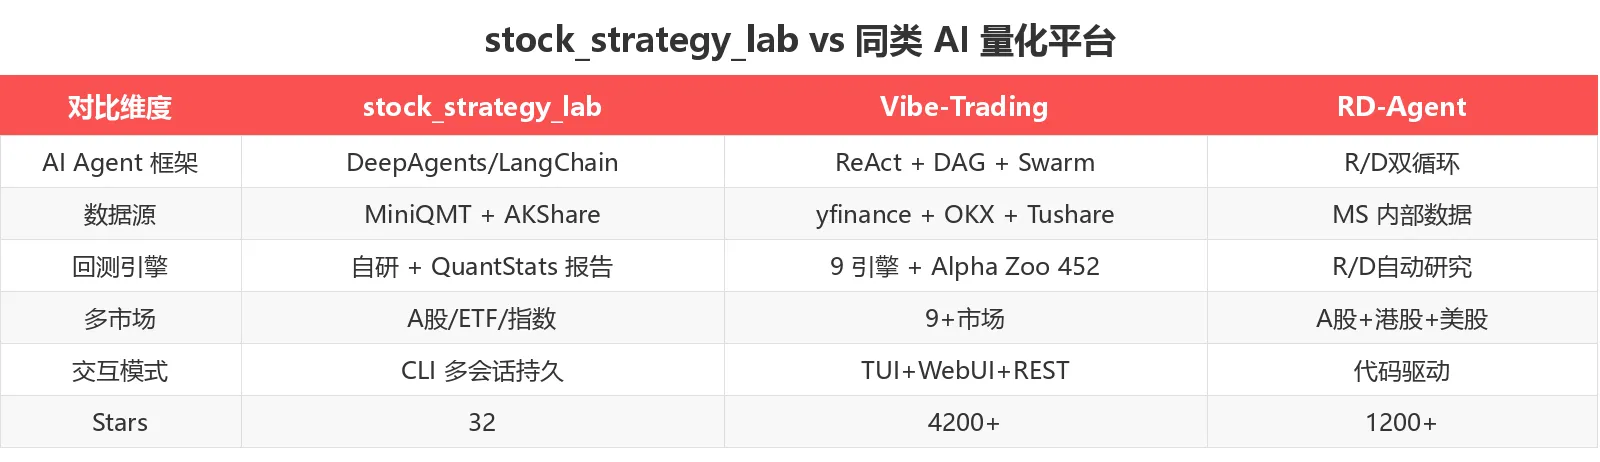
和港大 HKUDS 的 Vibe-Trading、微软 RD-Agent 相比,stock_strategy_lab 的差异化优势非常清晰:
- 更聚焦 A 股:Vibe-Trading 是全球 9+ 市场 + 452 Alpha Zoo,但 A 股深度依赖 Tushare token;RD-Agent 主打 R/D 双循环自动化研究,框架更大但学习曲线更陡。stock_strategy_lab 默认 MiniQMT(本地券商行情)+ AKShare(免费公开数据),A 股开箱即用。
- 更轻量的 Agent 框架:Vibe-Trading 是 ReAct + DAG + Swarm 蜂群多智能体架构,工具 75+,复杂度高;stock_strategy_lab 是 DeepAgents/LangChain 的简化封装,CLI 即可上手,无需前端服务。
- 真正的"改 skill 而非改代码":每个 skill 文件(如
signal_strategy_library.md、budget_policy_library.md、fusion_policy_library.md)都是 Markdown 文档,扩展策略只需改文档,下次跑任务时 LLM 自动学会新策略。这是项目最具创新性的设计。 - 支持 CLI 交互式介入:每个主智能体都支持
/help、/runs、/load <run_id>、/status、/memory、/resume <thread_id>等会话管理命令,可以随时告诉 LLM"这次优先控制回撤"或"这次重点解决资金利用率",AI 会写入任务状态文件并据此调整。
🏗️ 三层架构技术细节
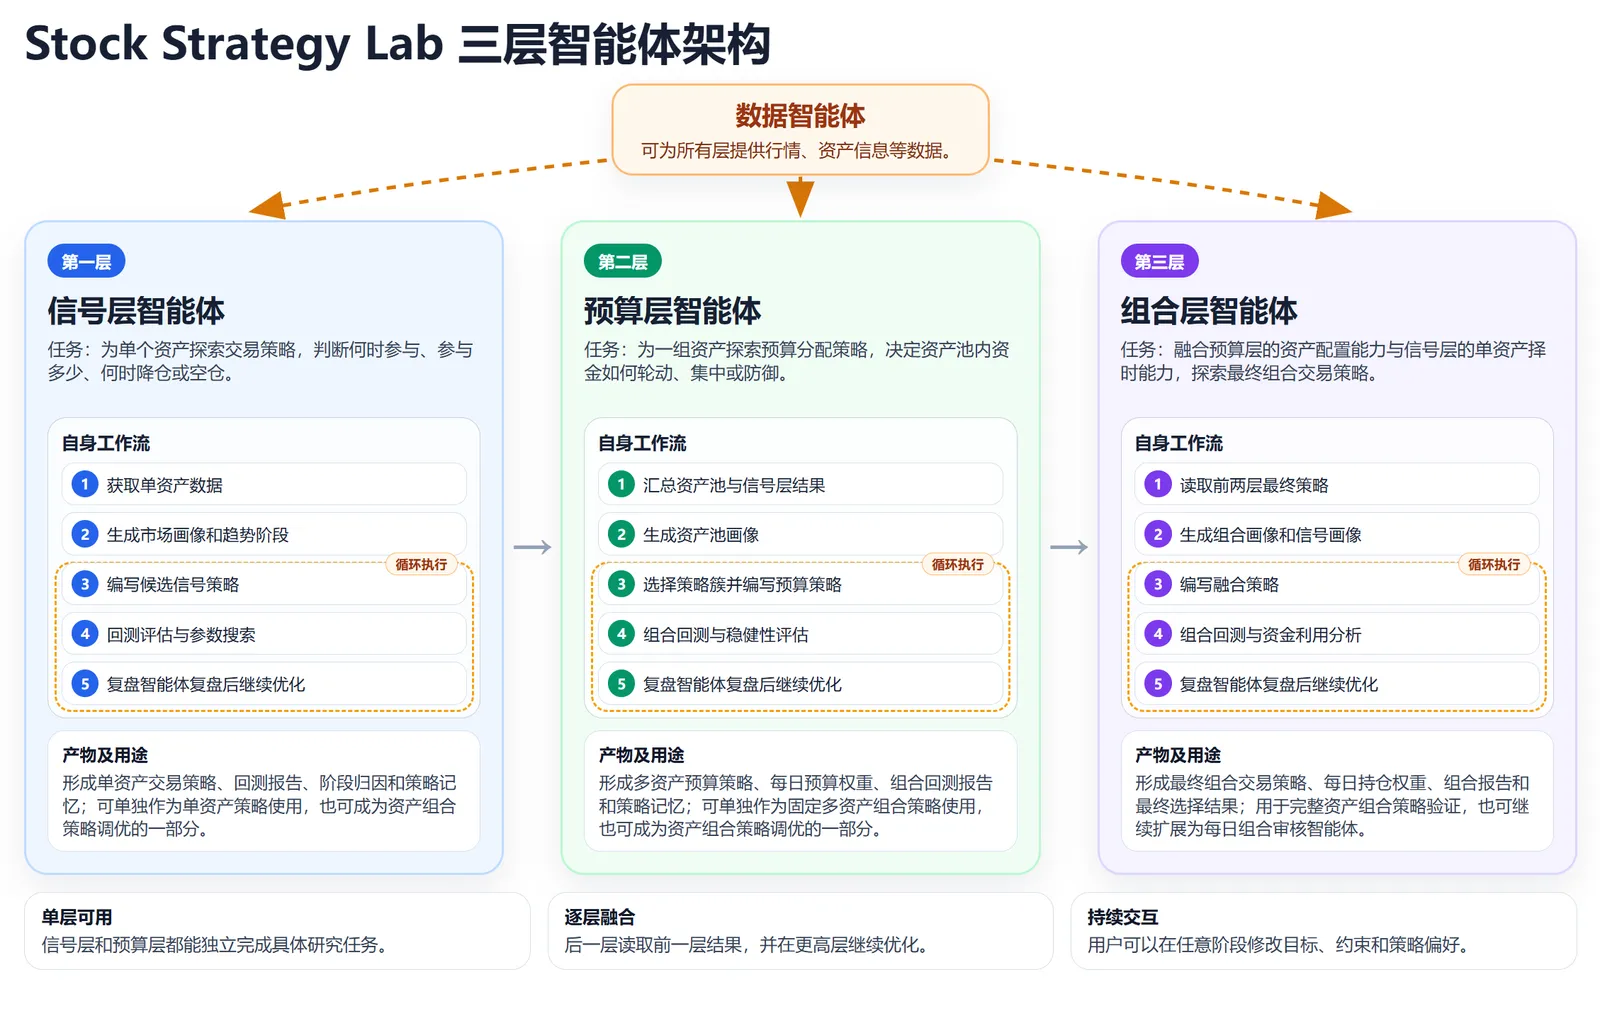
完整数据流(架构图):
用户自然语言任务
       ↓
DataAgent (MiniQMT/AKShare)
       ↓
SignalAgent → CriticAgent(信号层)
       ↓ final strategy
BudgetAgent → BudgetCriticAgent(预算层)
       ↓ final policy
PortfolioAgent → PortfolioCriticAgent(组合层)
       ↓ final fusion policy
每日组合权重输出
每层都是"策略编写 → 回测评估 → 复盘归因 → 持续优化"的独立闭环,最终通过 source_artifacts/ 把前一层产物复制到下一层 run 目录,保证三层之间的依赖关系清晰可追溯。
💡 适用场景
场景一:单资产深度策略研究(只用信号层)
功能说明:让 AI Agent 自主探索某只 ETF、指数或个股的交易策略,无需人工干预。
输入要求:资产代码、数据时间范围、目标偏好(夏普/最大回撤/资金利用率)
输出效果:标准化目录产物(策略脚本、参数空间、walk-forward 验证、QuantStats 报告、阶段归因、最终策略)
适用场景:
- 单只 ETF 择时(如 512880.SH 证券 ETF)
- 宽基指数增强策略(如沪深 300、中证 500)
- 行业主题轮动前置研究
场景二:资产池预算配置(只用预算层)
功能说明:让 BudgetAgent 在一组资产之间自动训练轮动/防御/集中等不同策略簇的预算策略。
输入要求:资产池代码列表、用户偏好(看收益、夏普、回撤还是换手率)
输出效果:每日预算权重、阶段归因报告、最优预算策略登记
适用场景:
- 行业 ETF 轮动(证券/医药/科技/消费)
- 宽基指数股债配置(沪深 300 + 中证 500 + 债券 ETF)
- 主题基金组合配置
场景三:三层完整融合(信号+预算+组合)
功能说明:把单资产择时和资产池配置融合到最终组合策略,是项目最完整的使用方式。
输入要求:信号层产物目录 + 预算层产物目录
输出效果:每日组合持仓权重、组合层回测报告、最终融合策略
适用场景:
- 多 ETF 组合策略(如 5 只 ETF 联动 + 强信号增强)
- 指数增强 + 行业轮动 + 现金管理的完整体系
- A 股全市场量化研究闭环
用户群体总结
- ✅ A 股个人量化研究者:用三层架构快速探索策略,无需从头写回测代码
- ✅ 量化团队 Lead:用 LLM 自动化大量初版策略筛选,人类专注于策略评审
- ✅ AI 工程化实践者:学习 DeepAgents 框架在垂直领域的多智能体落地范式
- ✅ 教学与培训场景:完整的 CLI 交互 + 状态文件 + 产物目录,非常适合做教学演示
- ❌ 不适合:高频 tick 策略(项目以日线为主)、需要直接对接实盘券商(项目仅模拟,不自动下单)
🔄 完整工作流演示
项目内置 5 个调度研究模板,支持 IANA 时区感知、DST 友好的 cron 调度,可以接入 GitHub Actions 或本地 crontab 跑每日任务。完整的"研究一次、用很多次"工作流:
1. DataAgent 拉取数据 → 标准 parquet 文件
2. SignalAgent 跑单资产策略 → final/strategy.json
3. BudgetAgent 读多个信号层产物 → final/budget_policy.json
4. PortfolioAgent 读预算层 final → final/fusion_policy.json
5. 每日定时任务执行 fusion_policy → 输出当日持仓权重
💻 核心代码示例
启动信号层智能体
# src/strategy_lab/cli.py
import typer
from strategy_lab.agents.signal_agent import SignalAgent

app = typer.Typer()

@app.command()
def signal_chat():
    """进入信号层交互式会话"""
    agent = SignalAgent.from_config("configs/agent.yaml")
    agent.run_interactive()

if __name__ == "__main__":
    app()
自定义信号策略(仅需修改 skill 文档)
在 src/strategy_lab/skills/signal_agent/strategy-authoring/references/signal_strategy_library.md 添加:
## 6. 多因子动量反转策略

### 思路
- 入场:5 日动量 > 0 且 RSI(14) < 70(趋势确认 + 不超买)
- 加仓:当日收盘突破 N 日新高 + 成交量 > 1.5 倍均量
- 减仓:RSI(14) > 80 或 5 日动量转负
- 清仓:固定 10% 止损 或 20% 止盈

### 适用环境
- 趋势市 + 中等波动率
- 不适合:单边下跌、剧烈震荡
下次跑任务时,SignalAgent 会自动读取这个新策略,无需改动主代码。
注意:项目所有 skill 都是 Markdown 文档,扩展策略最简单的方式是直接修改 references/*.md 文件,重启 CLI 即可生效。
🎯 总结
stock_strategy_lab 是一个把"多智能体协作"工程化落地的开源量化研究框架。它没有 Vibe-Trading 那样的 9+ 市场广度,也没有 RD-Agent 那样全自动的研究流水线,但在 A 股垂直场景下做到了三个独特价值:
- 三层独立 + 可串联:信号层、预算层、组合层各自独立闭环,可单独使用也可完整串联,灵活度高于单一回测框架。
- LLM 真正参与决策:不是 chat 一下就完事,而是 LLM 编写策略、读取参数空间、生成元数据,由 CriticAgent 复盘归因,形成完整工程化闭环。
- 改 skill 而非改代码:通过 Markdown 文档扩展策略库,无需 Python 编程即可让 AI 学到新策略,这是项目最值得借鉴的设计哲学。
推荐指数: ⭐⭐⭐⭐(4/5,适合 A 股个人/团队的量化研究工作台)
适合人群: A 股量化研究者、量化团队、AI Agent 工程化实践者、教学培训场景
立即体验: GitHub 仓库
GitHub 仓库: adennng/stock_strategy_lab
数据截至 2026-08-26,最新信息请以 GitHub 仓库为准。