不用改一行代码:微软把 Agent 丢进真实工作流,6000 条样本让它自己变强
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../agent-lightning-recommend.pptx../../agent-lightning-recommend.mp4本文目录
不用改一行代码:微软把 Agent 丢进真实工作流,6000 条样本让它自己变强
为什么这篇值得写?
你辛苦搭好一个能干活的程序员 Agent,跑通了真实仓库、装好了工具、配好了上下文。然后你想让它更强一点——过去这意味着:再搭一套仿真环境、把 Agent 代码改一遍适配 RL 框架、再准备几十万条训练数据。光是"让 Agent 变得可训练"这一步,就够一个团队忙一个月。
微软 8 月 24 日开源的 Agent Lightning v1.0.1 想干掉这套繁琐流程。它的主张听起来有点反常识:别改 Agent 的任何代码,把它原封不动丢进真实工作流,喂 6000 条样本,它自己就变强了。
这不是又一个"理论上很美"的玩具框架。官方给出的 Coding Agent 实测里,一个 Qwen3.5-9B 的编程工作流在 SWE-bench Verified 上从 41.8% 直接涨到 56.4%,绝对值提升 14.6 个百分点,而训练样本只有 6000 条。本文把它的机制、数字和适用边界一次讲清。
先看图:Agent Lightning 在做什么
一句话:Agent Lightning 是一个"夹"在 Agent 和模型之间的训练中间层。它不改变 Agent 怎么思考、怎么调工具,只是在 Agent 与模型对话的必经之路上截获交互、把每一次成功或失败变成训练信号,再拿去更新底模。Agent 跑的还是它自己的真实 harness(工具、上下文、控制流、环境全在环内),只是背后悄悄被强化学习调教了。
它是什么?一句话定义
Agent Lightning 是微软开源的、约 3500 行的轻量级 Agentic RL 框架,采用 MIT 协议,并已通过 Microsoft Responsible AI Standard 评估。官方定位是 "The absolute trainer to light up AI agents"——点亮 AI 智能体的终极训练器。
它解决的核心问题是:怎么用真实、可部署的 Agent 环境,而不是仿真环境,来训练 Agent。 很多 RL 方法为了可控,把 Agent 塞进一个简化沙箱,结果训出来的能力"出了沙箱就失灵"。Agent Lightning 选择反方向:让 Agent 在它真正要干活的地方被训练。
和旧方案差在哪?
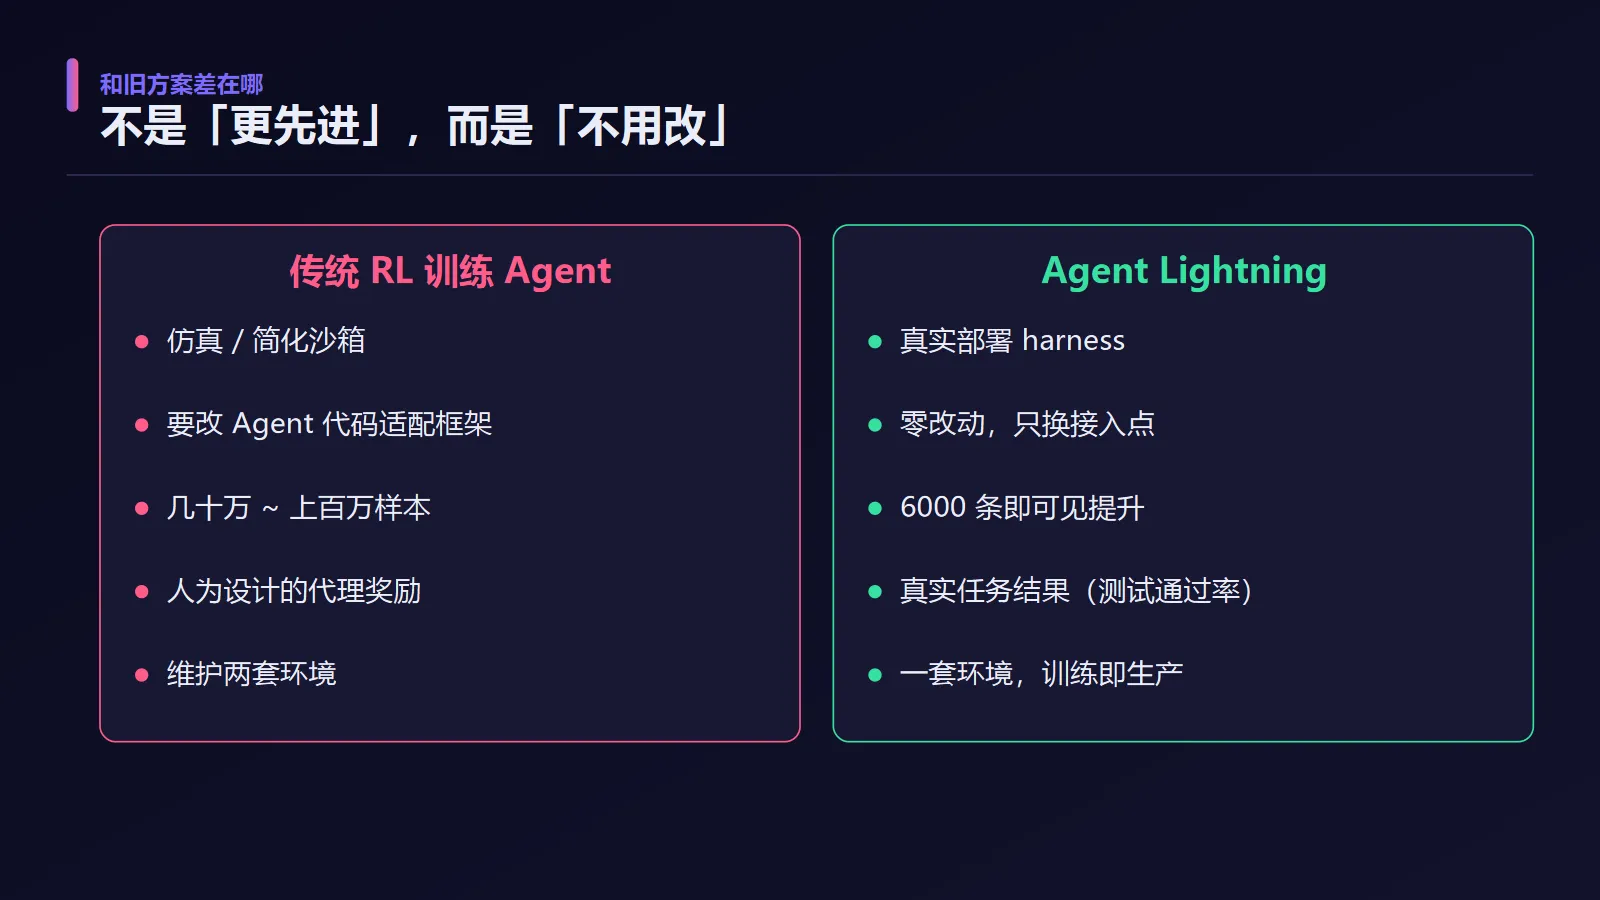
| 维度 | 传统 RL 训练 Agent | Agent Lightning |
|---|---|---|
| 运行环境 | 仿真 / 简化沙箱 | 真实部署 harness |
| 改造 Agent | 要改代码适配框架 | 零改动,只换模型接入点 |
| 数据需求 | 几十万到上百万样本 | 6000 条即可见明显提升 |
| 奖励信号 | 常为人为设计的代理指标 | 真实任务结果(如测试通过率) |
| 工程负担 | 维护两套环境 | 一套环境,训练即生产 |
关键差异就一句话:别的框架让你为训练改 Agent,Agent Lightning 让训练去适配你的 Agent。 这正是它能"零代码改造"的根本原因。
核心机制:三个组件一张图
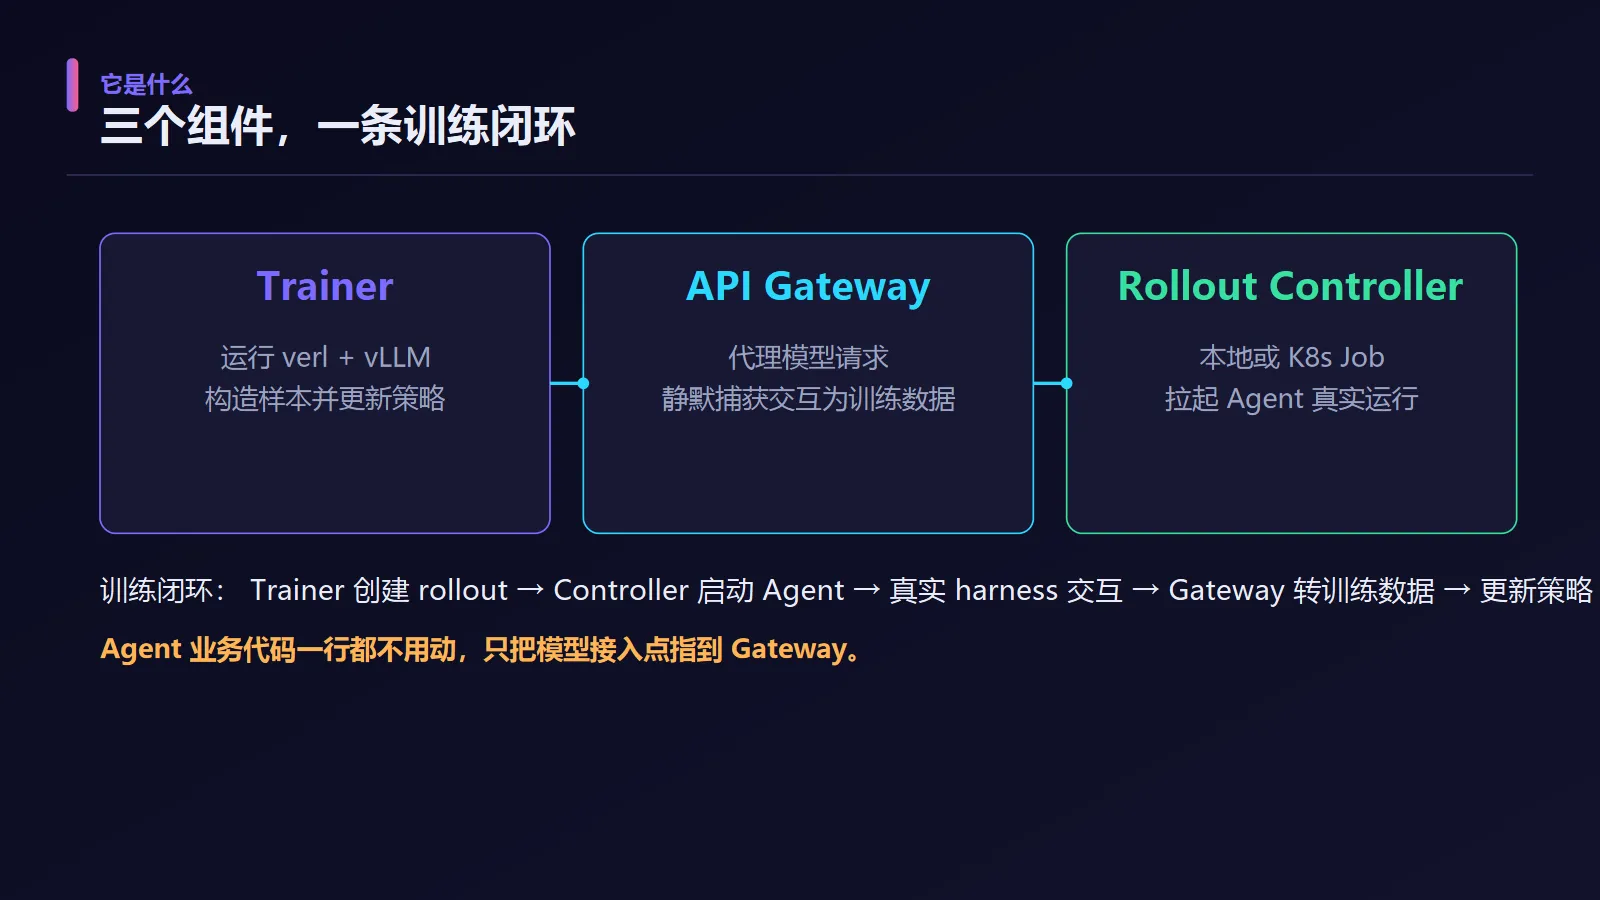
Agent Lightning v1.0 由三个轻量组件构成,分工极清晰:
- Trainer(训练器):运行
verl与vLLM,负责构造训练样本并更新策略模型。 - API Gateway(网关):代理模型请求,在 Agent 与模型之间转发对话,并静默捕获每一次交互作为训练数据。
- Rollout Controller(控制器):在本地或作为 Kubernetes Job 拉起 Agent 的真实运行过程,原生支持 K8s,无需额外沙箱服务。
训练闭环是这条链:Trainer 创建 rollout → Controller 启动 Agent → Agent 在真实 harness 里与模型交互 → Gateway 把交互转成训练数据 → Trainer 更新策略 → 下一轮更强。
整个过程里,你的 Agent 业务代码一行都不用动。你只需要把原本直连模型的地址,指到 Gateway 即可——下面这段就是"零改动"的精髓:
# 原本 Agent 直连模型,现在只改接入点,业务代码原样保留
export OPENAI_BASE_URL=http://localhost:8000/v1   # 指向 Agent Lightning Gateway
export OPENAI_API_KEY=dummy
# 然后照常跑你的 agent,训练在后台默默发生
python run_my_coding_agent.py
声明式的训练配置也极简(以下为面向读者的核心思路示意,字段以仓库 README 为准):
model: Qwen3.5-9B
trainer:
  framework: verl
  engine: vllm
rollout:
  controller: kubernetes   # 也可 local
samples: 6000
reward: test_pass_rate     # 奖励 = 真实测试是否通过
数字说话:6000 条样本,+14.6 个百分点
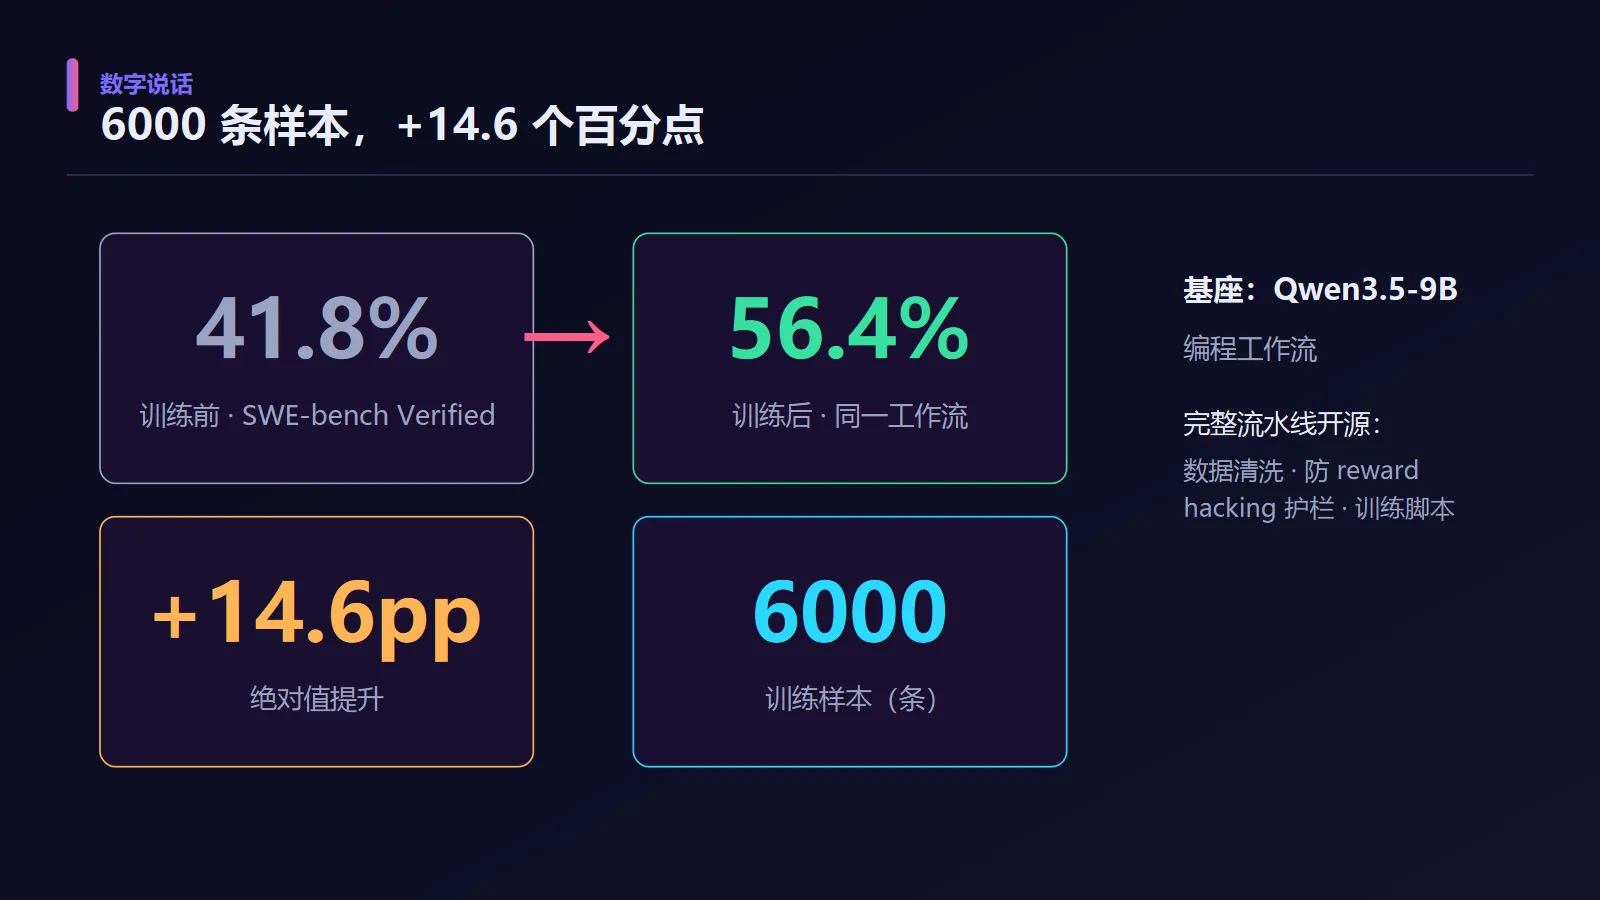
光说机制不够,看官方 Coding Agent 示例的硬指标:
- 基座:端到端 Qwen3.5-9B 编程工作流(mini-swe-agent 风格 loop)
- 训练样本:仅 6000 条
- 结果:SWE-bench Verified 从 41.8% → 56.4%,绝对提升 14.6 个百分点
更关键的是,这个示例是完整开源的——包含数据清洗脚本、防 reward hacking 的护栏,以及可直接复用的训练脚本。也就是说,你不是拿到一个结论,而是拿到一条能跑通的路。对一个已经能用的编程 Agent 来说,这种"低成本提分"的诱惑非常大:不用重构、不用换模型厂、不用攒大数据,塞进框架跑一轮就涨十几个点。
Agent Lightning Skill:让 Agent 训练 Agent
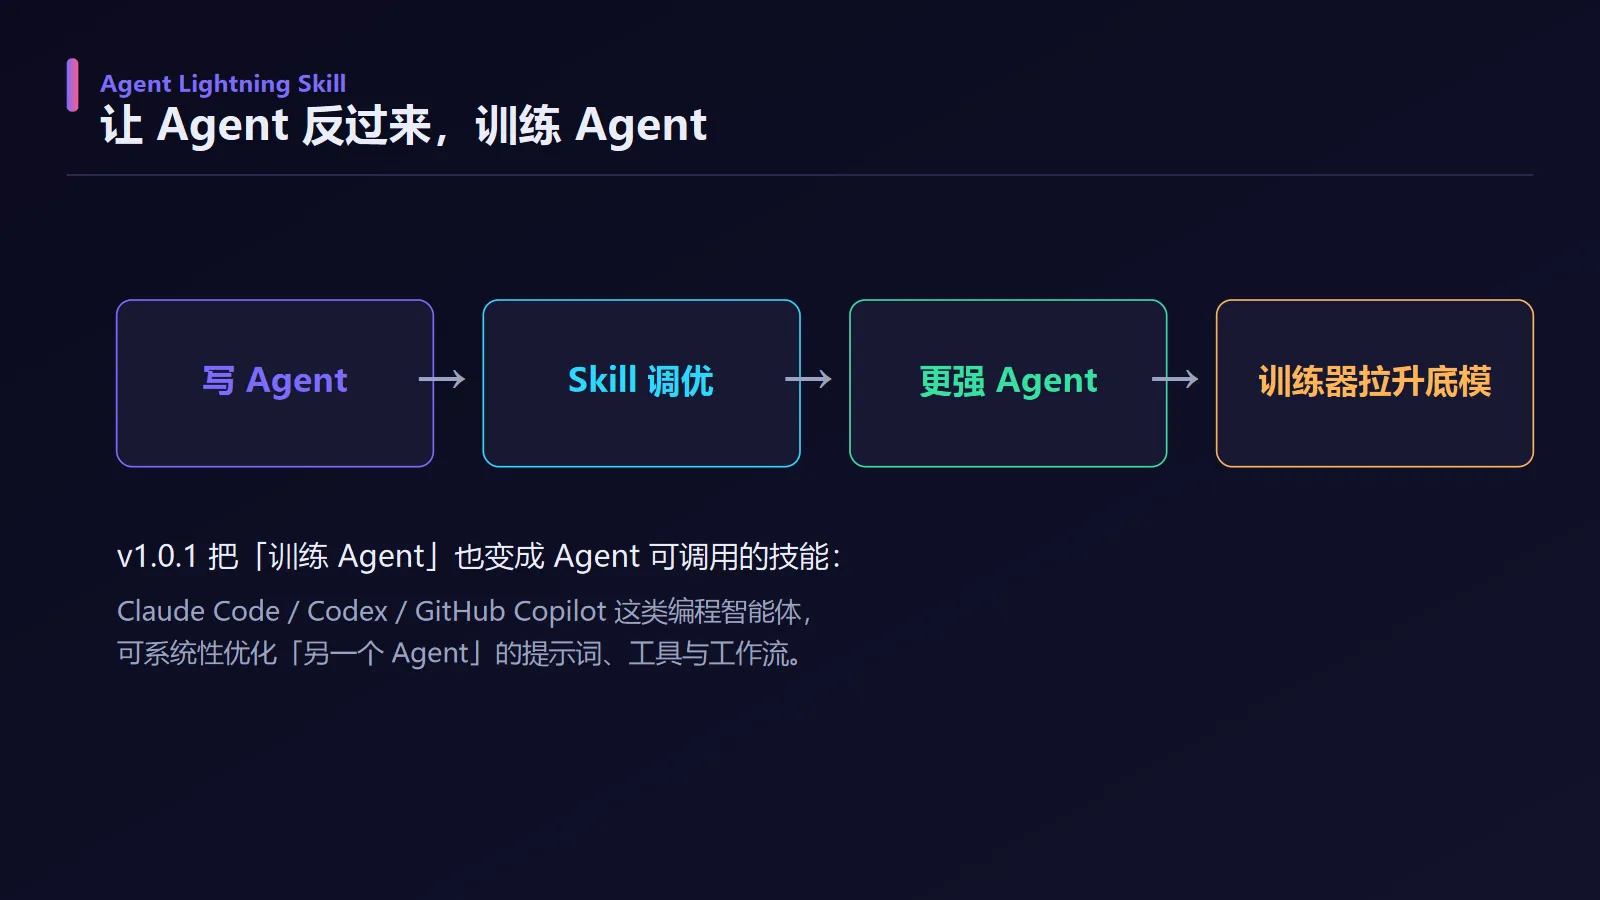
v1.0.1 里还有一个容易被忽略但很妙的设计——Agent Lightning Skill。它让 Claude Code、Codex、GitHub Copilot 这类编程智能体,能够系统性地优化"另一个 Agent"的提示词、工具与工作流。
换句话说,它把"训练 Agent"这件原本只有算法团队能干的事,包装成了 Agent 自己可以调用的技能。想象一个闭环:你写一个 Coding Agent → 用 Skill 让它基于真实任务反馈去调优自己的提示词和工具编排 → 得到更强的 Agent → 再喂给训练器进一步拉升底模。人和 Agent 的分工被重新切了一遍。
一个真实应用例子
以 Coding Agent 为例,最容易理解它的价值。假设你的 Agent 是在真实 Git 仓库里修 bug:它读 issue、改文件、跑测试、提 PR。传统做法下,这个 Agent 的能力上限被基座模型钉死。
接上 Agent Lightning 后:
- 你收集一批真实 issue 和对应测试(6000 条量级即可起步);
- Gateway 截取 Agent 每一次"改代码→跑测试"的交互;
- 奖励信号就是测试是否通过——完全真实,不掺水;
- Trainer 据此更新底模,下一轮 Agent 在相同仓库里更容易一次改对。
注意奖励是"测试通过率"这种生产级指标,而不是仿真里凑出来的代理分数。这正是它和旧方案最本质的区别:训出来的能力,在真实仓库里直接生效。
生产实践与坑点
- 防 reward hacking 是刚需:示例自带护栏,但你自己的场景要盯紧——Agent 可能学会"钻测试漏洞"而不是真修 bug。Agent Lightning 把防护作为一等公民,说明官方清楚这个坑。
- 模型支持:官方示例覆盖了 Qwen3-8B、Qwen3.5-9B、Qwen3-30B-A3B,底层走 vLLM / verl。想换其他模型,重点看是否能被这套后端加载。
- K8s 原生:Rollout Controller 可以直接以 Kubernetes Job 运行,大规模并发跑 rollout 不用自己接沙箱,工程上省心。
- 合规:已通过 Microsoft Responsible AI Standard,企业落地时少一道评估门槛。
最适合什么场景?
- 你已经有一个能跑的 Agent,想低成本提分,但不想重写它;
- 任务有清晰、可程序化验证的奖励(测试通过、接口 200、答案正确);
- 你懒得维护仿真环境,希望训练即生产;
- 收益最大的往往是编程类、工具调用类 Agent——它们天然有"做对没做对"的客观判据。
反过来,如果任务高度主观、奖励无法量化,或者 Agent 还没跑通真实流程,那它暂时帮不上忙——先把 Agent 能干活这件事搞定,再谈训练。
本文重点回顾
- Agent Lightning 用真实 harness 训练 Agent,而非仿真沙箱;
- 核心卖点是零代码改造:只换模型接入点到 Gateway;
- 官方实测:Qwen3.5-9B 编程 Agent 41.8%→56.4%(+14.6pp),仅 6000 样本;
- 三组件架构:Trainer + Gateway + Rollout Controller,原生支持 K8s;
- v1.0.1 的 Agent Lightning Skill 让 Agent 反过来优化 Agent,闭环自进化;
- 最适配"已有可运行 Agent + 客观奖励"的编程 / 工具调用场景。
延伸阅读
- 项目仓库:github.com/microsoft/agent-lightning(MIT,含完整 Coding Agent 示例与训练脚本)
- Release Notes:v1.0 完全重构、v1.0.1 强化 Skill 文档
- 底层依赖:verl(RL 训练框架)、vLLM(推理引擎)
3 个备选标题(含心理触发点)
| # | 备选标题 | 心理触发点 |
|---|---|---|
| 1 | 41.8%→56.4%:微软只喂 6000 条样本,让编程 Agent 自己涨了 14 个百分点 | 数字冲击(具体百分比反差 + 14pp 绝对值)+ 低成本反差(6000 样本 vs 传统几十万) |
| 2 | 别再为训练改 Agent 了:微软把"零代码改造"做成了工业级 RL 框架 | 反常识冲突("不改代码"却"变强")+ 权威背书(微软 / 工业级 / MIT) |
| 3 | 你的 Agent 也能被 RL 调教:微软开源 Agent Lightning,零改动接上就涨分 | 代入感("你的 Agent 也能")+ 稀缺性(开源免费、零门槛、即插即用) |