代码看起来对 ≠ 通过:清华开源 27B 模型,85% 真修复率
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../veriloop-coder-e1-recommend.pptx../../veriloop-coder-e1-recommend.mp4本文目录
代码看起来对 ≠ 通过:清华开源 27B 模型,85% 真修复率
AI 编程圈最近被一组反常识的数据刷屏了。
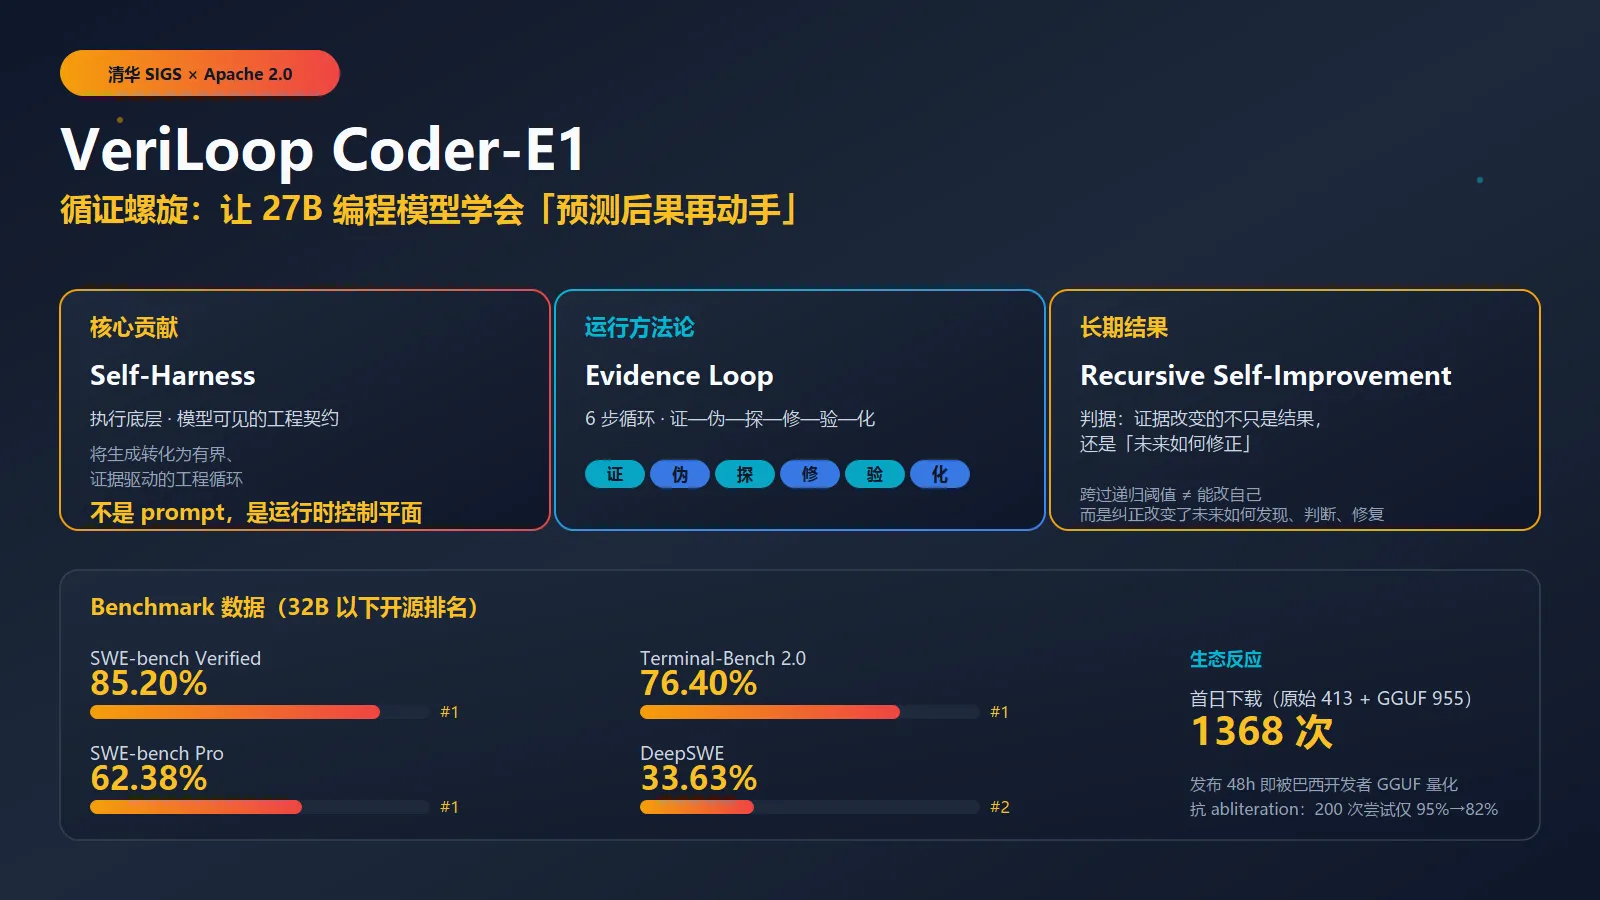
一个 27B 的小模型,在 SWE-bench Verified 上拿下 85.20%——比 DeepSeek V4-Flash-0731 还要猛一截;发布不到 48 小时,原始仓库下载量 413 次,第三方 GGUF 量化版本直接被巴西开发者做了出来,单日 955 次。更狠的是:在 32B 以下开源模型的赛道上,它在 SWE-bench Verified、Pro、Terminal-Bench 2.0 三项里都拿了 #1。
但让我真正停下来读它的,不是 benchmark,而是它把下面这句话直接写进了官方模型卡——
"代码看起来对 ≠ 任务完成。一个任务只有在原生交付物同时通过活动任务契约和验证证据的情况下,才被视为完成。"
这是清华 SIGS Robot Lab 王立博团队 7 月 29 日发布的 VeriLoop Coder-E1。背后的 27B 参数模型只是冰山一角,真正有意思的是它把一家公司花了 6 个月卖力宣传的「自我改进」叙事,做成了一条可验证、可回滚、可递归继承的工程闭环。
下面我们把这套「循证螺旋」拆开看看。
一、先看图:一次完整修复到底在跑什么
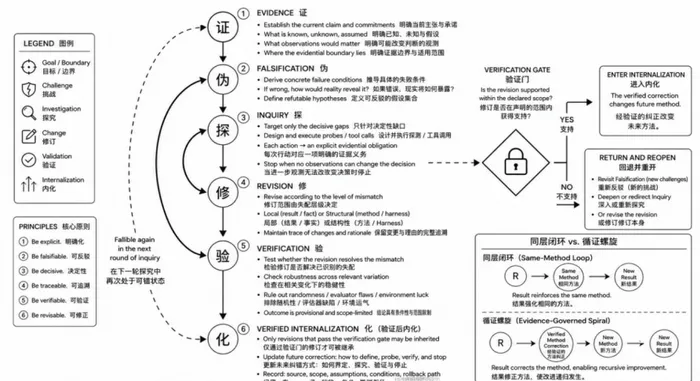
图 1|VeriLoop 的循证螺旋:每一轮生成都必须接受反证、探索、修订与复验,只有通过验证的纠正才有资格进入下一轮并影响后续方法选择。
整张图只讲一件事:Loop 跨过递归阈值,不是「能不能改自己」,而是「纠正是否改变了未来如何改自己」。
二、为什么这篇值得写?
过去一年,AI 编程赛道默认的叙事是「更大 = 更强」。但 VeriLoop 走了一条相反的路:
- 不堆参数:27B base,用少量 PEFT 适配器解锁能力
- 不靠更长 prompt:用 Self-Harness 做运行时控制平面
- 不靠更长 thinking:用 6 步循环(证—伪—探—修—验—化)逼证据兑现
- 不靠「重试到对」:验证失败的修订会被拒绝,验证通过的修订也只是「方法候选」,要等下一次独立任务真的改变了「证据如何生成、工具如何选择、修订如何定位、验证如何组织」,才算跨过递归阈值
这一整套「失败 ≠ 错,证据 = 唯一货币」的工程逻辑,是当下大模型圈最稀缺的东西。
读者读完应该记住的 3 个点:
- 代码看起来对 ≠ 任务完成——这是 VeriLoop 的判据
- 真正的递归自我改进——证据改变的是「未来如何改」,而不仅是「这次改对」
- Apache 2.0 + Pure Open Source——模型权重 + 4 个适配器全开,但生产级 Self-Harness 实现保留(这是架构边界,不是抠门)
三、它到底是什么?
VeriLoop Coder-E1 不是一个更大的模型,而是一个带强约束的模型 + 一个运行时分发器。
| 维度 | 值 |
|---|---|
| 基础模型 | Qwen3.6-27B 兼容 backbone(冻结) |
| 适配层 | 4 个 PEFT Surface Host Adapter(窄域) |
| 运行时分发 | Self-Harness(私有 + 公开 14 条规则) |
| 核心承诺 | Self-Harness → Evidence Loop → Recursive Self-Improvement |
| 许可证 | Apache License 2.0 |
| 发布时间 | 2026-07-29 |
| 支持语言 | 中文、英文 |
整个系统的进展路径可以理解为:
Vertical Coding Model (27B 底座)
        ↓
Self-Harness        (执行底层,将「生成」变为「有界工程循环」)
        ↓
Evidence Loop       (运行方法论:证—伪—探—修—验—化)
        ↓
Recursive Self-Improvement (长期系统结果)
注意:Self-Harness 是执行底层,不是 prompt 模板、不是多智能体 wrapper 也不是 fine-tuned adapter 集合。它负责把一次软件工程任务编译成多轮、分阶段、相互约束的模型调用。
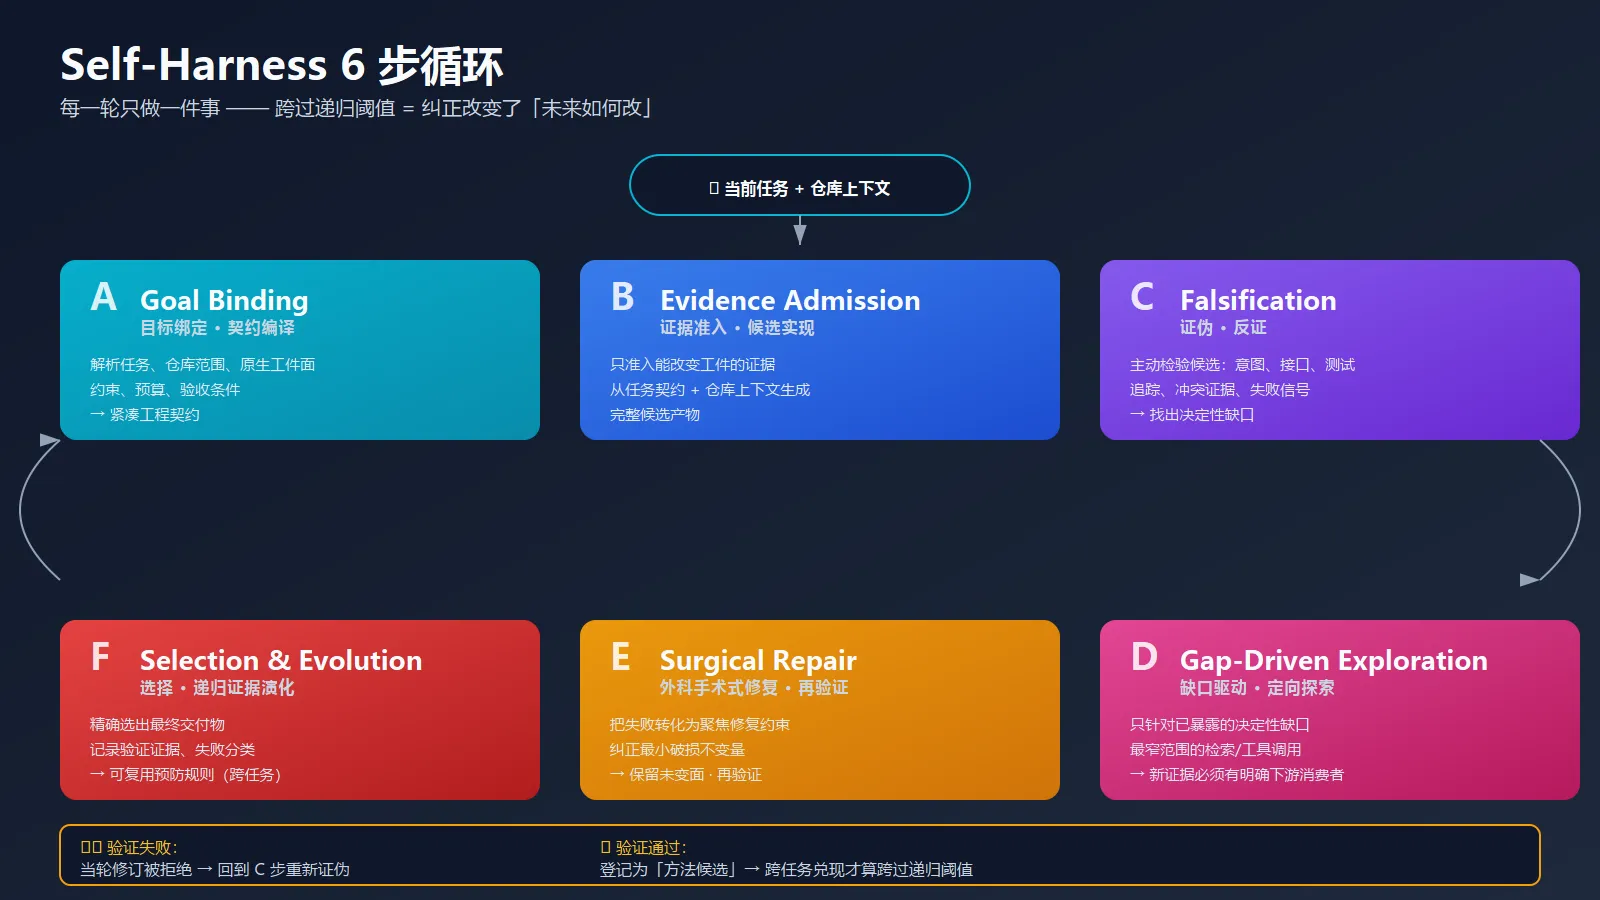
图 2|Self-Harness 6 步循环:验证失败 → 当轮修订被拒绝 → 回到 C 步;验证通过 → 登记为「方法候选」,跨任务兑现才算跨过递归阈值。
四、核心概念 1:Self-Harness 的 6 步循环
完整六个阶段,每轮只做一件事:
| 阶段 | 名称 | 职责 |
|---|---|---|
| A | Goal Binding | 解析任务、仓库范围、原生工件面、约束、预算、验收条件 |
| B | Evidence Admission | 只准入能改变工件的证据;生成候选产物 |
| C | Falsification | 主动检验候选:意图、接口、测试、追踪、冲突证据 |
| D | Gap-Driven Exploration | 针对已暴露的决定性缺口进行最窄范围的检索 |
| E | Surgical Repair & Re-verification | 把失败转化为聚焦修复约束;保留未变面 |
| F | Selection & Recursive Evidence Evolution | 选出最终交付物;记录可复用预防规则 |
这一循环的精妙之处在于第 F 步:
- 验证失败 → 当下修订被拒绝,回到第 C 步
- 验证通过 → 修订不会直接成为永久规则,而是登记为带证据集、适用范围、触发条件、失效边界、回滚路径的「方法候选」
- 真正的递归跃迁 = 这次的方法候选在后续独立任务中真的被调用,并确实改变了「证据如何生成、工具如何选择、修订如何定位、验证如何组织」
换句话说:不是改了就叫改进,能改出「下一次怎么改」才叫改进。
五、核心概念 2:递归自我改进的判据
团队在官方模型卡里直接把卡尔·波普尔的经典命题放进了工程实现:
不可反驳性并非理论的优点,恰恰是它的缺陷。
对应到模型上,递归自我改进的操作判据是:
Evidence(证据)
    ↓
Correction of the current method(纠正当前方法)
    ↓
Change in how future errors are discovered, judged, and repaired
(改变未来如何发现、判断、修复错误)
    ↓
New evidence may overturn the improved method
(新证据可证伪刚改进的方法)
    ↺
下图把这个跨越递归阈值的过程画得很清楚:
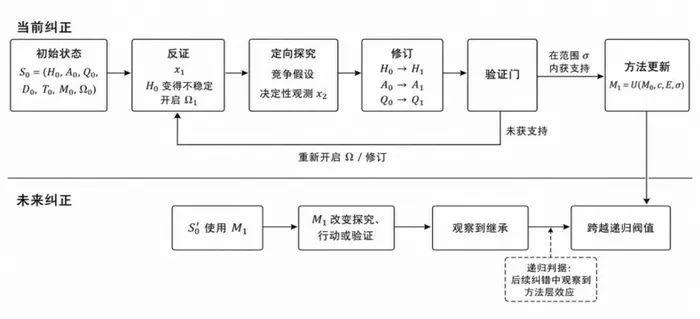
图 2|已验证纠正进入未来方法的运行轨迹:只有当方法候选在后续独立任务中实际改变「证据义务如何生成、工具如何选择、修订如何定位、验证如何组织」时,Loop 才真正跨越递归阈值。
这个判据让一个常见错觉站不住脚:
「系统能修改 Prompt / 工具策略 / 记忆 / 评价器 / 训练流程 / 模型本身」≠「真正改进发生」
如果目标、证据、评价、继承标准仍受同一组未经检验的假设支配,修改越深,奖励缺口、评价偏差、认知盲点越可能被固化到更高层机制中。
这正是 VeriLoop 与 DeepSeek 路径的根本分歧——
| 维度 | DeepSeek 路径 | VeriLoop 路径 |
|---|---|---|
| AGI 的核心假设 | 更大参数 + 更广知识 | 可修正状态表征 + 可反驳性 |
| 优先解空间 | 基础模型能力扩展 | 行动—证据—后果闭环 |
| 智能的判据 | 趋近全知 | 持续缩小对行动后果的预测误差,保留被纠正能力 |
| 自我改进的判据 | 提升下一轮能力 | 改变下一轮如何发现、判断、修复错误 |
团队原话:「AGI 不是逼近全知,而是在更广泛的环境中持续缩小对行动后果的预测误差,并始终保留被现实纠正的能力。」
六、核心概念 3:4 个 PEFT Surface Adapter
模型权重冻结后,VeriLoop 用 窄域 PEFT 解决了「不改 backbone 也能改行为」:
| Adapter | 优化目标 | 实际效果 |
|---|---|---|
| ToolSpec | 工具 schema、参数约束、前置/后置条件、执行格式 | 对格式错误、缺失前置条件、无效参数、不完整执行契约的敏感性更强 |
| Uncertainty | 答案 / 证据 / 执行 / 规格 / 风险不确定性 | 减少无根据的确定性;升级决策更准确 |
| Rollback | 验证器否定、失败编辑、有界修正、状态恢复 | 降低局部失败后大规模破坏性重写的风险 |
| Evidence Binding | 主张-证据对齐、来源、验证上下文 | 生成产物与可观察验证证据耦合更强 |
关键约束:这些适配器针对显式的 surface_host.* 模块,不能当作普通 LoRA 直接 PeftModel.from_pretrained 附加到未修改的 Qwen backbone 上。必须配合 surface_host_wrapper_publicsafe.py 加载。
七、4 项 Benchmark 数据
| Benchmark | 评估范围 | 报告分数 | 32B 以下开源排名 |
|---|---|---|---|
| SWE-bench Verified | 500 tasks | 85.20% | #1 |
| SWE-bench Pro | 731 tasks | 62.38% | #1 |
| Terminal-Bench 2.0 | 89 tasks | 76.40% | #1 |
| DeepSWE | 113 tasks | 33.63% | #2 |
声明:报告值为 benchmark 级通过率,不等同于 benchmark 维护者的背书、认证或独立验证。
135B 以上的开源在 SWE-bench Verified 上能稳到 85% 的并不多,27B 直接拉到这个位置,性价比优势明显。
八、3 分钟上手:如何跑起来
官方提供 4 种部署路径,门槛最低的是 GGUF 量化版(rodrigoramosrs/veriloop-coder-e1-gguf),适合个人开发者。
8.1 vLLM 标准部署
# 启动 vLLM 服务(原始权重)
python -m vllm.entrypoints.openai.api_server \
    --model "tsinghua-sigs-robot-lab/veriloop-coder-e1" \
    --host 0.0.0.0 \
    --port 8000 \
    --max-model-len 32768
8.2 SGLang 部署
python -m sglang.launch_server \
    --model-path "tsinghua-sigs-robot-lab/veriloop-coder-e1" \
    --host 0.0.0.0 \
    --port 30000
8.3 Docker Model Runner(一行命令)
docker model run hf.co/tsinghua-sigs-robot-lab/veriloop-coder-e1
8.4 OpenAI 兼容调用
curl -X POST "http://localhost:8000/v1/chat/completions" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "tsinghua-sigs-robot-lab/veriloop-coder-e1",
    "messages": [
      {"role": "user", "content": "Fix the bug in src/cache.py where asyncio.Lock is not released on exception."}
    ]
  }'
⚠️ 重要提醒:仅加载基础模型或单个 adapter 无法复现完整 VeriLoop Self-Harness。完整生产实现(编排、提示编译、证据路由、修复仲裁、记忆 schema、私有训练数据)保留在团队内部,这是架构边界,不是漏洞——开放学术原理 + 保留产品壁垒。
九、14 条公共 Self-Harness 规则摘要
团队把生产级 Harness 的可公开行为规范抽象成 14 条规则,规则谱系:
Andrej Karpathy(2026 年 1 月)
    → 观察编码代理的反复失败模式
        ↓
Forrest Chang(四原则:Think Before Coding / Simplicity First / Surgical Changes / Goal-Driven Execution)
        ↓
Mnilax(2026 年 5 月,扩展为 8 条 agent 时代规则)
        ↓
Libo Wang / VeriLoop(重写并扩展为 14 条公共契约)
部分关键规则(挑出 5 条最容易被工程团队抄走的):
| # | 规则 | 核心要点 |
|---|---|---|
| 01 | Current-Task Supremacy | 当前请求与精确输出契约覆盖旧记忆、缓存模板、习惯 |
| 05 | Repair the Broken Invariant, Not the Whole System | 局部修复优先;只有证据证明局部修复无法恢复正确性时才大范围重写 |
| 06 | Validate Intent, Not Appearance | 语法、格式、import 是必要检查;决定性测试是工件是否满足用户实际功能意图 |
| 07 | Surface Failure; Never Simulate Success | 失败、跳过、降级、未知在 Harness 证据中保持显式;绝不声称为发生的执行/验证/成功 |
| 13 | Deliver One Artifact with a Verifiable Evidence Chain | 精确选择一个最终交付物,同时保留解释为何被选的证据束 |
这 14 条规则最有意思的地方在于:每一条都是对「GPT 风格 web agent 常见失败模式」的精确反制。第 5 条治「把整体推倒重来」,第 6 条治「import 写对了就以为对了」,第 7 条治「假装测试通过了」。
十、它适合什么场景?
| 场景 | 适合度 | 理由 |
|---|---|---|
| 仓库级代码修复 | ⭐⭐⭐⭐⭐ | 主战场,4 项 benchmark 全部覆盖 |
| Bug 定位 + 外科手术式修复 | ⭐⭐⭐⭐⭐ | Surgical Repair 是核心能力 |
| 跨文件 API 变更 | ⭐⭐⭐⭐ | 14 条规则里专门覆盖 Local Convention 保持 |
| 工具介导的 agent 任务 | ⭐⭐⭐⭐⭐ | ToolSpec adapter 直接强化工具契约 |
| 长程工程任务(带 checkpoint) | ⭐⭐⭐⭐ | 第 11 条规则专门治 Checkpoint Long-Running |
| 从零写一个新项目 | ⭐⭐ | 它的强项是修复和验证,不是从零生成 |
| 闭箱黑盒快速 chatbot | ⭐⭐ | 完整能力依赖 Self-Harness,单模型跑起来优势有限 |
十一、社区反应:发布 48 小时即量化
几个值得记住的数字:
- 首日下载量:原始仓库 413 次 + 第三方 GGUF 955 次 = 1368 次
- 抗 abliteration 能力:200 次尝试,拒绝率仅从 95% 降到 82%(业内少见)
- 第三方衍生仓库:
rodrigoramosrs/veriloop-coder-e1-gguf(GGUF 量化,llama.cpp / Ollama / LM Studio 本地跑)asmanovlev/veriloop-coder-e1-heretic(第三方研究)
发布首日就被巴西开发者主动做 GGUF 量化,这件事本身就是对模型工程完成度的强信号——光是「跑起来能用」是不够的,还要让独立开发者愿意现学现做量化版本。
十二、重点回顾
| 概念 | 一句话 |
|---|---|
| Self-Harness | 不是 prompt,是执行底层,把生成转化为有界工程循环 |
| Evidence Loop | 6 步循环:证—伪—探—修—验—化 |
| Recursive Self-Improvement | 判据 = 证据改变的不是「这次改对了」,而是「未来如何改」 |
| Surface Host Adapter | 4 个 PEFT 适配器,窄域重训增强行为,不改 backbone |
| 运行模式 | Flash / Thinking / Expert(按延迟 / 质量选) |
| 开源边界 | 模型权重 + 4 个 adapter + 评测证据都开,生产 Harness 保留 |
如果你今天只记一件事:VeriLoop 真正颠覆的不是 benchmark 数字,而是把「AI 编程是不是修好代码」这件事的判据做了——
代码看起来对 ≠ 任务完成。任务只有在原生交付物同时通过活动任务契约和验证证据时,才被视为完成。
十三、延伸阅读
| 资源 | 链接 |
|---|---|
| 官方模型卡(Hugging Face) | https://huggingface.co/tsinghua-sigs-robot-lab/veriloop-coder-e1 |
| 基础论文 / 推文(X) | https://x.com/free_anyone/status/2080695708357951959 |
| Karpathy 原始 X 帖 | https://x.com/karpathy/status/2015883857489522876 |
| Forrest Chang 四原则仓库 | https://github.com/multica-ai/andrej-karpathy-skills |
| Mnilax 八规则扩展 | https://x.com/Mnilax/status/2053116311132155938 |
| 第三方 GGUF 量化 | https://huggingface.co/rodrigoramosrs/veriloop-coder-e1-gguf |
| 第三方研究(Heretic) | https://huggingface.co/asmanovlev/veriloop-coder-e1-heretic |
| SWE-bench Verified Leaderboard | https://huggingface.co/datasets/SWE-bench/SWEbench_Verified |
| Terminal-Bench 2.0 Leaderboard | https://huggingface.co/datasets/harborframework/terminal-bench-2.0 |
| 机器之心报道 | 机器之心官方公众号(2026-08-02) |
如果让你现在的 AI 编程 agent 接管一个 bug fix 任务,你会愿意让它跑 6 步循环(每一步都重新验证)吗?还是更希望它一步到位? 欢迎在评论区聊一聊。