Vibe-Research
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../Vibe-Research-recommend.pptx../../Vibe-Research-recommend.mp4本文目录
- 🚀 什么是 Vibe-Research?
- ✨ 核心功能一览
- 十大模块 · 一屏看全个人投研
- 🛠️ 快速上手:5 分钟跑通示例
- 安装(一行命令 + 两步启动)
- 核心代码示例(接入 AI 的三种方式)
- 📊 一屏看穿:A 股 + 美股 + 港股 + 韩股
- 每日复盘 · 一屏看全今天
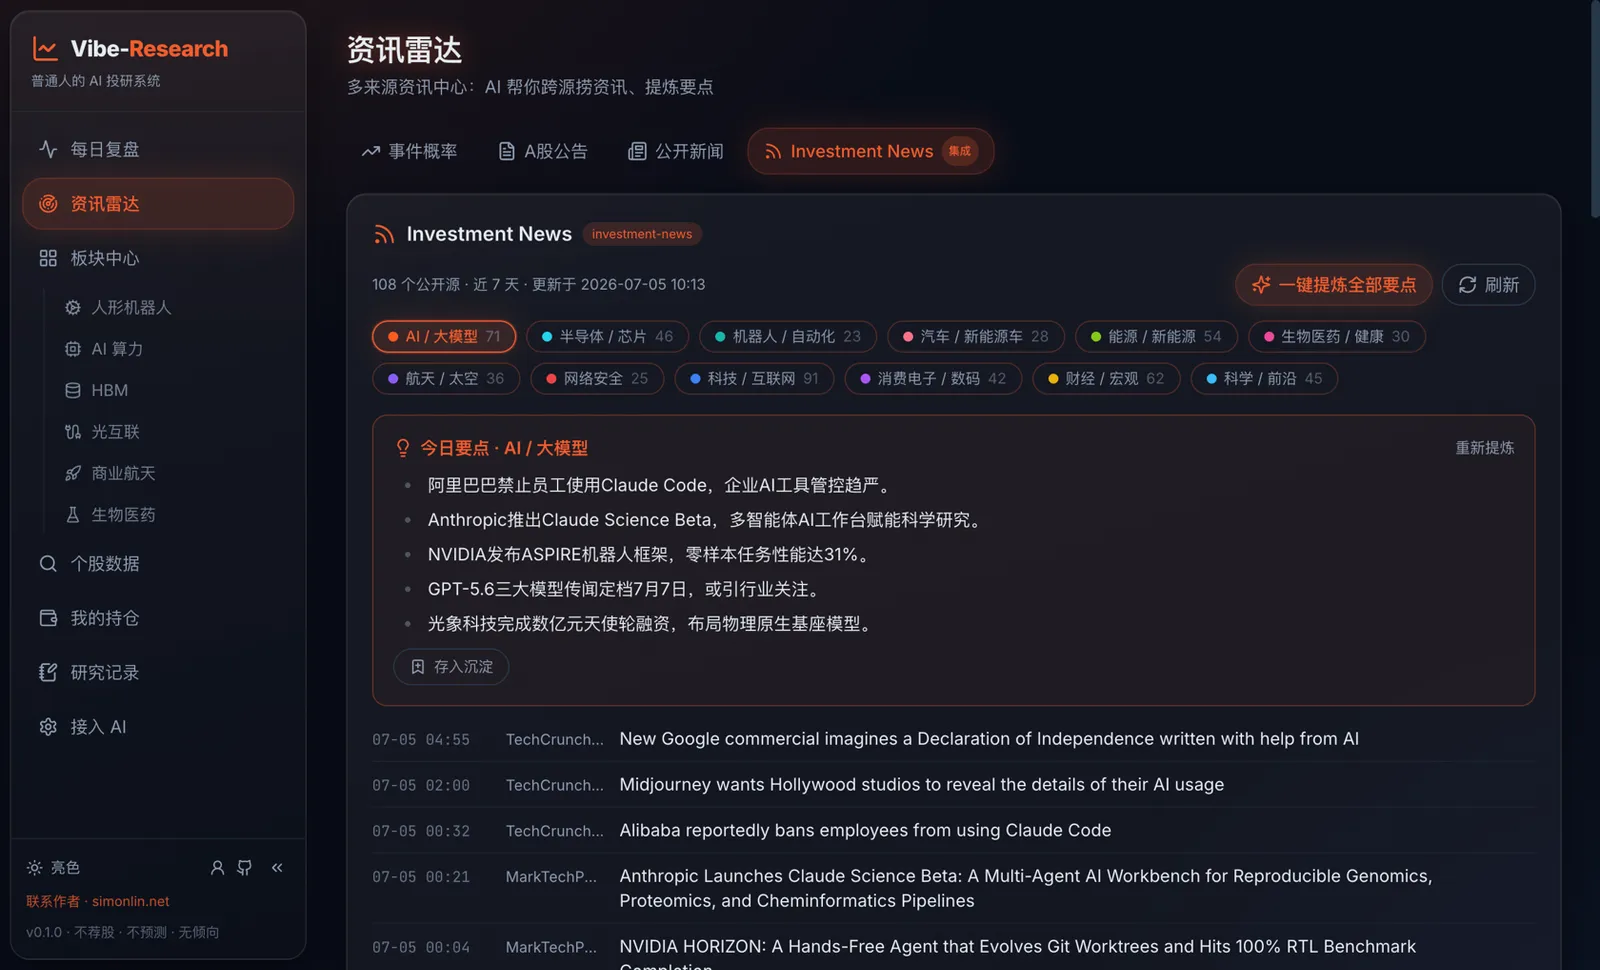
- 资讯雷达 · 跨源盯梢,一键成稿
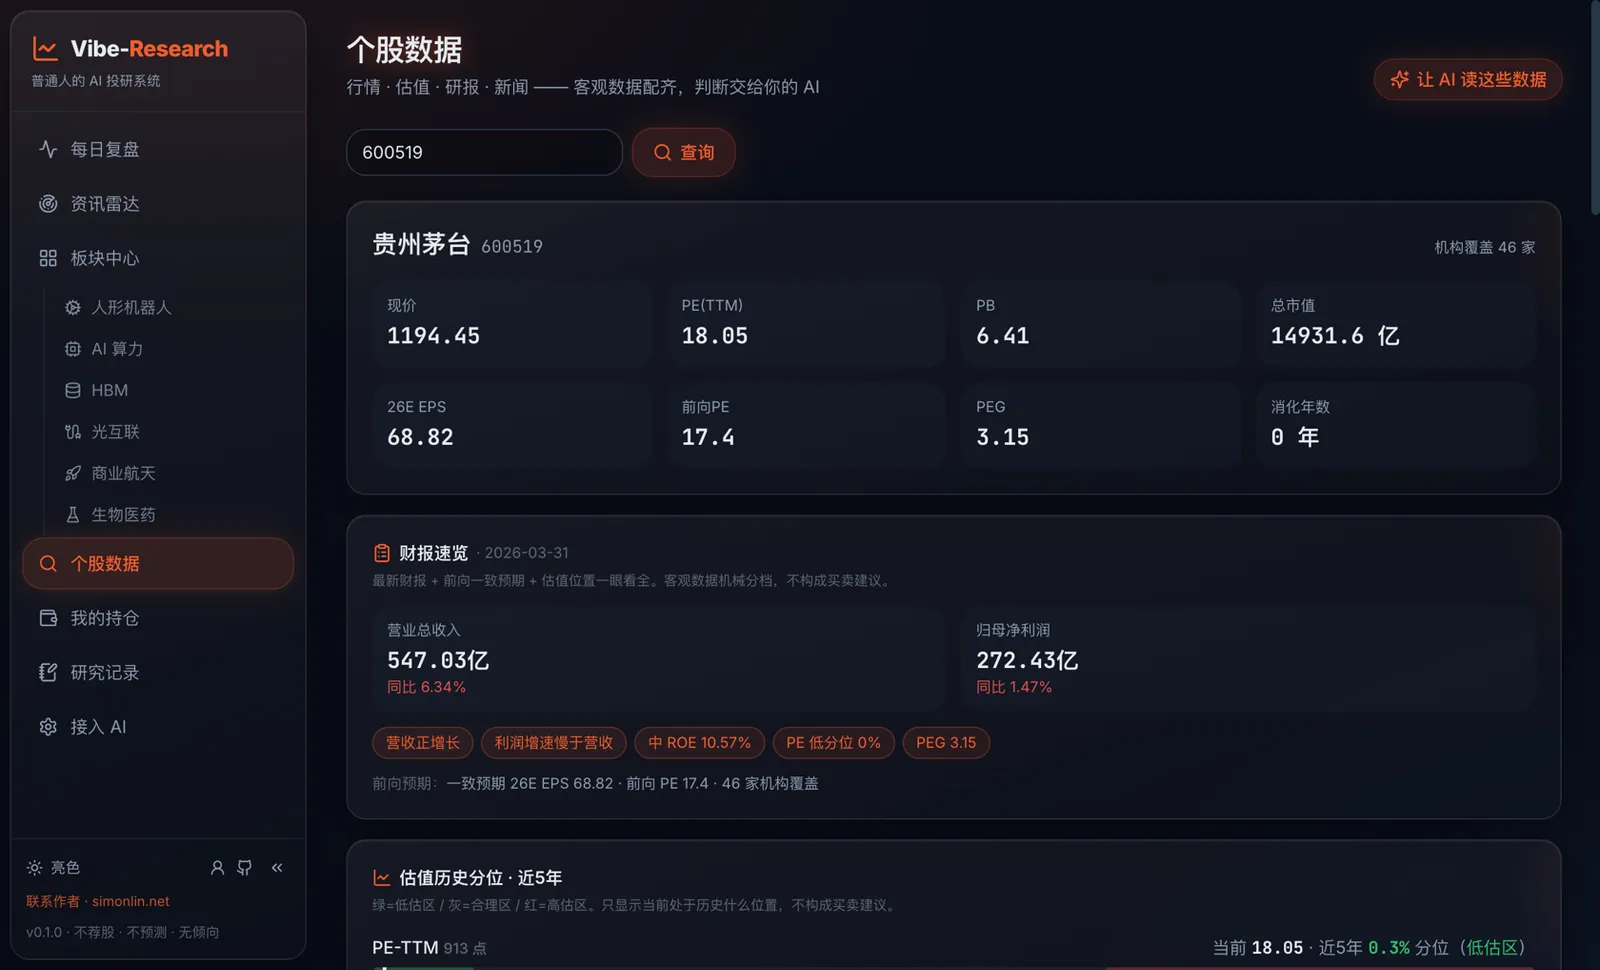
- 个股数据 · 一屏看穿,只下钻不下结论
- ⚔️ 多空辩论:终点是分歧,不是结论
- 一次辩论的开销(跑之前先看这里)
- 反思审计
- 📡 数据源:自带三大开源引擎,git clone 即用
- A 股数据引擎 a-stock-data 覆盖范围
- 🏗️ 架构:数据层 + 两条 AI 出口
- 三种 AI 接入方式
- 🔌 接入 AI:工具中立,主流 AI 都能接
- 订阅接入伙伴
- API 接入模型清单
- 🆚 同类工具横向对比
- 🔒 合规与边界
- 💡 适用场景
- 场景 1:跨市场盯盘 + 每日复盘
- 场景 2:用 Claude Code / Codex 订阅做投研
- 场景 3:本地优先 + 数据自主
- 场景 4:多 agent 投研框架研究者
- 用户群体总结
- 📝 快速上手:演示截图
- 每日复盘(顶部)
- 个股数据
- 资讯雷达
- 💰 定价方案
- 🎯 总结
📌 核心价值:把 A 股 / 美股 / 港股 三套开源数据引擎打包进一个本地优先的 AI 投研看板,复盘、资讯雷达、个股数据、自选股、持仓、多空辩论全配齐,方向与结论交给你自己的 AI 决定
散户做研究最大的痛点不是不会用 AI,而是 AI 没有"自己的数据"。Vibe-Research 用 git clone 就跑通的本地部署,把行情、研报、估值、财务、公告、资金面、资讯和 23 个数据工具装在一起,再让 Claude Code / Codex / Qwen Code / DeepSeek CLI 直接挂进来。
🚀 什么是 Vibe-Research?
Vibe-Research 是独立开发者 Simon(simonlin1212)开源的个人 AI 投研系统,主推 A 股、兼看美股 / 港股。它由一个 FastAPI 后端(:8900)+ Vite + React 19 前端(:5899,玻璃暖橙主题)+ 三套直接打进仓库的数据子模块(a-stock-data / global-stock-data / investment-news)组成。


核心定位:数据与功能配齐、AI 决策由你自己接入的中立工具——不荐股、不预测、不给买卖时机、不承诺收益,结论全部由你自己的模型产出
| 维度 | 数据 |
|---|---|
| Star | 1,637 |
| Fork | 330 |
| 协议 | MIT |
| 技术栈 | Python 3.10+ · FastAPI · Vite · React 19 · TypeScript · Tailwind |
| 后端端口 | :8900 |
| 前端端口 | :5899 |
| 创建 | 2026-07-05 |
| 最近更新 | 2026-08-02 |
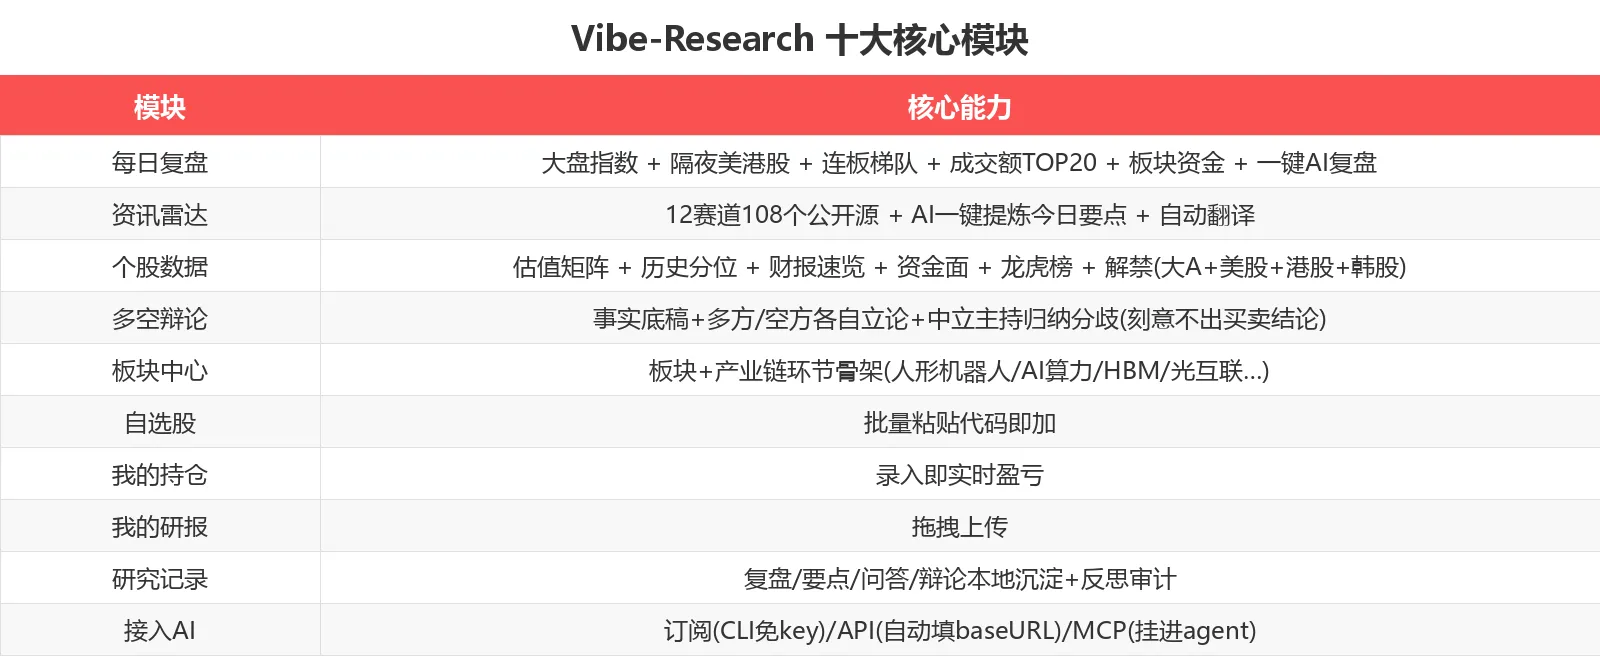
✨ 核心功能一览
十大模块 · 一屏看全个人投研
| 模块 | 核心能力 |
|---|---|
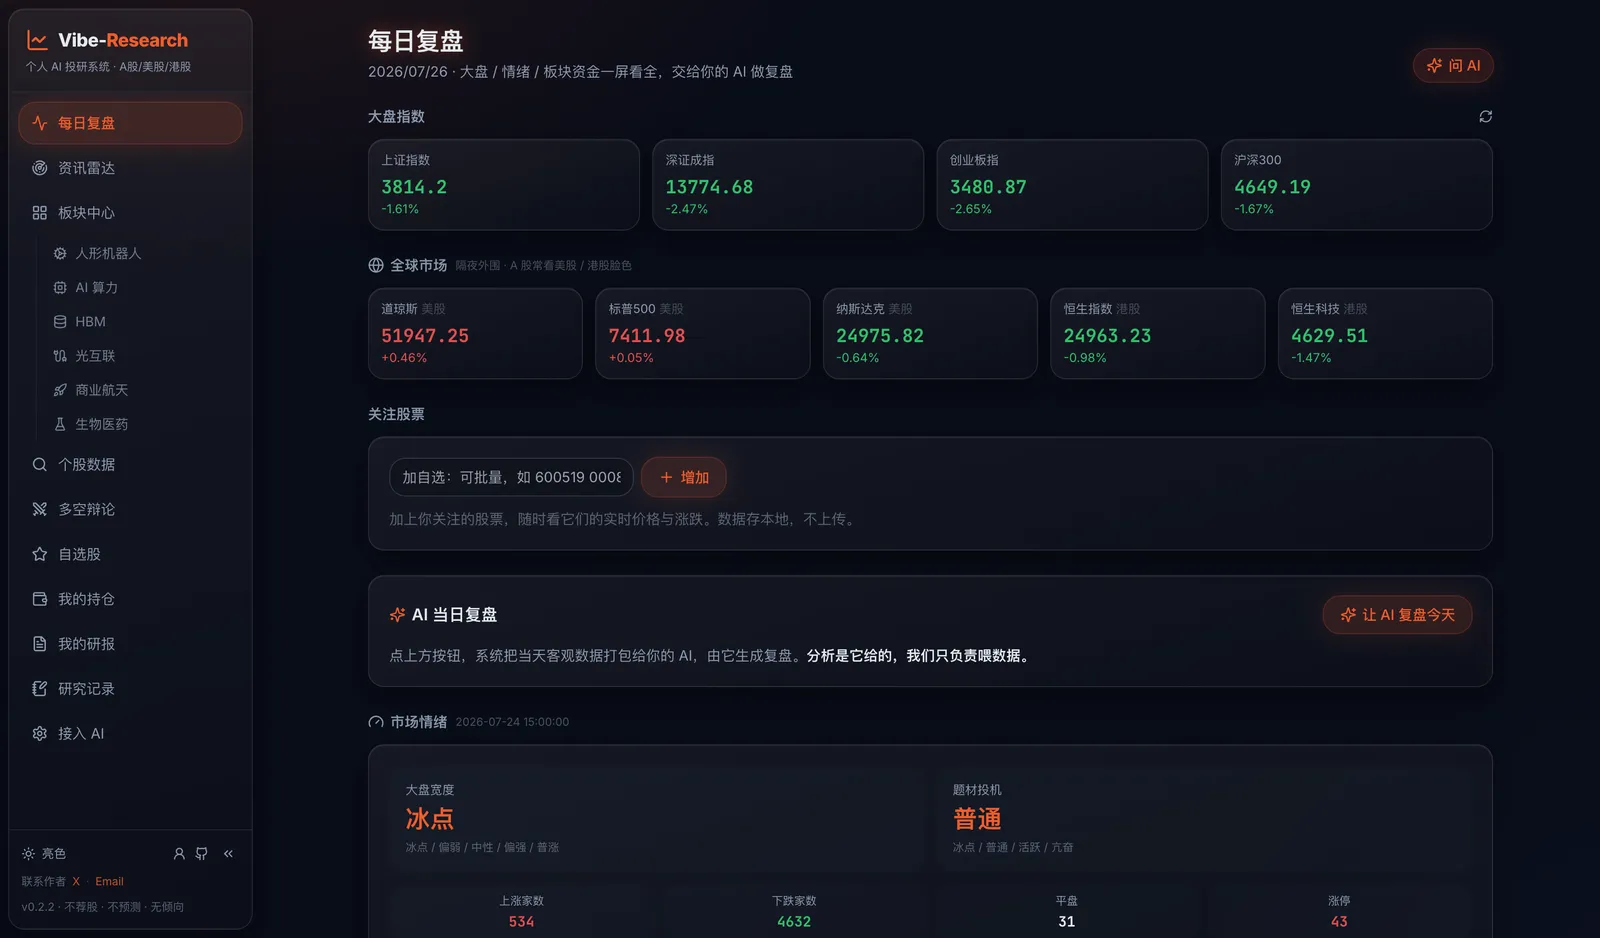
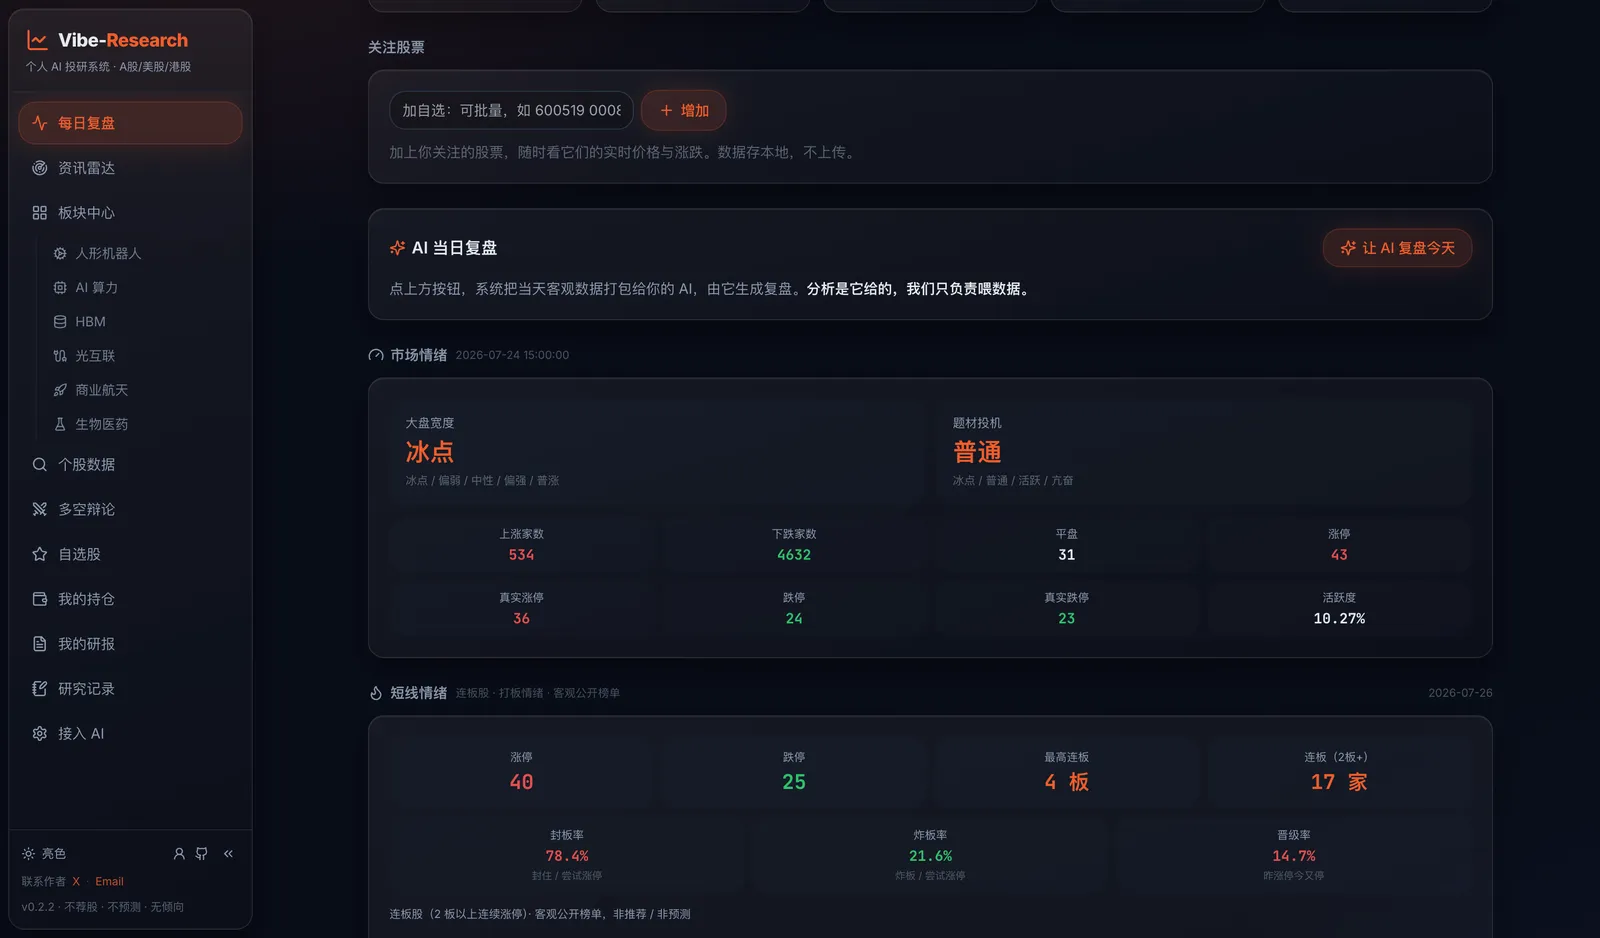
| 📊 每日复盘 | 大盘指数 + 隔夜美股 / 港股 + 关注股票 + 短线情绪(连板股 / 封板率 / 炸板率 / 晋级率)+ 全市场成交额 TOP20 + 板块资金趋势 + 资金轮动 + AI 当日复盘 |
| 📡 资讯雷达 | 12 赛道 108 个公开 RSS 源,AI 一键提炼"今日要点",自动翻译;A 股公告 / 公开新闻挂钩关注列表 |
| 🔍 个股数据 | A 股:行情 / 估值矩阵(前向 PE / PEG)/ 财报速览 / 估值历史分位 / 资金面 / 龙虎榜 / 解禁 / 互动易。美股 / 港股 / 韩股(输 AAPL / 00700 / 005930.KS) |
| ⚔️ 多空辩论 | 事实底稿(13 项数据不经 LLM)→ 多方 / 空方各自立论 → 中立主持归纳共识 / 分歧点 / 验证清单 / 数据缺口(刻意不出买卖结论) |
| 🧩 板块中心 | 板块 + 产业链环节骨架(人形机器人 / AI 算力 / HBM / 光互联…),只给环节不预置标的 |
| ⭐ 自选股 | 批量粘贴代码即加,实时行情可开关,只存本地 |
| 💼 我的持仓 | 录入即实时盈亏,已清仓记录(只存本地、不上传) |
| 📄 我的研报 | 拖拽 / 多选上传(PDF / Word / txt / 表格 / 图片),按文件名自动分行业归档,只存本地部署目录 |
| 📝 研究记录 | 复盘 / 今日要点 / 问 AI / 辩论结果本地沉淀 + 反思审计(让 AI 回头审推理挑刺) |
| 🔌 接入 AI | 订阅接入(本机 CLI 免 key)/ API 多模型(自动填 baseURL)/ MCP(挂进 Claude Code 等 agent) |
🛠️ 快速上手:5 分钟跑通示例
安装(一行命令 + 两步启动)
# 1. 克隆仓库(三套数据源已内嵌)
git clone https://github.com/simonlin1212/Vibe-Research
cd Vibe-Research

# 2. 启动后端(:8900)
cd backend && python3 -m venv .venv
.venv/bin/pip install -r requirements.txt
.venv/bin/python -m uvicorn app:app --host 127.0.0.1 --port 8900

# 3. 启动前端(:5899)
cd ../frontend && npm install && npm run dev
# 浏览器打开 http://localhost:5899
核心代码示例(接入 AI 的三种方式)
# 方式一:订阅接入(用本机已登录的 CLI,免 API key)
# 装 Claude Code / Codex / Qwen Code / DeepSeek CLI 任一个并登录
# 在「接入 AI 页 → 订阅接入」选一个即可,无需填 key
npm i -g @anthropic-ai/claude-code && claude    # 用 Claude 订阅登录

# 方式二:API 接入(baseURL 自动填好,只粘 key)
# 内置 DeepSeek / 豆包 / MiniMax / OpenAI / OpenRouter / Groq / Together / MiMo / 任意 OpenAI 兼容端点

# 方式三:MCP(把后端挂成 MCP server,让 agent 多步分析)
# 详见 backend/README.md
注意:CLI 不做多轮工具调用,适合"复盘 / 今日要点 / 个股页问 AI"这类数据已备好的场景;要 AI 自己现场调数据工具的自由问答,用 API 接入
📊 一屏看穿:A 股 + 美股 + 港股 + 韩股
每日复盘 · 一屏看全今天
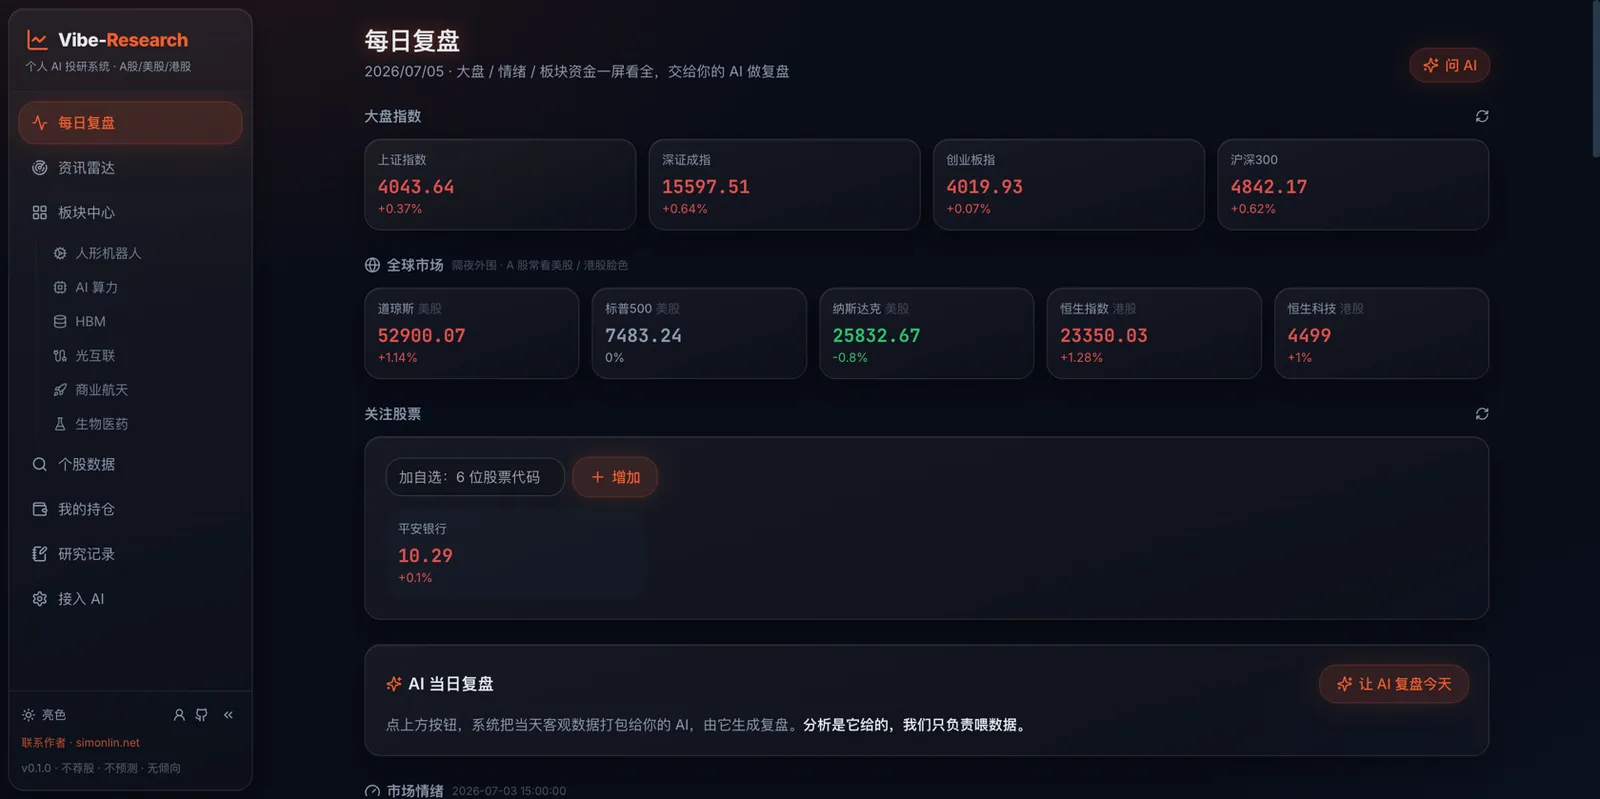
功能说明:把"今天发生了什么"压在一屏——大A 指数、隔夜美股 / 港股、市场情绪、连板梯队、成交额 TOP20、板块资金强弱、资金轮动,全部客观数据 + 一键打包给 AI 复盘。
资讯雷达 · 跨源盯梢,一键成稿
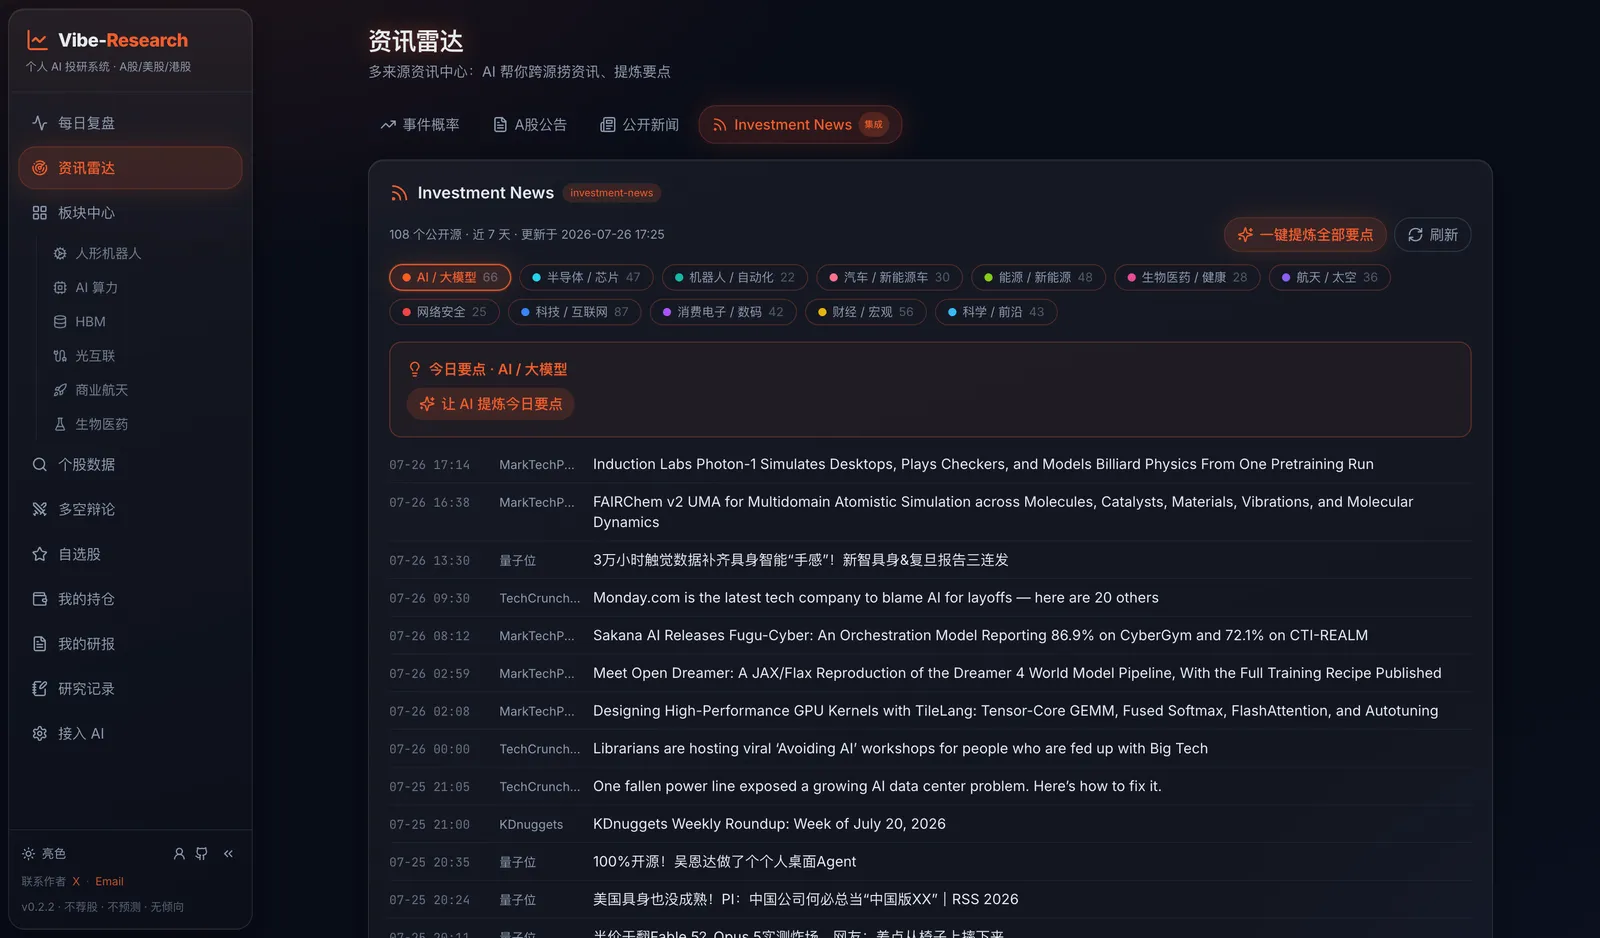
功能说明:12 赛道 108 个公开 RSS 源(半导体 / AI / 机器人 / 新能源车 / 医药…)一一对应大A 板块,AI 一键提炼当天"今日要点"并自动翻译;还内置标的公告 / 标的新闻,挂钩你的关注列表。
输入要求:无需任何 API key,纯标准库实现
输出效果:每条要点可一键复制进研究记录,全程本地
个股数据 · 一屏看穿,只下钻不下结论
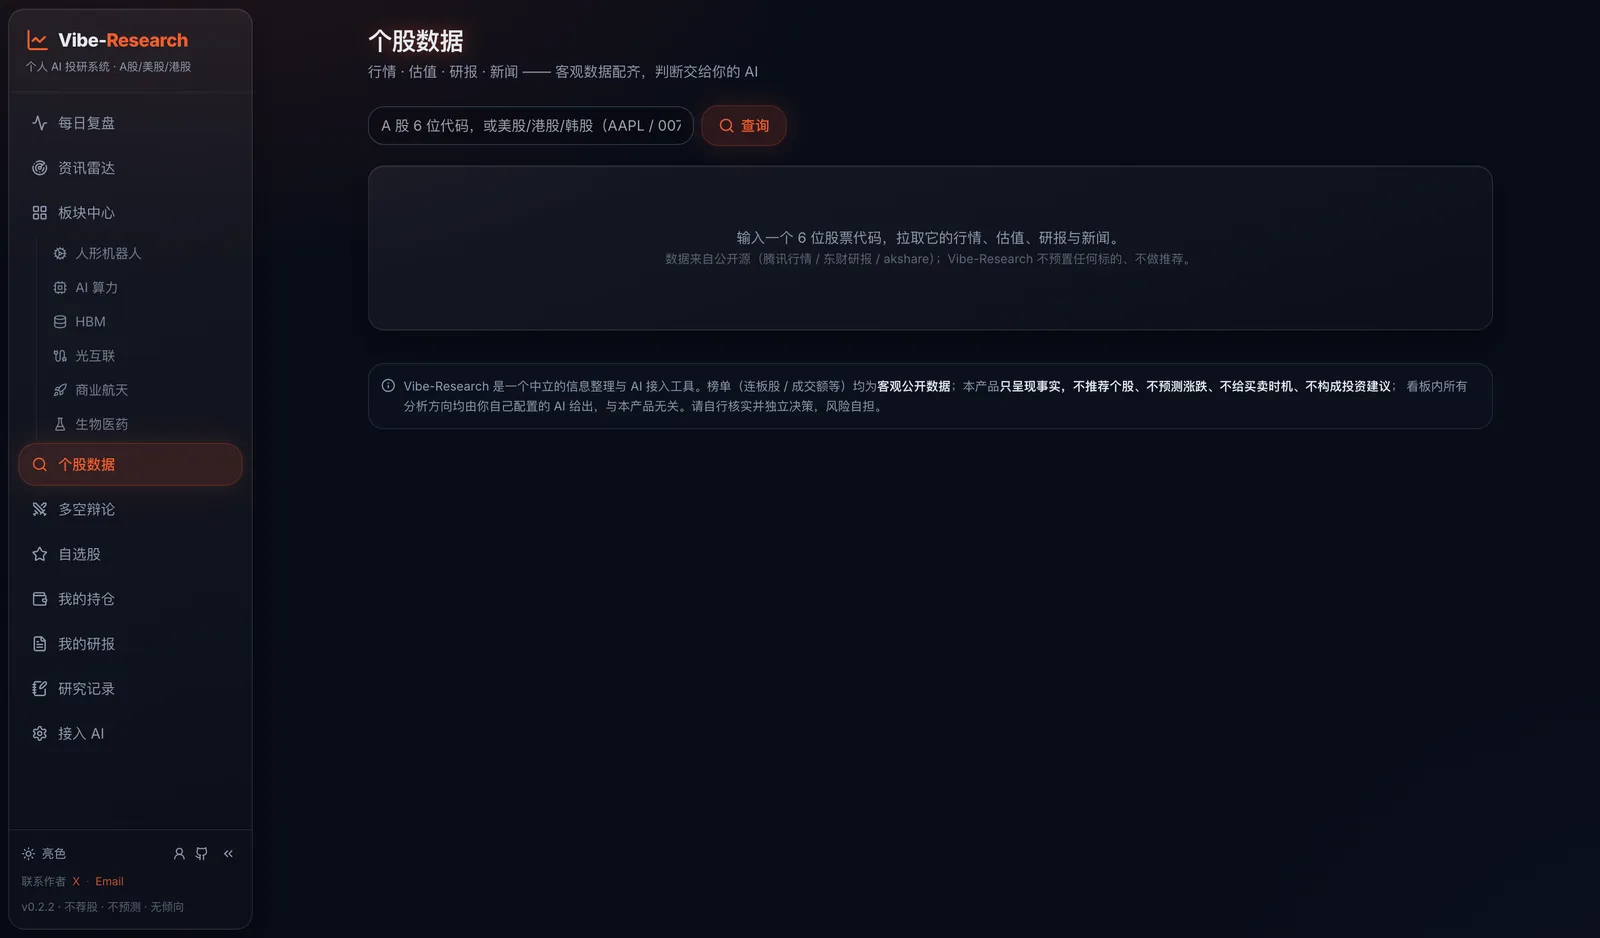
功能说明:输一个代码——大A 六位 / 美港股 AAPL·00700 / 韩股 005930.KS(必须带 .KS 后缀);行情、估值矩阵(前向 PE / PEG)、历史分位、财务、研报、公告、资金面一屏聚合。
核心设计哲学:
- 估值分位只标位置,不划买卖线
- 客观数据配齐,判断交给你的 AI
- 不排名、不预测涨跌、不做主观评分
覆盖维度:估值 / 财报速览 / 研报 / 公告 / 新闻 / 资金面(融资融券 / 股东户数 / 主力资金流 / 分红 / 大宗交易)/ 龙虎榜 / 限售解禁 / 板块归属 / 热门概念 / 互动易
⚔️ 多空辩论:终点是分歧,不是结论
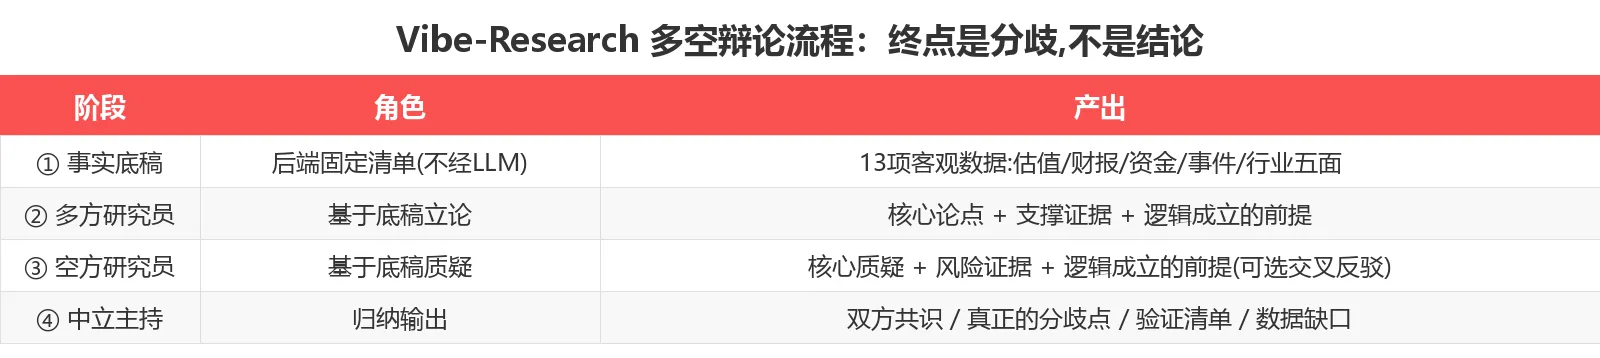
与 TradingAgents / ai-hedge-fund 的关键差异:开源的多 agent 金融框架末端都有一个 trader / portfolio_manager 角色,产出"买 / 卖 / 仓位多少"。Vibe-Research 刻意不做那一层。
这里的多 agent 终点是分歧,不是结论:
① 事实底稿   后端按固定清单拉 13 项客观数据(不经 LLM)
              ↓  多空双方吵的是同一份数据,谁也不能靠编数字赢
② 多方研究员  基于底稿立论:核心论点 + 支撑证据 + 逻辑成立的前提
③ 空方研究员  基于底稿质疑:核心质疑 + 风险证据 + 逻辑成立的前提
   (可选)    交叉反驳:逐条回应对方,承认的明说,能反驳的给数据
④ 中立主持    双方共识 / 真正的分歧点(是数据不足还是解读不同)/ 验证清单 / 数据缺口
一次辩论的开销(跑之前先看这里)
| 维度 | 一轮(各自陈述) | 两轮(加交叉反驳) |
|---|---|---|
| 模型调用次数 | 3 次 | 5 次 |
| 送进模型的内容 | 约 3.5 万字 | 约 6 万字 |
| 模型产出 | 约 4 千字 | 约 7 千字 |
| 耗时 | 约 100–120 秒 | 约 3 分钟 |
其中拉底稿约占 35 秒(打十几个公开数据接口,不消耗任何 token),剩下是模型生成时间。
反思审计
同一思路的延伸:对一段已写好的分析做推理审计,挑出"听起来合理但没有依据"的部分。只有 1 次模型调用,开销小得多。实测能揪出诸如"获得机构广泛认可"(用三家推断整体)、"频繁上调预期"(未量化)这类似是而非的表述。
作者建议:辩论不需要贵模型。数据已经在底稿里备齐了,模型只做组织和表达,中档模型足够;把预算留给你自己的深度提问
📡 数据源:自带三大开源引擎,git clone 即用
Vibe-Research 把三套公开数据源直接集成进仓库——git clone 下来开箱即用,无需另外下载、接线:
| 仓库 | 定位 | Star 数 |
|---|---|---|
| a-stock-data | A 股全栈数据工具包(10 层 · 44 端点 · 15 数据源)—— 本项目的 A 股数据引擎 | 8.3k |
| global-stock-data | 美股 / 港股全栈数据工具包(13 层 · 30+ 端点 · 11 数据源) | 1.4k |
| investment-news | 全球产业链资讯看板(12 赛道一一对应 A 股板块)—— 本项目的资讯源 | 380 |
A 股数据引擎 a-stock-data 覆盖范围
行情 / K 线 / 研报 / 一致预期 / 估值 / 历史分位 / 财务三表 / 公告 / 龙虎榜 / 融资融券 / 大宗交易 / 股东户数 / 分红 / 资金流 / 解禁 / 概念板块 / 打板情绪 / ETF 期权 / 互动易 / 全市场行业排名。
分级依赖:行情(腾讯)+ 研报 / 公告(东财)秒装可用;akshare / mootdx 惰性导入,缺失时对应端点返回 501 + 安装提示,不拖垮服务。
🏗️ 架构:数据层 + 两条 AI 出口
Vibe-Research/
├── a-stock-data/      A 股全栈数据工具箱(数据源,v3.6.0,自带即用)
├── global-stock-data/ 美股 / 港股数据工具箱(数据源,v2.0.3,自带即用)
├── backend/           FastAPI :8900
│   ├── astock.py        A 股数据(移植自 a-stock-data)
│   ├── gstock.py        美股 / 港股数据(移植自 global-stock-data)
│   ├── newsradar.py     资讯雷达(移植自 investment-news)
│   ├── market.py        市场情绪 + 板块资金流 + 全球指数
│   ├── portfolio.py     持仓 + 已清仓(存本地用户目录)
│   ├── tools.py         AI 工具层(23 个数据工具,chat / MCP / debate 共用)
│   ├── chat.py          系统 AI(OpenAI 兼容 function-calling)
│   ├── debate.py        多空辩论编排(事实底稿 → 多空 → 中立主持)
│   ├── reflection.py    反思审计(对已有分析做推理审计)
│   └── mcp_server.py    MCP server(给 Claude Code 等 agent)
└── frontend/          Vite + React 19 + TS + Tailwind(玻璃暖橙主题):5899
三种 AI 接入方式
| 方式 | 适用场景 | 费用 |
|---|---|---|
| 订阅接入(本机 CLI) | 复盘 / 今日要点 / 个股页问 AI(数据已备好) | 免 key,用订阅额度(Claude Code · Codex · Qwen Code · DeepSeek CLI) |
| API 接入(自填 key) | AI 自己现场调数据工具的自由问答(function-calling) | 按 token 计费 |
| MCP(挂进 agent) | 让 agent 多步分析、组合工具链 | 按订阅 / API 计费 |
🔌 接入 AI:工具中立,主流 AI 都能接
订阅接入伙伴
前提:① 后端跑在你本机(云端读不到你本机 CLI);② 对应 CLI 已安装并登录,命令在 PATH 上。
API 接入模型清单
| 模型 | 特性 |
|---|---|
| DeepSeek | 国产高性价比,支持 function-calling |
| 豆包(Doubao) | 字节跳动系列,自动填 baseURL |
| MiniMax | 国产中档选择 |
| OpenAI | GPT-4 / GPT-4o 全系列 |
| OpenRouter | 多模型聚合,按需切换 |
| Groq | 超快推理速度 |
| Together | 开源模型托管 |
| MiMo | 国产新兴选项 |
| 任意 OpenAI 兼容端点 | baseURL 自动填好 |
key 只存你本地浏览器、随请求发给你自己的后端、不上传、不进仓库
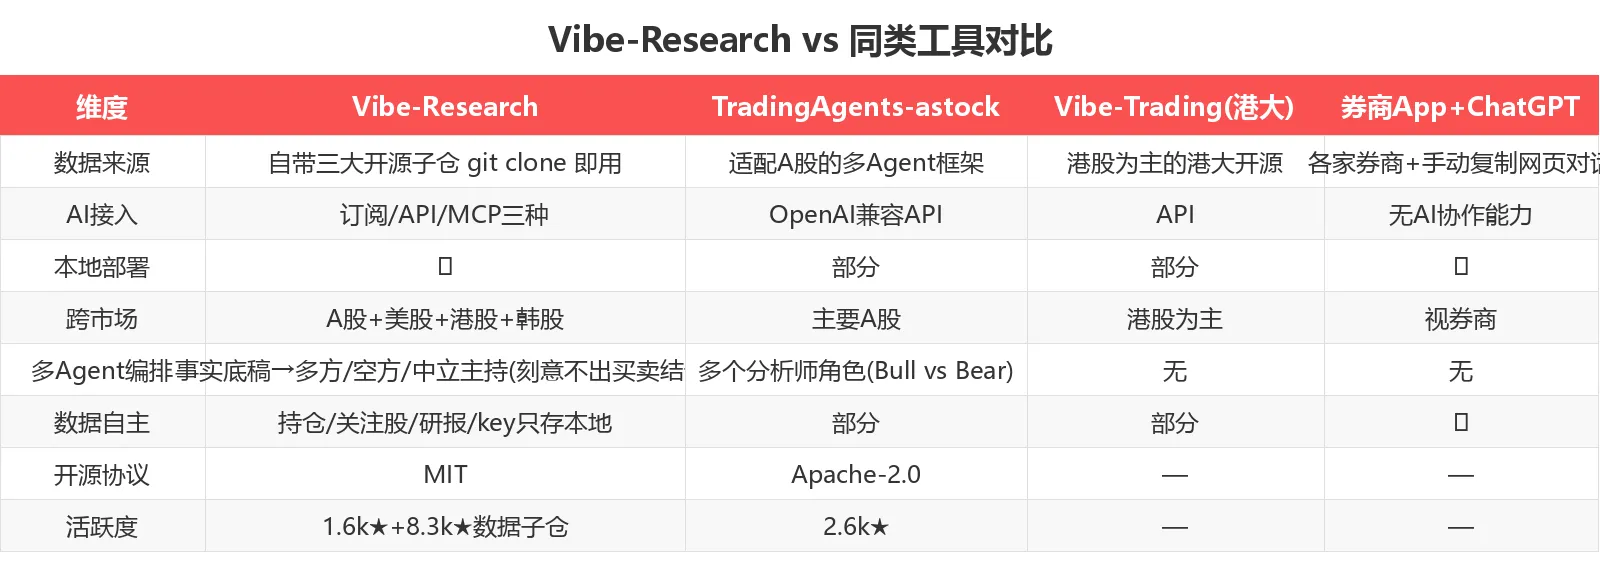
🆚 同类工具横向对比
| 工具 | 数据来源 | AI 接入 | 本地部署 | 跨市场 | 协议 |
|---|---|---|---|---|---|
| Vibe-Research | 自带三大数据源子仓,git clone 即用 | 订阅 / API / MCP 三种 | ✅ | A 股 + 美股 + 港股 + 韩股 | MIT |
| TradingAgents-astock | 适配 A 股的多 Agent 辩论框架 | OpenAI 兼容 API | 部分 | 主要 A 股 | Apache-2.0 |
| HKUDS/Vibe-Trading | 港大开源,港股为主 | API | 部分 | 港股为主 | - |
| QLib(微软) | 量化策略研发 | 无 AI 交互,需自己写模型 | ✅ | 主要 A 股 | Apache-2.0 |
| Zipline | 回测引擎 | 无 | ✅ | 美股为主 | Apache-2.0 |
| 同花顺 iFinD | 数据终端 | 部分 AI 功能 | ❌ | A 股 / 港股 | 商业软件 |
| 券商 App + ChatGPT 网页 | 手动复制 | ❌ | ❌ | 视券商 | - |
关键差异:
- Vibe-Research:把数据层、子仓化、AI 接入解耦;用户可只用数据层(克隆子仓)、只用 AI 接口(MCP)、或全栈跑;自包含零外部封装依赖
- TradingAgents-astock:偏多 Agent 辩论与决策,AI 扮演多个分析师角色;适合研究"AI 怎么思考",但默认依赖外部数据源、自己接
- 券商 App:数据稳定、官方合规,但 AI 协作能力弱,所有跨市场 / 跨工具调用都得手动
- 通用 ChatGPT / Claude 网页对话:没有数据工具调用能力,全靠用户复制粘贴,容易出错且效率低
🔒 合规与边界
⚠️ 本项目仅供学习与研究,不构成任何投资建议。
| 边界 | 说明 |
|---|---|
| ❌ 不荐股 | 只呈现公开榜单数据(东财 / 同花顺同款客观榜单) |
| ❌ 不预测涨跌 | 所有分析方向由你自己配置的 AI 给出 |
| ❌ 不给买卖时机 | UI 无买卖按钮 |
| ❌ 不做主观评分 | 估值历史分位只标位置、不划买卖线 |
| ✅ 中立无倾向 | 辩论不出买卖结论,仅归纳分歧与验证清单 |
| ✅ 数据本地化 | 持仓 / 关注股 / 上传的研报 / API key 只存本地,不上传、不进仓库 |
数据存储路径:持仓与上传的研报默认存在用户目录 ~/.vibe-research/(可用环境变量 VR_DATA_DIR 换根目录、VR_REPORTS_DIR 单独指定研报目录)——在项目文件夹之外,重新下载 / 覆盖更新项目文件夹不会丢数据;旧版本存在 backend/.cache/ 的数据,新版首次启动自动迁移(复制,原文件保留)。
💡 适用场景
场景 1:跨市场盯盘 + 每日复盘
- ✅ A 股 + 美股 ADR + 港股散户,需要在统一面板盯三个市场
- ✅ 想用 AI 辅助日常复盘,但不想为每个市场切一个 App
场景 2:用 Claude Code / Codex 订阅做投研
- ✅ 希望把订阅额度用在正经投研上、不想额外开 API
- ✅ 习惯用
claude/codex等 CLI 工具 - ✅ 想要数据工具调用能力,但不想自己拼提示词
场景 3:本地优先 + 数据自主
- ✅ 对"数据不上传"有强需求(隐私 / 合规 / 个人偏好)
- ✅ 想自己改造数据源(换源 / 加策略),又不想从零搭后端
场景 4:多 agent 投研框架研究者
- ✅ 研究"AI 怎么思考",需要可对比的多 agent 编排
- ✅ 想给 TradingAgents / ai-hedge-fund 加更多数据源
用户群体总结
- ✅ 散户投资者:跨市场盯盘 + AI 复盘
- ✅ Claude Code / Codex 订阅党:把订阅额度用在投研上
- ✅ 数据分析师 / 量化研究者:可复用的 A 股全栈数据 + 美港股数据 + AI 接口
- ✅ 企业 AI 落地探索者:同一作者有 Agent-Staff(把公司 Agent 化)可参考
- ❌ 不适合:追求"AI 替我决策"或需要 SaaS 化云端服务的用户
📝 快速上手:演示截图
每日复盘(顶部)
个股数据
资讯雷达
💰 定价方案
完全免费 + MIT 协议
- ✅ 可商用
- ✅ 可二次开发
- ✅ 可本地部署
- ✅ 无任何 API 调用强制费用(用 CLI 订阅 = 0 额外费用)
可选费用(仅当你选择 API 接入 + 付费模型时):
- 大模型 API:DeepSeek / 豆包 / MiniMax / OpenAI / Claude 等按 token 计费
- CLI 订阅:Claude Code / Codex 等按订阅费(一次性买断或月度)
💡 新用户福利:用「订阅接入」走 Claude Code / Codex / Qwen Code / DeepSeek CLI,0 额外 API 费用
🎯 总结
Vibe-Research 走的是「数据层 + AI 出口」分层路线:自带 a-stock-data、global-stock-data、investment-news 三个已成熟的数据源子仓(Star 数合计已超 1 万),避免重复造轮子;后端做数据 API + MCP server,前端做看板;AI 部分则完全交给用户自己的模型(订阅 / API / MCP 三选一)。
对散户而言,最大价值是把"数据在哪、怎么取、怎么给 AI 用"这一长串链路封装好了;对开发者而言,FastAPI 后端 + 标准化数据端点 + MCP 接口,意味着可以很方便地接入自己的策略或自动化工作流。生态作者 Simon 的几个数据子仓(a-stock-data 8.3k ★、global-stock-data 1.4k ★)已经过较长时间实战检验,是项目能稳定运行的基础。
如果你是 Claude Code / Codex 订阅用户、且有跨市场投研需求,Vibe-Research 是目前少有的「把数据 + Agent 框架 + AI 接入」三件事一起做好的开源方案。本地部署、订阅即可驱动、数据不上传,正好戳中散户最关心的"用 AI 但数据自主"痛点。
推荐指数:⭐⭐⭐⭐⭐(满分 5 星)
适合人群:
- 跨市场散户(A 股 + 美股 + 港股 + 韩股)
- Claude Code / Codex / Qwen Code / DeepSeek CLI 订阅用户
- 数据分析师 / 量化研究者
- 对"数据自主 + 本地部署"有强需求的用户
- 多 agent 投研框架研究者
立即体验:
- 官网:viberesearch.wiki
- GitHub 仓库:simonlin1212/Vibe-Research
数据截至 2026-08-02,最新信息请以官网为准。
⚠️ 本文仅作技术交流,不构成投资建议。股市有风险,投资需谨慎。