TopicFeasibilityScreener
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../topic-feasibility-screener-recommend.pptx../../topic-feasibility-screener-recommend.mp4本文目录
📌 核心价值:让 Codex 自动把"模糊选题想法 + 一份 CSV/DTA"变成可发表级别的选题排序报告
科研第一步最大的尴尬不是不会写代码,而是"有大致的方向,却不知道哪个具体选题值得做"。TopicFeasibilityScreener 把数据画像、选题发散、真实文献检索、理论/数据双重可行性评分、前三候选二次验证——五个步骤压缩成一条 Codex skill 命令,并产出可视化 HTML 报告。
🚀 什么是 TopicFeasibilityScreener?
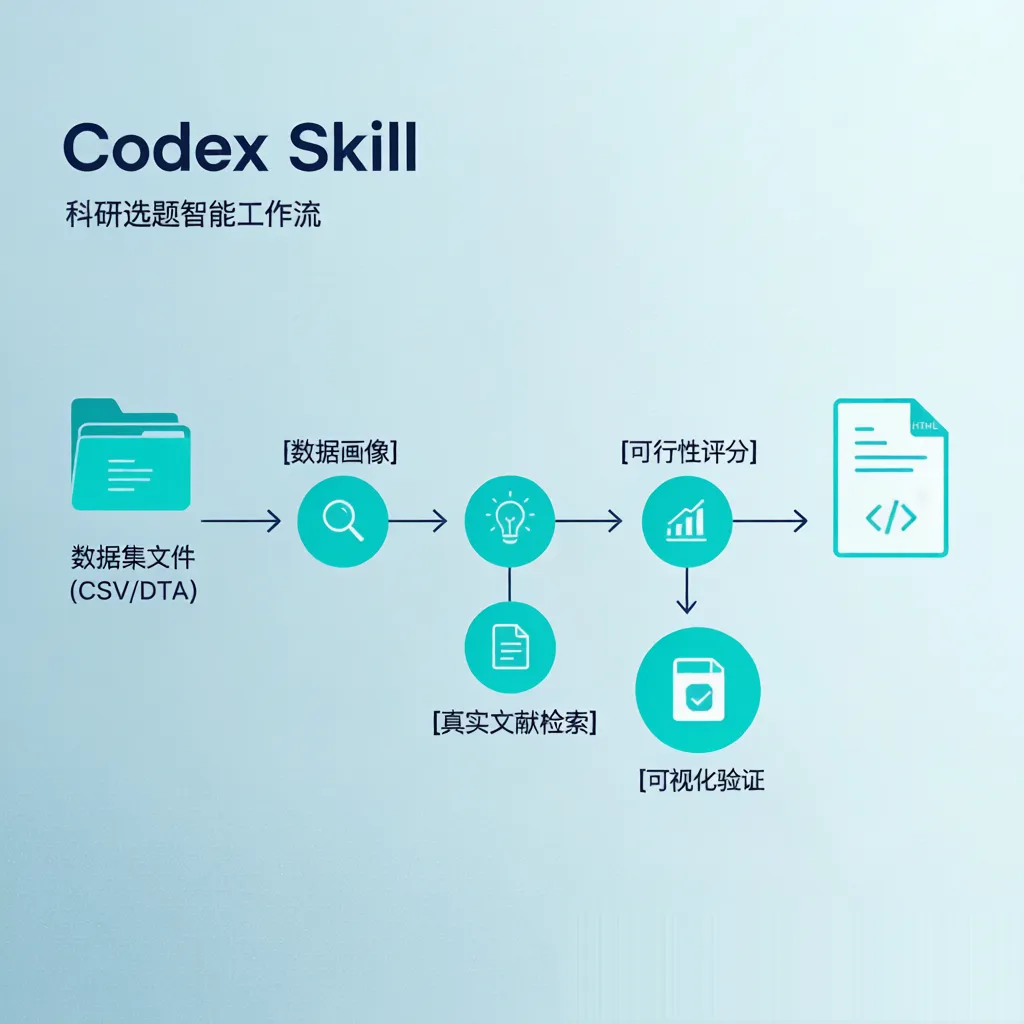
TopicFeasibilityScreener 是一个 Codex Skill——专门为实证研究早期选题阶段设计。你给它一份现有的 CSV 或 Stata DTA 数据集,再加一句"我大致想做 X 方向",它就会自动跑出 5 个步骤:
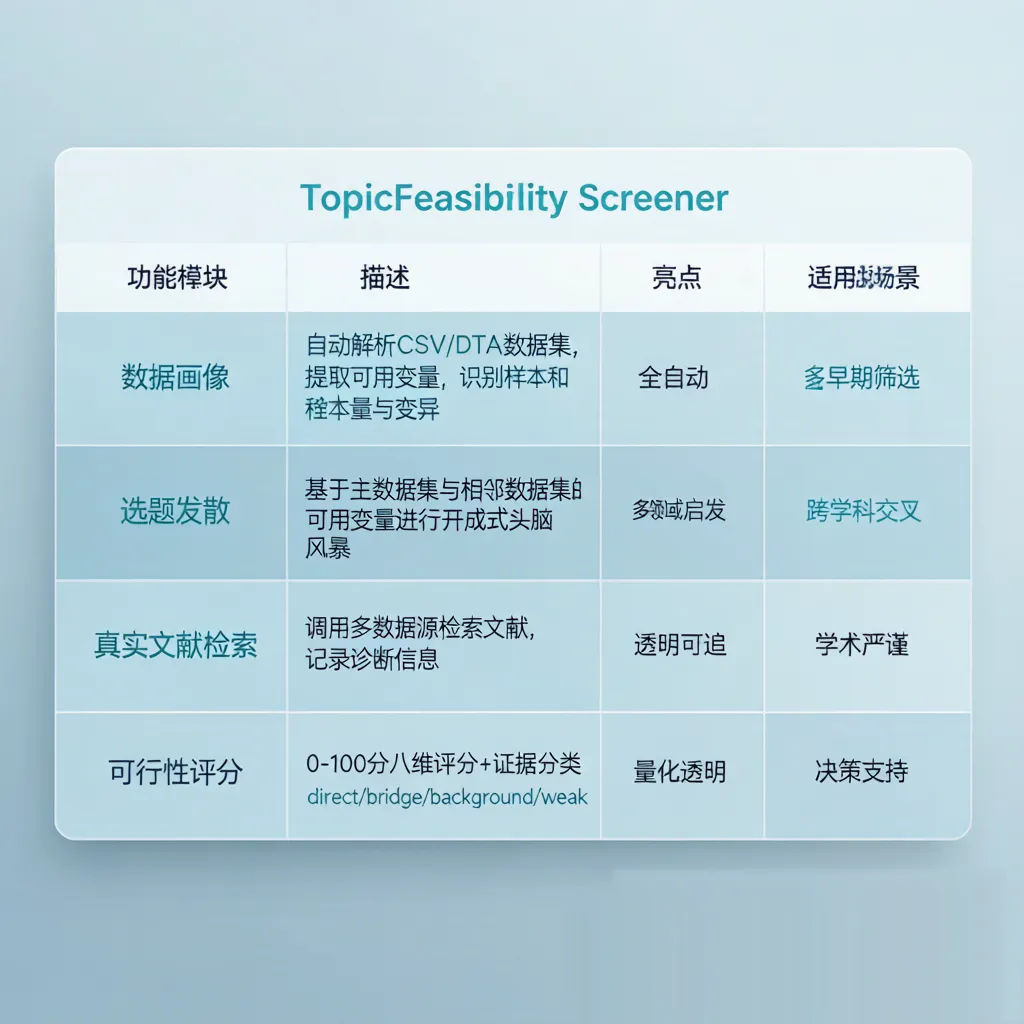
- 数据画像:解析变量、识别样本量、评估变异
- 选题发散:基于主数据集 + 同目录附近数据集的可用变量,开放式头脑风暴
- 真实文献检索:多源检索,记录原始命中/有效命中/相关命中/错误诊断
- 八维评分:总体可行性、实证可行性、理论支持、理论缺口、选题匹配度、论文相关性、来源等级、创新缺口价值——全部 0-100 分
- 二次验证:前三选题做固定效应检验 + 安慰剂/置换式诊断(如数据结构允许)


最终输出不是 Excel 表格,而是一个交互式 HTML 报告——可以截图给导师看、贴进组会 PPT、或者直接当作"候选选题对比表"。
核心定位:不是"显著系数 = 可发表",而是"理论可行 + 数据可行"双重筛查
✨ 核心功能一览
🛠️ 快速上手:5 分钟跑通示例
安装 / 注册
只需把仓库克隆到 Codex skills 目录:
# 克隆仓库
git clone https://github.com/lzh-phd/topic-feasibility-screener.git

# 复制到 Codex skills 目录
# Windows
copy -r topic-feasibility-screener C:\Users\<you>\.codex\skills\
# macOS / Linux
cp -r topic-feasibility-screener ~/.codex/skills/
核心代码示例
场景 1:最简调用(一个数据集 + 一句话方向)
python scripts\research_topic_lab.py "path\to\data.dta" \
  --topic "data resource recognition and corporate reputation"
场景 2:指定变量 + 控制变量(让 skill 知道你的研究设计)
python scripts\research_topic_lab.py "path\to\data.dta" \
  --topic "data resource recognition and corporate reputation" \
  --y ReputationScore \
  --x entry \
  --controls Size Lev ROA Growth BM Board Indep Top1 SOE Cashflow Loss \
  --id firm_id \
  --time year
场景 3:扫描项目根目录 + 深度二次验证(生产环境推荐)
python scripts\research_topic_lab.py "path\to\data.dta" \
  --topic "data resource recognition and corporate reputation" \
  --scan-root "path\to\project_folder" \
  --literature-top 30 \
  --per-query 8 \
  --deep-top 3 \
  --placebo-reps 200
注意:--placebo-reps 200 会跑 200 次安慰剂检验,对前三选题做稳健性诊断——这是传统 ChatGPT 问询完全做不到的事情
输出文件清单
主要输出文件:
| 文件 | 说明 |
|---|---|
research_topic_lab_report.html |
主输出,可视化报告(核心交付物) |
feature_validation_checks.csv |
强制自检文件,核验 6 个功能模块 |
topic_scores.csv |
所有候选选题的八维分数明细 |
second_pass_validation.csv |
前三选题的二次验证结果 |
literature_evidence.csv |
文献证据分类(direct/bridge/background/weak) |
literature_query_diagnostics.csv |
文献检索诊断(原始/有效/相关/错误) |
external_data_profile.csv |
同目录其他数据集的画像 |
external_topic_ideas.csv |
跨数据集启发的新选题 |
variable_profile.csv |
主数据集变量画像 |
summary.json |
JSON 摘要(便于程序化处理) |
📊 八维评分体系详解
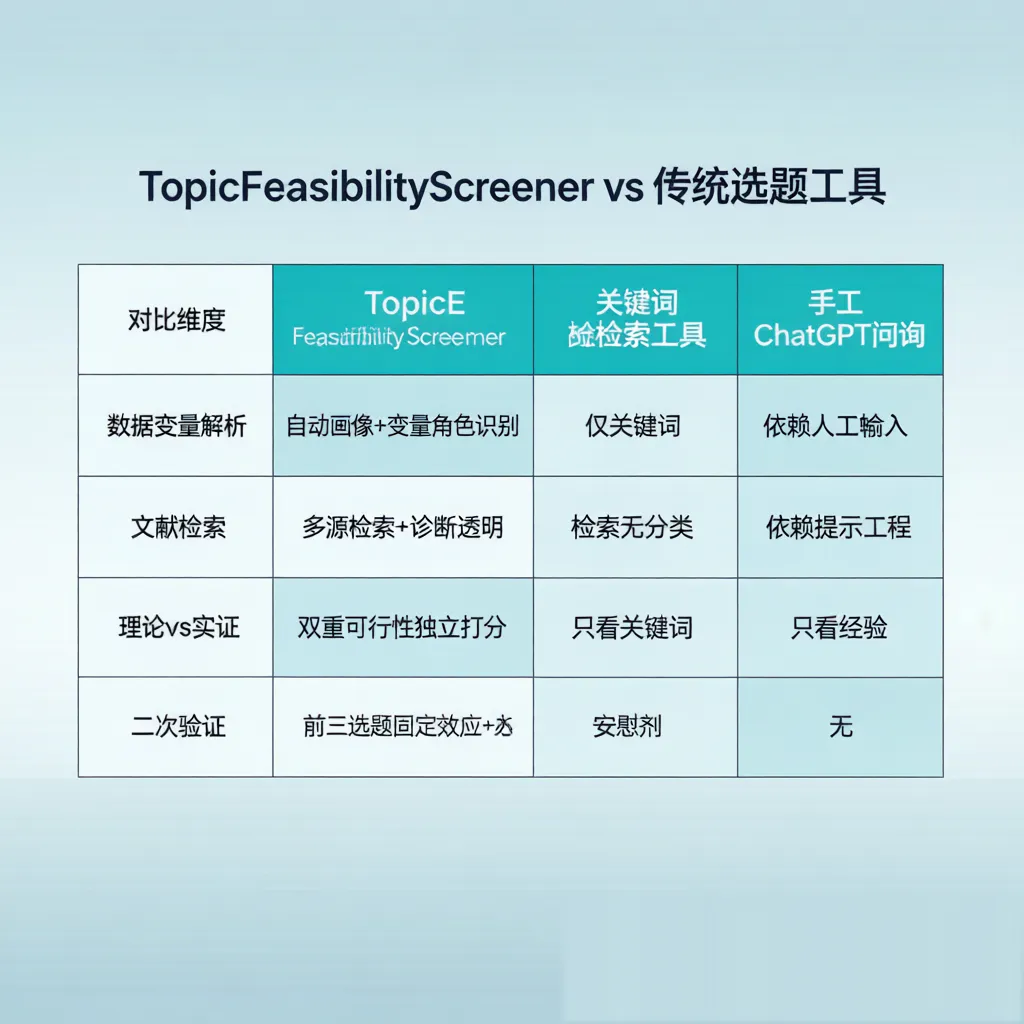
传统关键词工具最大的问题——给每个候选选题一个"综合分",但不知道这个分数是怎么来的。
TopicFeasibilityScreener 把可行性拆成 8 个独立维度,全部 0-100 分:
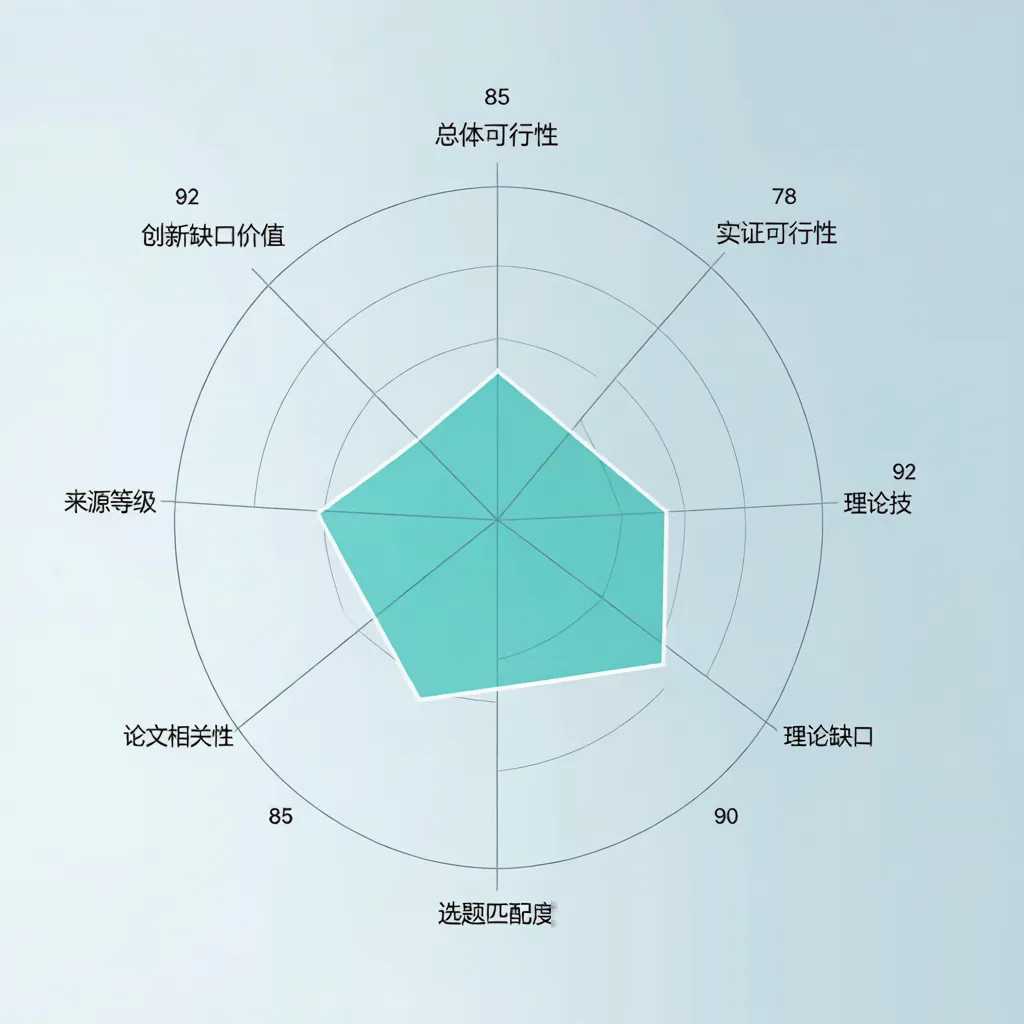
| 维度 | 计算依据 |
|---|---|
| 实证可行性 | 初步回归信号 + 前三选题二次验证 |
| 理论支持 | 来源等级、相关性、时效性、引用、方法、机制、证据类别 |
| 理论缺口 | 奖励活跃但不饱和的文献领域;直接证据缺失但桥接证据强时加分 |
| 选题匹配度 | 保证生成选题与用户给定方向相关,但保留开放式发散 |
| 创新缺口 | 区分"真正缺乏理论基础"vs"前沿缺口+相邻文献支撑" |
| 论文相关性 | 评估选题对顶级期刊的潜在契合度 |
| 来源等级 | 文献来源期刊/会议的影响因子分级 |
| 总体可行性 | 上述维度的加权综合 |
关键设计:直接证据缺失 ≠ 选题失败——这是第一次更新版对传统工具最大的改进
🔬 证据分类:direct / bridge / background / weak
很多工具只看"有没有相关文献",但实证研究中没有直接证据 ≠ 没有理论基础。
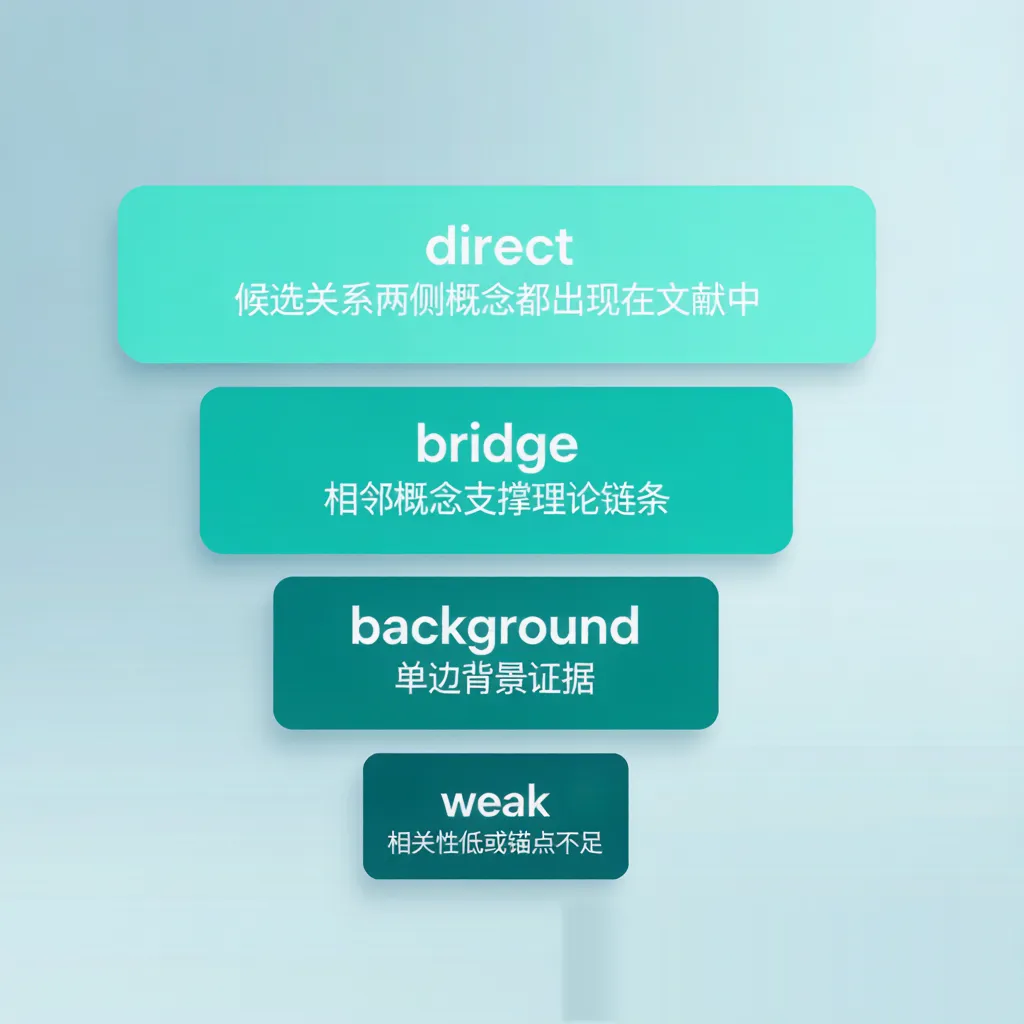
| 证据级别 | 含义 | 选题潜力 |
|---|---|---|
| direct | 候选关系两侧概念都出现在文献中 | 已成熟,竞争激烈 |
| bridge | 相邻概念支撑理论链条(如信息资产→数据资产→企业声誉) | 前沿机会 ← 这个最有价值 |
| background | 单边背景证据 | 辅助材料 |
| weak | 相关性低或锚点不足 | 慎选 |
实际意义:当 direct_evidence_hits = 0 时,只要 bridge_evidence 密集且概念距离近,这个选题反而可能是最有创新空间的——这是探索性研究最看重的特性。
📊 与传统选题方式对比
💡 适用场景
场景 1:研一新生拿到一份 CSMAR 数据集
功能说明:研一新生最常见的困境——导师给了"用 CSMAR 做一个公司治理方向的题",但具体做什么不知道。TopicFeasibilityScreener 在 10 分钟内输出 10-20 个候选选题,每个都有八维评分。
输入要求:CSMAR 的 CSV 文件 + 一句"我大致想做公司治理"
输出效果:research_topic_lab_report.html 包含:
- 候选选题列表(按综合分排序)
- 每个选题的雷达图(八维可视化)
- 文献证据卡片(direct/bridge/background/weak 分类)
- 前三选题的固定效应 + 安慰剂检验结果
适用场景:
- ✅ 硕士开题前 2 周
- ✅ 博士第一年定方向
- ✅ 跨学科选题(会计+AI+ESG)
场景 2:跨数据集启发新选题
功能说明:单一数据集往往限制思路。--scan-root 参数让 skill 自动扫描项目根目录下所有 CSV/DTA,识别"主数据集 + 辅助数据集"组合,启发跨数据集选题。
输入要求:项目文件夹路径(含多个数据集)
输出效果:
external_data_profile.csv——其他数据集画像external_topic_ideas.csv——跨数据集启发的新选题
适用场景:
- ✅ 多源数据融合论文
- ✅ "X + Y" 复合选题
- ✅ 同一变量的多数据集稳健性检验
场景 3:组会汇报选题进展
功能说明:传统方式——导师问"你的选题依据是什么",你只能口头说"看了几篇文献觉得不错"。用 TopicFeasibilityScreener 后,直接展示 HTML 报告。
输入要求:HTML 报告(已生成)
输出效果:
- 可视化雷达图——一眼看出选题的强弱维度
- 文献诊断——证明检索是透明的、可复现的
- 自检文件——证明评分系统没有被篡改
适用场景:
- ✅ 开题答辩
- ✅ 组会汇报
- ✅ 合作者快速同步
用户群体总结
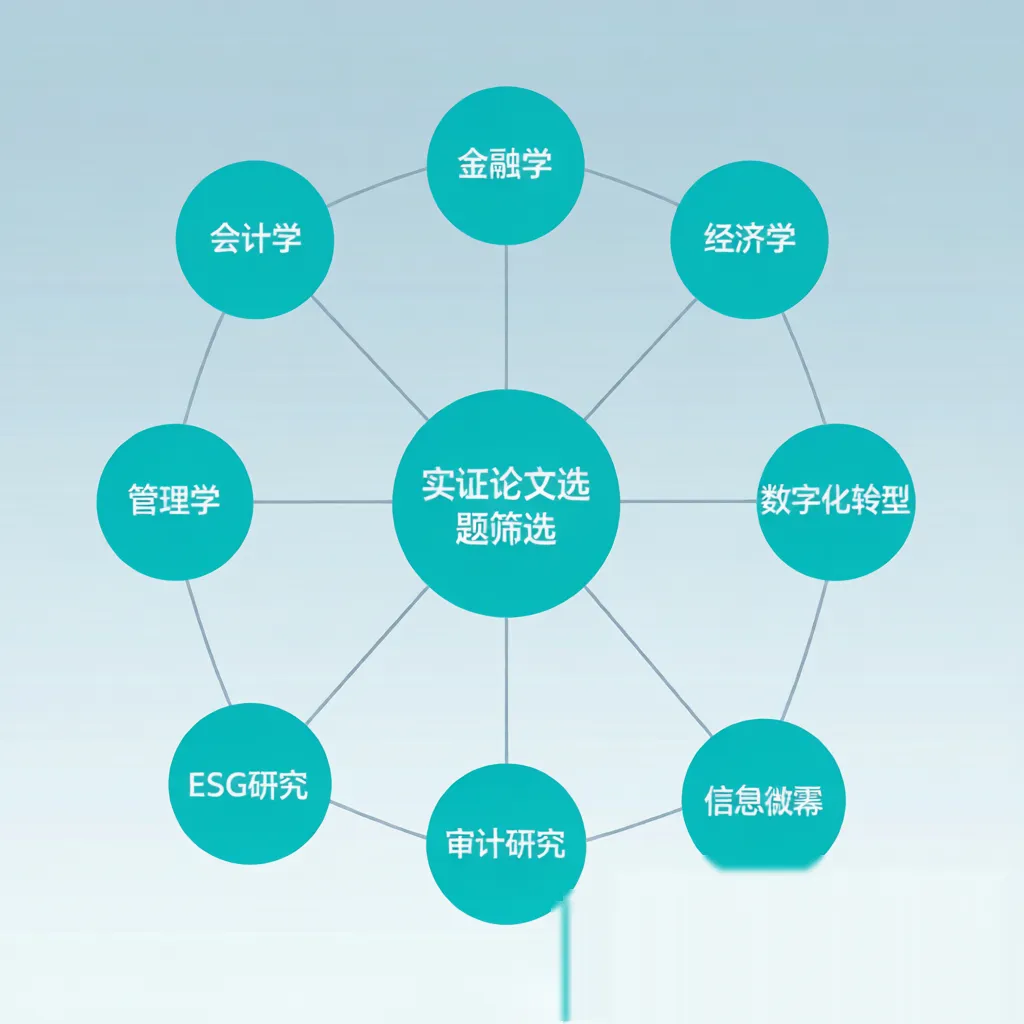
- ✅ 会计/金融/经济/管理硕博:CSMAR/Wind/CNRDS 数据集的标准工作流
- ✅ 公司治理/数字化转型/ESG 研究:变量丰富、需要严谨筛查
- ✅ 跨学科选题:从数据反推选题,比"先定题再找数据"更高效
- ❌ 不适合纯理论研究:本工具专为实证研究设计
- ❌ 不适合小型调查数据:样本量 < 100 时回归信号不稳定
💰 定价方案
完全免费 + 开源。
| 项目 | 说明 |
|---|---|
| 工具本体 | MIT License,免费使用 |
| Codex 调用 | 需要 ChatGPT Plus 或 Team 订阅(使用 Codex 沙盒) |
| 数据 | 你自己的 CSV/DTA,本地处理 |
| 文献检索 | 调用免费数据源,无需 API key |
开源协议: MIT
💡 学生福利:MIT 协议允许二次开发——你可以 fork 后改成自己学科的版本(如法学、医学)
🎯 总结
TopicFeasibilityScreener 解决的不是一个"AI 写论文"的玄学问题,而是一个非常具体的工程问题:把科研选题从"灵感驱动"变成"数据驱动"。
它不保证让你发顶刊,但它保证:
- 不浪费时间——5 分钟看到 10 个候选选题的八维评分
- 不凭空假设——文献检索透明可复现
- 不忽视数据——实证可行性独立打分
- 不忽略细节——前三选题二次验证
推荐指数: ⭐⭐⭐⭐(4/5,少1星因为仍需要 Codex 沙盒环境)
适合人群: 会计/金融/经济/管理硕博生 + 早期研究人员
立即体验: lzh-phd/topic-feasibility-screener
数据截至 2026-07-04,最新信息请以 GitHub 仓库为准。