270亿参数的小模型,在 Agent 战场上追平了 Claude Opus:阿里开源 Qwen3.8-27B
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../qwen38-recommend.pptx../../qwen38-recommend.mp4270亿参数的小模型,在 Agent 战场上追平了 Claude Opus:阿里开源 Qwen3.8-27B
金句:当大模型的战争从「谁的参数量更大」变成「谁的 Agent 更能干活」,27B 这一档,突然成了最性感的尺寸。
8 月 14 日晚,阿里千问悄悄干了一件大事:开源 Qwen3.8-27B。
别被「27B」这个看似不起眼的数字骗了。这是一款原生多模态稠密(Dense)模型,参数量只有 270 亿,整体水平却超过了自家的 Qwen3.7-Plus——一个参数规模明显更大的模型;并且在软件工程、电脑操作、手机操作这一整类「Agent 任务」上,追平甚至超过了 Claude Opus 4.6 Max。
更狠的是:它用 Apache 2.0 协议开源,量化之后普通消费级显卡就能跑。
如果把过去两年的开源叙事总结成一句话,那是「越大越好」。Qwen3.8-27B 想说的是另一句:在真实干活这件事上,小模型正在追上大模型。
先看图:它到底强在哪
Qwen3.8-27B 不是「样样第一」的模型,它在科学推理、高难综合推理上仍落后于 Opus 4.6 Max。但它赢的,恰恰是当下最被需要的那一档——让 AI 替你操作电脑、写代码、跑长周期办公任务。
下面这张表,把几个关键 Agent 基准拉出来对比(数据来自阿里官方公布的评测):
| 测试 | Qwen3.8-27B | Qwen3.7-Plus | Opus 4.6 Max | 胜负 |
|---|---|---|---|---|
| SWE-bench Pro(仓库级代码) | 61.7 | 57.6 | 53.4 | 27B 胜 |
| QwenSWEBench(软件工程) | 79.0 | 59.2 | 63.8 | 27B 胜 |
| CoWorkBench(长周期办公) | 70.7 | 65.1 | 68.2 | 27B 胜 |
| OSWorld-Verified(电脑操作) | 84.3 | 73.3 | 72.7 | 27B 大胜 |
| AndroidWorld(手机操作) | 81.9 | 81.0 | 62.0 | 27B 胜 |
| SWE-MM(多模态软件工程) | 38.6 | 30.0 | 27.1 | 27B 胜 |
| LiveCodeBench v6(竞技编程) | 90.3 | 89.6 | 88.8 | 27B 微弱胜 |
| Terminal Bench 2.1 | 73.0 | — | 78.2 | 负 Opus |
| GPQA Diamond(科学推理) | 89.2 | 90.3 | 91.3 | 负 Opus |
| HLE(高难综合推理) | 30.8 | 34.7 | 40.0 | 负 Opus |
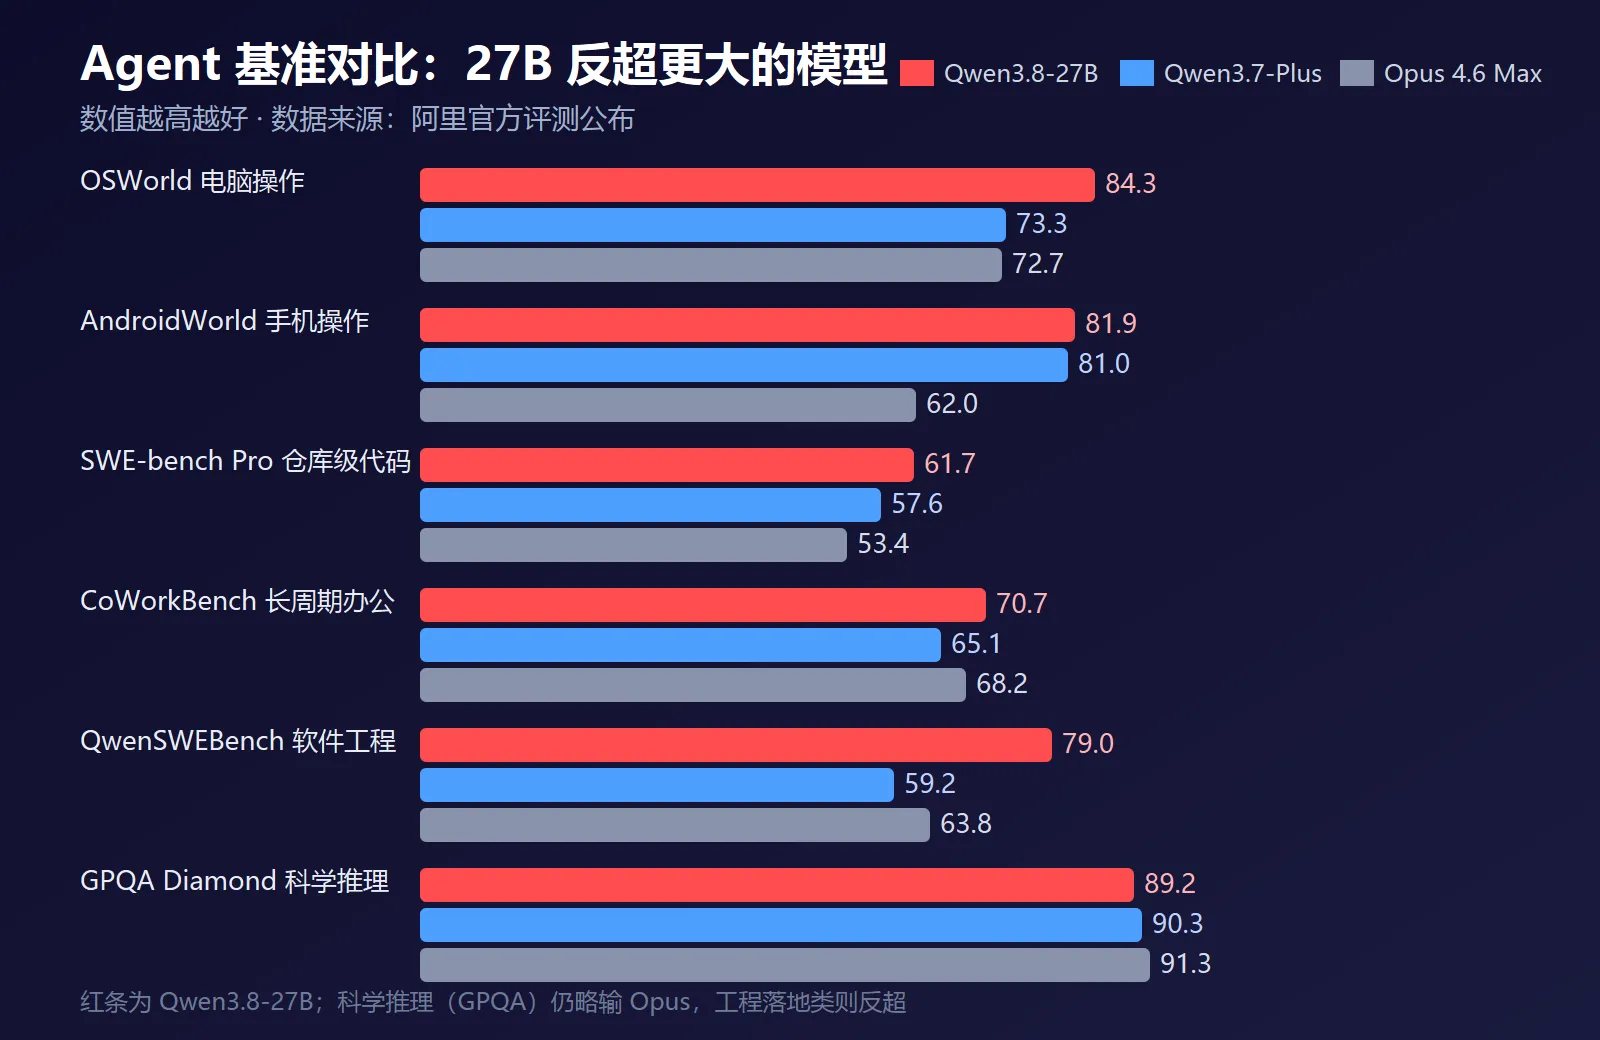
注意一个反直觉的细节:**OSWorld-Verified(让 AI 操作真实电脑界面)**这项,27B 拿到 84.3,比 Opus 4.6 Max 的 72.7 高出近 12 分。在「能不能帮你点鼠标、填表单、跨应用搬数据」这种最落地的能力上,小模型反而笑了。
它是什么:一个被重新定义的「小钢炮」
Qwen3.8-27B 的几个关键标签:
- 原生多模态:不是后期拼视觉模块,而是生来就能看图、看视频、理解文档;
- 262K 原生上下文,用 YaRN 技术还能外推到 1M tokens——一本长书一次性塞进去没问题;
reasoning_effort可控推理:根据任务难度动态调节「思考深度」,简单活少想、难活多想,省 token;- Apache 2.0 协议:最宽松的开源许可,可免费下载、部署、商用,没有任何营收门槛;
- 量化后消费级显卡可跑:这是它和动辄要几张 A100 的旗舰模型最大的分水岭。
一句话:它把原生多模态、长上下文、可控推理、Computer Use、软件工程、长周期办公,全部塞进了一个 27B 的身子,还让你在家用显卡上就能跑。
一组让行业沉默的数字
Qwen3.8-27B 值得写,不只因为它强,更因为它背后那个开源帝国的体量:
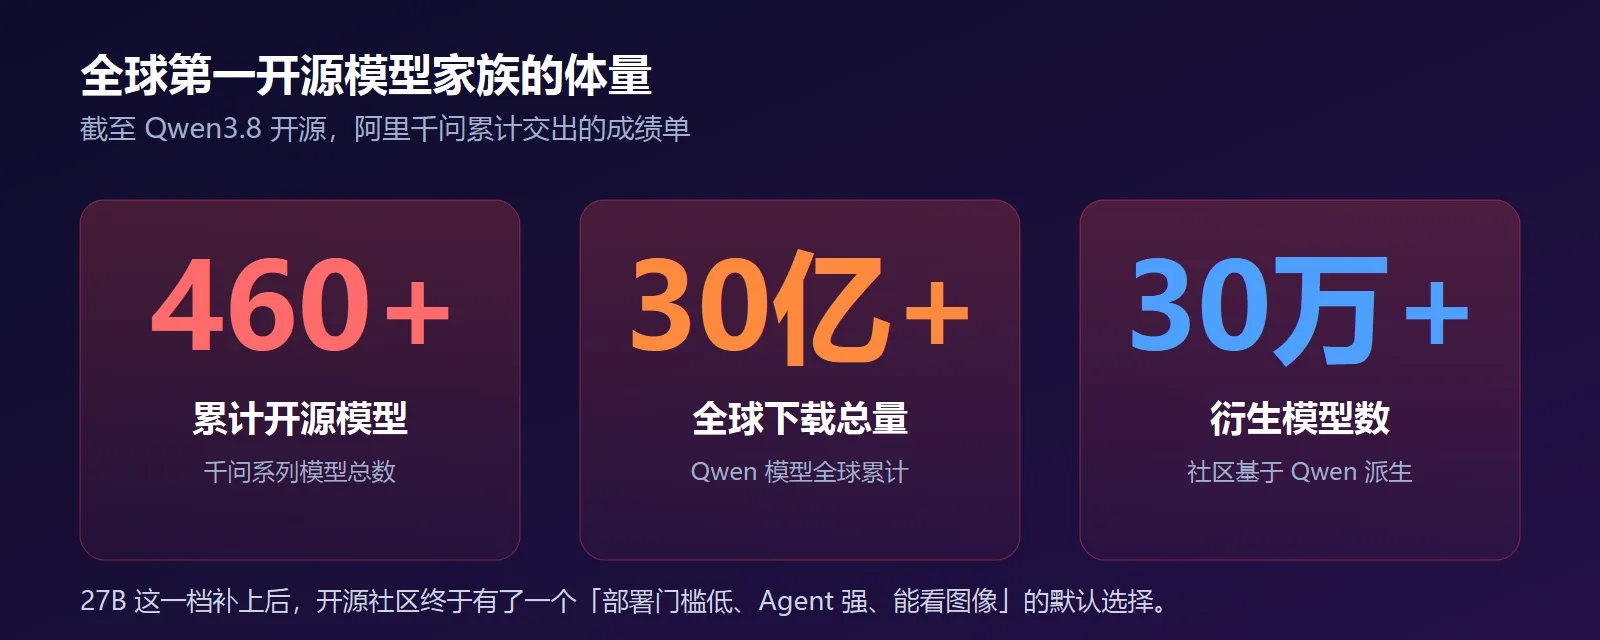
- 阿里已累计向全球开源 460 余个千问系列模型;
- Qwen 全球下载总量 突破 30 亿次;
- 衍生模型数 超过 30 万个;
- 千问稳居全球第一开源模型家族。
这意味着:你手机里、笔记本上、公司服务器里跑的无数 AI 应用,底层可能都是 Qwen。27B 这一档补上之后,开源社区终于有了一个「部署门槛低、Agent 能力强、还能看图像」的默认选择。
实用价值:家用显卡部署 + 可控推理
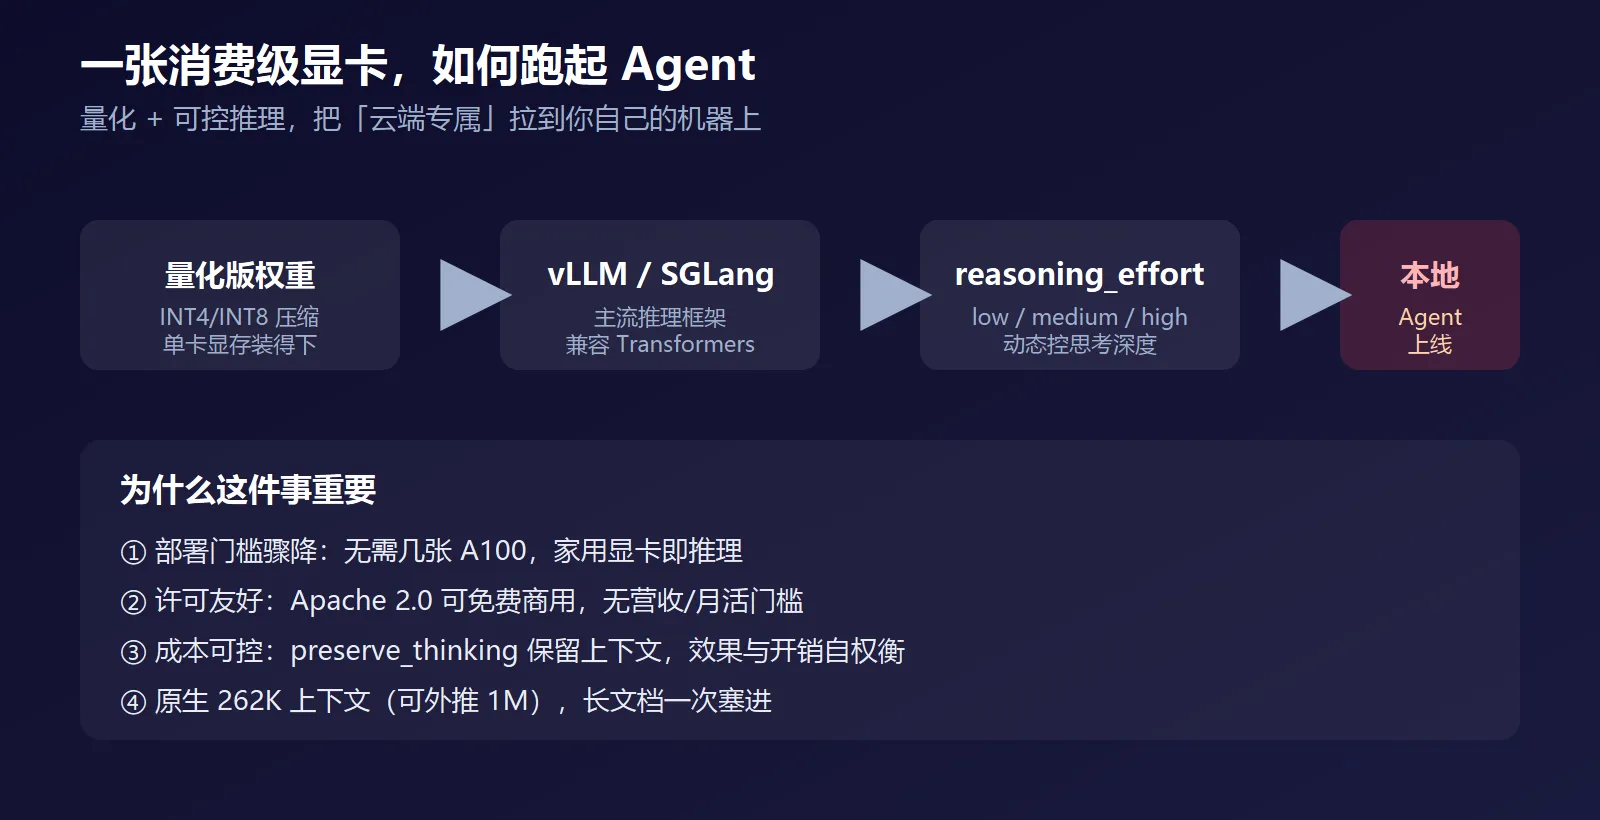
这是普通人最能感知的部分。旗舰模型 Qwen3.8-Max 是 2.4T 参数的巨无霸,普通人根本跑不动;27B 这一档,量化后一张消费级显卡就能流畅推理。
而且它的推理是可调的。默认开启思考模式,但你可以针对单次请求关闭思考,并用 preserve_thinking 保留历史推理上下文——在「效果」和「推理成本」之间做细粒度权衡。
最小可跑示例(基于 vLLM,量化版):
from vllm import LLM, SamplingParams

# 加载量化后的 Qwen3.8-27B(消费级显卡可跑)
llm = LLM(
    model="Qwen/Qwen3.8-27B",
    tensor_parallel_size=1,          # 单卡即可
    gpu_memory_utilization=0.85,     # 按显存自适应
    max_model_len=262_000,           # 原生 262K 上下文
)

params = SamplingParams(
    temperature=0.7,
    max_tokens=2048,
    # reasoning_effort 控制思考深度:low / medium / high
    extra_body={"reasoning_effort": "medium"},
)

# 多模态输入:直接喂图和指令
messages = [{
    "role": "user",
    "content": [
        {"type": "image_url", "image_url": {"url": "file://screenshot.png"}},
        {"type": "text", "text": "这张图里的报错怎么修?给出最小修改。"},
    ],
}]
outputs = llm.chat(messages, params)
print(outputs[0].outputs[0].text)
它已兼容 Hugging Face Transformers、vLLM、SGLang、TokenSpeed 等主流框架,迁移成本极低。
它没赢的地方:诚实比吹捧更有价值
爆款文章最容易犯的错,是把模型写成「全面碾压」。Qwen3.8-27B 不是。
在 **Terminal Bench 2.1(终端级长任务)**上,它 73.0,落后于 Opus 4.6 Max 的 78.2;在 **GPQA Diamond(科学推理)**上 89.2 对 91.3;在 **HLE(高难综合推理)**上差距更明显,30.8 对 40.0。
换句话说:它赢在工程落地和具身操作,输在需要深科学积累和超长链条综合推理的硬核考场。 把它当成「本地 Agent 主力」毫无问题;指望它替你做前沿科研推理,还是交给更大的模型更稳。
最适合谁:三个清晰的场景
- 本地 Agent / 自动化玩家:想在自己机器上跑一个能操作电脑、写代码、处理文档的助手,27B + 量化是目前的甜点档。
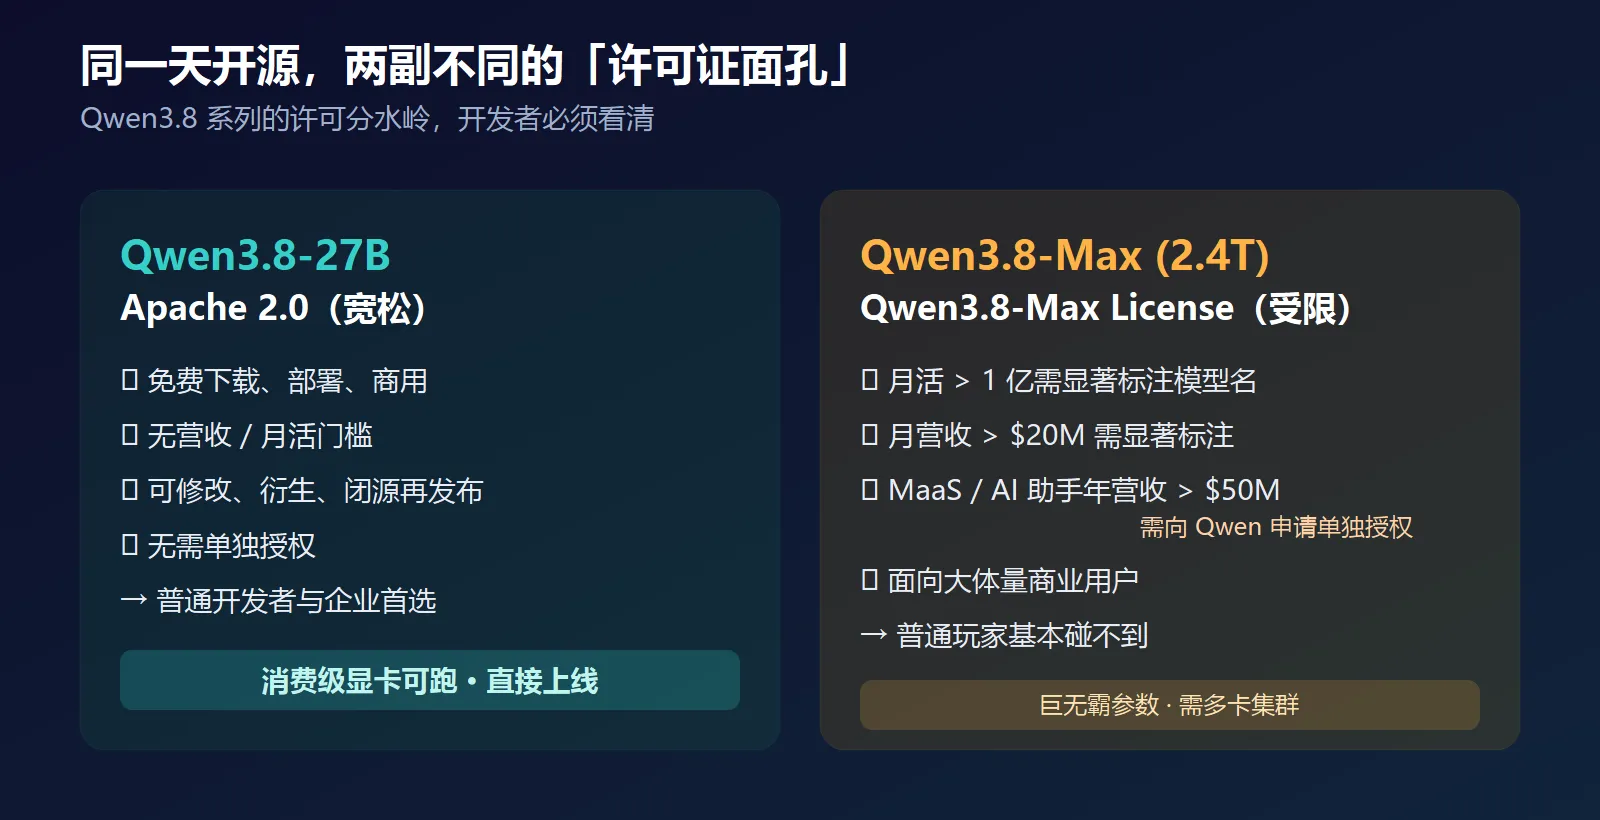
- 成本敏感的创业团队:Apache 2.0 可商用,无需为「月活上亿」或「营收超限」支付额外授权,部署即上线。
- 多模态办公流水线:需要「看图 + 长文档 + 跨应用操作」组合能力的企业内部工具。
本文重点回顾
- Qwen3.8-27B 是 270 亿参数的原生多模态稠密模型,Apache 2.0 开源,消费级显卡可跑;
- 它在 Agent / Computer Use / 软件工程类任务上追平或超越 Claude Opus 4.6 Max,但科学推理仍落后;
- 阿里开源家族已达 460+ 模型、30 亿下载、30 万衍生,全球第一;
reasoning_effort让推理成本可控,原生 262K 上下文(可外推 1M);- 它标志着 Agent 能力正式下沉到 27B 这一易部署档位。
结尾金句:大模型的下半场,比的不再是「我有多大」,而是「你愿不愿意让我在你自己的显卡上,踏实干活」。
延伸阅读
- 阿里官方 Qwen3.8 发布说明(Hugging Face / ModelScope 同步上线)
- Qwen3.8-Max License 与 Apache 2.0 的双许可差异(Max 对大体量商业用户有额外授权要求)
- SWE-bench Pro、OSWorld-Verified、AndroidWorld 基准官方主页