阿里第一次把 Max 旗舰开源:2.4 万亿参数的 Qwen3.8 来了
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../media/qwen3-8-2-4t-a95b.pptx../media/qwen3-8-2-4t-a95b.mp4本文目录
阿里第一次把 Max 旗舰开源:2.4 万亿参数的 Qwen3.8 来了
金句开头:过去一年,国产大模型最会说的一句话是"我们开源了";但真正敢把自家最强旗舰的权重也交出来的,阿里是头一个。
8 月 13 日,阿里千问团队在 Hugging Face 和魔搭社区同步放出了 Qwen3.8-2.4T-A95B 的完整模型权重。这不是一个蒸馏小模型,也不是上一代的残血版——它正是云端旗舰 Qwen3.8-Max 的底层权重,总参数 2.4 万亿,每个 token 激活 950 亿。这是阿里历史上第一次把 Max 级别的旗舰模型对外开放权重。
一句话判断:国产开源大模型的天花板,被又抬高一截;而更值得玩味的是,就在同一天的 24 小时窗口里,DeepSeek V4 Pro 正式版上线、xAI 的 Grok 4.6 发布——开源与闭源,正进入贴身肉搏的阶段。
为什么这篇值得写?
过去国产实验室的开源策略很克制:开源的通常是更小的杯型、或者上一代的旧权重,旗舰始终攥在手里做 API 生意。Qwen3.8-2.4T-A95B 打破了这个默契——它把"旗舰权重"也端上了开源餐桌。
对开发者这意味着三件事:你可以自部署、可以微调、可以放进自己的 VPC 里跑私有数据。对行业这意味着:开源模型的"开放"定义被重新抬高了,百度、字节、智谱都面临被迫跟进的压力。
先看图:Qwen3.8 到底是什么体量
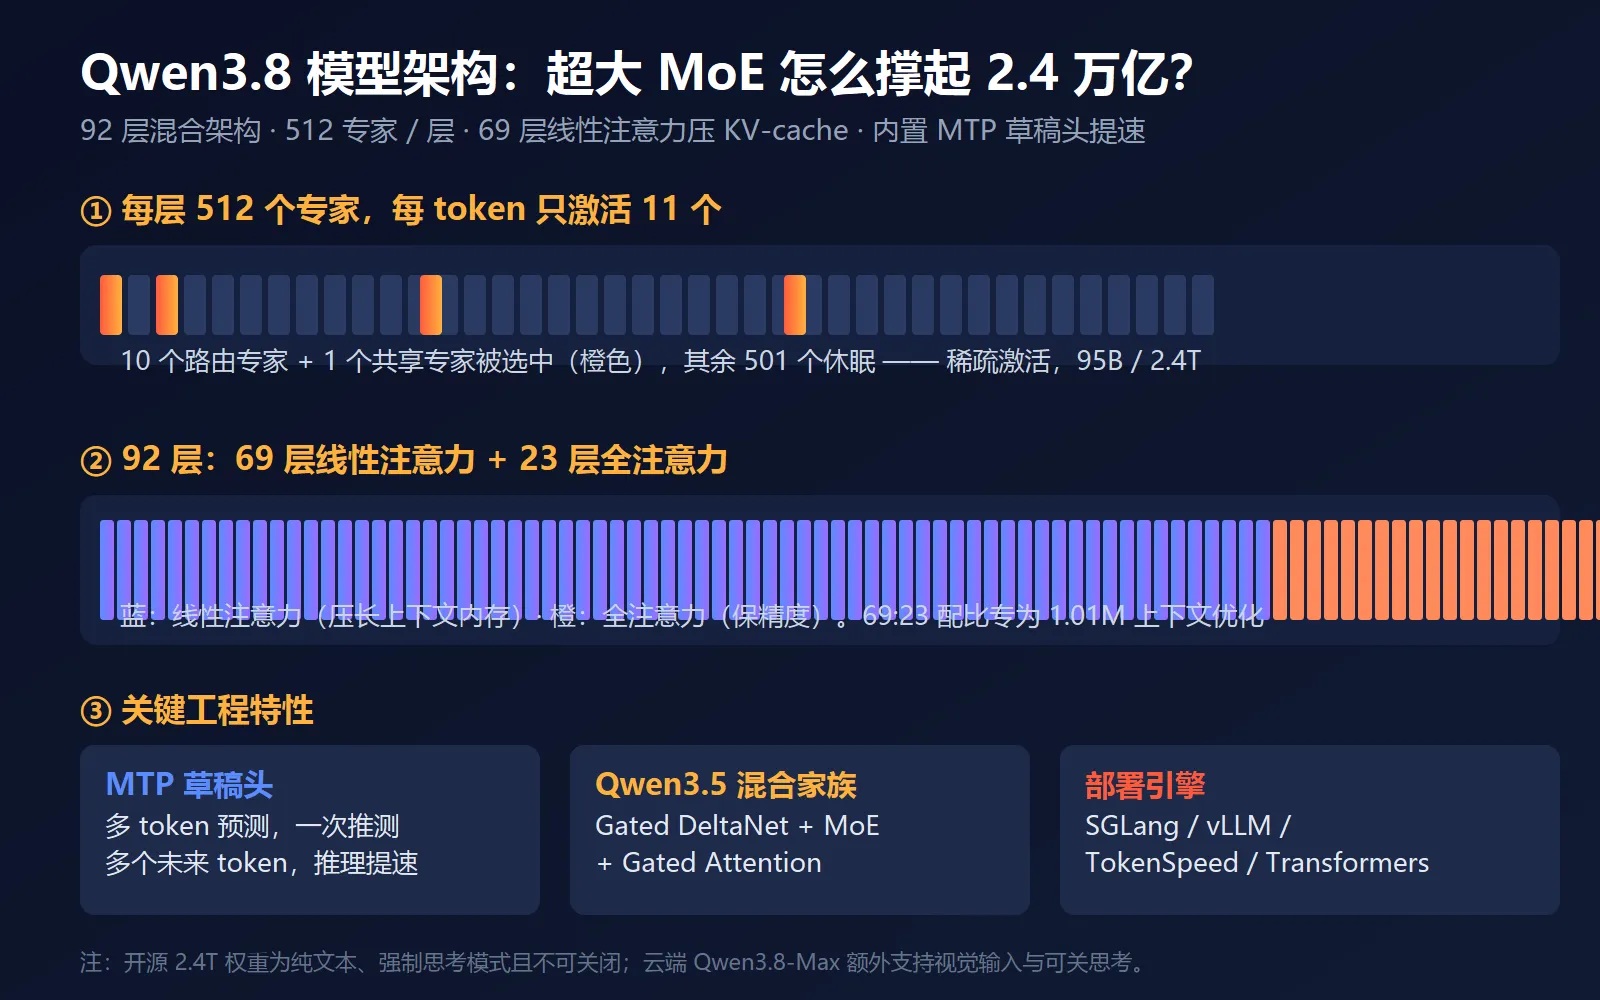
Qwen3.8-2.4T-A95B 的核心配置,先把数字摆清楚:
| 维度 | 数值 |
|---|---|
| 总参数 | 2.4 万亿(2.4T) |
| 每 token 激活 | 950 亿(95B) |
| MoE 专家数 / 层 | 512 个专家 |
| 每 token 选择 | 10 个路由专家 + 1 个共享专家 |
| 层数 | 92 层(69 线性注意力 + 23 全注意力) |
| 原生上下文 | 262,144 token,可扩展至 1,010,000 |
| 架构 | Qwen3.5 混合家族(Gated DeltaNet + MoE + Gated Attention) |
| 推理引擎 | SGLang / vLLM / TokenSpeed / Transformers |
| 多 token 预测 | 内置 MTP draft head,可一次推测多个未来 token |
几个值得注意的点:第一,92 层里有 69 层用线性注意力,主要为了压住超长上下文下的 KV-cache 内存;第二,模型带了一个 MTP(Multi-Token Prediction)草稿头,让推理引擎能一次猜多个后续 token,从而提速;第三,开源权重是纯文本的、且强制思考模式无法关闭——这与云端 Qwen3.8-Max 支持视觉输入、可关思考不同。
和旧方案 / 竞品差在哪?
把 Qwen3.8-2.4T-A95B 放进当前超大 MoE 的牌桌,格局是这样的:
| 模型 | 总参数 | 激活参数 | 上下文 | 开放情况 |
|---|---|---|---|---|
| Qwen3.8-2.4T-A95B | 2.4T | 95B | 1M | 开源(自定义许可) |
| Kimi K3(月之暗面) | 2.8T | 104B | 1M+ | 开源 |
| DeepSeek V4-Pro | 1.6T | ~40B | 1M | 闭源 API |
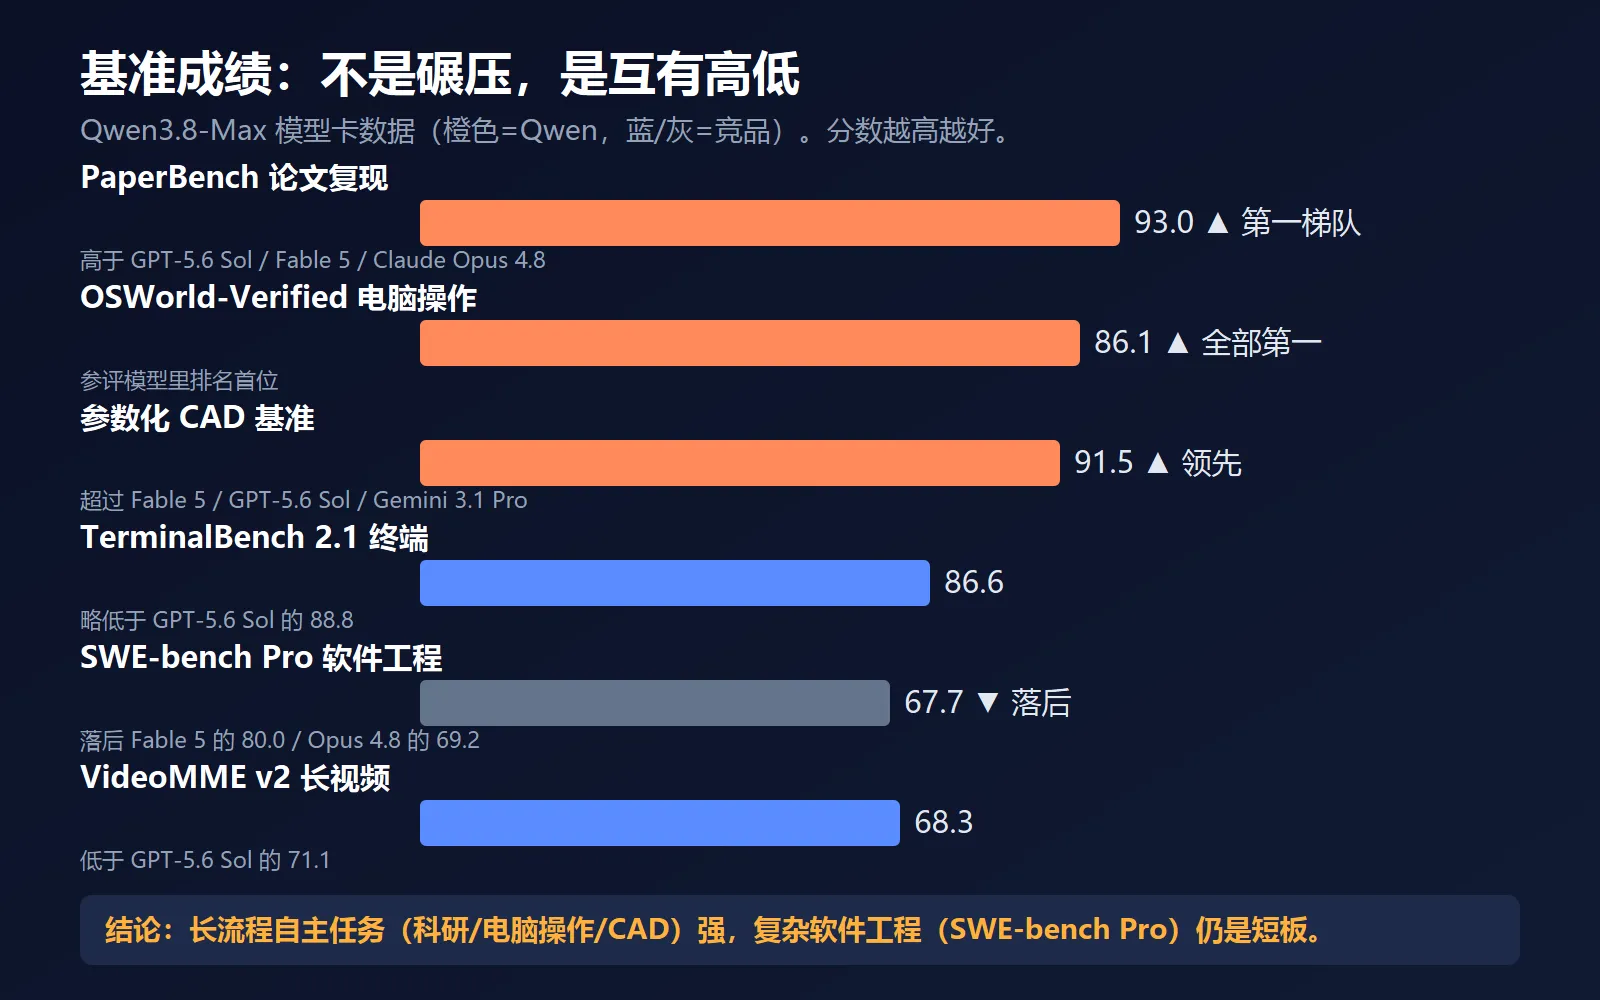
在官方模型卡里,Qwen3.8-Max 的成绩是"互有高低",不是碾压:
- PaperBench(论文复现)93.0:高于 GPT-5.6 Sol、Fable 5、Claude Opus 4.8;
- OSWorld-Verified(电脑操作)86.1:所有参评模型里第一;
- 参数化 CAD 基准 91.5:同样超过 Fable 5、GPT-5.6 Sol、Gemini 3.1 Pro;
- 但 SWE-bench Pro 只有 67.7,落后于 Fable 5 的 80.0 和 Claude Opus 4.8 的 69.2;
- TerminalBench 2.1 86.6,略低于 GPT-5.6 Sol 的 88.8。
结论很诚实:它在科研复现、电脑操作、CAD 这类"长流程自主任务"上强,但在复杂软件工程(SWE-bench Pro)上还差一截。这恰恰说明 2026 年的竞争焦点已经从"刷分"转向了"能不能把一个持续几天的项目自己跑完"。
3 分钟上手:怎么把它跑起来
权重已经在 Hugging Face 和魔搭上线,部署走主流推理框架即可。最小可懂的加载方式:
# 用 transformers 加载 Qwen3.8-2.4T-A95B(需要足够显存/内存)
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "Qwen/Qwen3.8-2.4T-A95B"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype="auto",      # 按硬件选 BF16 / FP8
    device_map="auto",       # 多卡自动切分
)

# 注意:开源权重强制思考模式,输出会自动包在 <think>...</think> 里
messages = [{"role": "user", "content": "用 Python 写一个带超时重试的 HTTP 客户端"}]
inputs = tokenizer.apply_chat_template(messages, return_tensors="pt").to("cuda")
out = model.generate(inputs, max_new_tokens=2048)
print(tokenizer.decode(out[0], skip_special_tokens=False))
工程现实提醒:全精度(BF16)权重约 4.9TB,普通显卡根本放不下。正式部署必须上 SGLang / vLLM 的最新 Qwen3.8 Recipe,按权重精度、GPU 型号和数量选并行策略。
核心点 1:4.9TB 被压到 397GB,一台大内存机器就能本地跑
这才是普通开发者最关心的部分。开源社区 Unsloth AI 用动态 1-bit 分层选择性量化,把 Qwen3.8-2.4T-A95B 从原始 4.9TB 压到了 397GB,存储空间缩减 91%。配合 Unsloth-Desktop,只要设备的内存 + 显存总和超过 410GB,就能在本地把这台 2.4 万亿参数的模型跑起来。
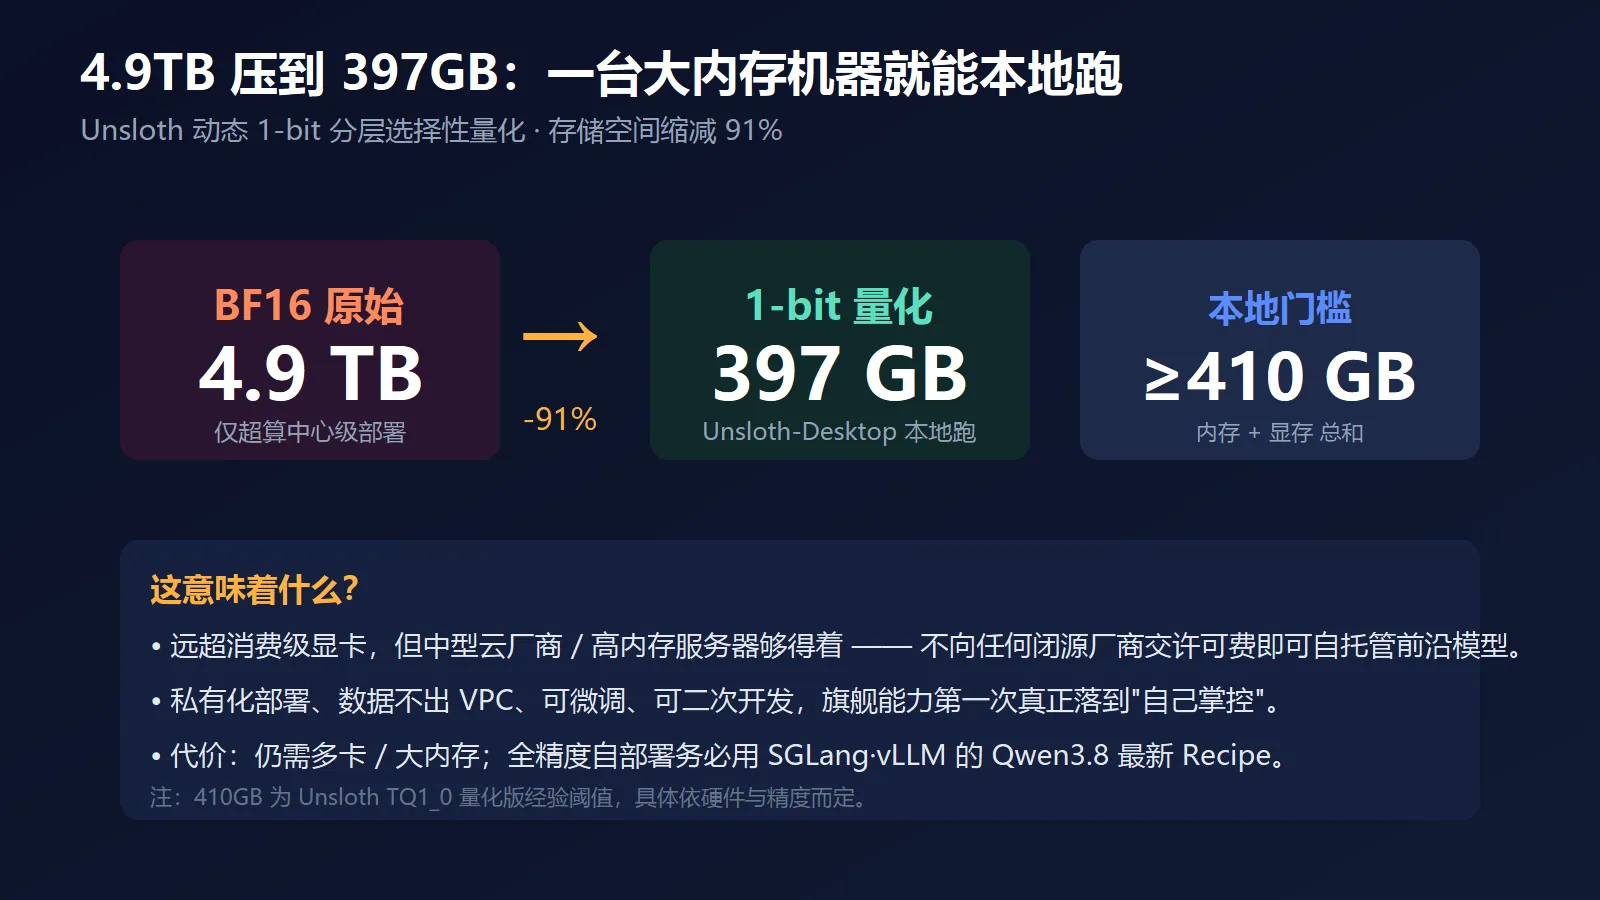
这仍然远超消费级硬件,但已经落到"高内存服务器 / 中型云厂商"够得着的区间——意味着你不用向任何闭源厂商交许可费,就能自托管一个前沿级模型。
核心点 2:阿里用"开放"做生态锁
把旗舰权重开源,不是做慈善。每一份自托管部署,都会通过 Qwen 的工具约定、API 规范和推理 Recipe 把用户锁进自己的生态。换句话说,权重免费,但整套工程习惯是收费的。对阿里来说,这是用开放换空间、以生态赢主动的阳谋。
不过要提醒一句:这次的 Qwen3.8-Max License 不是 Apache 也不是 MIT,是自定义许可。如果你的商业产品月活超过 1 亿、或月收入超过 2000 万美元,必须在界面显著标注模型名;如果你做 MaaS / AI 工作助手且年营收超过 5000 万美元,还要单独谈授权。内部使用、不对外暴露能力的,有豁免。做商用前请务必读许可原文。
核心点 3:开源正在围剿闭源
把镜头拉远,今天这步棋是更大趋势里的一子。仅 8 月以来,Kimi K3、智谱 GLM-5.2、MiniMax H3、Muse Glimmer 相继迭代;同一天窗口内,DeepSeek V4 Pro 正式版上线、xAI Grok 4.6 发布(闭源)。据 Hugging Face 2026 春季报告,中国自研开源模型下载占比已达 41%,首次超过美国;有美国投资机构统计,多达八成美国 AI 初创公司在融资路演里会用中国开源模型。
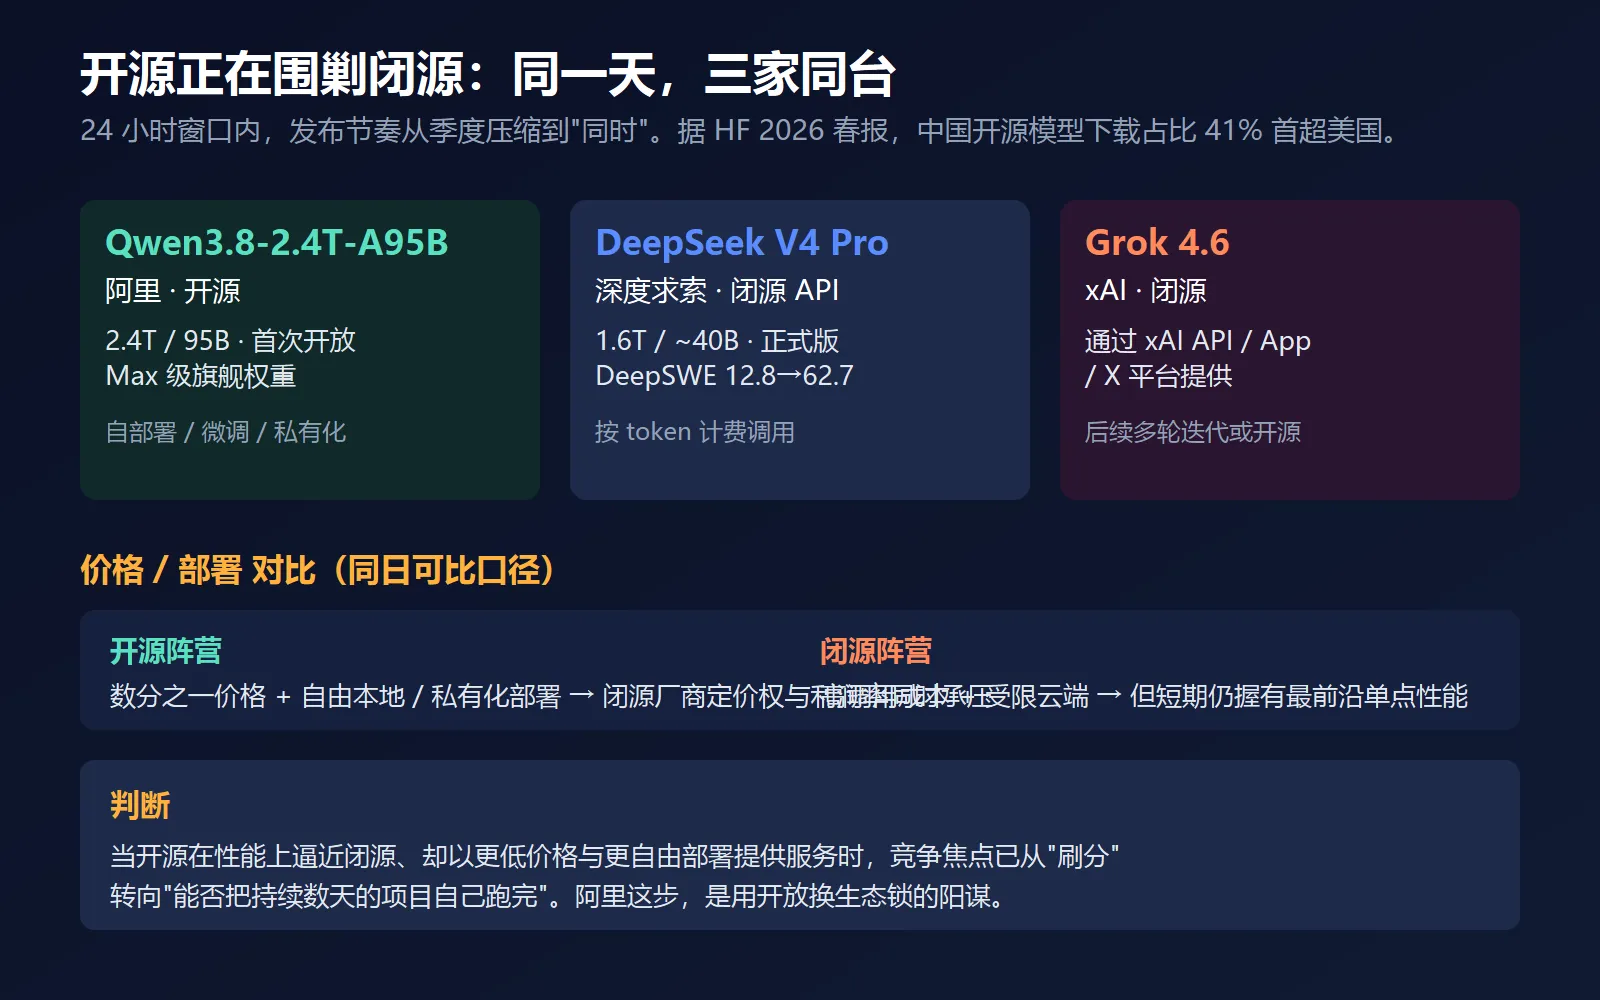
当开源模型在性能上逼近闭源对手,却以数分之一的价格、相对自由的部署方式提供服务时,闭源厂商的定价权与利润率会同时承压。以同日可比为例,DeepSeek-V4-Pro 的输出价格不足 Grok 4.6 的七分之一。
一个真实应用例子:16 天 autonomous coding
阿里没只靠静态榜单,而是跑了"长周期自主任务"来证明 Agent 能力:Qwen3.8-Max 连续自主编程约 16 天,自己搭出一套自进化开发框架,完成需求收集、任务分配、代码生成、测试验证和自修复的全流程;另一个测试里,它在 2000 多轮交互中独立运营一家虚拟电商企业;还能独立复现并改进一篇研究论文。
这类"能不能把一个持续几周的项目自己跑完、中间不用人扶"的叙事,正是 2026 年企业买家最看重的差异化卖点。
生产实践经验 / 坑点
- 强制思考,关不掉:开源 2.4T 版本不支持关闭思考模式,所有输出都会带
<think>标签,做低延迟场景要提前设计解析。 - 硬件门槛仍高:全精度 4.9TB,BF16 自部署至少多卡;要本地单机跑,先确认内存+显存 ≥ 410GB。
- 许可要读:商业规模化前核对 Qwen3.8-Max License 的 MAU / 营收门槛,别默认当 MIT 用。
- SWE 短板:复杂软件工程(SWE-bench Pro)仍落后 Fable 5,重度 coding agent 场景建议实测后再决定主力模型。
最适合什么场景?
- ✅ 科研复现、长文档理解、超长上下文 Agent 工作流;
- ✅ 电脑操作 / 办公自动化(OSWorld 第一);
- ✅ 需要私有化部署、数据不出 VPC 的企业;
- ⚠️ 重度软件工程流水线,建议与 Claude / Fable 类模型实测对比后再定。
本文重点回顾
- 阿里第一次开源 Max 级旗舰权重 Qwen3.8-2.4T-A95B:2.4T 总参、95B 激活、1.01M 上下文。
- 架构看点是 69 层线性注意力 + MTP 草稿头,为超长上下文和推理提速设计。
- 成绩互有高低:PaperBench / OSWorld / CAD 领先,SWE-bench Pro 落后。
- Unsloth 把 4.9TB 压到 397GB,410GB 内存+显存即可本地跑。
- 自定义许可有商用门槛;开源围剿闭源的趋势正在加速。
延伸阅读
- Hugging Face 权重:https://huggingface.co/Qwen/Qwen3.8-2.4T-A95B
- 魔搭社区:https://modelscope.cn/models/Qwen/Qwen3.8-2.4T-A95B
- 基准细节与许可原文以官方模型卡为准。
三备选标题与心理触发点:
- 阿里第一次把 Max 旗舰开源:2.4 万亿参数的 Qwen3.8 来了 —— 触发「稀缺性 + 反常识」(原来旗舰也开源)
- 2.4 万亿参数压到 397GB:一台 410GB 显存的机器就能本地跑 Qwen3.8 —— 触发「实用价值 + 数字冲击」(普通开发者也能跑旗舰)
- 开源正在围剿闭源:同一天 Qwen 开源、DeepSeek V4 Pro 上线、Grok 4.6 闭源 —— 触发「情绪共鸣 + 行业格局」(你站哪边)