一张显卡装下超级智能:Meta 开源 30B 模型 Muse Glimmer
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../muse-glimmer-recommend.pptx../../muse-glimmer-recommend.mp4本文目录
title: 一张显卡装下超级智能:Meta 开源 30B 模型 Muse Glimmer author: yesai description: Meta 把 30B Agent 模型塞进一张 RTX 3090,Llama 4 之后首次开放权重
一张显卡装下超级智能:Meta 开源 30B 模型 Muse Glimmer
当别人还在比谁的模型参数更多、谁的云更贵,Meta 悄悄把「超级智能」塞进了你打游戏的那张显卡。
8 月 11 日,Meta 超级智能实验室(MSL)开源了 Muse Glimmer——一个 30B(300 亿参数)的稠密多模态模型,2.8B 文本解码器 + 1.8B 视觉编码器,从自家旗舰闭源模型 Muse Spark 蒸馏而来,用 Apache 2.0 协议彻底放开权重。最狠的一点是:它用 4-bit 量化压到 20GB 以内,一张 RTX 3090 / 4090 就能跑起来,还能调用工具、跑 Agent、看截图、读文档。
这是 Llama 4 之后,Meta 第一次把模型权重交还给公众。扎克伯格在发布同天的长文里写了句话,几乎就是这次发布的注脚:「与其把超级智能集中起来,不如把它广泛分发,让每个人都能驾驭它。」
一句话结论:开源大模型的下半场,不再卷「在云上多大」,而是卷「在你桌面上多能打」。
一、它到底是个什么模型?
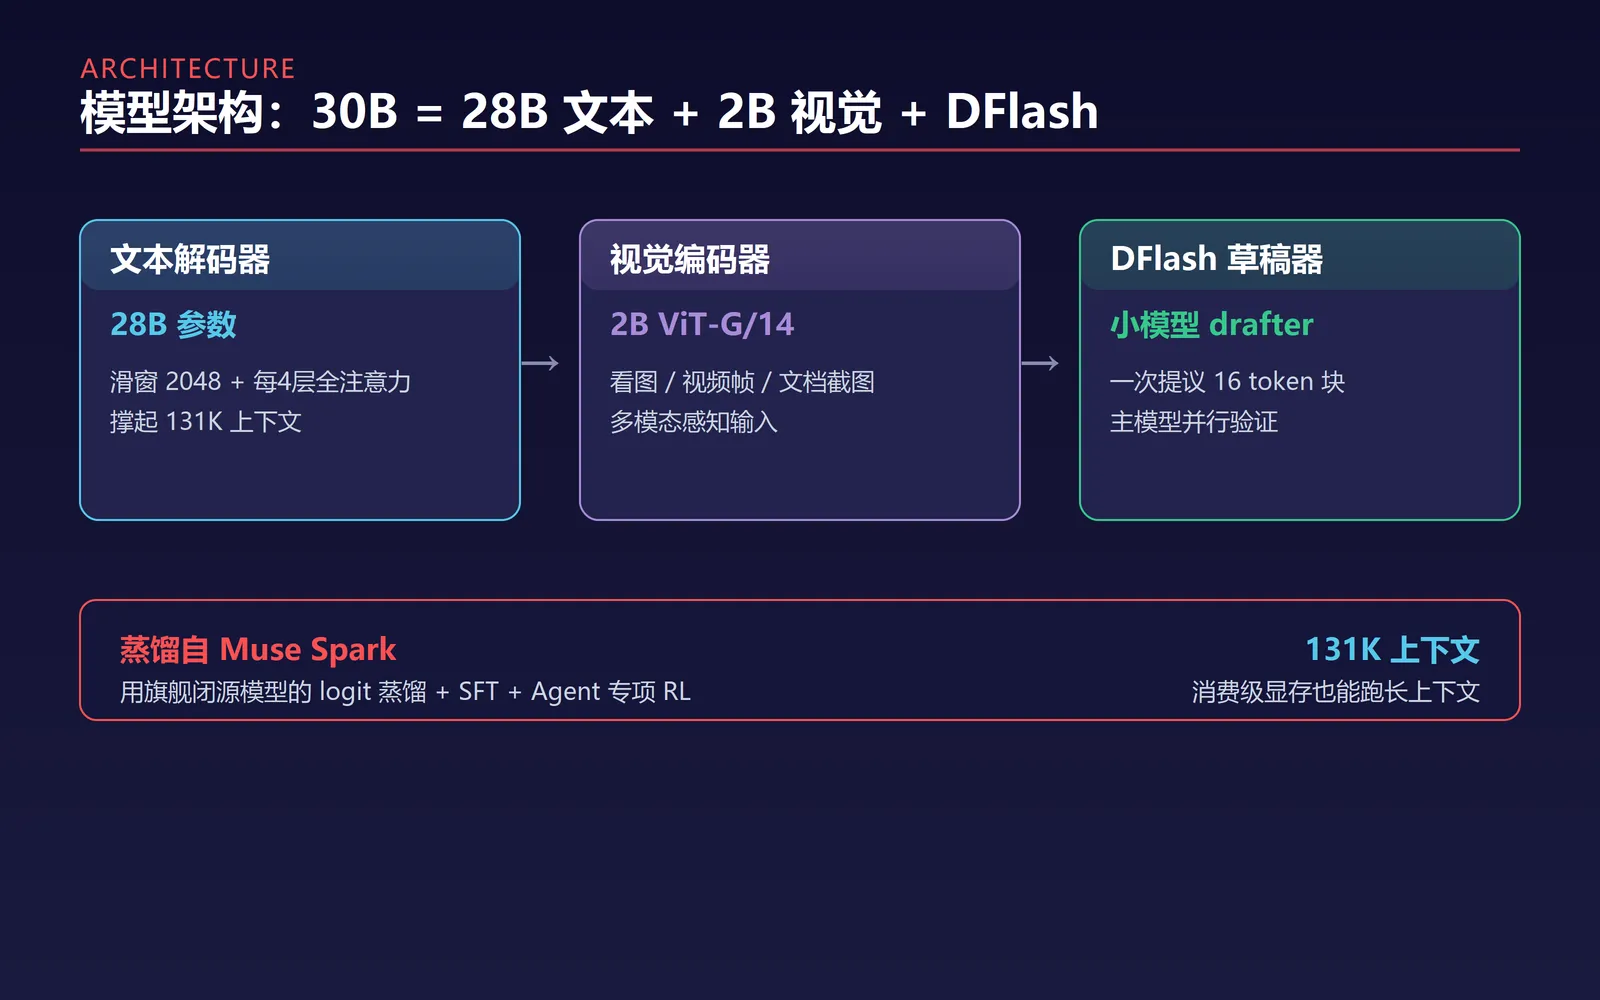
Muse Glimmer 不是又一个聊天玩具。Meta 给它定的位置非常明确:为「常驻本地」的 Agent 而生。
- 参数:30B 稠密模型,28B 文本解码器 + 约 2B 的 ViT-G/14 视觉感知编码器(能看图、看视频帧、读文档截图)。
- 出身:用 Muse Spark(Meta 闭源旗舰)的 logit 做蒸馏,再叠加 SFT、Agent 专项推理冲刺和 on-policy 强化学习。
- 协议:Apache 2.0——可下载、可改、可商用、无使用限制。这是真开源,不是「开源但不可商用」的噱头。
- 语言:原生支持 100+ 语言。
- 定位:隐私敏感场景(写代码、文档分析、个人助理、OpenClaw / Hermes 类本地智能体)。
对比一下同段位的开源选手:Google Gemma 4-31B、阿里 Qwen3.6-27B。Glimmer 不追求「全面碾压」,它把砝码压在了 Agent / 工具调用 / 多步推理 这一侧。
二、三招把 55GB 塞进一张消费级显卡
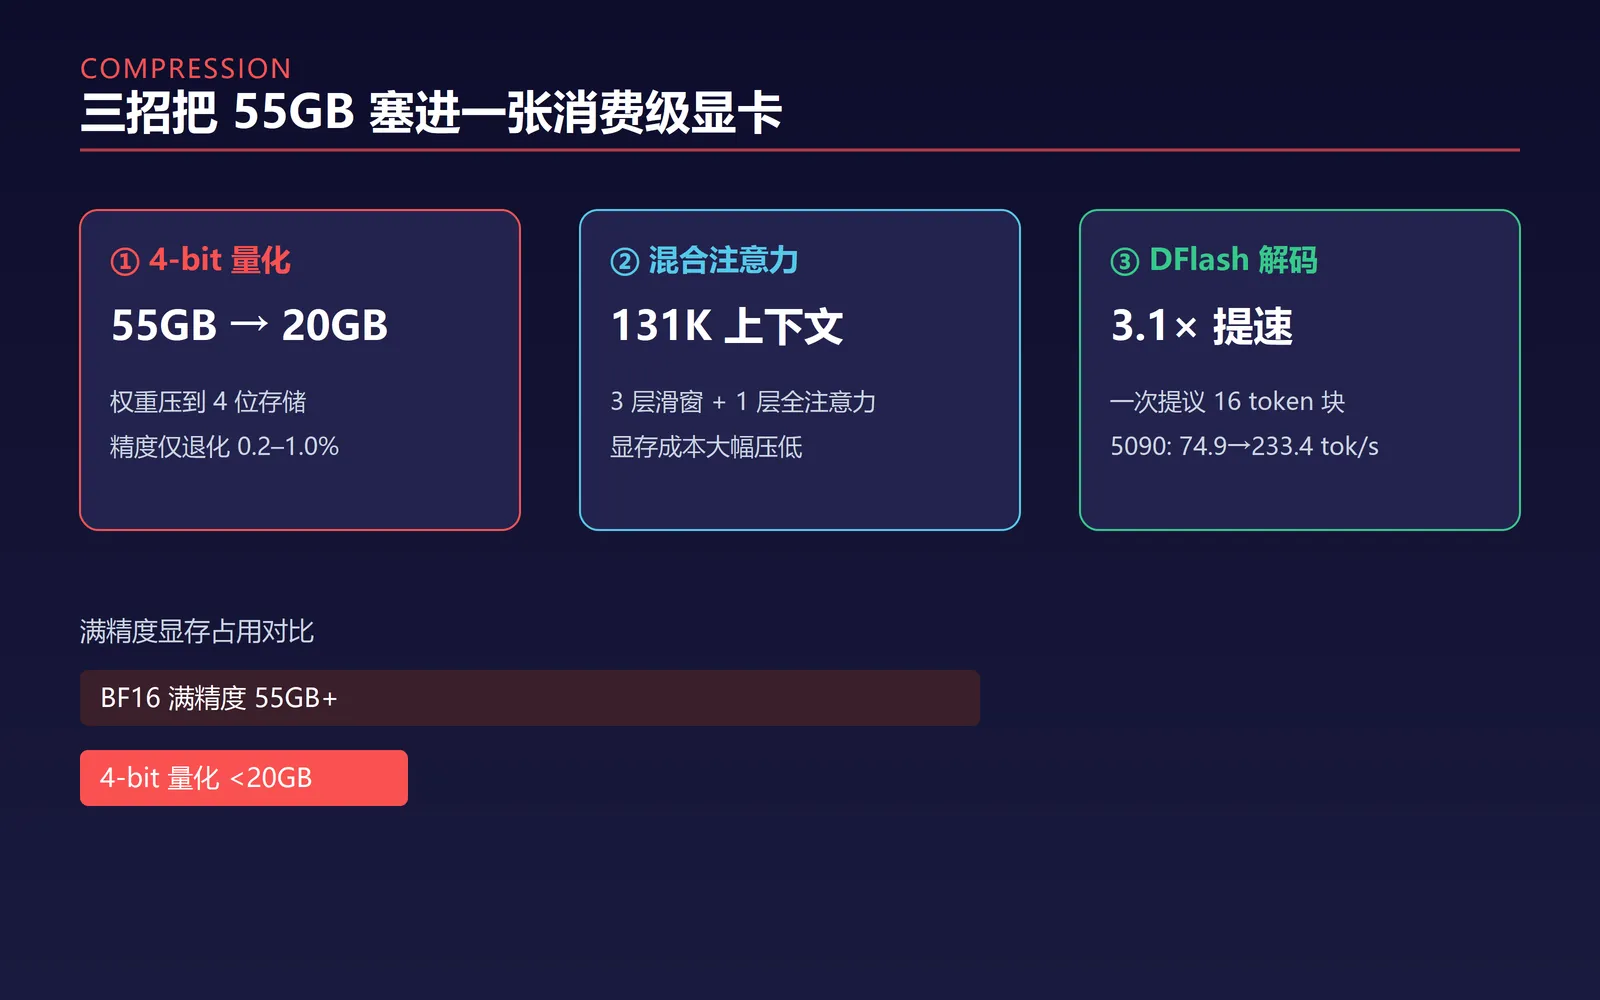
满精度(BF16)的 30B 模型要吃掉 55GB+ 显存,任何游戏显卡都扛不住。Meta 用了三招把它搬进你家主机:
第一招:4-bit 量化 把模型权重从 16 位压到约 4 位,语言模型本体压到 20GB 以下,给 KV cache、视觉编码器和协作的小模型留出余量。代价极小:官方在 15 项基准上测,32GB 版量化平均只退化 0.2%,24GB 版退化 1.0%——基本「压完没变笨」。
第二招:混合注意力,把上下文拉长还不爆显存 文本解码器交替使用「3 层 2048 token 滑窗注意力(旋转位置编码)+ 1 层全注意力(无位置编码)」,四层一组重复 13 次共 52 层。也就是说,每 4 层才做一次全量注意力,从而把 131K 上下文窗口 的显存成本压到消费级硬件能承受的范围。
第三招:DFlash 投机解码,专治本地 Agent 的延迟 本地 Agent 一次请求可能触发几十次模型回合、工具调用和自检,逐 token 生成的延迟会被放大到不可用。DFlash 让一个更小的「drafter」模型一次提议 16 个 token 块,主模型并行验证接受。结果:RTX 5090 上生成速度从 74.9 tok/s 提到 233.4 tok/s(3.1×);苹果 M5 Max 1.8×、M4 Max 1.5×。速度不是聊天才重要,Agent 才最吃延迟。
三、跑分:工具调用吊打同段位,编码互有胜负
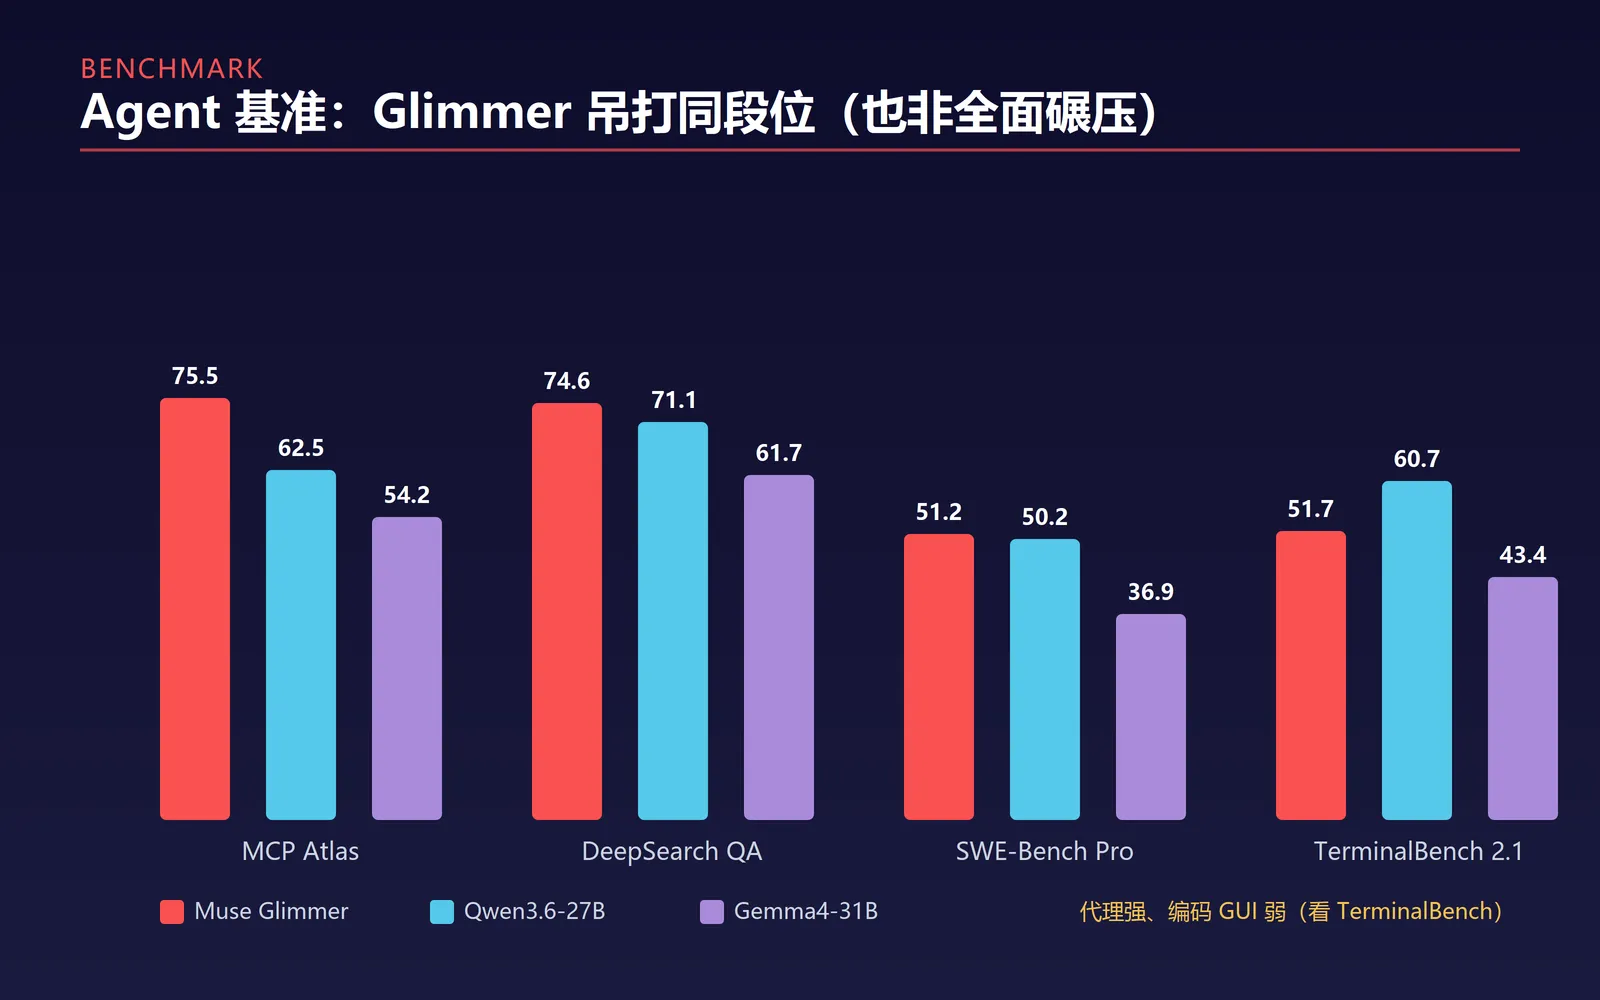
官方对照表里,Glimmer 在 Agentic 类 基准上一骑绝尘:
| 基准(考什么) | Muse Glimmer | Qwen3.6-27B | Gemma4-31B |
|---|---|---|---|
| MCP Atlas(调外部工具完成代理任务) | 75.5 | 62.5 | 54.2 |
| DeepSearch QA(多步检索问答) | 74.6 | 71.1 | 61.7 |
| SWE-Bench Pro(修真实开源项目 bug) | 51.2 | 50.2 | 36.9 |
| τ³-Banking(金融 Agent 任务) | 23.5 | 16.7 | 15.1 |
| AIME 2026(数学竞赛) | 94.7 | 94.1 | 89.2 |
但别被官方挑的项目带偏——它不是全面领先。在纯编码 / 操作系统操作上,Qwen 反超:
- TerminalBench 2.1:Glimmer 51.7 vs Qwen 60.7
- SWE-Bench Verified:Glimmer 76.0 vs Qwen 77.2
- OSWorld-Verified(电脑操作):Glimmer 65.9 vs Qwen 75.6
所以更准确的说法是:Glimmer 强在「工具调用 + 多步代理 + 失败自愈」,编码和 GUI 操作与 Qwen 互有胜负。尤其 MCP Atlas(75.5)这个分数要打个问号——这是和 Model Context Protocol 生态强相关的 Agent 基准,模型叫「Muse」难免让人怀疑训练数据有重叠,需等第三方独立评测。
四、本地部署阶梯:从游戏显卡到 Mac
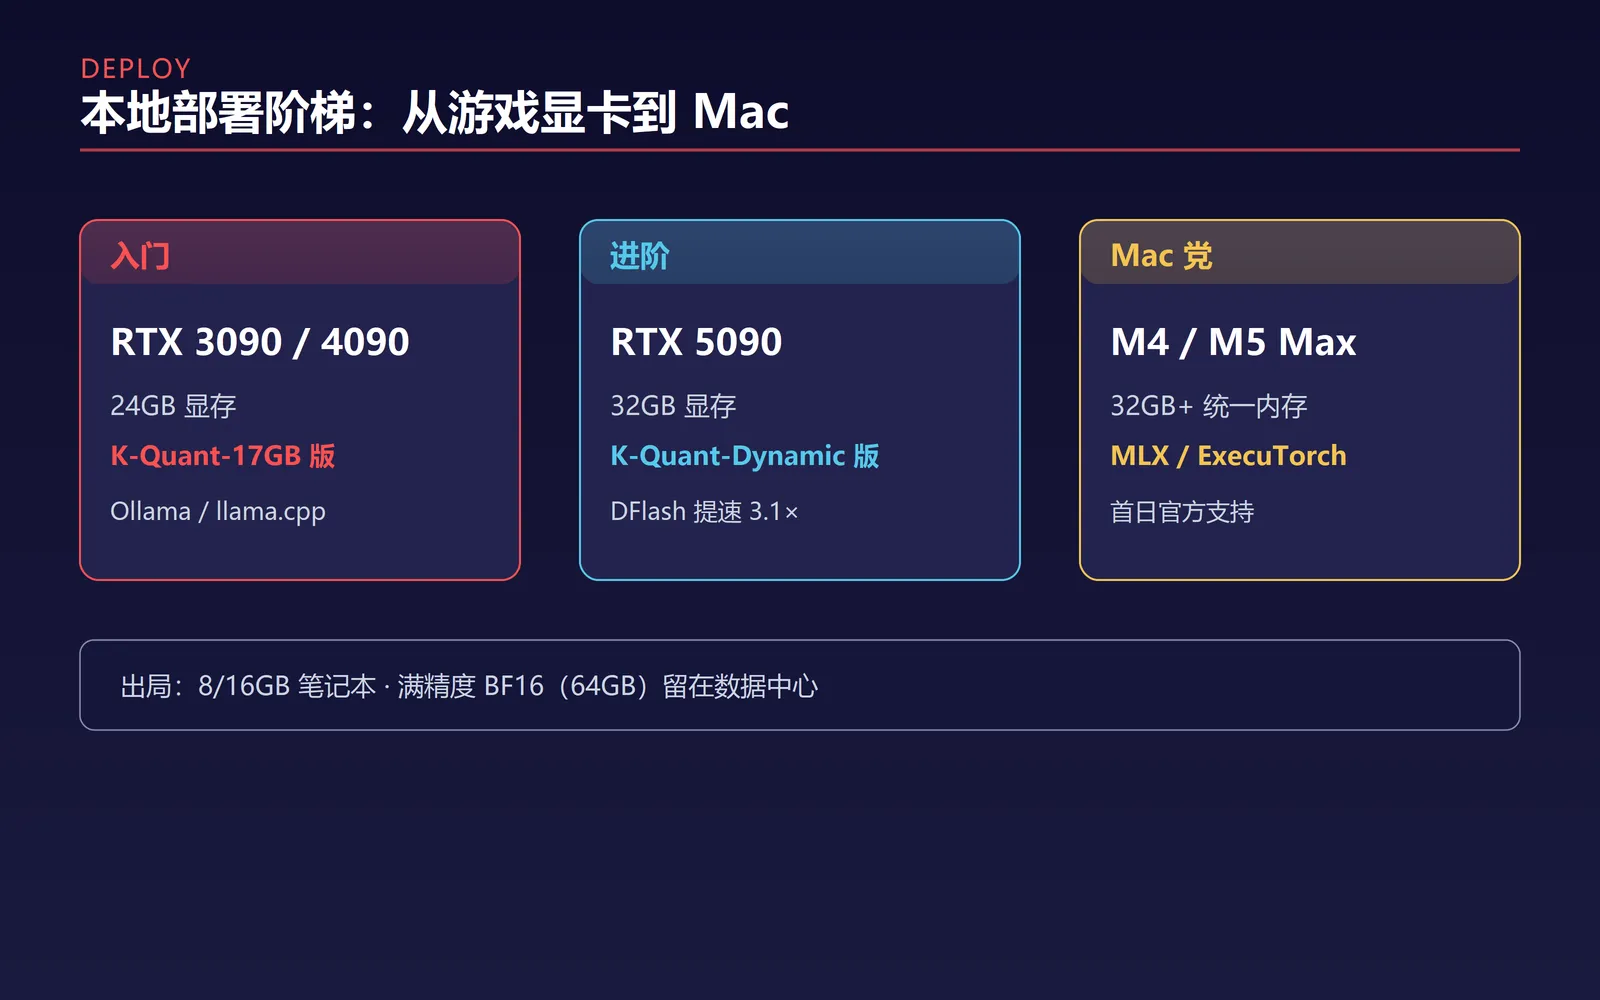
Glimmer 的硬件门槛是「 enthusiast 级」而非「人人都有」:
- 入门:NVIDIA RTX 3090 / 4090(24GB 显存)→ 跑 K-Quant-17GB 版
- 进阶:RTX 5090(32GB)→ 跑 K-Quant-Dynamic 版,DFlash 加速最猛
- Mac 党:M4 Max / M5 Max(32GB+ 统一内存)→ 用 MLX / ExecuTorch 跑
- 出局:8GB / 16GB 笔记本、满精度 BF16(64GB)留在数据中心
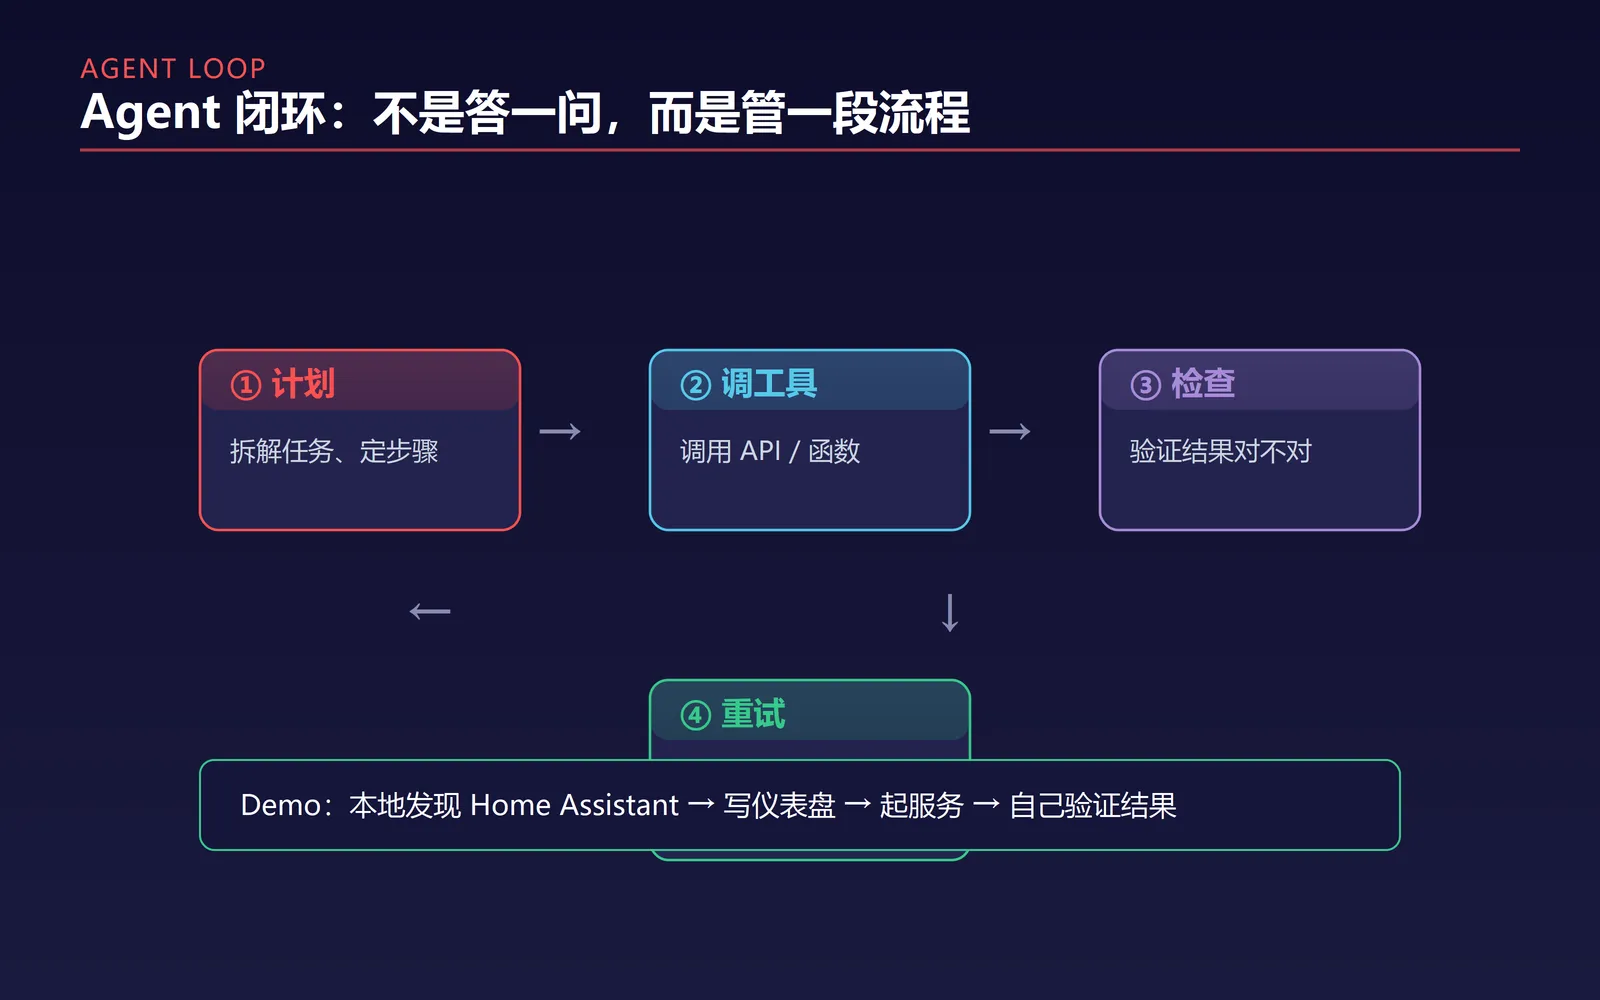
首日就支持 llama.cpp、MLX、Ollama、LM Studio、vLLM、SGLang;AMD、Intel、Arm、Dell、NVIDIA 都在做优化部署。Meta 自己还演示了一个本地 Home Assistant 工作流:Glimmer 通过工具调用自动发现局域网里的 HA 实例、查设备 API、从零写出响应式仪表盘并起本地服务自己验证结果——这比任何 QA 基准都更接近企业 Agent 的真实样子。
五、为什么这件事值得普通读者关心?
三个理由,每一个都和「你」有关:
- 隐私:模型在你自己机器上跑,数据不出本机,不连云、不订阅。对政府、医疗、金融这类有数据主权要求的场景,这是刚需。
- 成本:一次性下载,后续零 API 账单。云 Agent 按 token 持续收费,本地 Agent 只吃电费。
- 愿景:扎克伯格把这次发布写成了一篇「个人超级智能」宣言——超级智能不该锁在几家大厂的机房里,而该装进每个人的设备。Glimmer 就是这份愿景的第一块可下载的砖。
当然也要泼盆冷水:Apache 2.0 意味着没有内置安全护栏,Meta 文档明确建议部署方自己加系统级防护;编码任务并非全面碾压;24GB 显存也不是随便一台电脑就有。它是「 enthusiast 的本地超级智能」,不是「全民的」。
六、谁该现在就跑?
- 你是 OpenClaw / 本地 Agent 玩家,想给常驻智能体换一个更强、能看图、会调工具的本地大脑 → 直接上。
- 你是 开发者,做隐私敏感的内部工具、文档分析、本地 coding 助手 → Glimmer 比同段位闭源 API 更省也更稳。
- 你只有 8/16GB 笔记本 → 先等更小蒸馏版,或继续用云端。
怎么跑?Hugging Face 搜 Muse Glimmer,挑 K-Quant-17GB(24GB 卡)或 Dynamic(32GB 卡),Ollama / llama.cpp 一行命令拉起。Meta 还说几周内会开放 Muse Spark 1.2 权重,更大的 Muse Spark 2.1 也在路上。
金句收尾:真正改变世界的,往往不是最大的模型,而是第一个让你在自己桌上就跑得起的模型。
你怎么看 Meta 这步「把超级智能塞进显卡」的棋?欢迎在评论区聊聊——你手上是哪张卡,敢不敢接住这 30B?
信源:Meta Hugging Face 官方博客、VentureBeat、Marktechpost、Neowin、InfoQ 等 2026-08-11 至 08-12 报道;跑分以 Meta 官方对照表为准,部分项目建议等待第三方独立评测。