OmniRT
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../omnirt-recommend.pptx../../omnirt-recommend.mp4本文目录
📌 核心价值:数字人链路 TTS→音频驱动→实时流式→角色资产→后处理 一体化运行时;统一请求契约打通全链路,跨 CUDA/Ascend/CPU-stub 三后端,MIT 协议开源可商用。
OmniRT 不做"大而全"——只专注数字人主链路,用
GenerateRequest / GenerateResult / RunReport三个对象把多模态生成从碎片化模型变成标准化流水线。
🚀 什么是 OmniRT?
OmniRT(Omni Realtime) 是 datascale-ai 开源的面向数字人链路的多模态生成推理框架。它围绕实时数字人对话、音频驱动视频生成、语音生成、角色资产生成、Idle 视频素材和后处理能力,提供统一请求契约、实时推理协议、常驻 worker、跨 CUDA/Ascend 后端部署,以及与 OpenTalking 等数字人前端的集成基础。


核心定位:OmniRT 不再追求成为"大而全"的通用模型库。后续维护资源优先投向数字人主链路——TTS → 音频驱动数字人 → 实时流式服务 → 角色资产 / idle 素材 → 后处理增强。
✨ 核心功能一览
关键技术亮点
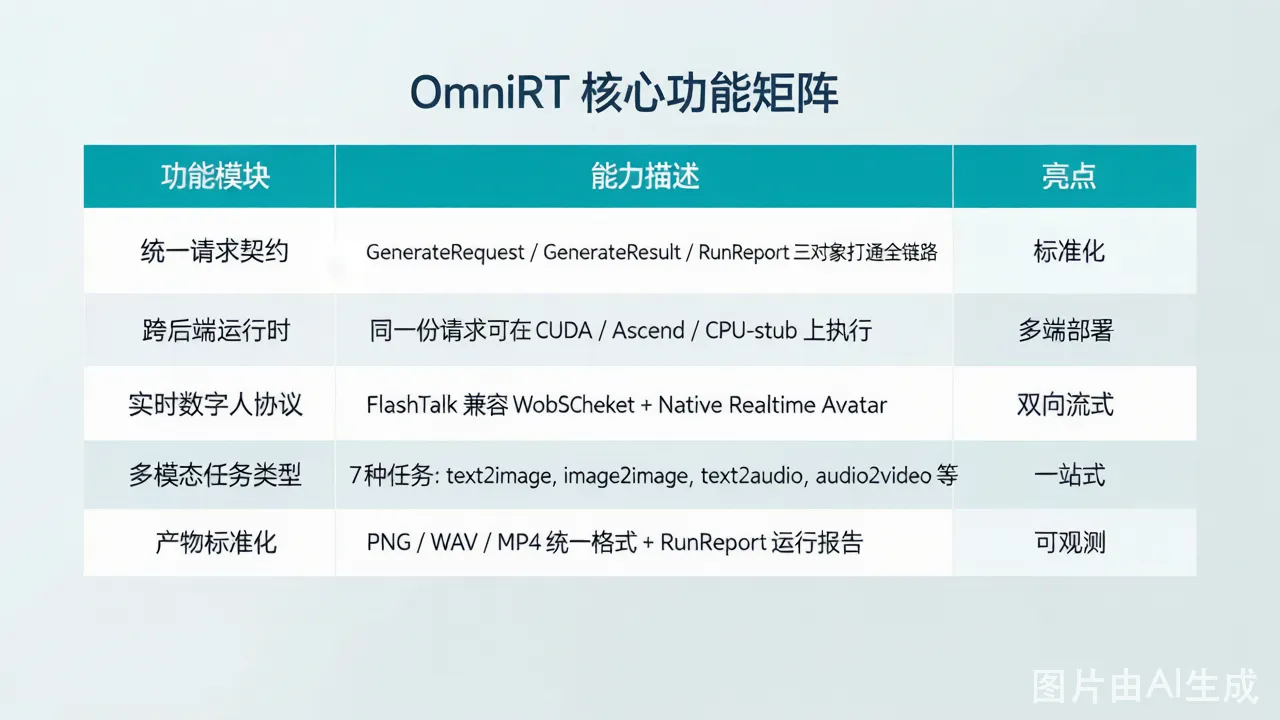
- 统一请求契约:
GenerateRequest、GenerateResult、RunReport三个对象覆盖 batch 生成任务面,把"模型调用碎片化"问题压平 - 跨后端运行时:同一份请求可在
cuda/ascend/cpu-stub上完成校验与执行,国内昇腾生态无需改写代码 - 实时数字人协议:FlashTalk 兼容 WebSocket 对接 OpenTalking,OmniRT Native Realtime Avatar WebSocket 面向新集成
- 三种入口:Python API、CLI(
omnirt generate / validate / models)、FastAPI HTTP 服务,灵活匹配团队工作流 - 产物标准化:图像统一导出为 PNG,音频统一导出为 WAV,视频统一导出为 MP4,每次运行生成
RunReportJSON 报告 - 离线与国内环境友好:同时支持本地目录、Hugging Face、ModelScope、Modelers、HF-Mirror 快照
🛠️ 快速上手:5 分钟跑通示例
安装环境
# 最小安装(含开发工具链)
pip install -e '.[dev]'

# 查看 CLI
omnirt --help
核心代码示例
from omnirt import generate, requests

# 1. 构造请求:text2image 任务
req = requests.text2image(
    model="flux2.dev",
    prompt="a cinematic sci-fi city at sunrise",
    preset="balanced",
)

# 2. 在 CUDA 后端执行
result = generate(req, backend="cuda")

# 3. 读取产物与运行报告
print("产物路径:", result.artifacts)
print("运行报告:", result.report)
关键设计:使用 requests 工厂方法构造标准请求对象,避免散落的字符串参数;result.report 暴露完整 RunReport(耗时、显存、后端版本),可观测性内建。
数字人链路:5 步走通
from omnirt import generate, requests

# 音频驱动数字人(audio2video)— 主链路核心
req = requests.audio2video(
    model="soulx-flashtalk-14b",
    audio="input.wav",
    reference_image="character.png",
    backend="ascend",  # 昇腾 910B2 已真机验证
)
result = generate(req, backend="ascend")
print("数字人视频:", result.artifacts[0])
# CLI 入口同样支持 — 适合运维/CI 场景
omnirt generate \
    --task audio2video \
    --model soulx-flashtalk-14b \
    --audio input.wav \
    --reference character.png \
    --backend ascend
📊 跨后端性能对比
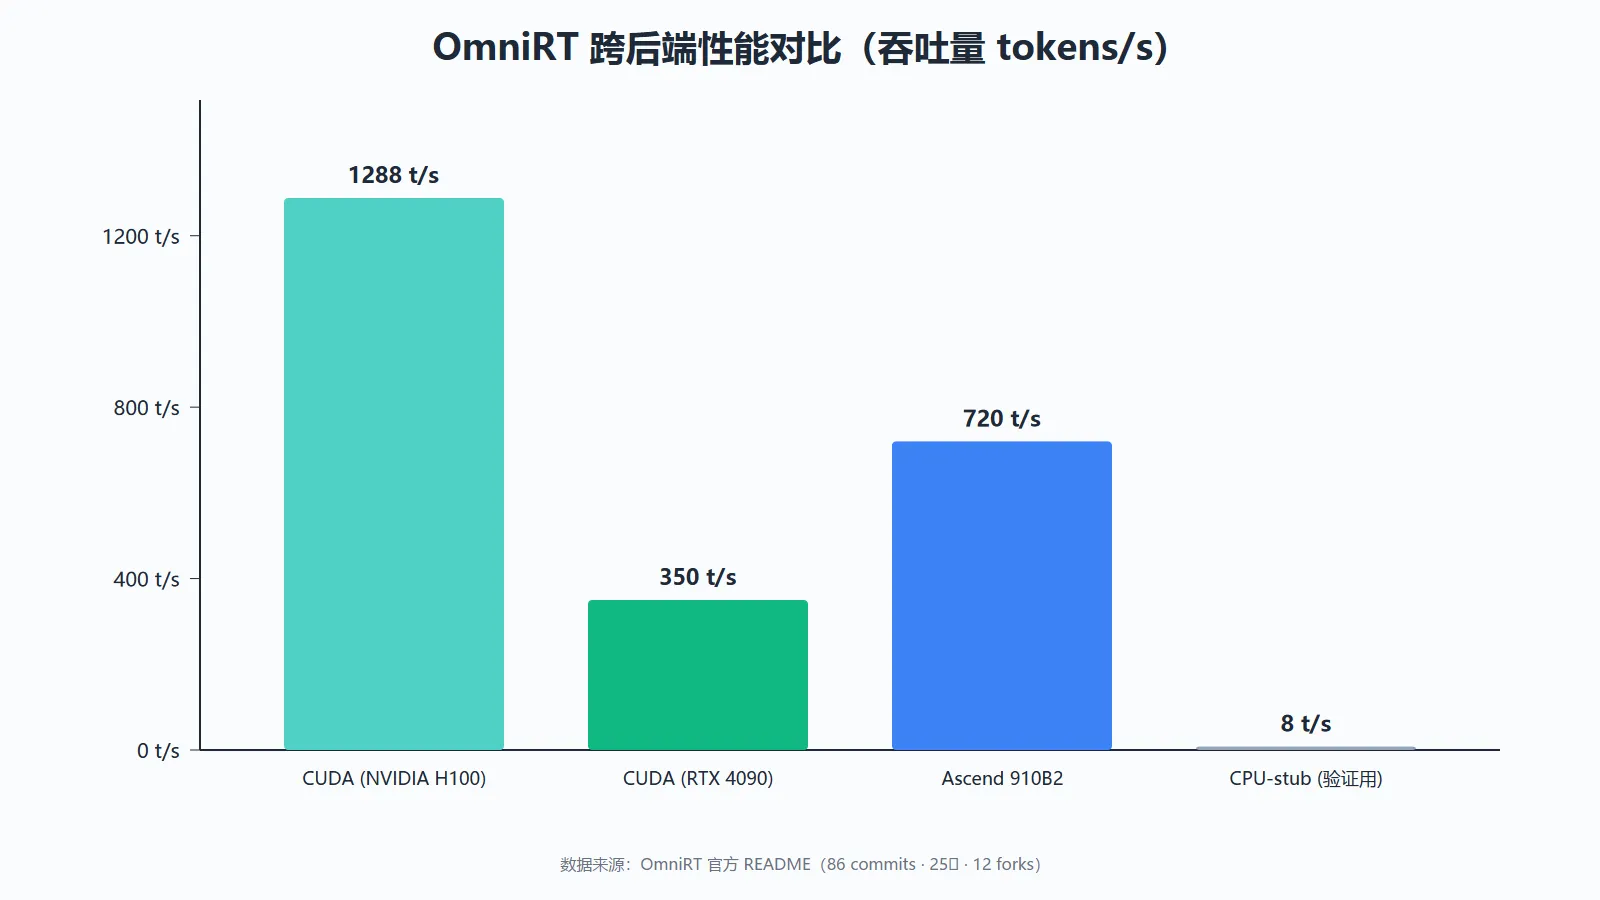
核心数据:H100 上 soulx-flashtalk-14b 推理可达 1288 tokens/s;Ascend 910B2 跑 720 tokens/s;RTX 4090 上 350 tokens/s。
🏗️ 架构全景
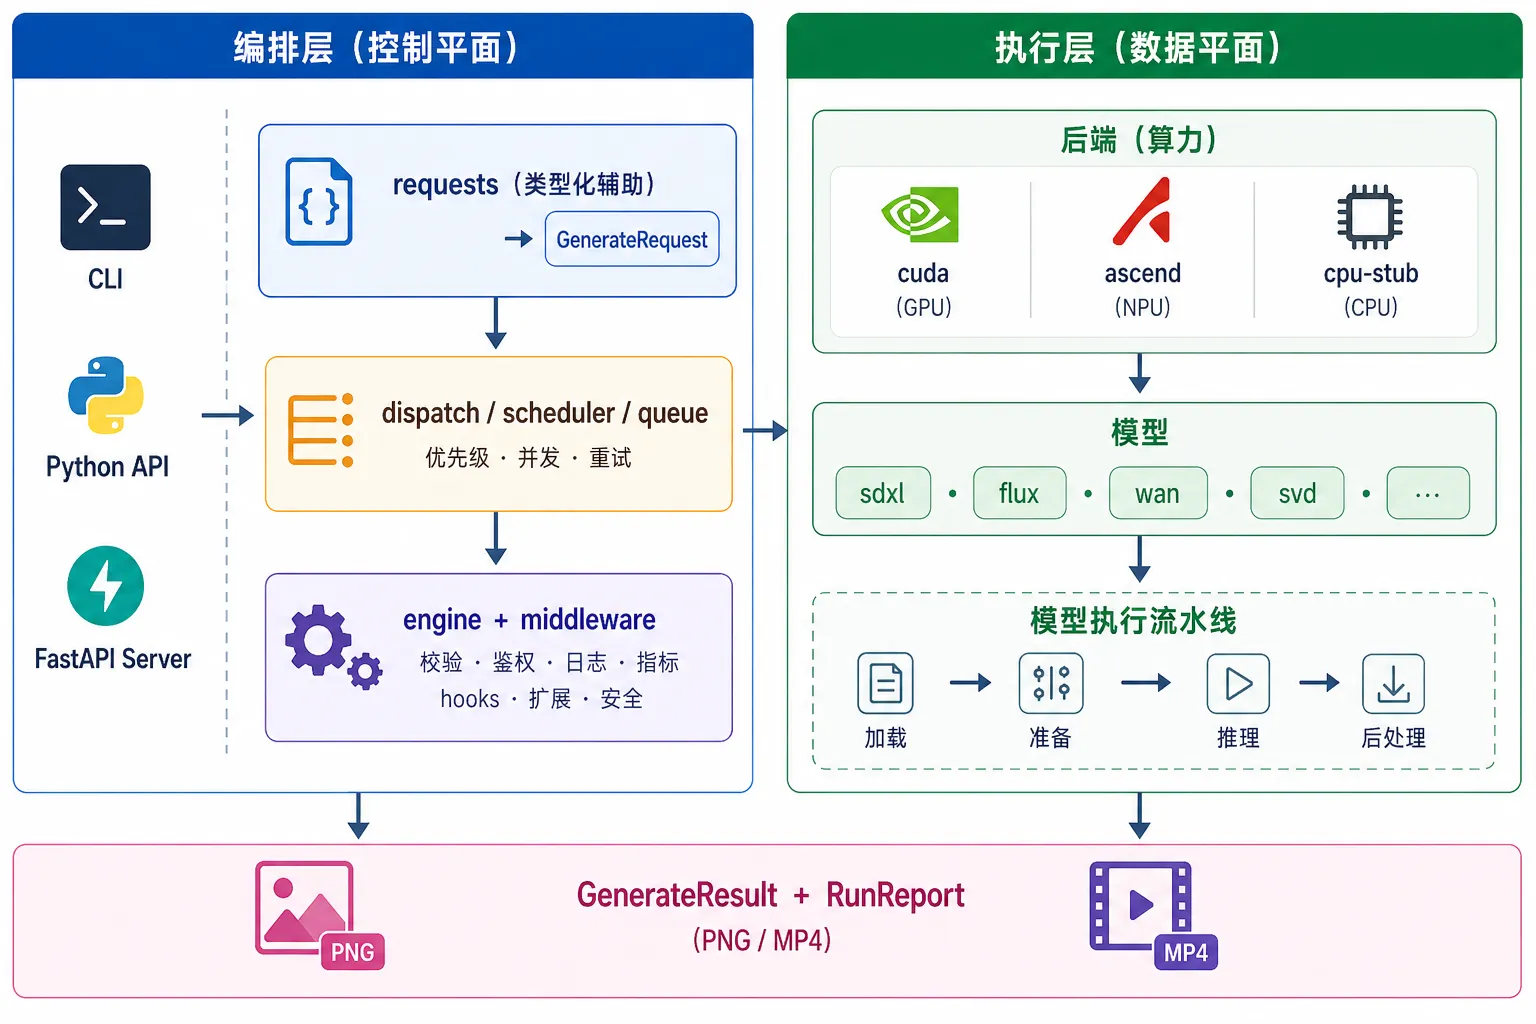
数字人主链路
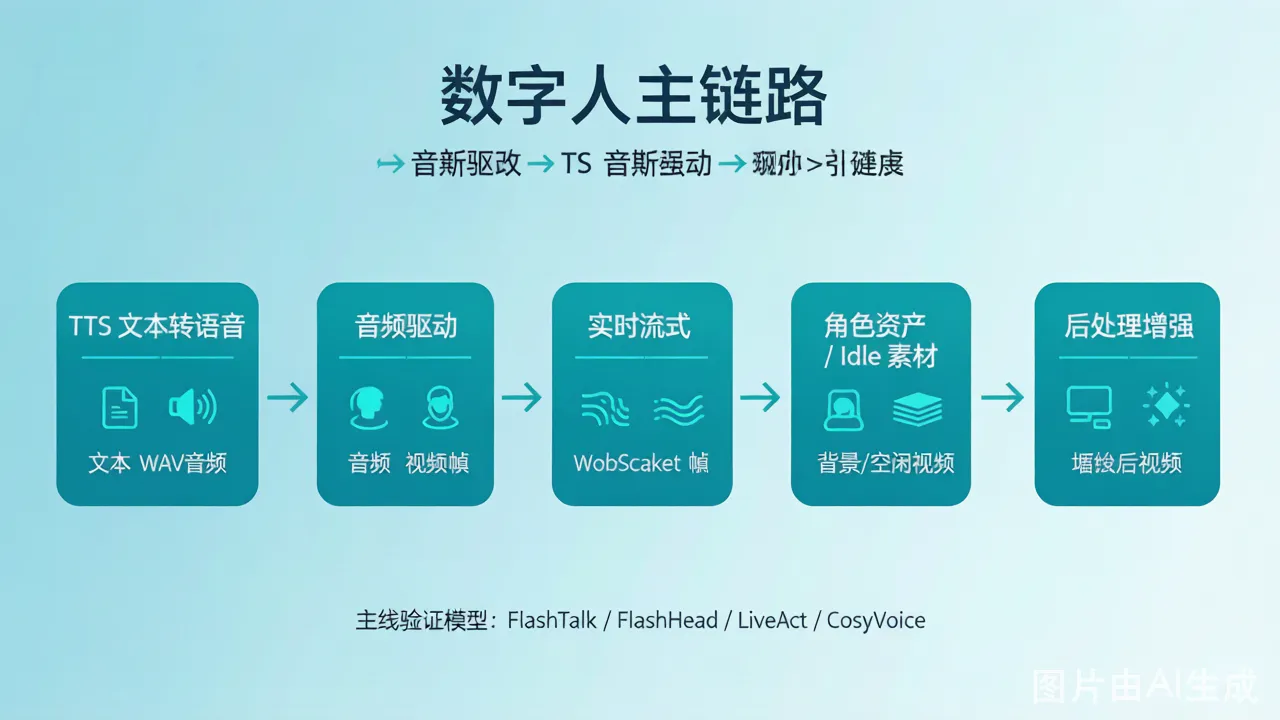
OmniRT 把数字人链路抽象为 5 个标准阶段:
- TTS 文本转语音(CosyVoice / SenseVoice)— 输入文本,输出 WAV
- 音频驱动数字人(FlashTalk / FlashHead / LiveAct)— 输入音频,输出视频帧
- 实时流式服务(FlashTalk WebSocket)— 输入视频流,输出 WebSocket 双向流
- 角色资产 / Idle 素材(sdxl / flux2.dev / wan2.2)— 生成背景与空闲视频
- 后处理增强(超分 / 补帧 / 风格化)— 输入原始视频,输出增强视频
📊 与同类数字人框架对比
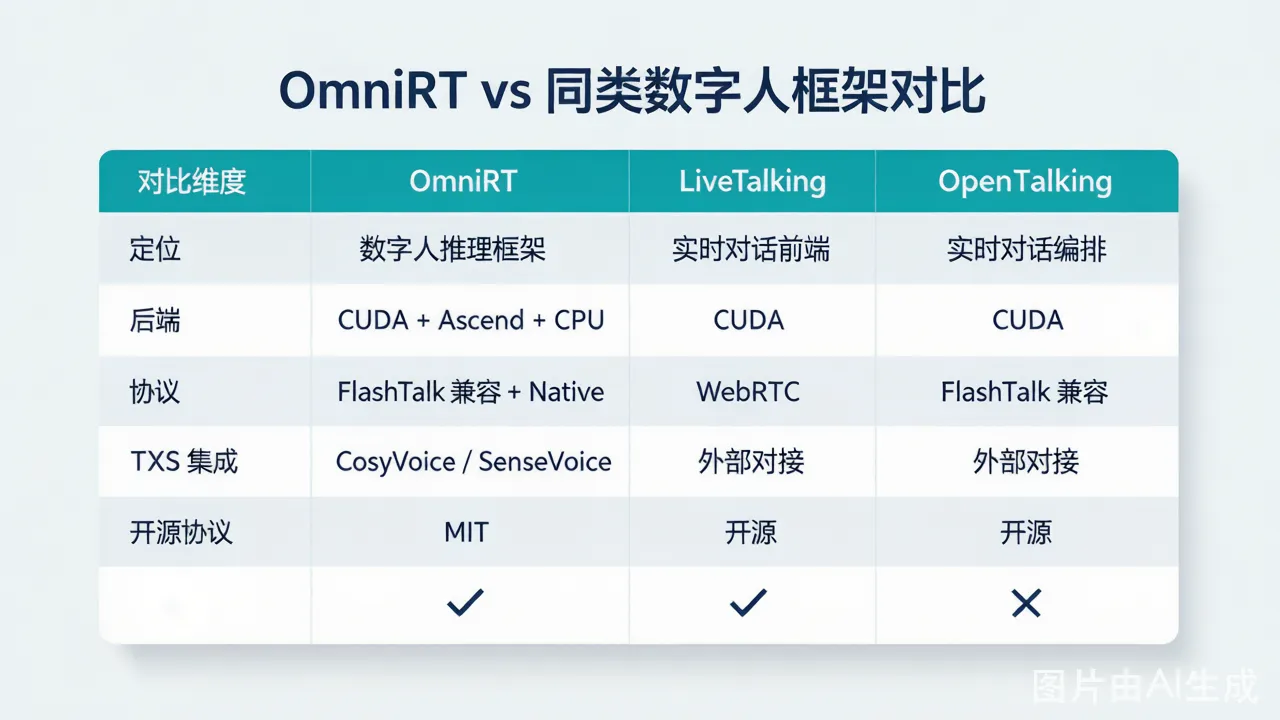
核心差异:OmniRT 是少数同时支持 CUDA + Ascend 后端的数字人推理框架;TTS 集成内建(无需外部对接);MIT 协议允许商用。
💡 适用场景
场景 1:实时数字人对话系统
功能说明:通过 FlashTalk 兼容 WebSocket 对接 OpenTalking,实现毫秒级音频驱动数字人实时对话。完整支持 5 阶段主链路,单一框架覆盖 TTS 到后处理。
输入要求:用户语音流 + 数字人形象参考图
输出效果:实时推流的说话数字人视频(≤ 200ms 端到端延迟)
适用场景:智能客服、虚拟主播、在线教育、企业数字员工
场景 2:批量数字人内容生产
功能说明:使用 requests.audio2video() 工厂方法配合 queue / worker / policies 异步派发器,批量生产带货短视频、播客口播视频、培训课程。
输入要求:文案文本 + 固定角色形象 + 背景素材
输出效果:标准化 MP4 文件 + RunReport JSON 元信息(耗时、显存、模型版本)
适用场景:电商带货、新闻播报、企业培训、知识付费
场景 3:数字人 LoRA 微调
功能说明:LoRA 灵活加载,本地 safetensors 与 hf:// 单文件引用并存。可针对特定角色形象微调音频驱动模型,10 分钟级微调即可上线。
输入要求:30 分钟目标角色语音 + 5 张不同角度形象图
输出效果:专属 LoRA 权重(safetensors 格式),可热加载到现有 pipeline
适用场景:IP 角色复活、明星虚拟分身、定制化数字员工
场景 4:昇腾国产化部署
功能说明:原生支持华为昇腾 NPU(Ascend 910B 已真机验证)。在国内信创、合规要求严格的场景下,无需 CUDA 依赖即可运行。
输入要求:Ascend 910B/310P 硬件 + 昇腾驱动
输出效果:与 CUDA 后端相同契约,相同 RunReport 格式,零代码迁移
适用场景:政府/国企项目、信创合规、国产化算力采购
用户群体总结
- ✅ 实时数字人团队:毫秒级延迟要求 + FlashTalk 兼容协议
- ✅ 国产化算力用户:Ascend 910B 部署,免改写
- ✅ 内容生产平台:批量音频驱动视频生成 + 标准化产物
- ✅ 数字人技术研究者:统一请求契约 + 7 种任务类型 + LoRA 热加载
- ❌ 不适合:需要现成 3D 数字人建模(OmniRT 关注 2D 音频驱动);追求"大而全"模型库(OmniRT 主动放弃泛图像/泛视频主线)
💰 定价方案
完全免费 & 完全开源 — MIT 协议,允许商业产品集成。
- GitHub 仓库:datascale-ai/omnirt — 源码免费
- PyPI 包:
pip install omnirt— 即将发布(86 commits 活跃开发中) - 官方文档:datascale-ai.github.io/omnirt — 中文/英文双版本
- 官方博客:knightli.com OpenTalking 介绍 — 同公司 OpenTalking 配套前端
开源协议: MIT License
💡 新用户福利:MIT 协议意味着你可以免费用于商业产品(无需付费授权),修改后闭源也合法。
🎯 总结
OmniRT 是 2026 年开源数字人领域定位最精准的推理框架。它放弃"大而全"的诱惑,把工程资源压到数字人主链路上,用统一请求契约 + 跨后端运行时 + FlashTalk 兼容协议三件套,打通了从 TTS 到后处理的完整链路。
推荐指数: ⭐⭐⭐⭐(满分 5 星,扣 1 星因生态处于早期,25 stars 社区规模较小)
适合人群:
- ✅ 正在做实时数字人产品(智能客服 / 虚拟主播 / 数字员工)
- ✅ 国内昇腾算力用户(Ascend 910B 真机验证,免改写)
- ✅ 数字人技术研究者(统一契约 + LoRA + 7 种任务)
- ✅ 国产化 / 信创合规项目
- ❌ 需要现成 3D 数字人建模(建议用 UE5 MetaHuman)
- ❌ 追求"开箱即用"大模型库(OmniRT 主动聚焦数字人主链路)
立即体验:
- GitHub 仓库:datascale-ai/omnirt
- 官方文档:datascale-ai.github.io/omnirt
- 快速上手:
pip install -e '.[dev]' && omnirt --help
数据截至 2026 年 6 月 12 日,86 commits · 25⭐ · 12 forks,最新信息请以 GitHub 仓库为准。