moore-wechat-article-downloader
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../moore-wechat-article-downloader-recommend.pptx../../moore-wechat-article-downloader-recommend.mp4本文目录
📌 核心价值:把公众号从信息流里捞出来,变成 Codex / Claude Code 可以继续分析的本地资料库
用自然语言就能让本地 Skill 同步公众号文章、保存精选评论和互动数据,所有内容沉淀到本地 SQLite,长期可搜索、可分析、可复用。
🚀 什么是 moore-wechat-article-downloader?
这是 Moore Developers 团队 2026-07-08 开源的本地优先 Skill,三天时间在 GitHub 拿下 240 Star。它的核心思路是:把微信公众号里散落的文章、评论、互动数据,变成一个本地可搜索、可分析、可长期复用的内容情报库。


核心定位:把公众号从信息流里捞出来,变成可继续分析的本地资料库——不是一次性导出,而是同步、收藏、研究、归档的闭环。
和常见的"微信公众号批量下载工具"有什么本质区别?
- 常见工具:脚本或一次性导出,按 run-id 分散输出,导出完就结束
- moore-wechat-article-downloader:本地优先 Skill 形态,用自然语言说需求,SQLite 管理所有状态(公众号、文章、下载、互动),可以增量更新、长期追踪
它面向四类用户:
- ✅ 内容创作者:拆选题、拆标题、拆表达方式
- ✅ 研究者 / 产品人:长期跟踪多个公众号,比较变化
- ✅ 知识管理用户:把微信内容沉到自己的本地资料库、wiki 或第二大脑
- ✅ AI 用户:把公众号内容变成 Codex / Claude Code 可以继续分析的输入
✨ 核心功能一览
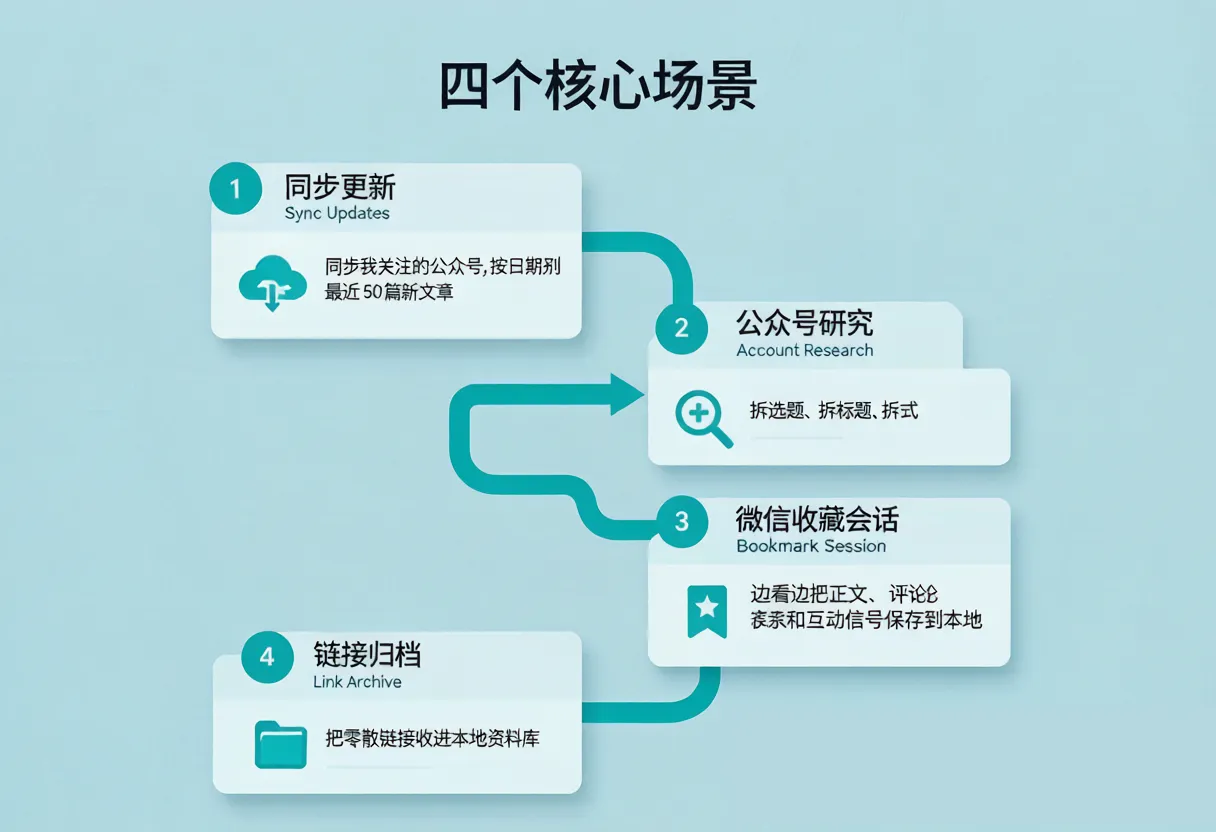
工具围绕四个核心场景形成闭环:
- 同步更新:把关注的公众号变成可追踪列表,按日期列出最近 N 篇新文章
- 公众号研究:拆选题、拆标题、拆表达方式,结合精选评论看读者真正买账的点
- 微信收藏会话:边看边把正文、评论、互动信号存到本地
- 链接归档:把零散链接收进统一的本地资料库
这四个场景不是孤立的——它们共享同一个 SQLite 状态库,每一步操作都会写入订阅、文章、下载、互动四张表,形成真正的"本地内容情报库"。
🛠️ 快速上手:5 分钟接入 Codex / Claude Code
安装
把项目克隆到 Codex 或 Claude Code 的 Skills 目录:
# Codex
mkdir -p ~/.codex/skills
git clone https://github.com/Moore-developers/moore-wechat-article-downloader.git \
  ~/.codex/skills/moore-wechat-article-downloader

# Claude Code
mkdir -p ~/.claude/skills
git clone https://github.com/Moore-developers/moore-wechat-article-downloader.git \
  ~/.claude/skills/moore-wechat-article-downloader
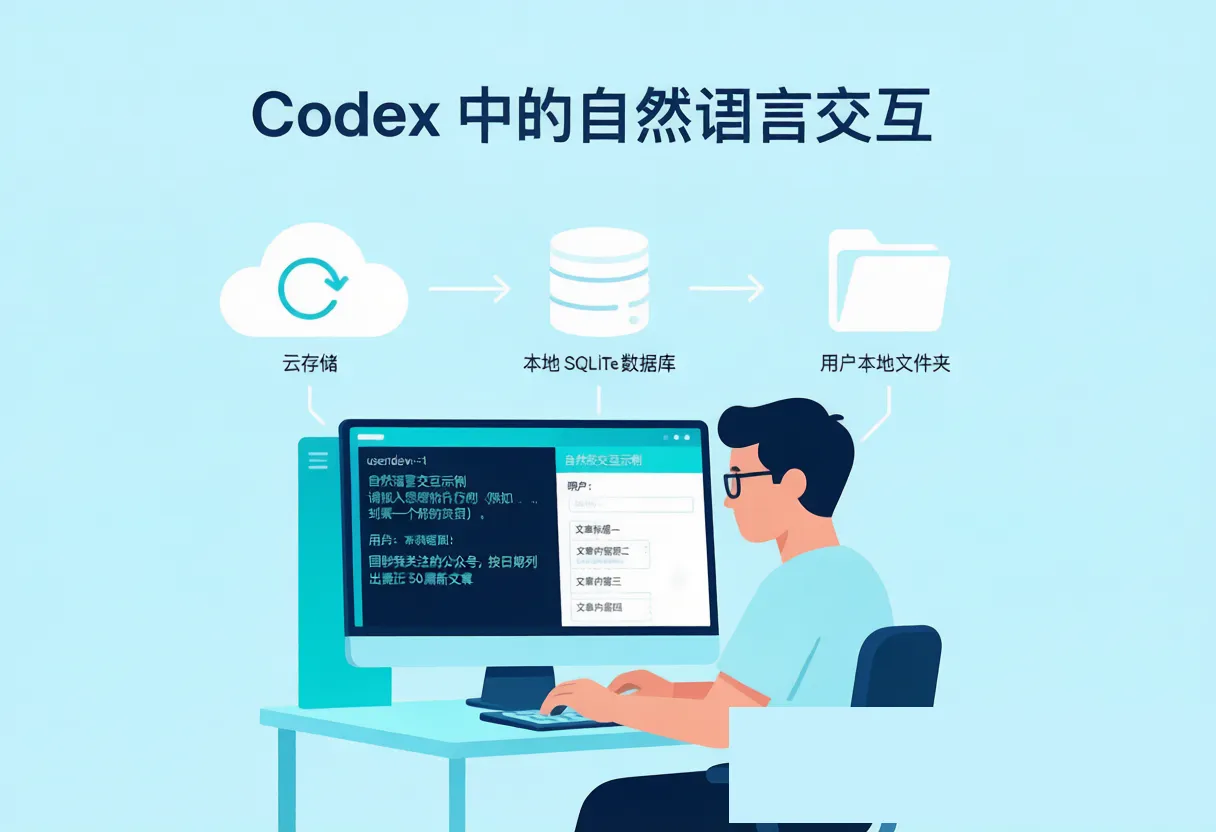
重新打开 Codex / Claude Code 后,直接用自然语言说需求就行,不需要记忆任何 CLI 参数。
自然语言交互示例
同步我关注的公众号,按日期列出最近 50 篇新文章
把「<某公众号>」最近 20 篇文章收进本地资料库
研究「<某公众号>」最近 10 篇文章,拆出它的选题方法和内容结构
结合「<某公众号>」最近 5 篇文章的精选评论和互动数据,判断读者真正买账的点
开启微信收藏会话,边看边把正文、评论和互动信号保存到本地
把这些公众号文章链接导入本地:https://mp.weixin.qq.com/s/xxx
注意:所有命令都是自然语言,不需要记任何参数——这是和传统"脚本式下载工具"最大的体验差异。
可选依赖
- Exporter 历史列表:需要扫码登录自己的微信公众号后台
- 微信收藏和旧代理历史:需要 macOS 微信桌面客户端 + 本地证书 + mitmproxy
- 自动切换和恢复系统代理:目前只支持 macOS
📊 工具架构
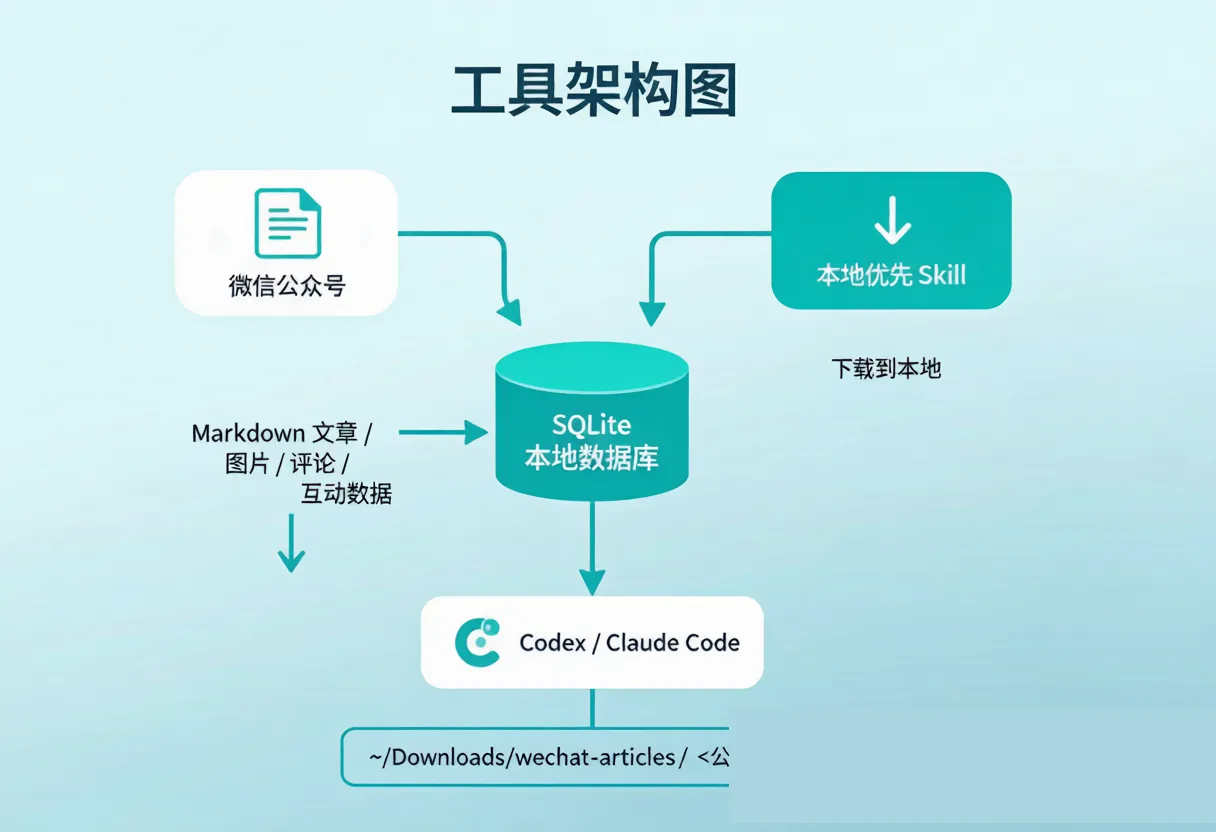
整个工具是一条单向数据管道:
- 数据源:微信公众号(公开文章 + 公开评论 + 页面暴露的互动数据)
- 采集层:
wechat_wizard.py自然语言任务、登录和选择入口;wechat_exporter.py公众号搜索、历史同步、订阅和增量下载;wechat_downloader.py链接导入、微信收藏、旧代理历史 - 存储层:SQLite 本地数据库(管理公众号、文章、下载、互动四类状态)
- 消费层:Codex / Claude Code 直接查询 SQLite,把内容作为下一步分析的输入
默认输出目录:
~/Downloads/wechat-articles/<公众号名>/
├── articles/<文章标题>.md
├── images/<文章标题>/
└── index.csv
本地还会保存:文章正文 Markdown、图片、索引、SQLite 状态、页面数据和互动数据。
📊 与常见公众号导出工具对比
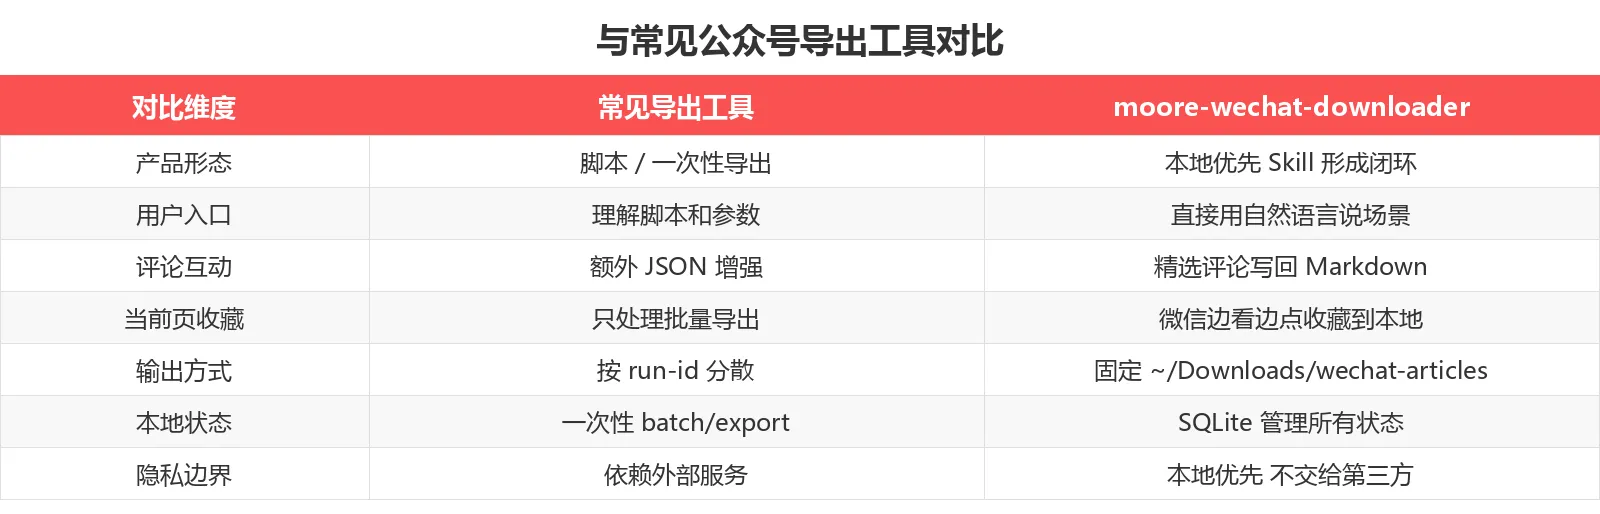
一句话总结:它不是把文章"导出来就结束",而是把公众号内容变成后续可以继续搜索、拆解和分析的本地资料库。
💡 适用场景
场景 1:内容创作者的"逆向工程"
功能说明:选定 3-5 个想长期学习的对标公众号,每周末让 Codex 自动同步最近 20 篇文章,结合精选评论拆解"选题来源、标题写法、内容结构、情绪钩子、读者反馈"五个维度。
输入要求:公众号名称、追踪周期(周/月)、研究维度
输出效果:
~/Downloads/wechat-articles/<公众号名>/articles/*.md:原文 Markdownindex.csv:可导入 Notion / Obsidian 的索引表- SQLite 中的精选评论和阅读/点赞/在看数据
适用场景:
- ✅ 公众号矩阵研究(同时跟踪 10+ 公众号的变化趋势)
- ✅ 单个公众号深度拆解(最近 20-50 篇的演化分析)
- ✅ 选题灵感库(按情绪钩子类型分类的所有标题)
场景 2:知识管理者的本地第二大脑
功能说明:把"微信收藏"从单向标记升级为可搜索的本地知识库——所有收藏的文章、评论、互动数据都沉淀到 SQLite,可以和 Notion / Obsidian / logseq 双向同步。
输入要求:微信收藏链接、目标知识库格式
输出效果:
- 精选评论写回对应文章 Markdown(不是 JSON 增强文件)
- 文章标签、关联公众号、首次收藏时间
- 可直接被 Claude / Codex 二次查询的 SQLite
适用场景:
- ✅ 把散落的微信内容变成"长期可复用"的研究资料
- ✅ 跨公众号的横向主题研究(例如"AI 编程教育"主题下 50 个公众号的态度差异)
- ✅ 评论区的"读者真正关心什么"语料库
场景 3:研究者的公众号追踪仪表盘
功能说明:用 脚本 持续追踪 20+ 关注的公众号,自动按日期、热度、互动数据生成周报/月报。
输入要求:订阅的公众号列表、报告周期、关注的指标(阅读、点赞、在看、评论数)
输出效果:
- SQLite 中保存了所有公众号的发布频率、阅读量趋势
- 可对比不同公众号在同一主题上的选题差异
- 互动数据可视化(哪些文章真正触发了传播)
适用场景:
- ✅ 行业自媒体监测(AI / 财经 / 教育等垂直领域)
- ✅ 竞品公众号研究
- ✅ 选题热度趋势分析
用户群体总结
- ✅ 内容创作者:拆解对标公众号,长期可复用
- ✅ AI 重度用户:把公众号变成 Codex / Claude Code 可分析的结构化输入
- ✅ 知识管理用户:把微信内容沉到本地资料库
- ✅ 研究者 / 产品人:长期跟踪多个公众号的演化
- ❌ 不适合:希望"一次性导出完就再也不用管"的用户(这个工具是持续追踪形态,不是单次导出)
💰 定价与开源协议
完全免费,本地优先。
- 开源协议:MIT(可商用、可二次开发)
- 云端依赖:无(所有数据沉淀到本地 SQLite 和
~/Downloads/wechat-articles/,不依赖外部 SaaS) - 付费功能:无
- 按需依赖:
- Exporter 历史列表:需要自己的公众号后台扫码登录
- 微信收藏会话:需要 macOS 微信客户端 + 本地证书 + mitmproxy
- 系统代理自动切换:仅 macOS
💡 新用户福利:MIT 协议 + 本地优先,零成本长期可复用。
🎯 总结
moore-wechat-article-downloader 不是又一个"微信公众号批量下载脚本",而是一个本地优先的 Skill 形态——用自然语言驱动、SQLite 持续管理状态、把公众号从信息流变成可分析的资料库。
推荐指数: ⭐⭐⭐⭐⭐(满分 5 星,工具形态创新 + 解决真痛点 + MIT 协议)
适合人群:
- 长期追踪多个公众号的内容创作者 / 研究者
- 希望把微信内容沉到本地知识库的 Notion / Obsidian 用户
- 重度 Codex / Claude Code 用户,希望把公众号内容变成 AI 可分析的输入
立即体验:
git clone https://github.com/Moore-developers/moore-wechat-article-downloader.git \
  ~/.codex/skills/moore-wechat-article-downloader
重新打开 Codex,说一句"同步我关注的公众号,按日期列出最近 50 篇新文章"——30 秒后你就有了一个本地可搜索的内容情报库。
GitHub 仓库: Moore-developers/moore-wechat-article-downloader
数据截至 2026-07-11,最新信息请以官网为准。