LingBot-Vision
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../lingbot-vision-recommend.pptx../../lingbot-vision-recommend.mp4本文目录
📌 核心价值:蚂蚁集团 + 上交开源自监督 ViT 家族,1.1B 参数 ViT-g/16 旗舰,「边界建模」让密集空间感知再升级
自监督 ViT 领域的 DINOv3 升级版,原生支持深度估计 / 语义分割 / 视频分割 / 深度补全 4 大密集任务。
🚀 什么是 LingBot-Vision?
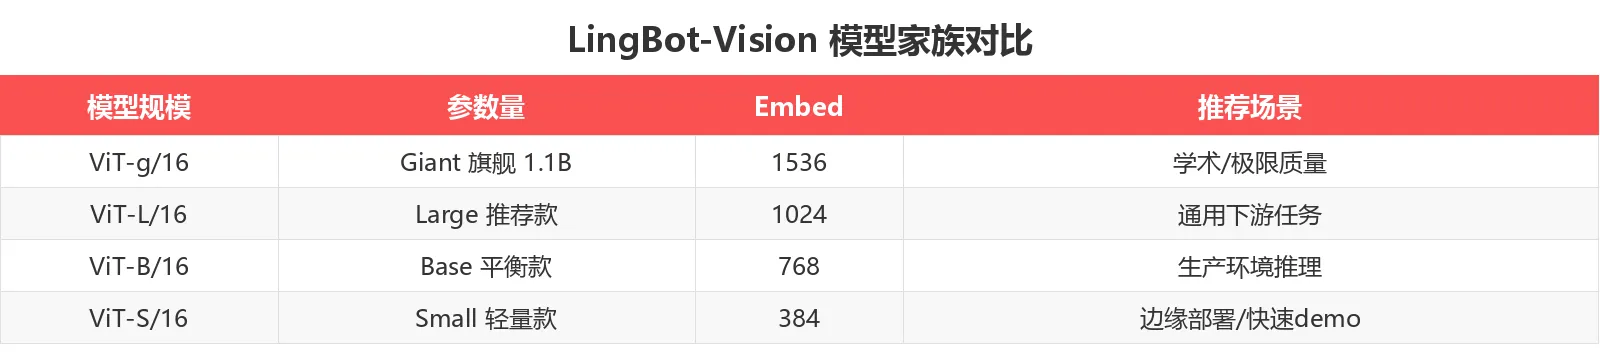
LingBot-Vision 是蚂蚁集团联合上海交通大学 2026 年 7 月发布的一套自监督 Vision Transformer 骨干网络家族,专为密集空间感知(dense spatial perception)设计。从 ViT-S/16 到 1.1B 参数的 ViT-g/16 旗舰共 4 个尺寸,可以无监督地学到边界、形状和语义区域,作为下游密集预测任务的 drop-in 视觉编码器。
核心创新:边界中心化掩码建模(Masked Boundary Modeling)——通过一个边界中心化的预训练目标,让 ViT 学到的 patch 特征同时具备语义分组和几何结构能力,无需任何人工标注。


🎯 核心定位:让 ViT 既懂"语义"又懂"边界"——这是 DINOv2 之后第一个把密集空间感知做深做透的开源家族。
✨ 核心功能一览
🛠️ 快速上手:5 分钟跑通示例
环境要求
- Python ≥ 3.10
- PyTorch ≥ 2.0
- 推荐 CUDA-capable GPU(Large/Giant 模型)
安装
# 1. 克隆仓库
git clone https://github.com/robbyant/lingbot-vision.git
cd lingbot-vision

# 2. 创建 conda 环境
conda create -n lingbot-vision python=3.10 -y
conda activate lingbot-vision

# 3. 安装依赖
python -m pip install -r requirements.txt
python -m pip install -e .
核心代码示例
import torch
from lingbot_vision import load_pretrained_backbone, extract_patch_tokens, load_image

device = "cuda" if torch.cuda.is_available() else "cpu"
dtype = torch.bfloat16 if device == "cuda" else torch.float32

# 第一次运行会自动从 Hugging Face 下载权重
backbone, embed_dim = load_pretrained_backbone(
    variant="small",   # 可选 giant / large / base / small
    device=device,
    dtype=dtype,
)

img_norm, _, _ = load_image(
    "examples/example.png",
    size=512,
    patch_size=backbone.patch_size,
    mode="square",
)
patch_tokens, patch_grid = extract_patch_tokens(backbone, img_norm, device, dtype)

print(patch_tokens.shape, patch_grid, embed_dim)
# torch.Size([1, 1024, 384]) (32, 32) 384
关键参数:patch_tokens 形状为 [B, H*W, C],直接拿去做下游密集预测 head 的输入即可——这是 drop-in 视觉编码器的核心价值。
运行 PCA 可视化 demo
./scripts/run_pca_demo.sh \
  --config-file lingbot_vision/configs/lbot_vision_vitl.yaml \
  --ckpt /path/to/model.pt \
  --input examples/example.png \
  --out outputs/pca_demo \
  --size 512 \
  --mode square \
  --dtype bf16
注意:CPU 推理请加 --dtype fp32 --device cpu;Giant 模型在 GPU 上单卡显存约 6GB,Large 约 3GB。
📊 与竞品对比
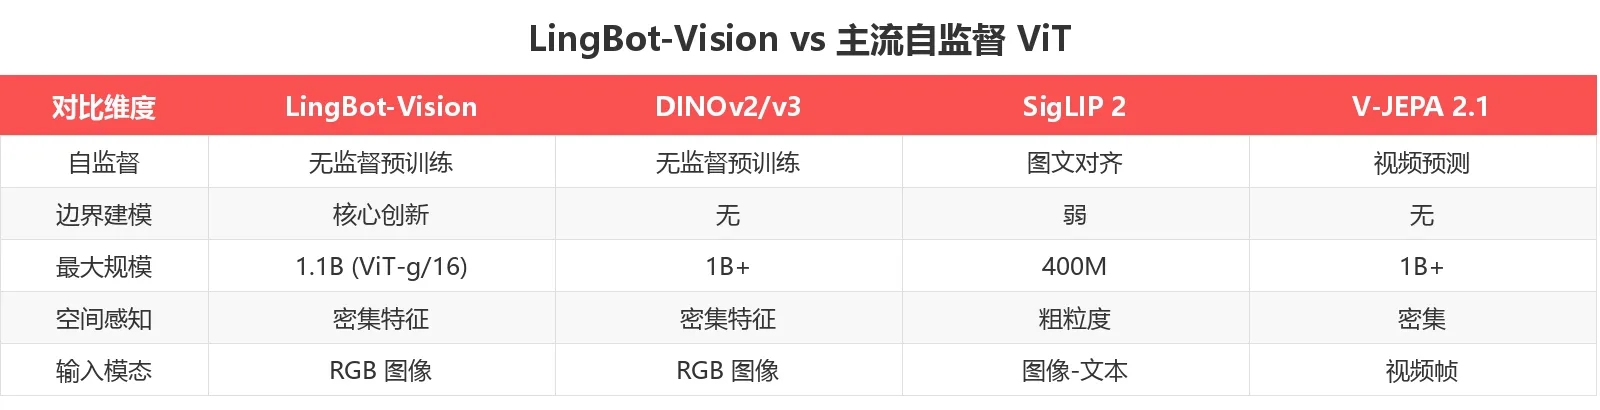
核心差异:LingBot-Vision 是当前唯一把"边界建模"作为自监督核心目标的 ViT 家族,DINOv2/v3 仍是 patch 重建 + 蒸馏,V-JEPA 走视频预测路线——边界信息让 LingBot 在密集空间任务上能直接用 frozen 特征做下游 head。
💡 适用场景
场景 1:边界建模与特征可视化
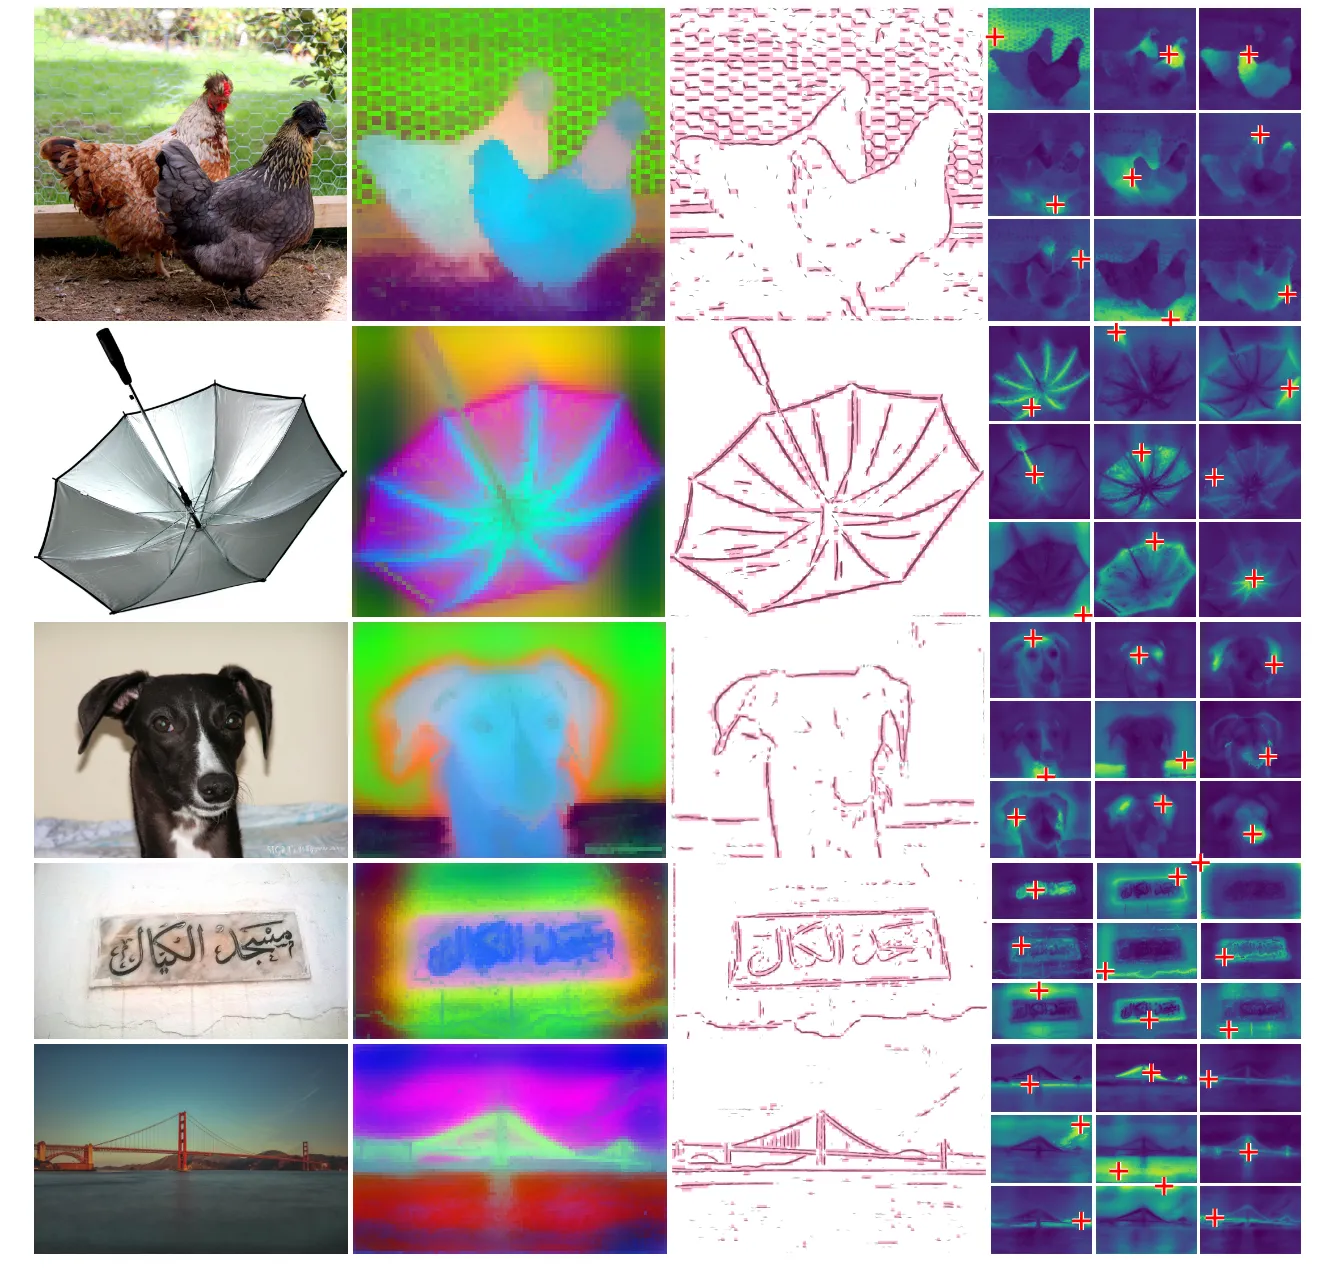
功能说明:LingBot-Vision 的"边界中心化掩码建模"在 5 类典型图像(鸡、伞、狗、阿拉伯文、金门大桥)上展示了 frozen patch tokens 的 PCA 投影、teacher 发现的边界 token、以及与边界查询的余弦相似度图。特征同时捕获语义分组和几何结构——这是普通自监督 ViT 难以兼顾的。
输入要求:RGB 图像,ViT-g/16 推荐 512×512 输入,对应 32×32 patch grid
输出效果:1024 个 patch tokens(384/768/1024/1536 维),可直接喂给下游密集预测 head
适用场景:
- 机器人视觉前端编码器(强化边界感知)
- 医疗影像分割(边界比语义更关键)
- 工业质检(细微缺陷需要边界敏感)
场景 2:深度补全——镜面/玻璃场景的硬骨头
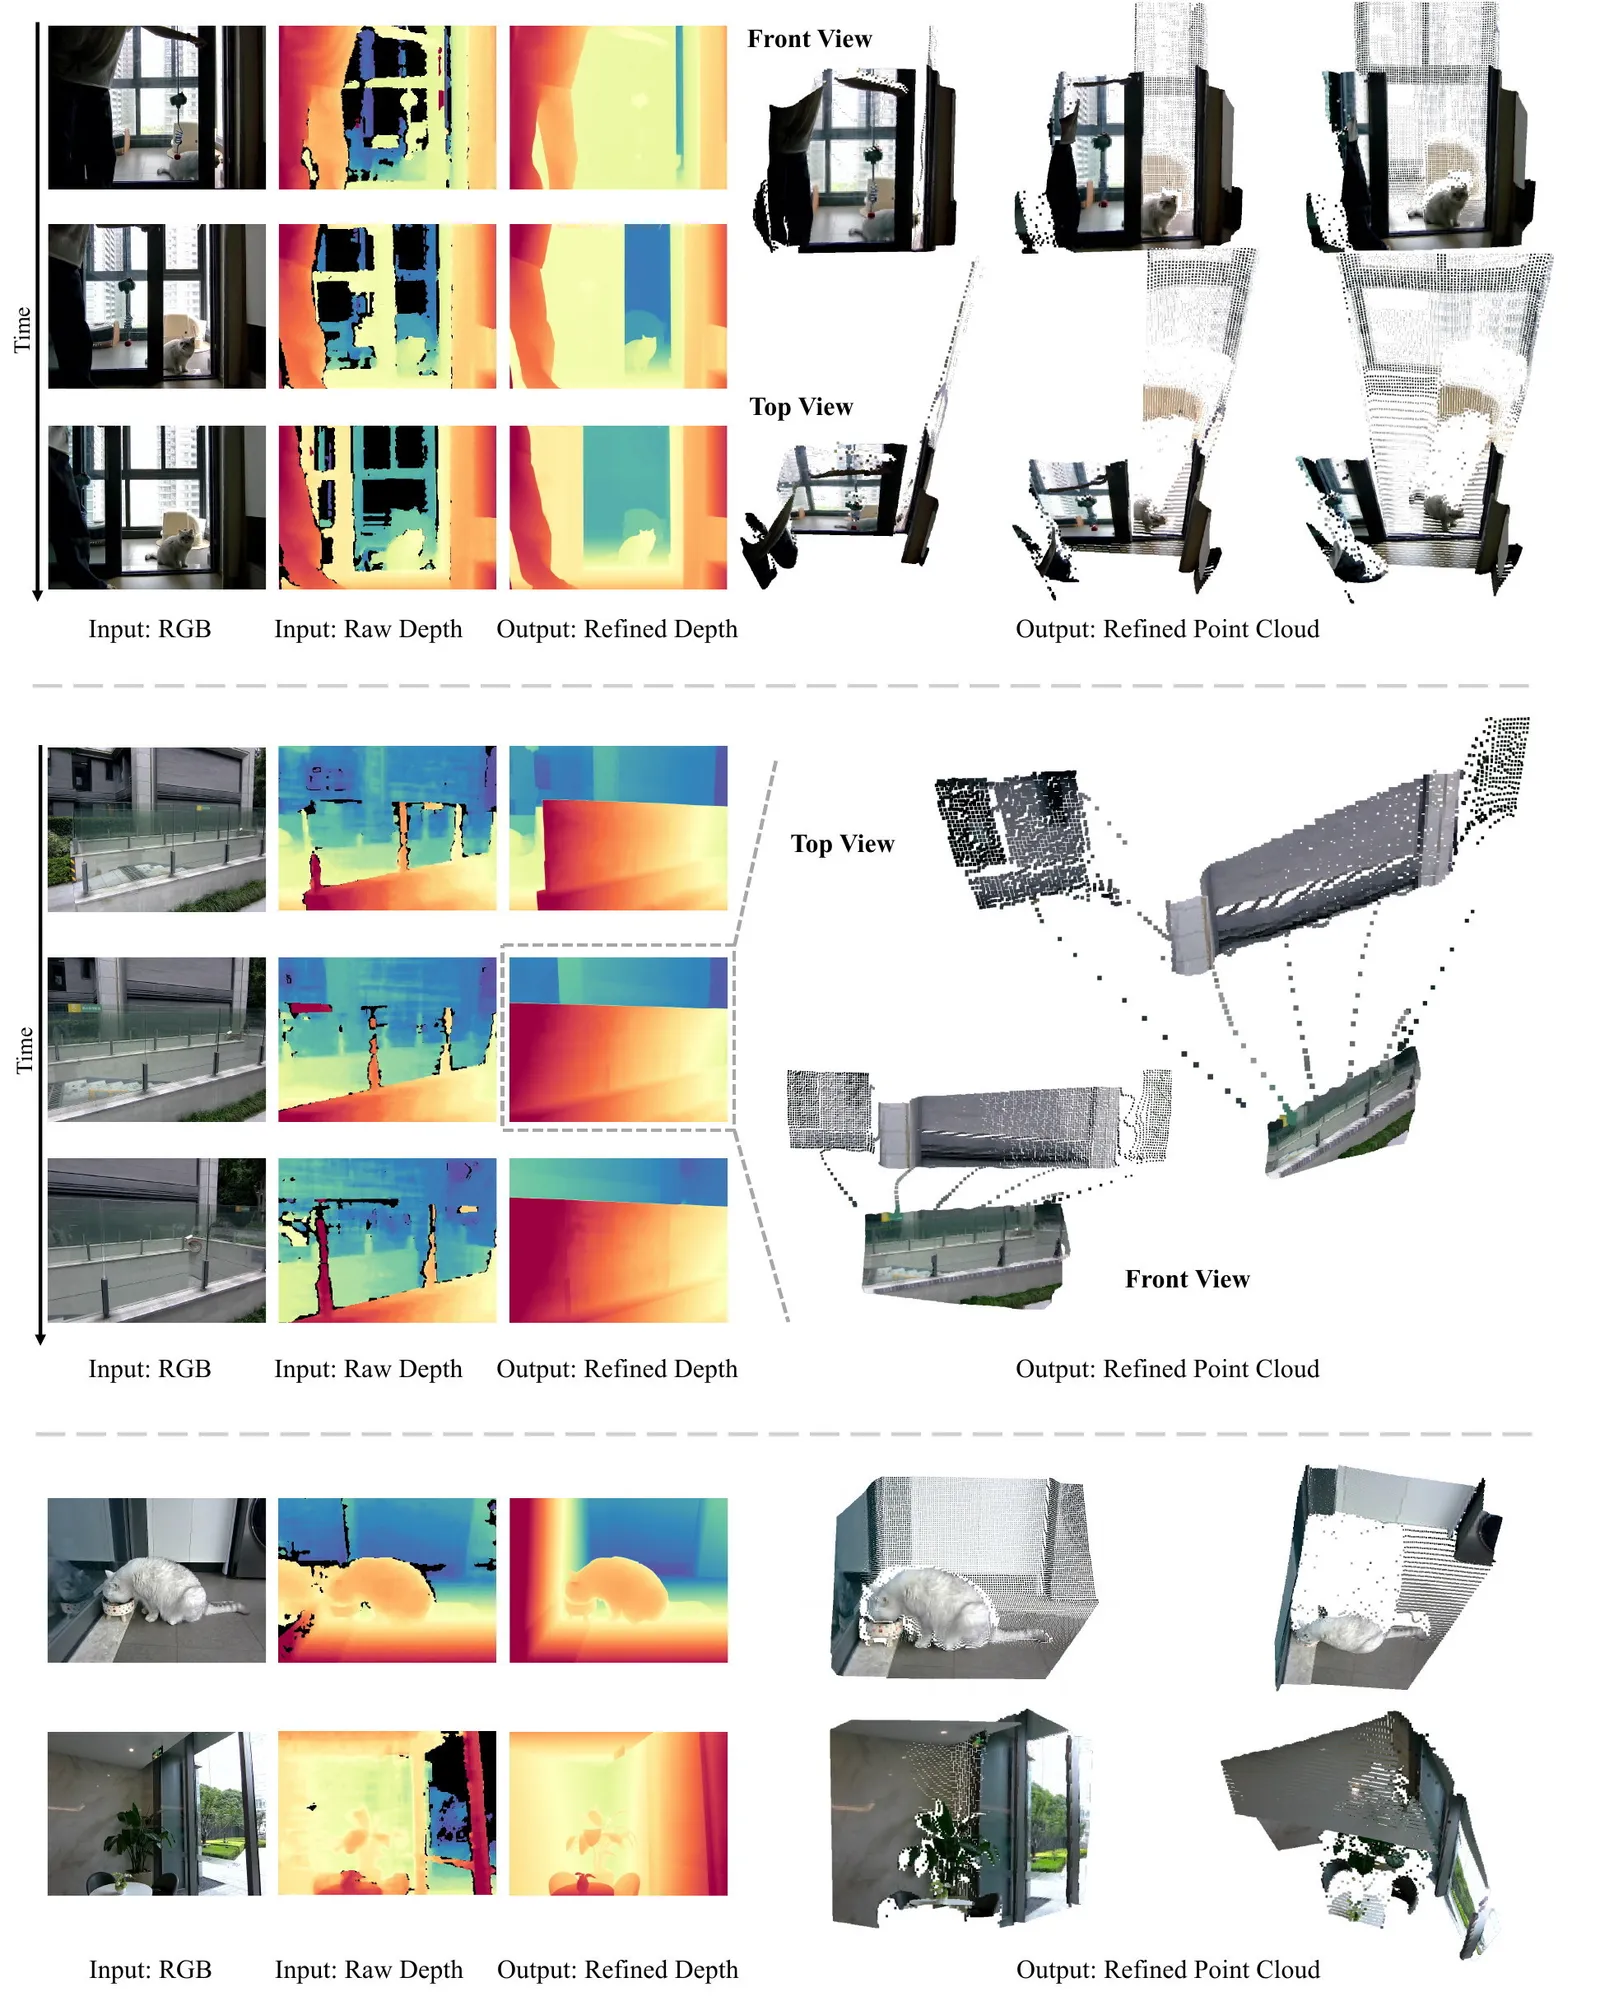
功能说明:LingBot-Depth 2.0 用 LingBot-Vision 作为 ViT-L/16 和 ViT-g/16 的视觉编码器初始化,配合 150M RGB-D 训练语料(相比上一代 3M 提升 50 倍),在镜面、玻璃、反射地面这些"传感器深度图大面积缺失"的场景里,能够补全成稳定连续的表面,跨帧时间一致性也很好。
输入要求:RGB + 原始传感器深度(如 RealSense、Kinect、LiDAR-Camera 融合)
输出效果:精炼后的稠密深度图 + 三维点云重建(前视图 + 俯视图双视角)
适用场景:
- 室内机器人导航(玻璃门/镜面墙的鲁棒定位)
- AR/VR 空间锚定(透明物体不会丢失深度)
- 自动驾驶传感器融合(应对反光地面/车窗)
场景 3:与主流自监督 ViT 的特征质量对比
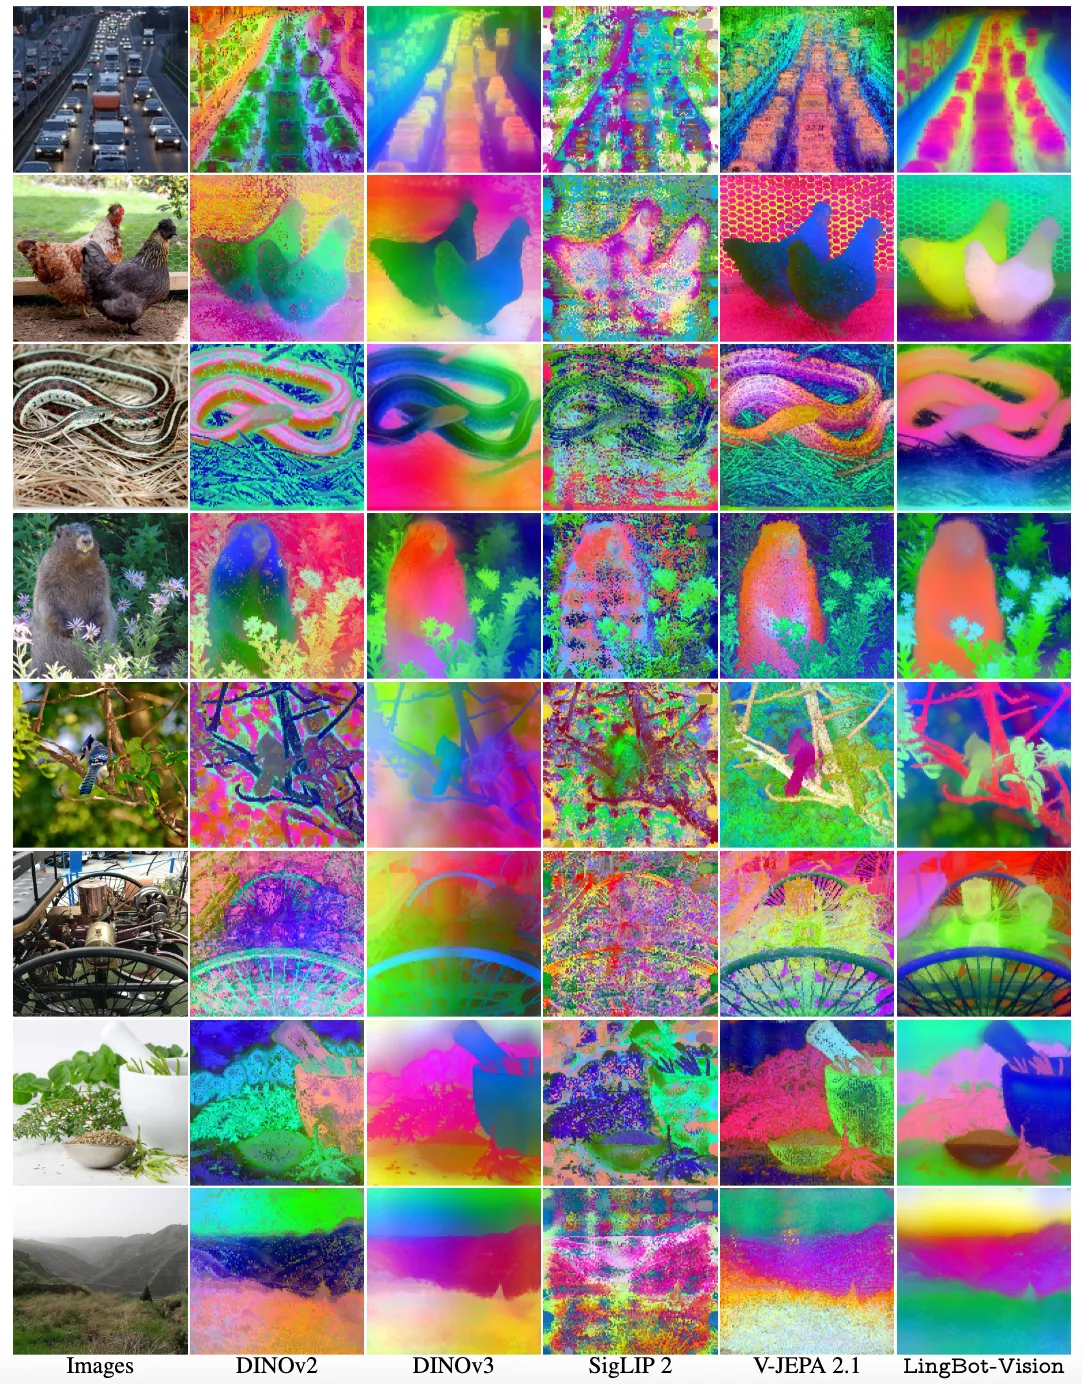
功能说明:在 8 类典型场景(堵车、母鸡、蛇、鸟、蜘蛛网、自行车、旋转椅、植物、远山)上,LingBot-Vision 与 DINOv2、DINOv3、SigLIP 2、V-JEPA 2.1 的 PCA 投影对比。LingBot-Vision 表现出更干净的语义分组和更锐利的边界——这是边界中心化训练目标的直接收益。
输入要求:与对比模型完全相同的 224×224 图像预处理
输出效果:top-3 PCA 通道映射到 RGB,可视化 frozen token 特征
适用场景:
- 模型选型决策(自监督 ViT 哪家强?)
- 消融实验基线(边界建模的贡献可视化)
- 学术论文 baseline 对比
用户群体总结
- ✅ 机器人/具身智能团队:需要鲁棒的空间感知前端
- ✅ AR/VR 开发者:需要处理镜面/玻璃等透明表面
- ✅ 自动驾驶工程师:需要应对反光/雨雾等极端场景
- ✅ 学术研究者:做自监督预训练 + 密集预测下游任务
- ✅ 工业质检团队:需要边界敏感的视觉编码器
- ❌ 不适合:纯分类任务(CLIP/DINOv2 已足够)、需要图文对齐的多模态场景(用 SigLIP)
💰 定价方案
LingBot-Vision 是完全开源免费的项目。
开源协议: Apache-2.0
权重下载:
- Hugging Face: robbyant/lingbot-vision
- ModelScope: Robbyant/LingBot-Vision
💡 商业友好:Apache-2.0 协议允许商用、修改、闭源分发——企业可放心集成到产品。
🎯 总结
LingBot-Vision 是 2026 年 7 月自监督 ViT 领域最值得关注的开源项目之一。它用"边界中心化掩码建模"这一新颖训练目标,把 DINOv2 之后密集空间感知的边界能力推到了新高度。从 ViT-S 到 ViT-g 共 4 个尺寸覆盖了边缘到云端的部署需求,配合 LingBot-Depth 2.0 直接在镜面/玻璃场景给出工业级深度补全效果,是具身智能、AR/VR、自动驾驶团队的视觉编码器升级首选。
推荐指数: ⭐⭐⭐⭐⭐(满分 5 星)
适合人群: 机器人/AR/VR/自动驾驶团队的视觉工程师、自监督表征学习研究者
立即体验: LingBot-Vision 项目页
GitHub 仓库: Robbyant/lingbot-vision
数据截至 2026-07-09,最新信息请以官网为准。