🔥 【今日推荐 LangExtract】:Google 开源 35K Stars 文本智能提取神器,5行代码把非结构化文档变成结构化数据!
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../langextract-recommend.pptx../../langextract-recommend.mp4本文目录
🔥 【今日推荐 LangExtract】:Google 开源 35K Stars 文本智能提取神器,5行代码把非结构化文档变成结构化数据!
每天有无数临床病历、法律合同、金融研报躺在电脑里无法利用——Google 用一个开源库彻底解决了这个难题。LangExtract 让 LLM 不只是"生成",而是"精准提取",每条结果都能溯源到原文的精确位置。
🚀 什么是 LangExtract?
LangExtract 是 Google 开源的 Python 库,专门解决一个高频痛点:如何用 LLM 从大量非结构化文本中可靠地提取结构化信息。
传统方案要么靠正则表达式(太脆),要么靠 LLM 直接输出 JSON(幻觉多、溯源难)。LangExtract 走了第三条路——Few-shot 示例驱动 + 精准溯源 + 可控结构化输出,让每一条提取结果都有据可查。


核心定位:不是又一个 LLM Wrapper,而是一个以"精准溯源"为核心的工业级信息提取引擎,内置并行分块和多轮 Pass 策略,专为长文档设计。
项目地址:https://github.com/google/langextract
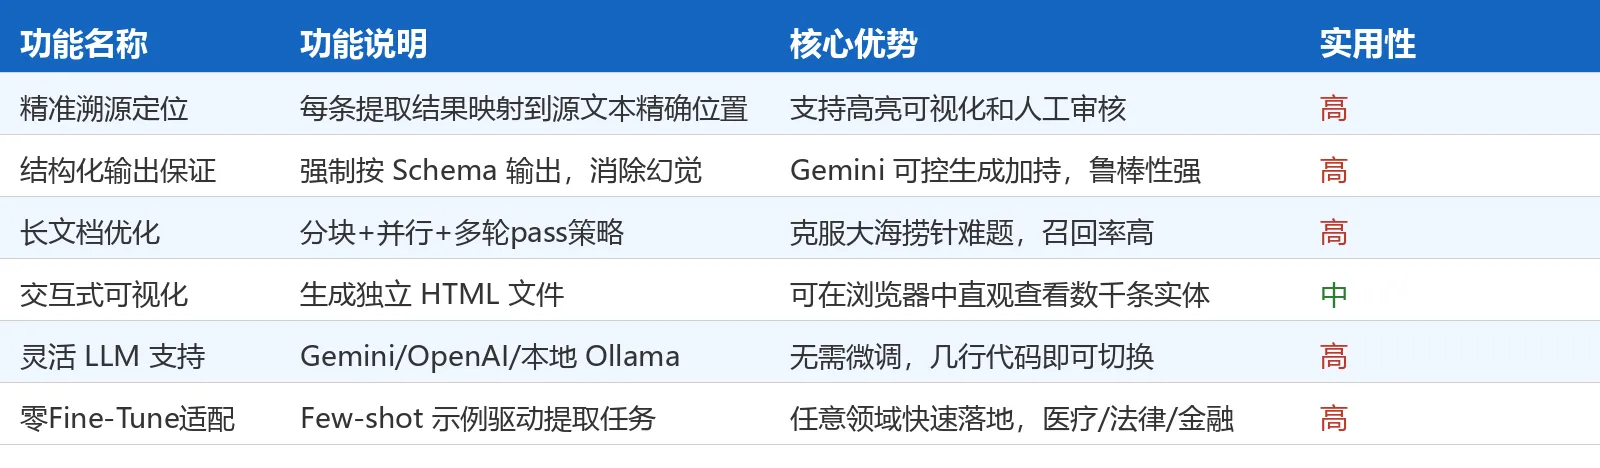
✨ 核心功能一览
🛠️ 快速上手:5 分钟跑通示例
安装
pip install langextract
核心代码示例(《罗密欧与朱丽叶》人物提取)
import langextract as lx
import textwrap

# 1. 定义提取任务(一段 Prompt 即可)
prompt = textwrap.dedent("""\
    Extract characters, emotions, and relationships in order of appearance.
    Use exact text for extractions. Do not paraphrase or overlap entities.
    Provide meaningful attributes for each entity to add context.""")

# 2. 提供 Few-shot 示例(告诉模型提什么、怎么提)
examples = [
    lx.data.ExampleData(
        text="ROMEO. But soft! What light through yonder window breaks? It is the east, and Juliet is the sun.",
        extractions=[
            lx.data.Extraction(
                extraction_class="character",
                extraction_text="ROMEO",
                attributes={"emotional_state": "wonder"}
            ),
            lx.data.Extraction(
                extraction_class="emotion",
                extraction_text="But soft!",
                attributes={"feeling": "gentle awe"}
            ),
        ]
    )
]

# 3. 加载文档,一键提取
doc = lx.data.Document(text=open("romeo_and_juliet.txt").read())
result = lx.extract(doc, prompt=prompt, examples=examples)

# 4. 生成可视化 HTML(含溯源高亮)
lx.visualization.write_html(result, "output.html")
print(f"提取到 {len(result.extractions)} 条实体")
注意:Few-shot 示例质量直接决定提取效果。示例越精准,输出越稳定。建议每个类别至少提供 2-3 个示例。
切换到本地 Ollama(无需 API Key)
import langextract as lx

# 使用本地 Ollama 运行(无需任何 API Key,完全离线)
result = lx.extract(
    doc,
    prompt=prompt,
    examples=examples,
    provider="ollama",
    model="llama3.2"
)
医疗场景:药物信息提取
# 专业医疗提取场景示例
medication_prompt = "Extract medication names, dosages, and frequencies from clinical notes."

medication_examples = [
    lx.data.ExampleData(
        text="Patient was prescribed Metformin 500mg twice daily for diabetes management.",
        extractions=[
            lx.data.Extraction(
                extraction_class="medication",
                extraction_text="Metformin",
                attributes={"dosage": "500mg", "frequency": "twice daily", "indication": "diabetes"}
            ),
        ]
    )
]

# 批量处理临床病历
for note in clinical_notes:
    doc = lx.data.Document(text=note)
    result = lx.extract(doc, prompt=medication_prompt, examples=medication_examples)
    # 每条提取结果都带有源文本偏移量,精准溯源
    for extraction in result.extractions:
        print(f"药物: {extraction.extraction_text}, 位置: {extraction.start_offset}-{extraction.end_offset}")
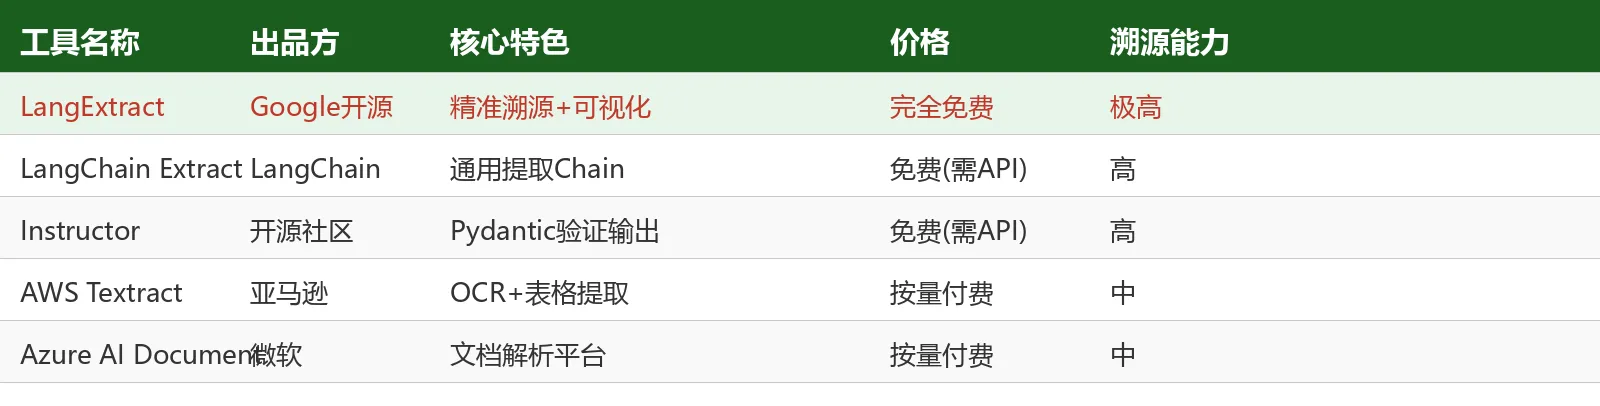
📊 与竞品对比
💡 适用场景
🏥 医疗:临床病历结构化
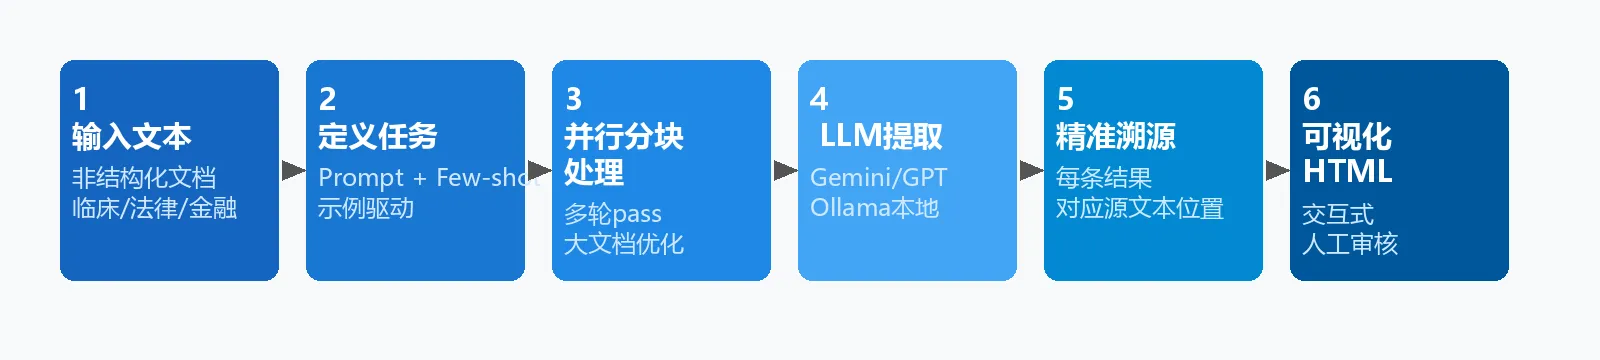
功能说明:从非结构化的临床笔记、放射报告、出院小结中提取药物名称、诊断、剂量、手术记录等关键信息,每条结果精确对应源文本位置,满足医疗合规要求。
输入要求:任何格式的临床文本文档,支持长文档分块处理。
输出效果:结构化 JSON + 交互式 HTML 可视化报告,医生可直接在浏览器中高亮审核每条提取结果。
适用场景:医院 EMR 系统数据清洗、药物不良事件监测、临床研究数据采集。
⚖️ 法律:合同关键条款提取
功能说明:从合同、法律文书、监管文件中批量提取当事人姓名、关键日期、金额、违约条款等信息,实现合同审查自动化。
输入要求:PDF 或纯文本格式的法律文档,支持超长合同分块处理。
输出效果:结构化字段数据 + 精准溯源位置,便于律师快速定位和审核。
适用场景:企业法务部合同审查提速、合规文件批量处理、尽职调查辅助。
📊 金融:研报/新闻实体识别
功能说明:从金融研报、新闻文章中提取公司名称、数据指标、分析观点等结构化信息,支持知识图谱构建和投资信号识别。
输入要求:金融文本,可通过自定义 Few-shot 示例适配特定行业术语。
输出效果:实体-属性-关系三元组结构,可直接导入数据库或知识图谱。
适用场景:量化投研数据采集、舆情监控、企业知识库构建。
📚 使用场景总结
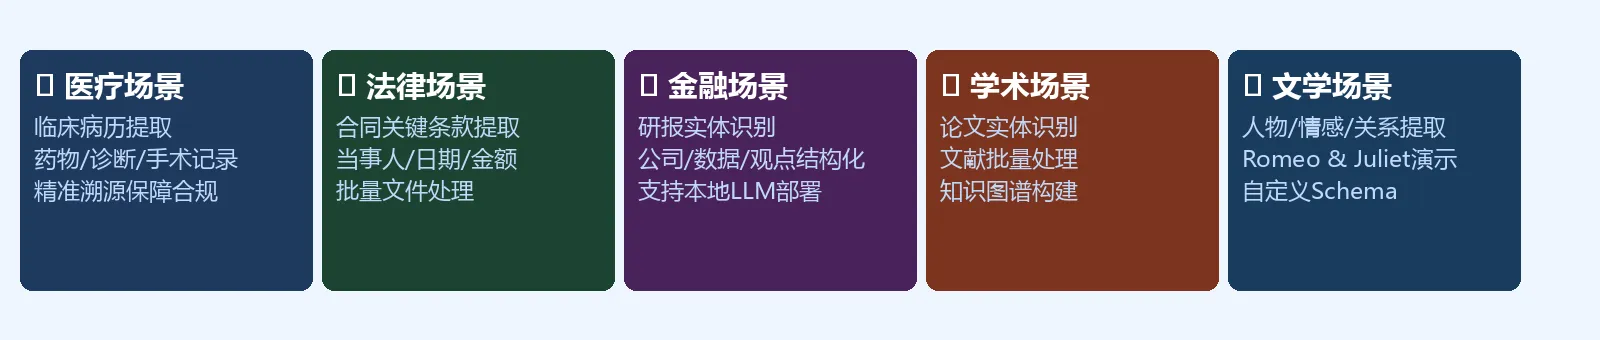
- ✅ 医疗合规:精准溯源满足医疗数据合规要求,支持人工审核
- ✅ 法律自动化:合同批量处理,律师效率提升数倍
- ✅ 金融研究:研报实体结构化,量化投研数据采集
- ✅ 学术研究:文献批量处理,知识图谱构建
- ❌ 不适合:需要实时生成内容(LangExtract 专注提取,不做生成);简单短文本(用正则就够了)
🌟 为什么 LangExtract 值得关注?
LangExtract 有 7 大核心优势,让它在众多 LLM 提取方案中脱颖而出:
1. 精准溯源(Grounding)
每条提取结果都带有源文本的精确偏移量(start_offset/end_offset),可直接在 HTML 中高亮显示。这在医疗、法律场景中是刚需——没有溯源就没有可信度。
2. 可控结构输出 结合 Gemini 的可控生成能力,强制模型按照指定 Schema 输出,大幅减少幻觉和格式错误。
3. 长文档优化 独创的"分块 + 并行 + 多轮 Pass"策略,专门克服大海捞针难题。超长文档不再是痛点。
4. 零 Fine-Tune 只需几个 Few-shot 示例,即可适配任意领域。今天医疗,明天法律,完全不需要重新训练模型。
5. 完全开源免费(Apache-2.0) 代码、示例、文档全部开源,支持本地 Ollama 部署,无需花一分钱 API 费用。
6. 交互式可视化
lx.visualization.write_html() 一行生成独立 HTML,可在浏览器中查看数千条提取实体的原文位置。
7. Google 官方维护 Google 内部团队出品,代码质量和长期维护有保障,arXiv 论文支撑(DOI: 10.5281/zenodo.17015089)。
💰 定价方案
完全免费,Apache-2.0 开源协议
| 方式 | 费用 | 说明 |
|---|---|---|
| 使用 Gemini API | 免费额度/按量付费 | Gemini 1.5 Flash 免费额度相当大 |
| 使用 OpenAI API | 按量付费 | 支持 GPT-4o/GPT-4o-mini |
| 使用本地 Ollama | 完全免费 | 支持 llama3.2、qwen 等本地模型 |
💡 新手推荐:本地 Ollama + llama3.2,零成本体验全部功能,适合企业私有化部署和个人学习。
开源协议: Apache-2.0
🎯 总结
LangExtract 是 2026 年最值得关注的 AI 工具之一。它不是在赶 LLM 的热潮,而是在解决一个真实且高价值的工程问题:如何让 LLM 的提取结果可信、可验证、可批量化。
35K Stars、Google 官方维护、Apache-2.0 开源——这三点就足以说明它的质量和可持续性。无论你是在做医疗 NLP、法律文本分析、金融数据采集还是学术研究,LangExtract 都能帮你把非结构化文本变成可用的结构化数据。
推荐指数: ⭐⭐⭐⭐⭐(满分5星)
适合人群: 需要从大量文档中提取结构化信息的工程师、研究人员、数据分析师
立即体验: pip install langextract
GitHub 仓库: google/langextract
数据截至 2026-04-26,最新信息请以官网为准。