🔥 【今日推荐 RLM】:MIT 实验室开源递归语言模型引擎,让 LLM 调用自己——无限长上下文彻底破解!
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../RLM-recommend.pptx../../RLM-recommend.mp4本文目录
🔥 【今日推荐 RLM】:MIT 实验室开源递归语言模型引擎,让 LLM 调用自己——无限长上下文彻底破解!
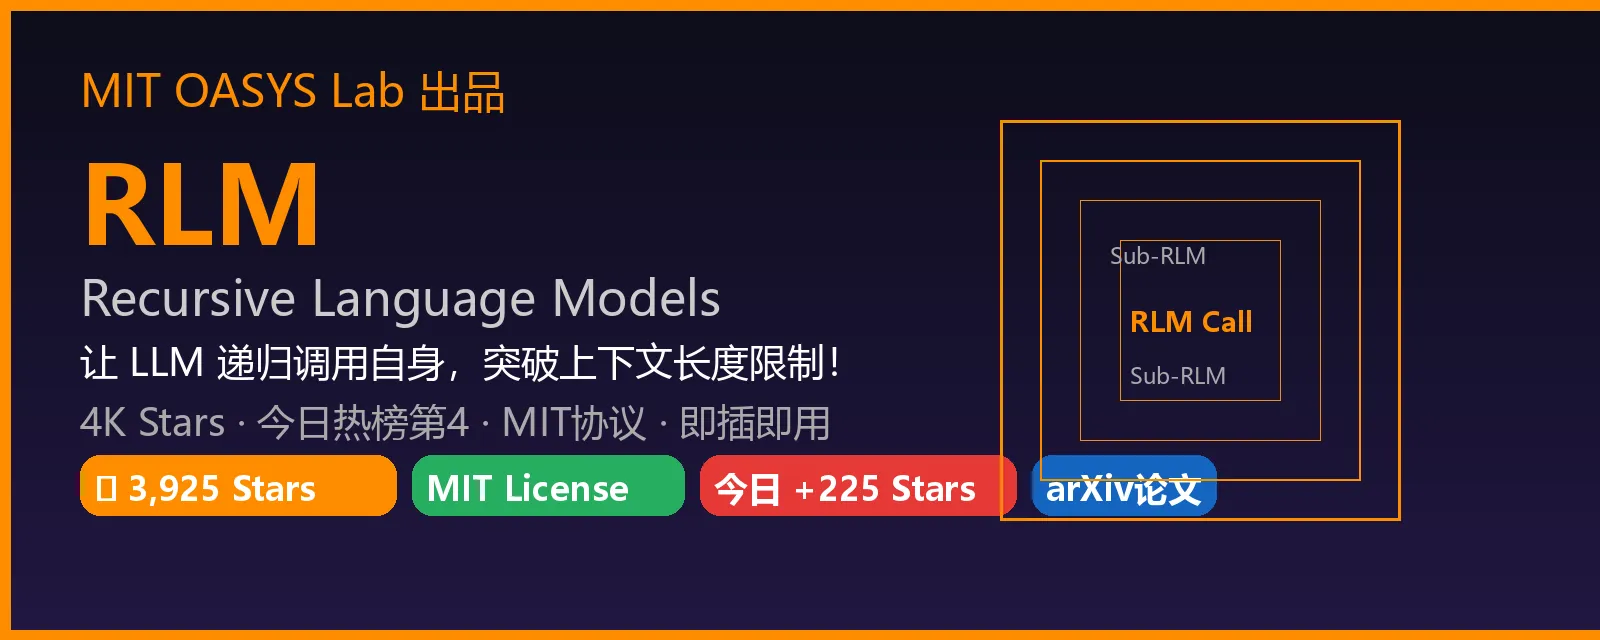
当 LLM 碰到无法装进上下文的超长任务,怎么办?MIT OASYS Lab 给出了答案——让 LLM 递归地调用自身,把任务分解再分解,直到每个子任务都能被处理。RLM,今日 GitHub 热榜第4,4K Stars 持续飙升。
🚀 什么是 RLM(Recursive Language Models)?
RLM 全称 Recursive Language Models,由 MIT OASYS Lab 出品,是一个即插即用的递归推理引擎。
核心思路极简:用 rlm.completion(prompt, model) 替换你现在的 llm.completion(prompt, model),LLM 就获得了在 REPL 环境中递归调用自身的能力——它可以把超长任务分解成子任务,给子 RLM 处理,最终汇总结果。
就像写代码里的递归函数,但执行者是 LLM 本身。


核心突破:不再受制于 Context Window,任何超长文档、超长任务都可以被 RLM 递归分解处理,理论上支持近无限长度上下文。
项目地址:https://github.com/alexzhang13/RLM arXiv 论文:arxiv.org/abs/2512.24601
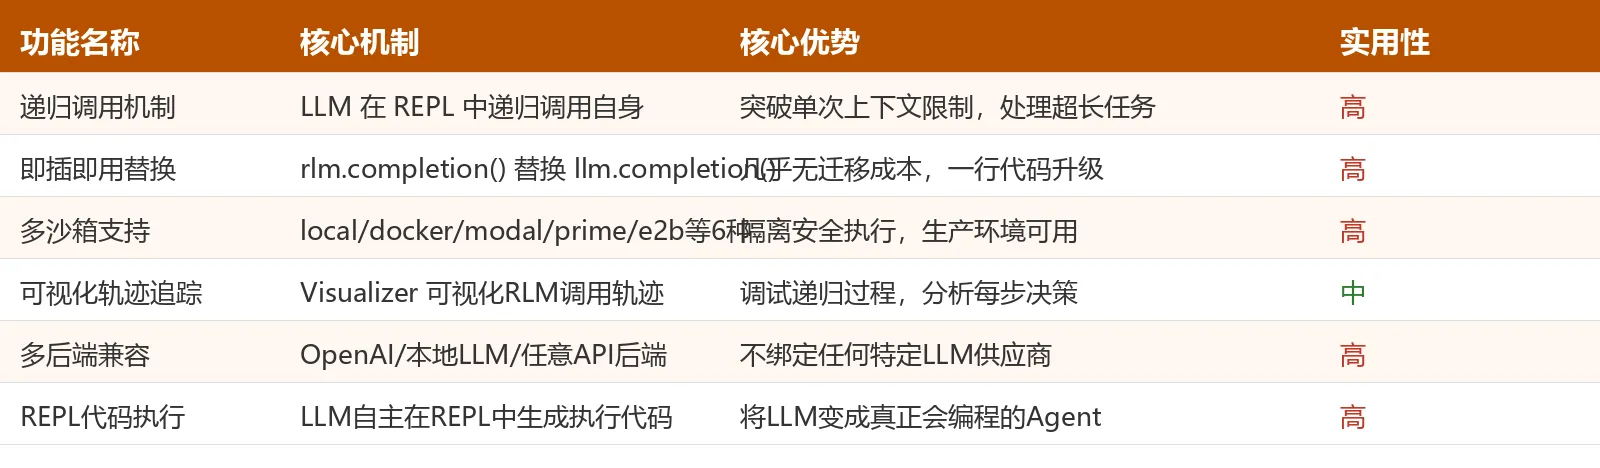
✨ 核心功能一览
🛠️ 快速上手:3 分钟体验递归 LLM
安装
pip install rlms
最简单的示例(打印100个2的幂次)
from rlm import RLM

# 初始化 RLM(使用 OpenAI 后端)
rlm = RLM(
    backend="openai",
    backend_kwargs={"model_name": "gpt-4o-mini"},
    verbose=True,  # 打印递归调用过程,方便调试
)

# 和普通 LLM 一样调用,但 RLM 会在内部递归
result = rlm.completion("Print me the first 100 powers of two, each on a newline.")
print(result.response)
注意:verbose=True 可以看到 RLM 如何在 REPL 中生成代码并执行,这是理解 RLM 工作原理的最好方式。
使用本地 Ollama(完全免费)
from rlm import RLM

# 本地 Ollama 后端,零 API 费用
rlm = RLM(
    backend="ollama",
    backend_kwargs={"model_name": "qwen2.5:14b"},
    verbose=True,
)

result = rlm.completion("分析这篇10000字的技术文档,提取所有功能要点并按优先级排序")
print(result.response)
切换到隔离沙箱环境(生产推荐)
from rlm import RLM

# 使用 Docker 隔离沙箱,安全执行 LLM 生成的代码
rlm = RLM(
    environment="docker",     # 也可以是 "modal", "e2b", "prime", "daytona"
    environment_kwargs={},
    backend="openai",
    backend_kwargs={"model_name": "gpt-4o"},
)

# 生产环境下放心运行
result = rlm.completion("读取并分析这些日志文件,找出所有 ERROR 级别的问题")
print(result.response)
可视化追踪递归轨迹
# RLM 会自动生成日志文件,可用 Visualizer 查看
from rlm import RLM, Visualizer

rlm = RLM(backend="openai", backend_kwargs={"model_name": "gpt-4o"}, log=True)
result = rlm.completion("解析这份100页的合同文档")

# 启动可视化界面(浏览器打开)
viz = Visualizer(log_path=rlm.log_path)
viz.serve()  # 默认 http://localhost:8080
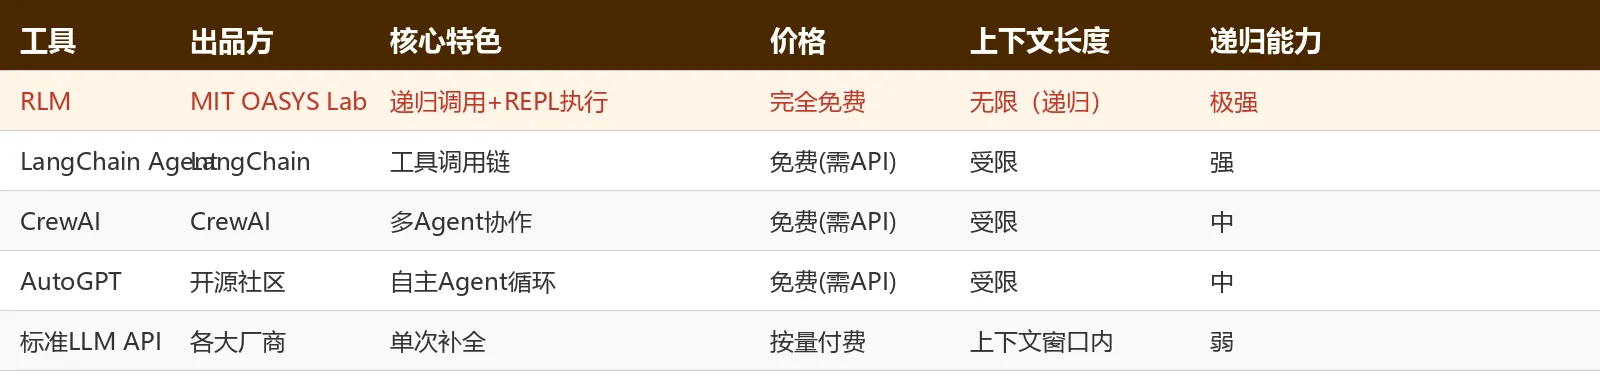
📊 与竞品对比
💡 适用场景
📄 超长文档处理
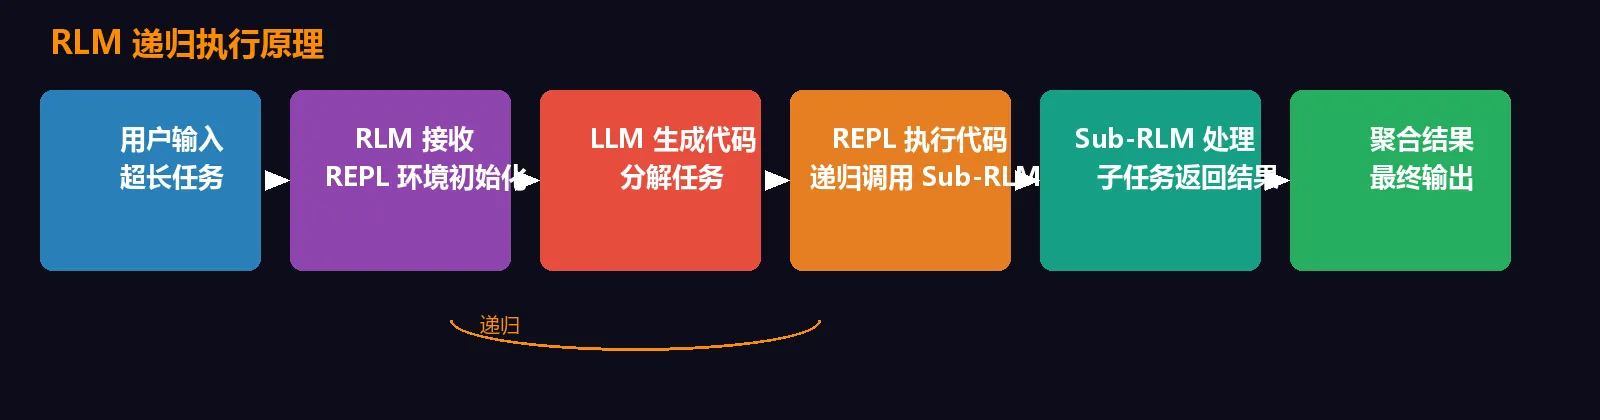
功能说明:传统 LLM 受限于 Context Window(即使是 128K 也不够处理完整的法律合同、学术文献或代码库),RLM 通过递归分解,让 LLM 自主决定如何拆分和处理超长任务。
输入要求:任意长度的文本任务,通过 rlm.completion(task_description) 输入。
输出效果:LLM 会自动将大任务分解为多个子任务,递归处理每个子任务后合并结果,最终返回完整输出。
适用场景:百页 PDF 分析、大型代码库理解、超长会议记录整理。
🔁 复杂多步骤任务
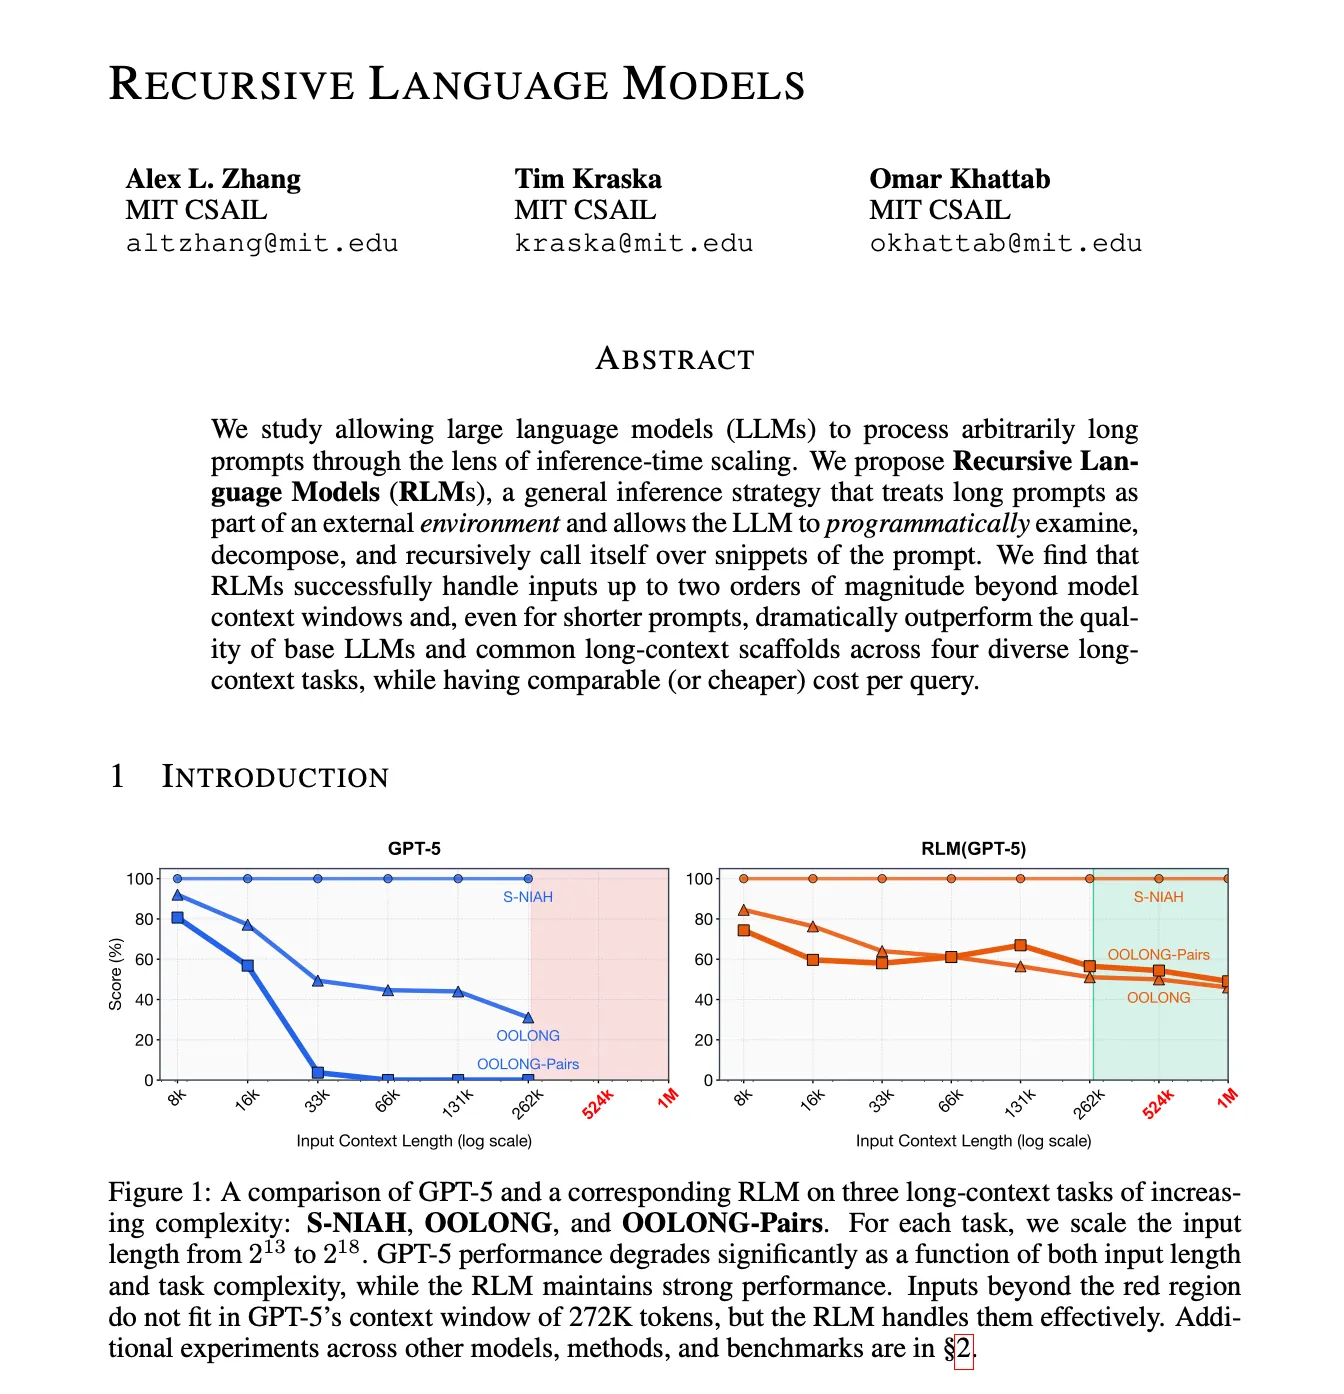
功能说明:对于需要多轮迭代推理的任务(如数学推导、代码调试、数据分析),RLM 可以让 LLM 在 REPL 中自主执行代码、观察结果、调整策略,实现真正的自主推理循环。
输入要求:描述清晰的多步骤任务,无需手动分解。
输出效果:LLM 自主完成"思考→代码生成→执行→观察→再思考"的完整推理循环,直到任务完成。
适用场景:数学竞赛题求解、复杂数据分析管道、自动化测试生成。
🖥️ 可视化调试界面
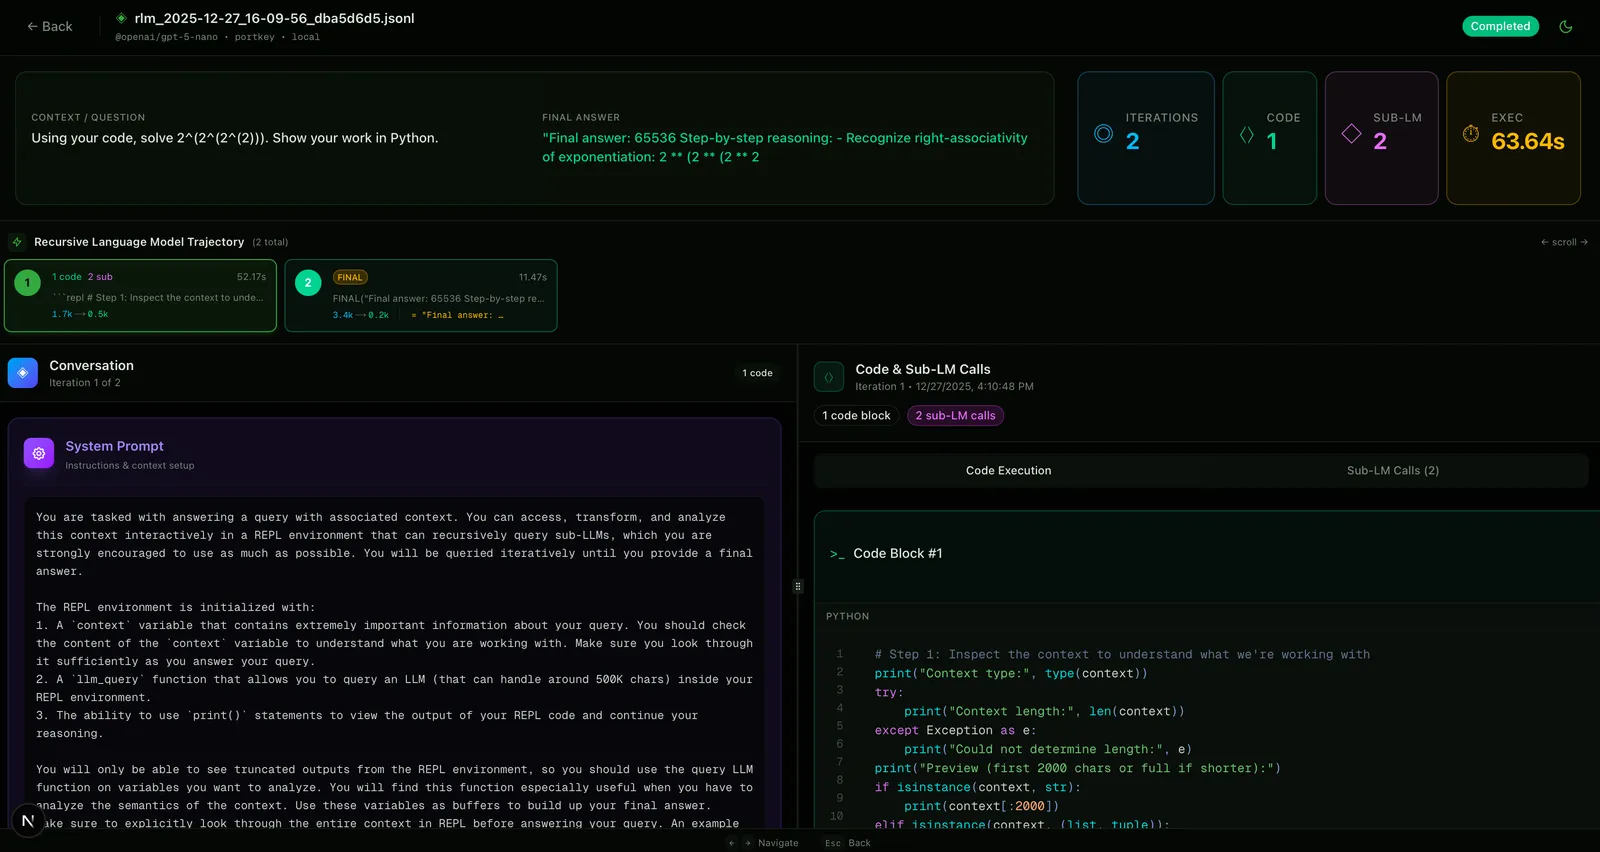
功能说明:Visualizer 提供 Web UI,可以直观地查看 RLM 的每一次递归调用、中间状态、代码执行结果,极大降低递归推理的调试难度。
输入要求:开启 log=True 参数运行 RLM,自动生成日志。
输出效果:可视化的递归调用树,每个节点展示 prompt、代码、执行结果。
适用场景:开发调试 RLM 应用、分析 LLM 推理过程、教学演示递归推理。
使用场景总结
- ✅ 超长文档研究:百页 PDF、大型代码库,传统 LLM 直接放弃的任务
- ✅ 复杂推理任务:数学/科学计算、多步骤数据分析
- ✅ 自主代码 Agent:需要 LLM 反复写代码、测试、迭代的工作流
- ✅ 成本敏感场景:支持本地 Ollama,零 API 费用运行
- ❌ 不适合:简单的单次问答任务(用普通 LLM 即可);需要极低延迟的实时对话(递归调用有额外延迟)
🌟 为什么 RLM 值得关注?
一行代码升级你的 LLM
RLM 最打动人的地方,是迁移成本极低。如果你现在在用 LangChain、直接调用 OpenAI API 或者 Ollama,只需要把 llm.completion() 换成 rlm.completion(),立刻获得递归能力。
MIT 学术背书 + arXiv 论文
RLM 不是一个"拍脑袋"的项目,背后有严肃的学术研究(arXiv:2512.24601)。MIT OASYS Lab 专注于 AI 系统和推理,这意味着代码质量和理论基础都有保障。
多沙箱保障安全执行
LLM 在 REPL 中执行代码是有安全风险的——RLM 原生支持 Docker、Modal、e2b 等 6 种沙箱环境,生产环境下代码执行完全隔离,不会影响宿主机,可以放心部署。
开源生态蓬勃发展
4K Stars、700+ Forks,社区贡献活跃。项目文档完善,支持 make quickstart 一键体验,上手极快。
💰 定价方案
完全免费,MIT 开源协议
| 使用方式 | 成本 | 说明 |
|---|---|---|
| 本地 Ollama | 零费用 | 支持 llama、qwen 等本地模型 |
| OpenAI API | 按量付费 | GPT-4o-mini 单次调用费用极低 |
| Gemini API | 免费额度+按量 | Flash 系列有慷慨的免费额度 |
| 沙箱环境 | Modal/e2b 各自计费 | 本地 Docker 沙箱免费 |
💡 推荐配置:本地 Ollama + Docker 沙箱,完全零成本、完全隔离,适合本地研究和开发测试。
开源协议: MIT License
🎯 总结
RLM 代表了一种新的 LLM 使用范式——不再把 LLM 当成"填空机器",而是赋予它递归分解和自主执行的能力。
如果你曾经因为上下文窗口不够而放弃某个 LLM 应用场景,RLM 值得你认真试试。它不是概念玩具,有 MIT 的学术背书,有 700+ Forks 的社区验证,有完善的沙箱支持——一行代码的迁移成本,换来近乎无限的上下文能力。
推荐指数: ⭐⭐⭐⭐⭐(满分5星)
适合人群: 需要处理超长文档的工程师、AI Agent 开发者、LLM 研究人员
立即体验: pip install rlms
GitHub 仓库: alexzhang13/RLM
数据截至 2026-04-26,最新信息请以官网为准。