🔥 CocoIndex:AI Agent 的实时增量数据引擎
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../cocoindex-recommend.pptx../../cocoindex-recommend.mp4本文目录
🔥 CocoIndex:AI Agent 的实时增量数据引擎
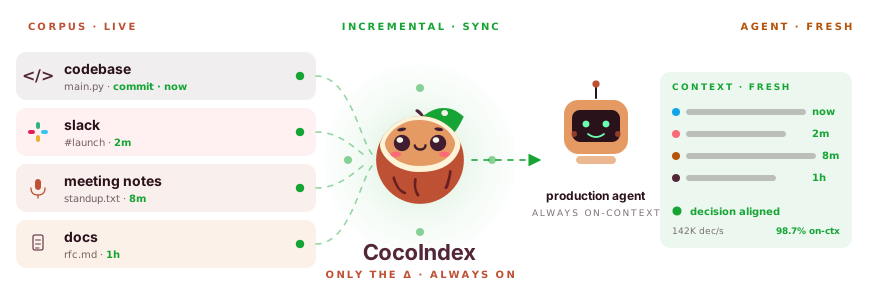
将代码库、会议记录、收件箱、Slack、PDF 和视频转化为实时、持续更新的上下文,为 AI 助手和 LLM 应用提供新鲜数据——仅需处理增量变化。
🚀 什么是 CocoIndex?
CocoIndex 是一个增量数据同步引擎,专为长周期 AI Agent 设计。它的核心使命很明确:让你的 AI Agent 永远拥有最新鲜的上下文,而无需重复处理 99.9% 的已知数据。
想象一下这个场景:你的 RAG 系统索引了公司 10 万份文档,每天新增 100 份。传统方案需要重新嵌入全部 10 万份,而 CocoIndex 只处理新增的 100 份——这才是真正意义上的"增量"。


核心定位:面向生产环境的增量数据处理框架,实现毫秒级新鲜度,成本降至传统的 1/10
✨ 核心功能一览
CocoIndex 的架构设计借鉴了 React 的响应式思想:声明目标状态,引擎自动保持一致性。

核心价值
| 特性 | 说明 | 技术亮点 |
|---|---|---|
| Sub-second Fresh | 更改 1 秒内传播到目标 | 流式处理架构 |
| 10× 更便宜 | 仅重处理 0.1% 变更 | 智能缓存 + 增量计算 |
| Explainable | 100% 数据溯源 | 端到端追溯每个字节 |
| Production-Ready | Rust 核心,自动重试 | 指数退避、死信队列 |
支持的连接器
8 种数据源:
- Codebases(代码库)
- Meeting Notes(会议记录)
- Web APIs
- File System / Blob Stores
- Databases
- Message Queues
- Images / Video
- Voice / Transcripts
6 种目标存储:
- Relational DB(关系型数据库)
- Data Warehouse(数据仓库)
- Vector DB(向量数据库)
- Graph DB(图数据库)
- Message Queue(消息队列)
- Feature Store(特征存储)
核心优势:Δ-only 增量处理,相比全量计算降低 99.9% 的 LLM 调用
🛠️ 快速上手:5 分钟跑通示例
安装
pip install -U cocoindex
核心代码示例
import cocoindex as coco
from cocoindex.connectors import localfs, postgres
from cocoindex.ops.text import RecursiveSplitter

# 声明转换函数(自动缓存)
@coco.fn(memo=True)  # 按哈希 (input) + 哈希 (code) 缓存
async def index_file(file, table):
    for chunk in RecursiveSplitter().split(await file.read_text()):
        table.declare_row(
            text=chunk.text,
            embedding=embed(chunk.text)
        )

# 主流程
@coco.fn
async def main(src):
    table = await postgres.mount_table_target(
        PG, table_name="docs"
    )
    table.declare_vector_index(column="embedding")
    await coco.mount_each(
        index_file,
        localfs.walk_dir(src).items(),
        table
    )

# 运行应用 - 增量更新
coco.App(
    coco.AppConfig(name="docs"),
    main,
    src="./docs"
).update_blocking()
工作原理:
- 首次运行:全量回填数据
- 重新运行时:仅重新嵌入已更改的文件
- 文件未变:直接从缓存读取,0 计算
注意:@coco.fn(memo=True) 是实现增量缓存的关键,自动按内容哈希跳过未变更的处理
📊 应用场景对比
| 场景 | 传统 RAG | CocoIndex | 提升 |
|---|---|---|---|
| 数据新鲜度 | 小时级批量 | 亚秒级实时 | 100× |
| 增量更新成本 | 全量重处理 | 仅处理 Δ | 1000× |
| 数据溯源 | 困难 | 100% 可追溯 | 🆕 |
| 生产可靠性 | 手动重试 | 自动重试 | 🆕 |
| LLM 调用次数 | 每次都全量 | 99.9% 缓存命中 | 10× |
💡 20+ 示例项目类型
1. Code Embedding:实时代码索引

功能说明:对代码库进行增量索引,支持 AST 分块,自动处理文件变更
典型应用:代码问答系统、智能代码补全、跨文件依赖分析
2. PDF RAG:文档智能问答
功能说明:经典 RAG 堆栈,支持 PDF 解析、分块、嵌入,增量更新
典型应用:技术文档问答、合同审查助手、政策法规查询
3. HN Trending Topics:话题提取与排名
功能说明:实时分析 Hacker News,提取热门话题并排名
典型应用:趋势监控、市场情报、社区运营
4. Conversation → Knowledge Graph:对话转知识图谱
功能说明:从会议记录、Slack 对话中提取知识实体和关系
典型应用:企业知识管理、项目关系追踪、智能搜索增强
5. Multi-repo Summarization:多仓库总结
功能说明:跨多个代码仓库生成总结报告,增量刷新
典型应用:开源项目监控、企业代码治理、技术雷达生成
6. Structured Extraction:结构化提取
功能说明:从表单、PDF 中提取结构化数据,支持 BAML/DSPy
典型应用:发票处理、简历解析、医疗记录数字化
👥 用户群体
- ✅ AI 应用开发者:需要实时数据的新鲜度
- ✅ ML 工程师:构建生产级 Agent 系统
- ✅ 数据工程师:实时 ETL 管道建设
- ✅ 科研团队:论文、文档的持续索引
- ❌ 不适合:一次性批处理任务
💰 定价与开源
开源版本:
- 协议:Apache-2.0
- 功能:完整核心功能
- 社区支持:Discord、GitHub Issues
企业版特性:
- PB 级语料库支持
- 10× 更少的 LLM 调用
- 100% 数据溯源
- 专属技术支持
💡 新用户福利:完全开源免费,可自托管到 PB 级规模
🔗 相关链接
- 官网:https://cocoindex.io
- 文档:https://cocoindex.io/docs
- Discord:https://discord.com/invite/zpA9S2DR7s
- 博客:https://cocoindex.io/blogs/
- YouTube:@cocoindex_io
🎯 总结
CocoIndex 是React for Data Engineering理念的完美实践:声明你期望的目标状态,引擎负责保持与最新源数据同步。相比传统的批处理 ETL,它带来了:
- 1000× 的增量更新效率提升
- 10× 的 LLM 调用成本降低
- 亚秒级 数据新鲜度保证
如果你正在构建需要实时上下文的 AI Agent、RAG 系统或数据管道,CocoIndex 是一个值得认真考虑的 production-ready 选择。
推荐指数:⭐⭐⭐⭐⭐(满分 5 星)
适合人群:需要实时数据更新的 AI 开发者、ML 工程师、数据工程师
立即体验:GitHub 仓库 | 官方文档 | Discord 社区
数据截至 2026-05-06,最新信息请以官网为准。