Wan2.2
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../Wan2.2-recommend.pptx../../Wan2.2-recommend.mp4本文目录
**📌 核心价值:阿里通义万相实验室开源的视频生成大模型,首次将 MoE 混合专家架构引入视频扩散模型,让消费级 GPU(24GB RTX 4090)也能跑出 720P@24fps 电影级视频
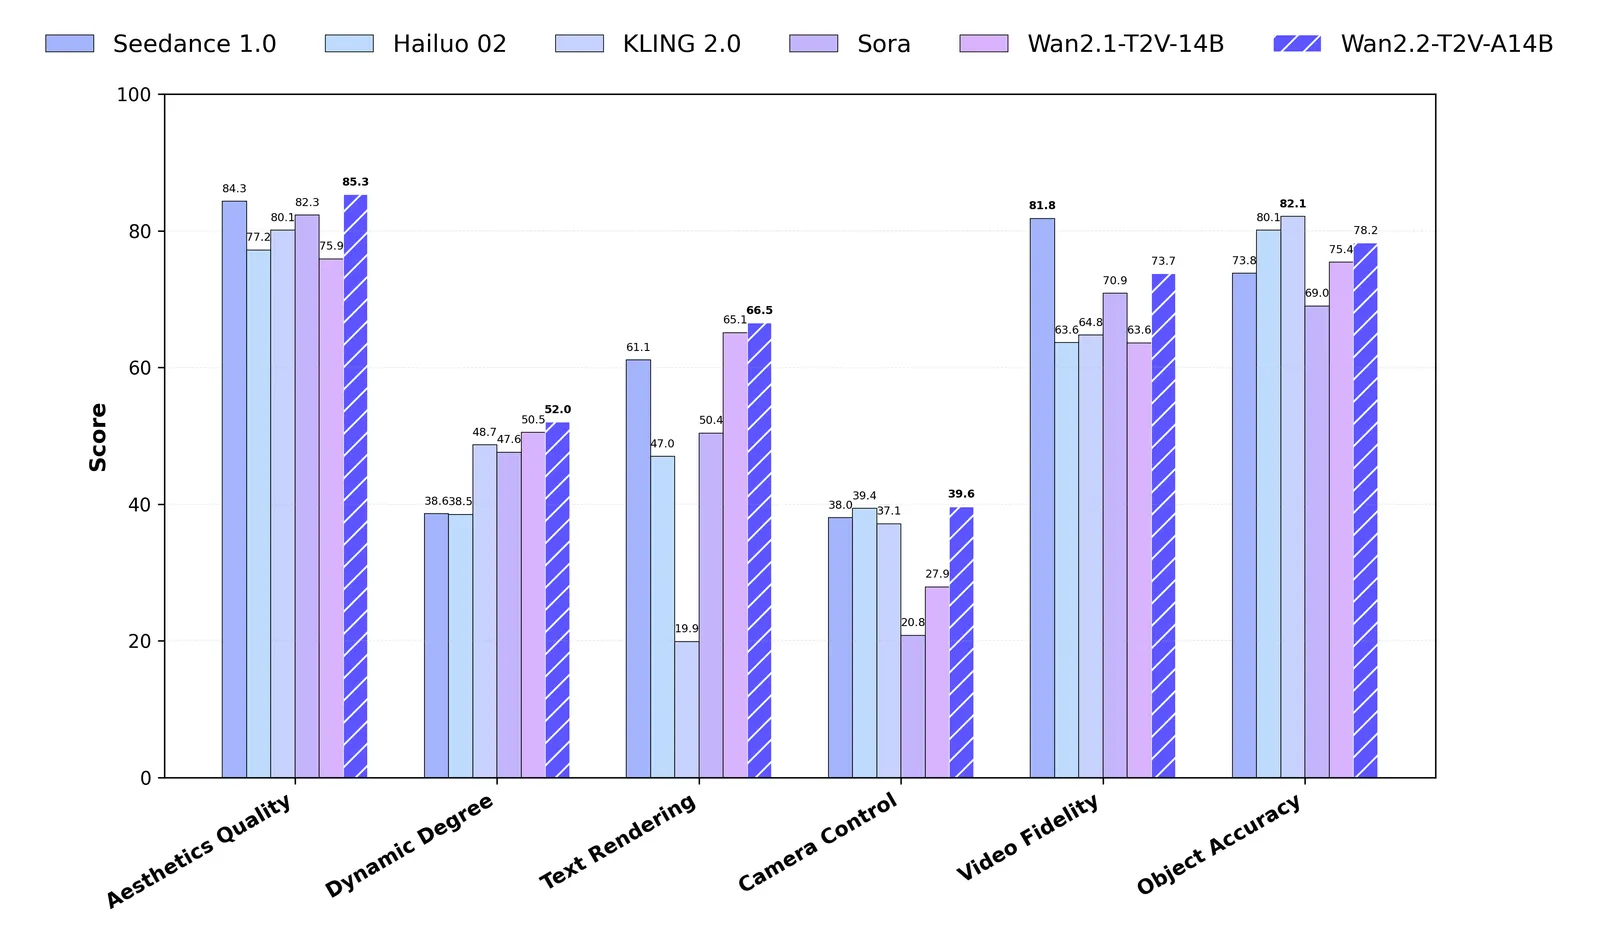
Wan2.2 不是单一模型,而是覆盖「文生视频 / 图生视频 / 语音生视频 / 角色动画」的5 模型矩阵,在 Wan-Bench 2.0 与 VBench 上多项指标超越 Sora、Runway Gen-3 等闭源方案。Apache 2.0 协议,模型权重与推理代码全部开源。
🚀 什么是 Wan2.2?
Wan2.2 是阿里巴巴通义万相实验室于 2025 年 7 月正式开源的下一代视频生成大模型,论文同步发表于 arXiv(2503.20314)。相比 Wan2.1,Wan2.2 在四个维度进行了重大升级:
- MoE 混合专家架构:将去噪过程拆分为「高噪声专家(负责整体布局)」与「低噪声专家(负责细节优化)」,总参数 27B 但每步仅激活 14B,实现"容量翻倍而计算成本不变"
- 电影级美学控制:标注 60+ 美学参数(光照 / 构图 / 色调 / 对比度),支持精确的电影镜头语言
- 复杂运动生成:训练数据 +65.6% 图像、+83.2% 视频,运动连贯性与物理合理性显著提升
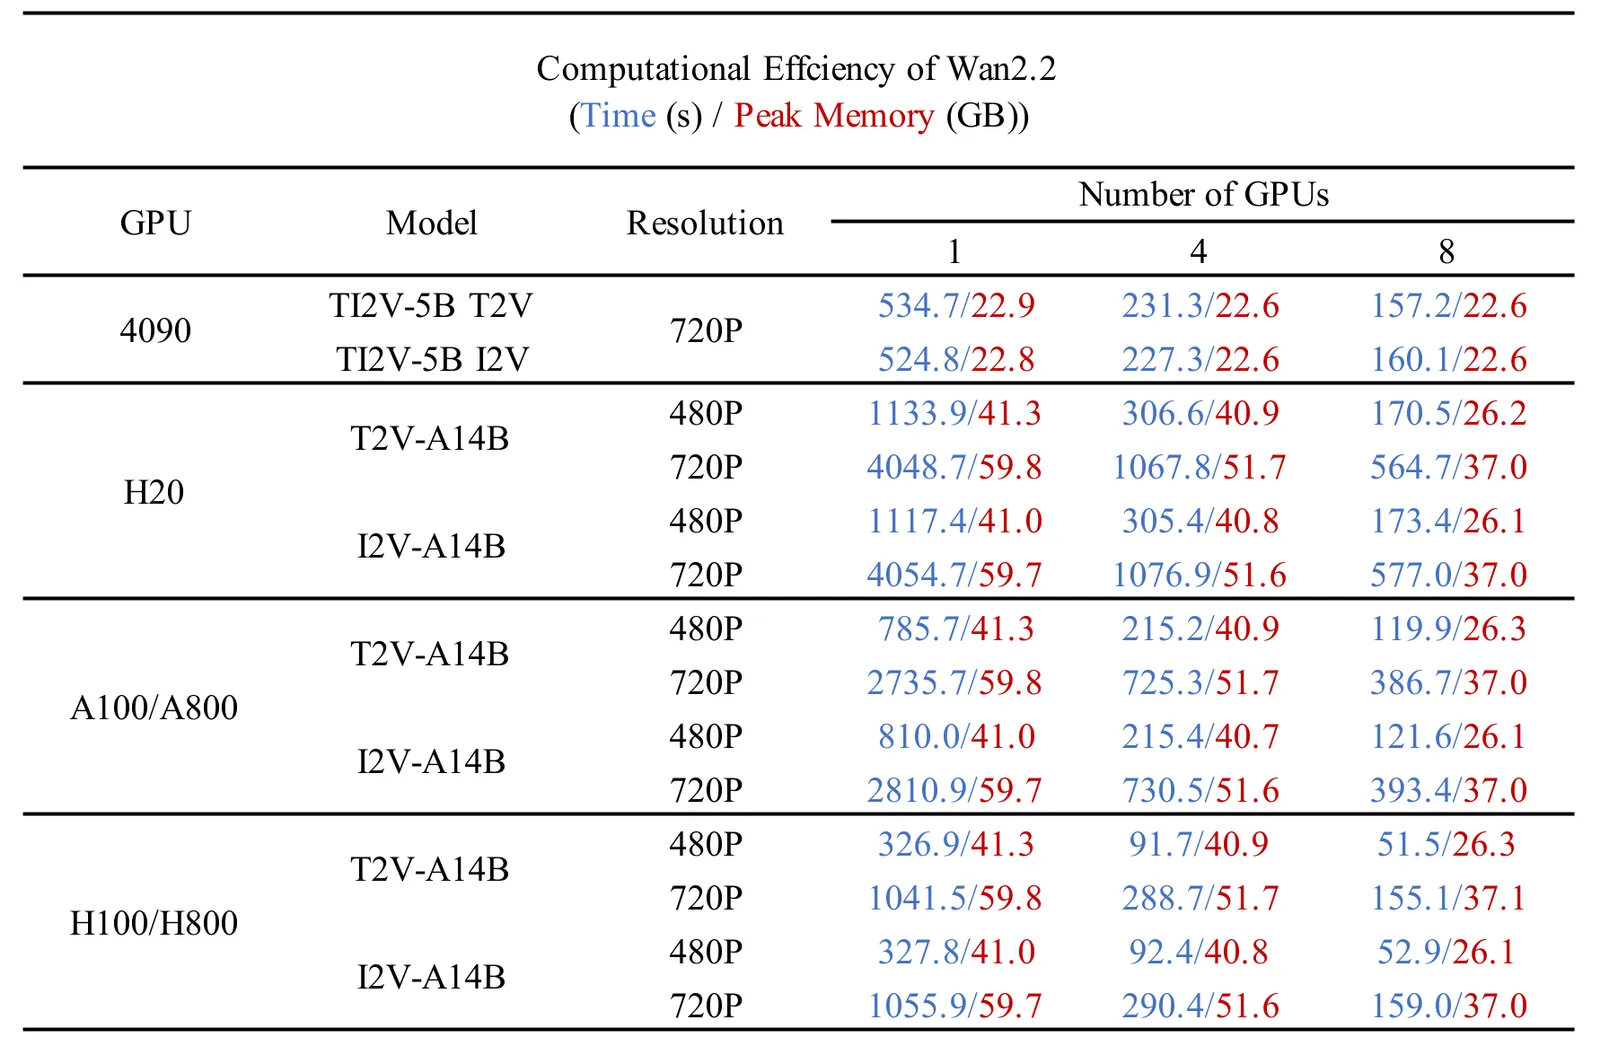
- Wan2.2-VAE 高压缩:16×16×4 时空压缩比,单卡 4090 24GB 即可在 9 分钟内生成 5 秒 720P 视频
核心定位:开源界唯一同时支持 T2V/I2V/S2V/Animate 四大视频任务、且在 VBench 上 89.7 分超越 Sora 1.0 的视频生成全家桶
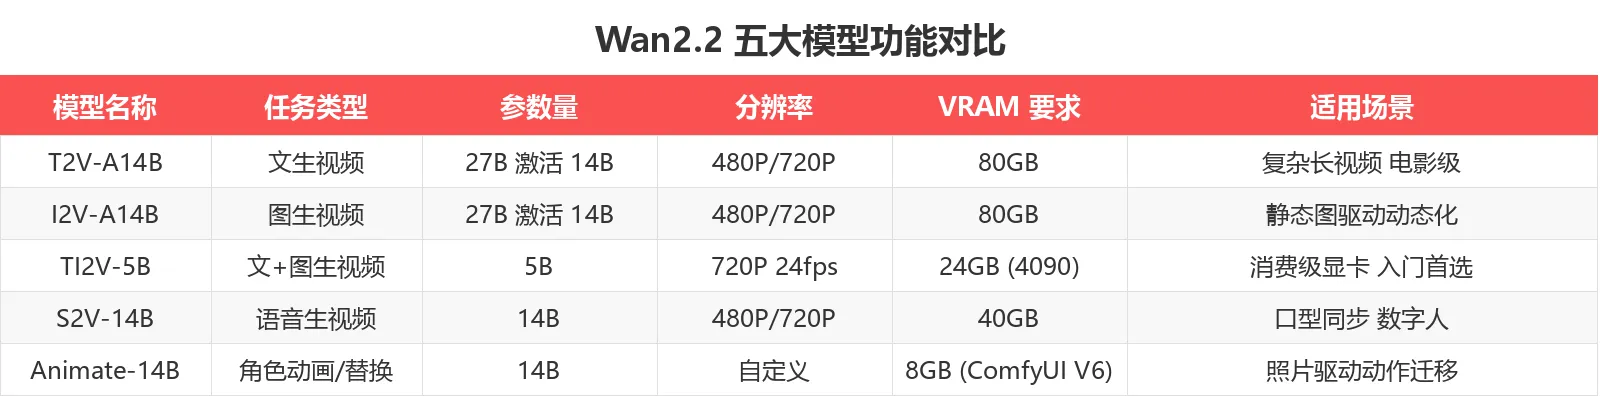
✨ 五大模型矩阵一览
🛠️ 5 分钟跑通:Wan2.2-TI2V-5B 快速上手
环境准备
# 1. 克隆仓库
git clone https://github.com/Wan-Video/Wan2.2.git
cd Wan2.2

# 2. 安装依赖(需 torch >= 2.4.0)
pip install -r requirements.txt

# 3. 下载模型权重(推荐 HuggingFace)
pip install "huggingface_hub[cli]"
huggingface-cli download Wan-AI/Wan2.2-TI2V-5B --local-dir ./Wan2.2-TI2V-5B
一行命令生成 720P 视频(消费级 4090 即可跑)
python generate.py \
  --task ti2v-5B \
  --size 1280*704 \
  --ckpt_dir ./Wan2.2-TI2V-5B \
  --offload_model True --convert_model_dtype --t5_cpu \
  --prompt "Two anthropomorphic cats in comfy boxing gear and bright gloves fight intensely on a spotlighted stage"
⚡ 速度对比:同 prompt 下,Wan2.2-TI2V-5B 在 4090 单卡 9 分钟生成 5 秒 720P@24fps 视频,比同类开源模型(典型 30+ 分钟)快 3 倍以上
Python API 调用(Diffusers 集成)
import torch
from diffusers import WanPipeline
from diffusers.utils import export_to_video

# 加载 5B 轻量模型
pipe = WanPipeline.from_pretrained(
    "Wan-AI/Wan2.2-TI2V-5B",
    torch_dtype=torch.float16
).to("cuda")

# 启用显存优化
pipe.enable_model_cpu_offload()

# 文+图生视频
output = pipe(
    prompt="A cat walking gracefully on a wooden floor, cinematic lighting, 4k",
    num_frames=81,           # 5 秒 @ 24fps 减 1 帧
    height=704, width=1280,
    num_inference_steps=30,
    guidance_scale=7.5
).frames[0]

export_to_video(output, "cat_walking.mp4", fps=24)
🧠 MoE 架构:参数翻倍,计算量不变
Wan2.2 的最大技术创新是首次将 Mixture-of-Experts(混合专家)架构 引入视频扩散模型。
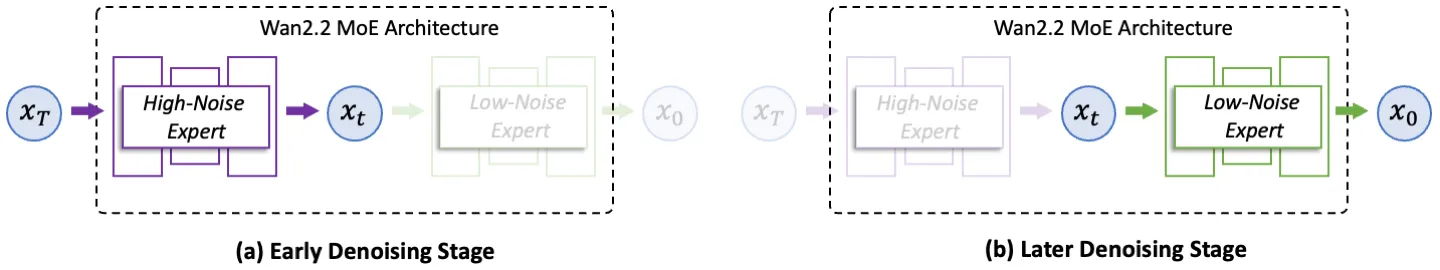
传统视频生成模型对所有时间步都用同一套参数去噪——早期步骤(高噪声)需要的是"整体构图能力",后期步骤(低噪声)需要的是"细节优化能力",这其实是两种完全不同的能力要求。
Wan2.2 通过信噪比(SNR)阈值 t_moe 切换两个专家:
- 高噪声专家(早期):负责视频整体布局、动作轨迹
- 低噪声专家(后期):负责人脸细节、纹理、光影
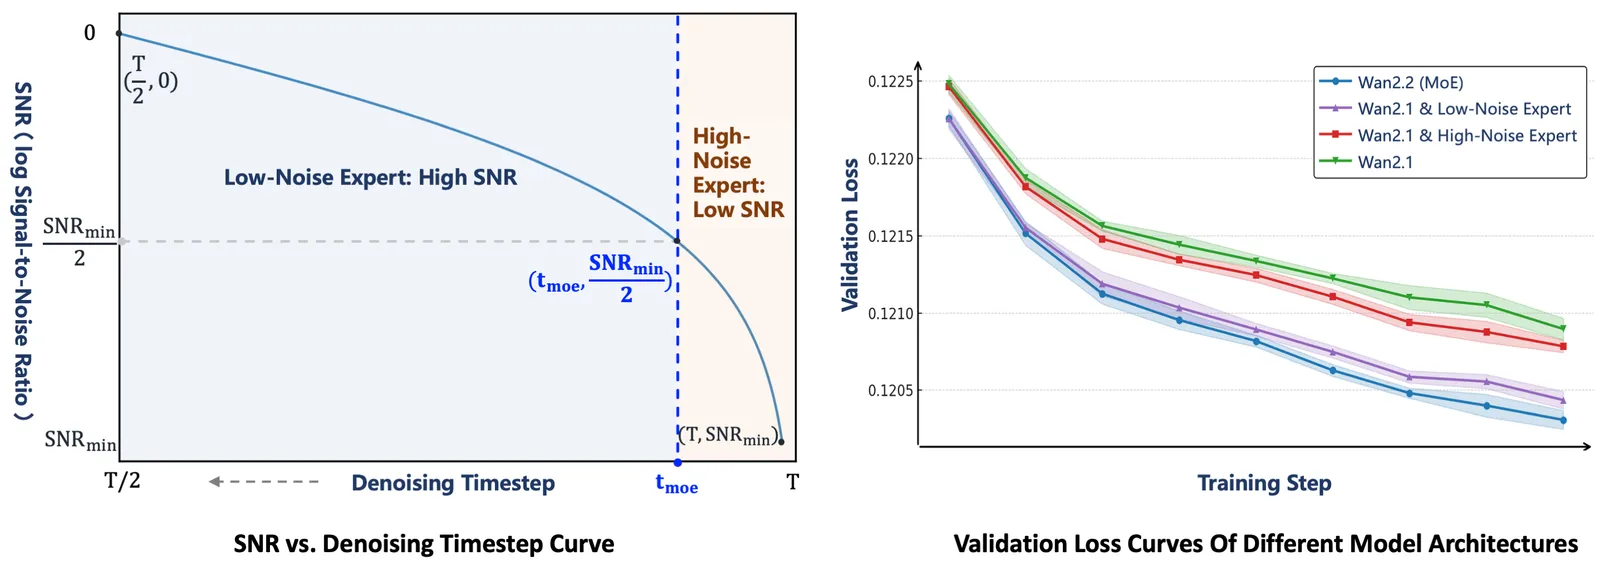
实测效果:14B 激活参数的 MoE 模型,生成质量接近 27B 单体模型,但 VRAM 占用仅需 80GB 而非 200GB+
💡 四大核心场景
场景 1:文生视频(T2V-A14B)
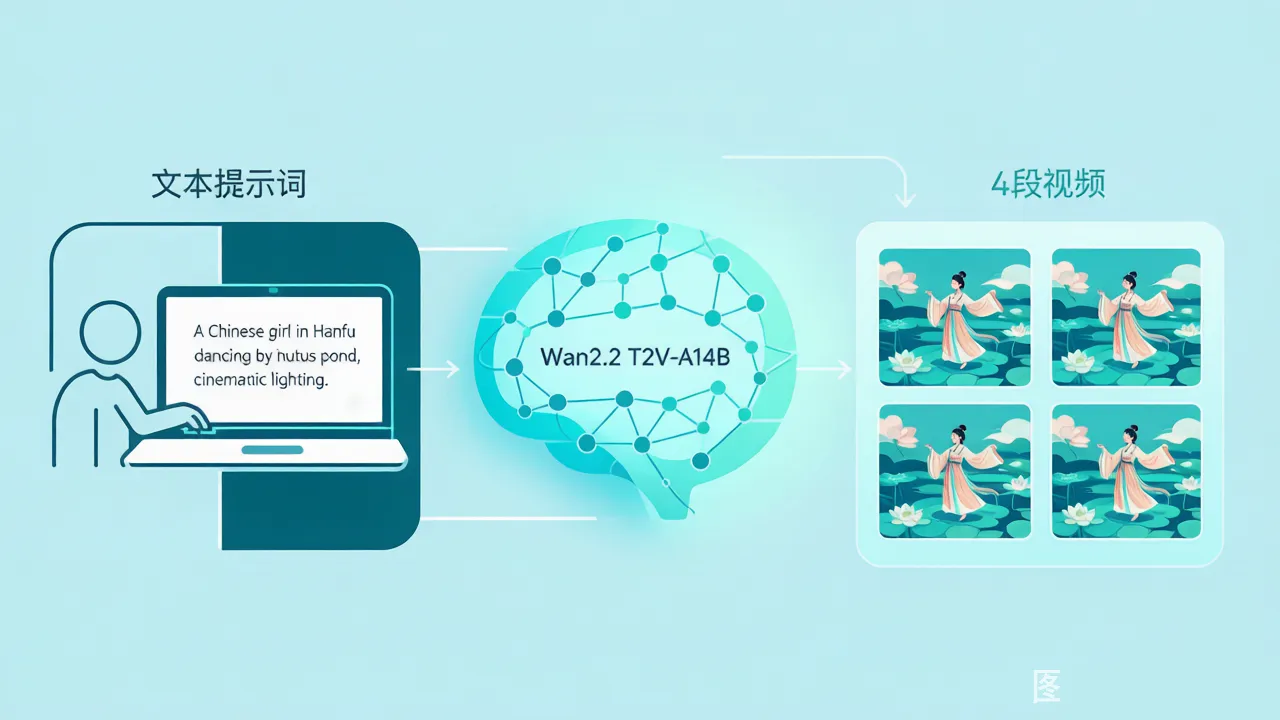
功能说明:输入一段中文/英文文字描述,Wan2.2 自动生成 5 秒 720P 视频。
输入要求:
- 提示词建议 30-80 字,包含「主体 + 动作 + 环境 + 风格」
- 中文支持原生优化(其他模型中文表现差)
输出效果:
- 720P@24fps 5 秒 MP4
- 复杂动作如人体后空翻可精准还原
- 美学参数可精确控制(黄金分割构图 / 逆光剪影 / 青绿山水色调)
适用场景:
- 短视频创作者:1 段文字 = 1 段 5 秒爆款片段
- 广告公司:概念片 / 创意 demo 零成本试错
- 教育/科普:抽象概念可视化
Prompt 模板:
[主体] + [动作] + [环境/光线] + [摄影机] + [风格]
"A Chinese girl in Hanfu dancing by a lotus pond, 环绕运镜+青绿山水色调, cinematic lighting, 8k"
场景 2:图生视频(I2V-A14B)
功能说明:上传 1 张静态图片(人物 / 风景 / 商品图),生成让图片"动起来"的视频。
输入要求:
- 图片清晰无遮挡,建议正方形或 16:9
- 可选附加运动提示词(控制镜头方向、动作幅度)
输出效果:
- 保留原图细节(人脸、构图、风格)
- 自然运动(头发飘动、衣服褶皱、眼神流转)
- 与原图完全一致的角色身份
适用场景:
- 电商商品图 → 30 秒商品展示视频
- 老照片修复 + 动态化
- 动漫角色立绘 → 动态漫片段
- 影视分镜快速预览
实测案例(来自掘金作者「马克学ai」):
上传「办公室工位自拍」+ 网红手势舞视频 → 生成的画面里你依然坐在工位上,但双手会精准跟着手势舞节奏动,背景还是你熟悉的键盘和绿植。
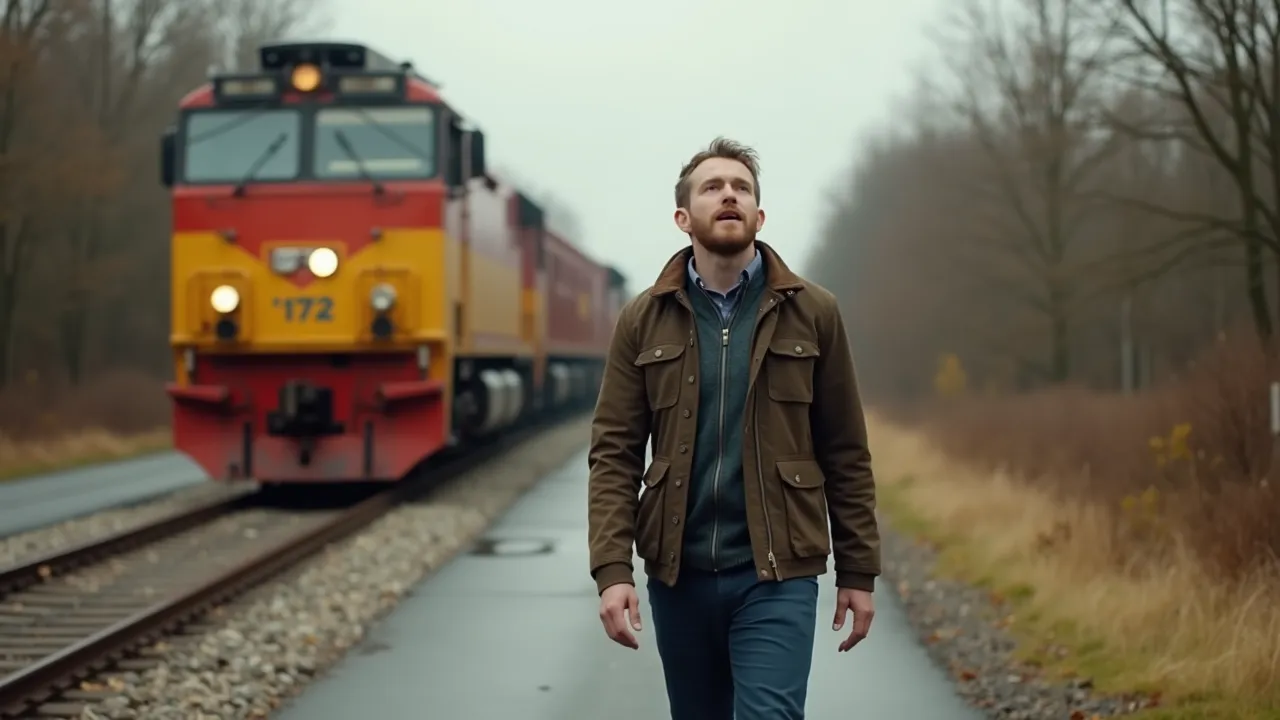
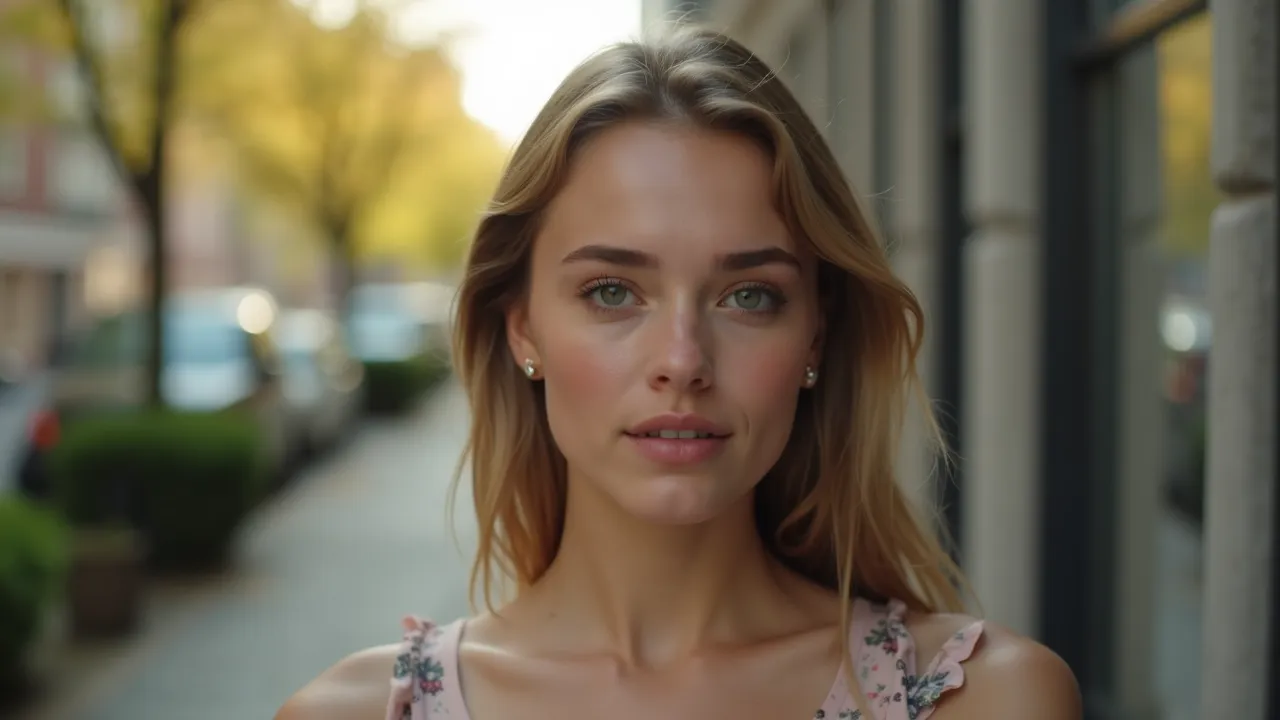
场景 3:语音生视频(S2V-14B)
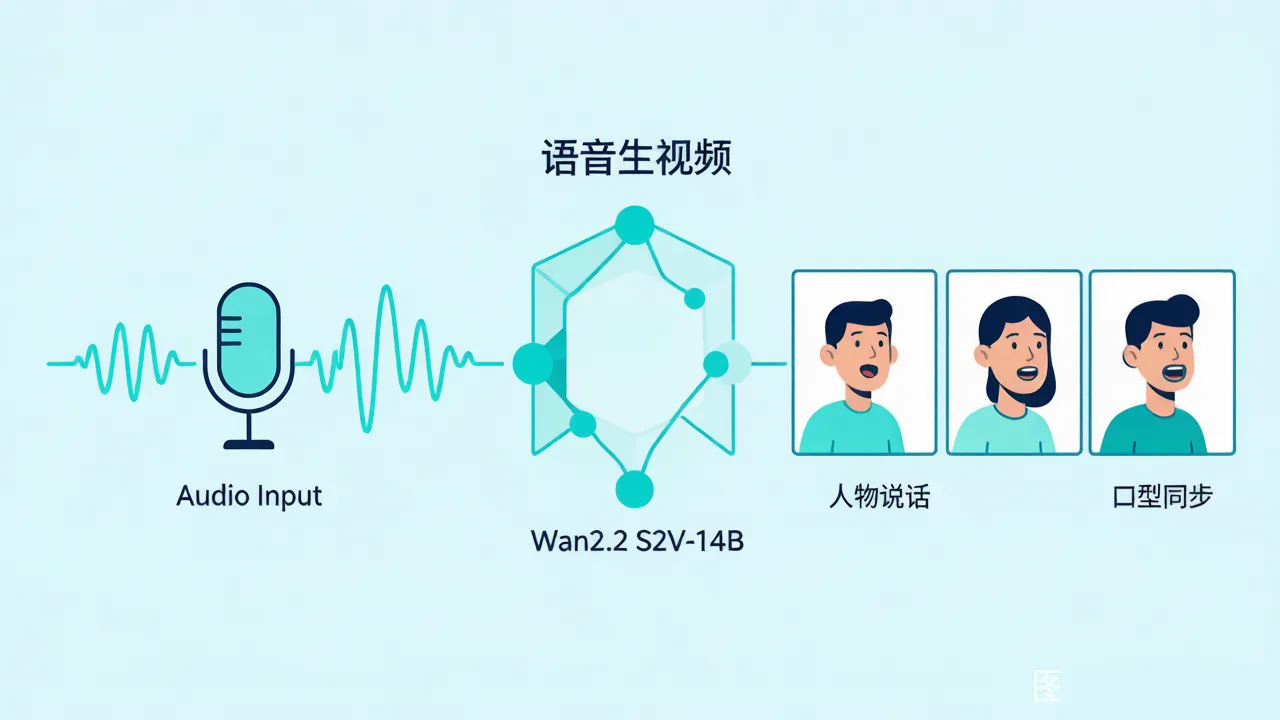
功能说明:上传 1 张人像 + 1 段音频(WAV/MP3),生成说话/唱歌的动态视频。
输入要求:
- 人像正面照,嘴部清晰
- 音频建议 5-30 秒,单人说话或唱歌
- 可选参考姿态(控制头部动作幅度)
输出效果:
- 口型精准同步(Wan2.2-S2V 的核心优势)
- 表情自然(眨眼、眉动、嘴角变化)
- 支持中英日韩多语言
适用场景:
- 数字人 / 虚拟主播
- 配音视频批量生成
- 历史人物"复活"讲解
场景 4:角色动画与替换(Animate-14B)
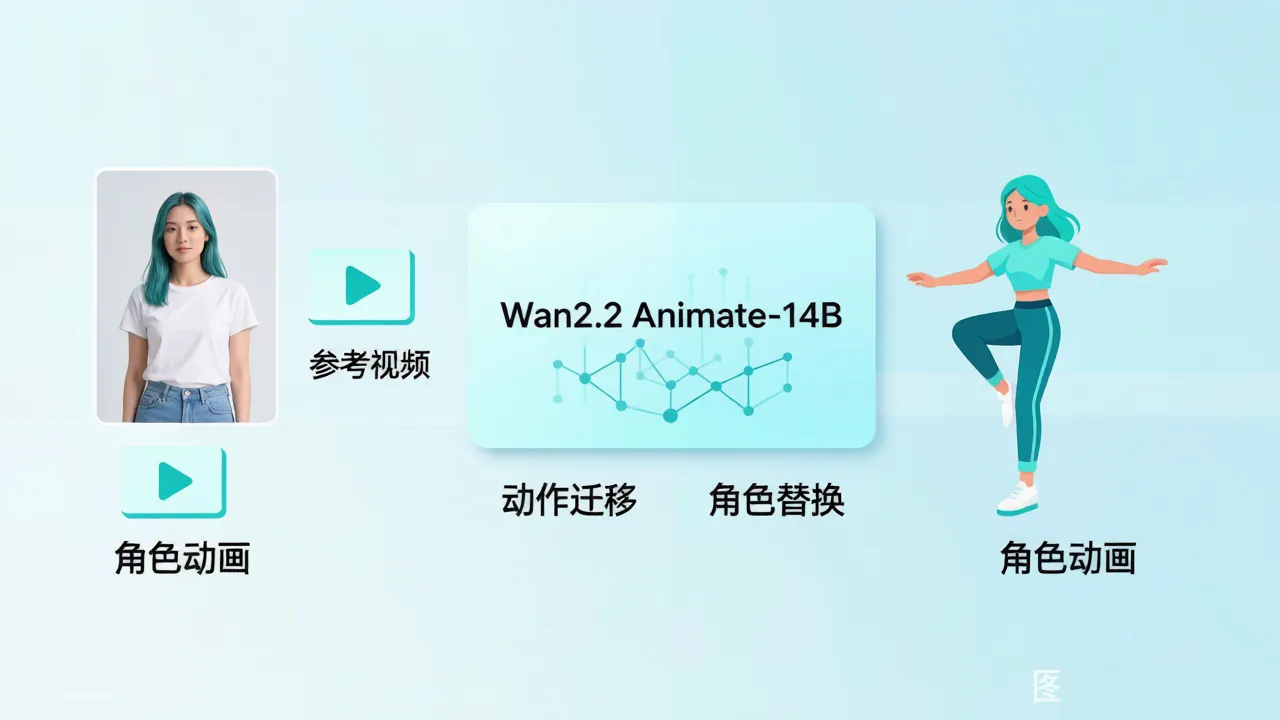
功能说明:单模型同时支持「动作模仿(Move)」和「视频换人(Mix)」 两大需求——上传 1 张照片 + 1 段参考视频即可实现。
核心模式:
- Move 模式:保留照片原背景,让照片角色跟着参考视频动
- Mix 模式:保留参考视频的场景/动作/光线,把角色换成照片里的人
输入要求:
- 照片:正面单人,人脸清晰无遮挡
- 参考视频:建议 ≤ 30 秒,动作明确
输出效果:
- 动作复刻、表情同步、光照匹配
- 头发丝反光 / 衣服光影都自动调整
- 比传统 AI 换脸工具真实 10 倍
适用场景:
- 短视频创作:用自己照片复刻热门舞蹈(《科目三》/手势舞),轻松蹭流量
- 影视后期:特技演员替换、特效补拍,省几十万成本
- 游戏/动漫:让静态角色立绘跟着参考视频动,不用动画师逐帧绘制
部署门槛极低:ComfyUI V6 版本最低 8GB 显存就能跑,生成 5 秒视频仅需 1 分钟,普通游戏本也能本地部署
📊 与主流开源视频模型对比
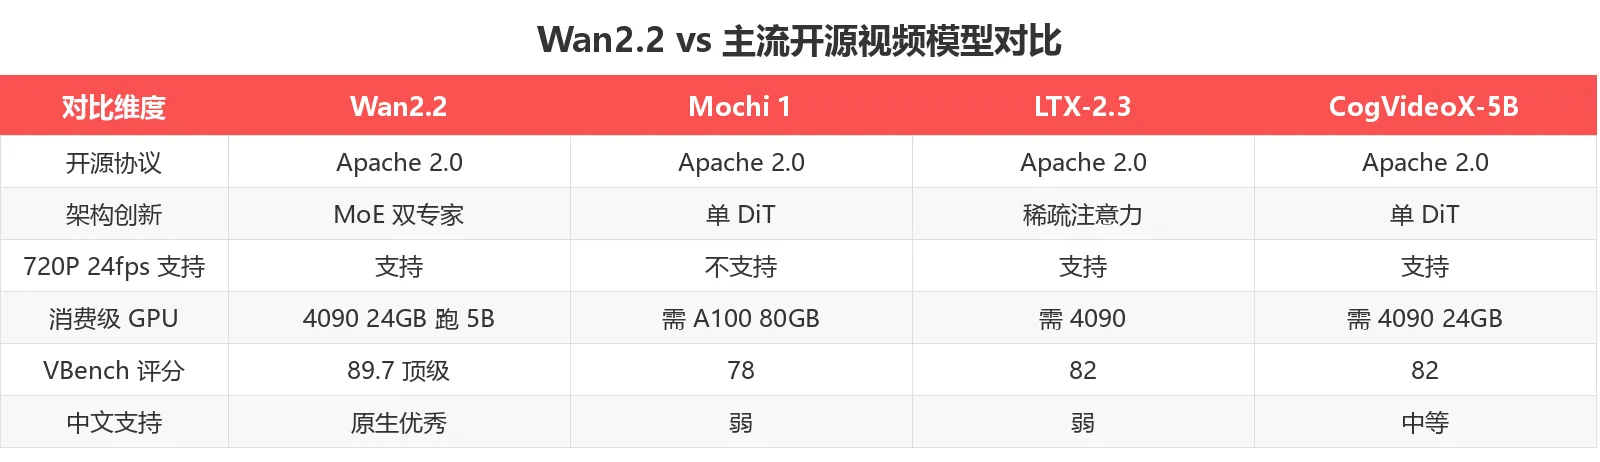
关键差异点:
| 维度 | Wan2.2 | 其他开源模型 |
|---|---|---|
| 架构 | MoE 双专家 | 单 DiT / 稀疏注意力 |
| VBench 评分 | 89.7(接近商业 Sora 1.0) | 78-82 |
| 训练数据 | +65.6% 图像 / +83.2% 视频 vs Wan2.1 | 增长有限 |
| 中文支持 | 原生优秀(阿里通义基座) | 弱/中等 |
| 消费级 GPU | 4090 24GB 可跑 5B | 多需 A100 80GB |
🏗️ Wan2.2-VAE:16×16×4 时空压缩
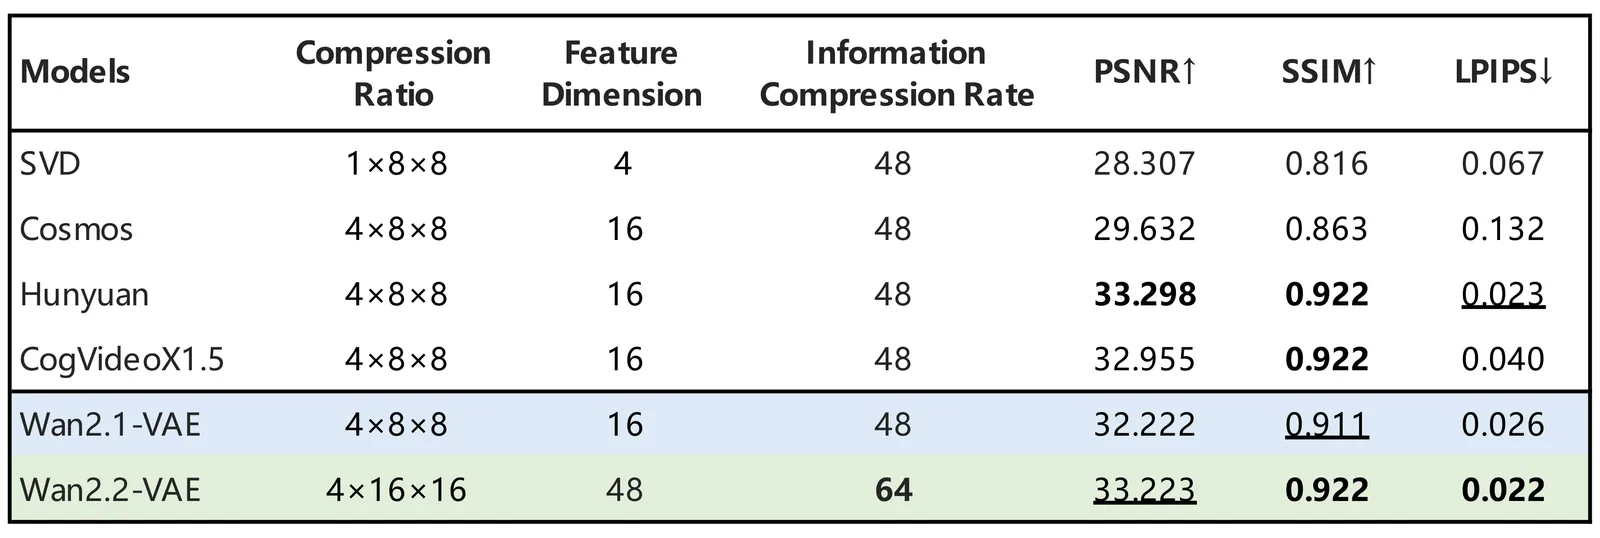
Wan2.2 配套开源了 Wan2.2-VAE——业界领先的高压缩视频自编码器:
- T×H×W 压缩比 4×16×16(含 patchification 后 4×32×32)
- 信息压缩率达 64 倍,大幅降低潜空间计算量
- 支持 480P / 720P 多分辨率
- 24GB 消费级 GPU 即可运行 TI2V-5B
相比同类 VAE 节省 60%+ 显存,是 Wan2.2 能在 4090 上跑的核心功臣
🌐 完整生态
Wan2.2 已形成完整的开源生态,被主流社区广泛集成:
| 生态项目 | 功能 |
|---|---|
| ComfyUI WanVideoWrapper(Kijai) | 节点式工作流,5 分钟搭好生成管线 |
| DiffSynth-Studio | 一体化 Diffusers 微调/推理框架 |
| LightX2V | 蒸馏加速,生成速度再提 50% |
| FastVideo | 稀疏注意力 + 蒸馏,5B 模型 1 分钟出 5 秒视频 |
| Cache-dit | 缓存优化,重复去噪步骤跳过 80% |
| HuMo | 多模态交互式视频生成 |
| Helios | 长视频一致性扩展 |
📦 在线体验
不想本地部署?直接用在线平台:
- 通义万相国内站(推荐国内用户):tongyi.aliyun.com/wan — 1 张照片 + 1 段参考视频,3 分钟出结果
- HuggingFace Spaces:huggingface.co/spaces/Wan-AI/Wan2.2-Animate — 支持最长 30 秒参考视频 + 4 种分辨率
🎯 总结
Wan2.2 是当前开源视频生成的天花板:
- 唯一覆盖 5 大视频任务(T2V / I2V / TI2V / S2V / Animate)的全家桶
- 唯一引入 MoE 架构的视频扩散模型
- 唯一在 VBench 89.7 接近商业 Sora 1.0 的开源方案
- 唯一原生支持中文的视频生成大模型
推荐指数: ⭐⭐⭐⭐⭐(满分 5 星)
适合人群:
- ✅ 短视频创作者(抖音 / TikTok / B 站)
- ✅ 广告创意 / 影视后期团队
- ✅ 数字人 / 虚拟主播开发者
- ✅ AI 视频生成研究者
- ✅ 游戏 / 动漫内容生产者
- ❌ 不适合:需要 4K 60fps 以上的专业影视级(仍推荐 Sora 2 / Veo 3)
立即体验:
- 🌐 官网:wan.video
- 📘 国内站:tongyi.aliyun.com/wan
- 💻 GitHub 仓库:Wan-Video/Wan2.2
- 🤗 HuggingFace:Wan-AI
- 📑 论文:arXiv:2503.20314
- 💬 Discord:AIGC 创作交流群
数据截至 2026-06-20,Star 数 16,293 / Fork 数 2,022,最新 commit 2026-03-17。最新信息请以 GitHub 仓库为准。