🔥 【今日推荐 VoxCPM2】:清华 OpenBMB 开源最强 TTS,无分词器架构颠覆语音合成!
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../VoxCPM2-recommend.pptx../../VoxCPM2-recommend.mp4本文目录
🔥 【今日推荐 VoxCPM2】:清华 OpenBMB 开源最强 TTS,无分词器架构颠覆语音合成!
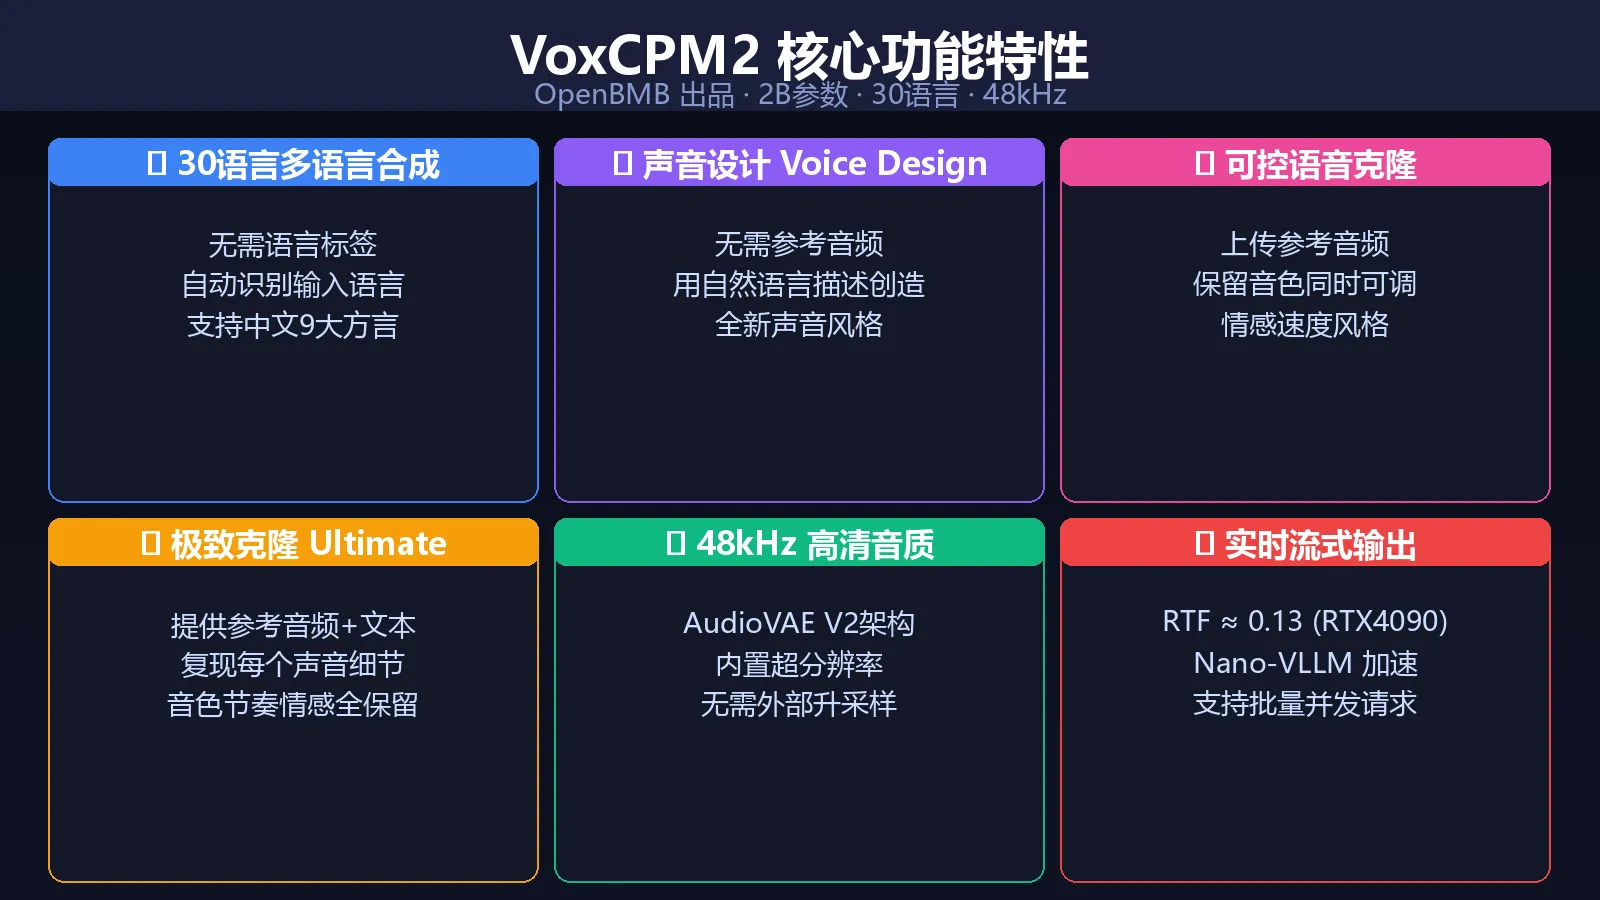
2B 参数、30 种语言、48kHz 高清输出、实时流式合成——OpenBMB 最新开源 TTS 模型 VoxCPM2,不仅能克隆任何声音,还能用一句话"凭空设计"出全新声线。


🚀 什么是 VoxCPM2?
VoxCPM2 是清华大学 OpenBMB 团队推出的下一代文本转语音(TTS)系统,也是目前 GitHub 上今日热度最高的开源语音 AI 项目之一(4 月 13 日新增 +1,278 Stars,总计 11,370+ ⭐)。
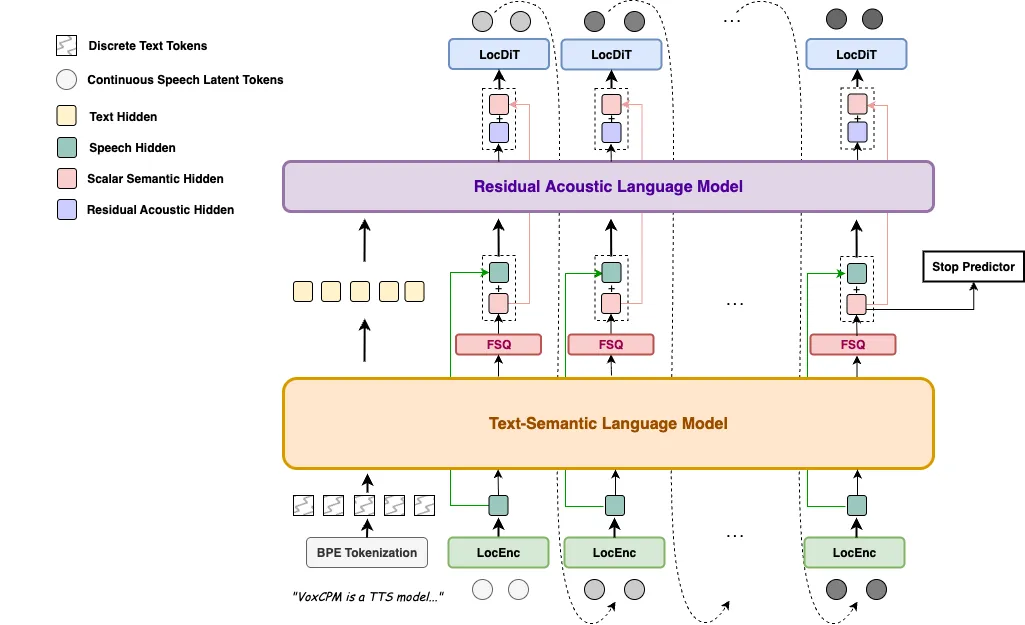
与传统 TTS 模型不同,VoxCPM2 采用无分词器(Tokenizer-Free)端到端扩散自回归架构,跳过离散 Token 化,直接在连续潜空间生成语音,彻底解决了传统方法中因 Token 压缩带来的音质损失和表达失真问题。
核心突破:2B 参数规模,训练于超过 200 万小时多语言语音数据,支持 30 种语言,48kHz 原生高清输出,RTF 低至 0.13——这是目前开源 TTS 领域的最强性能水平。
VoxCPM2 基于 MiniCPM-4 主干网络构建,采用 Apache-2.0 开源协议,可免费商用。
✨ 六大核心功能
🏗️ 端到端扩散自回归架构
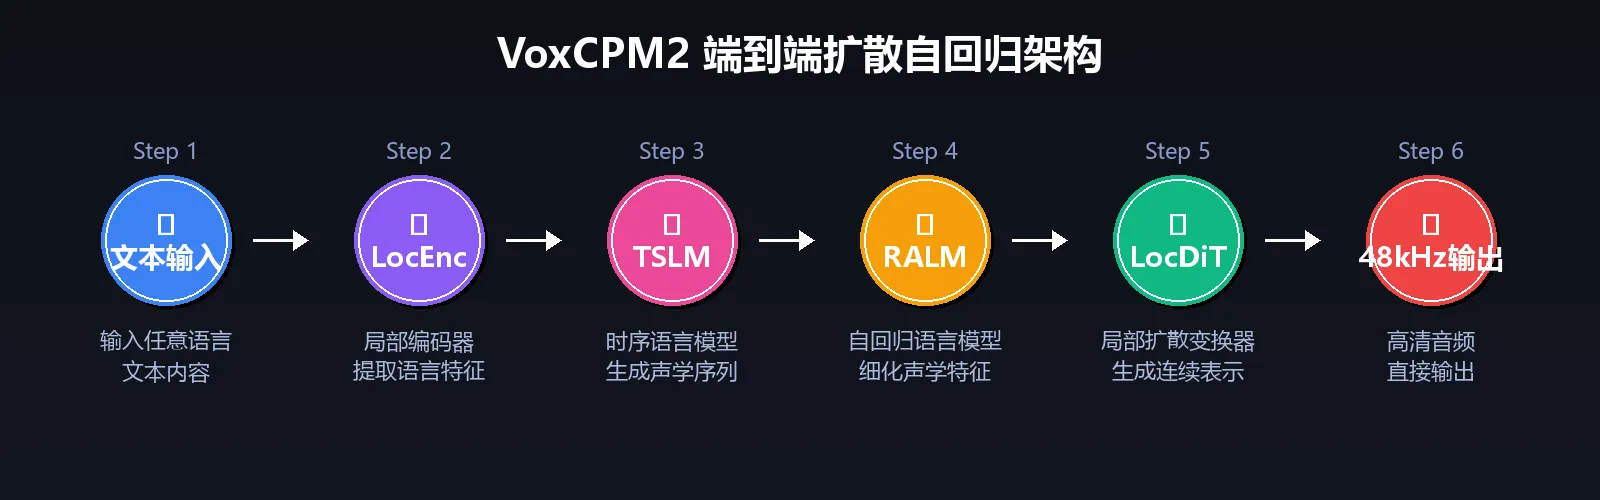
VoxCPM2 的核心架构由四个模块串联而成:
- LocEnc(局部编码器):提取输入文本的局部语言特征
- TSLM(时序语言模型):生成时间对齐的声学序列
- RALM(自回归语言模型):细化声学特征,增强表达力
- LocDiT(局部扩散变换器):通过扩散过程生成连续的 AudioVAE 表示
最终经 AudioVAE V2 非对称解码器直接输出 48kHz 音频,内置超分辨率,无需任何外部上采样器。
🛠️ 快速上手:5 分钟跑通完整示例
安装
pip install voxcpm
环境要求: Python ≥ 3.10(< 3.13),PyTorch ≥ 2.5.0,CUDA ≥ 12.0,显存 ≥ 8GB
基础 TTS 合成
from voxcpm import VoxCPM
import soundfile as sf

# 加载模型(自动从 HuggingFace 下载)
model = VoxCPM.from_pretrained(
    "openbmb/VoxCPM2",
    load_denoiser=False,
)

# 普通 TTS 合成
wav = model.generate(
    text="今天天气真好,非常适合出门踏青。",
    cfg_value=2.0,
    inference_timesteps=10,
)
sf.write("output.wav", wav, model.tts_model.sample_rate)
print("saved: output.wav")
🎨 声音设计(无需参考音频)
用一句自然语言描述,凭空创造全新声音:
# 在括号内描述声音特征
wav = model.generate(
    text="(年轻女性,声音温柔甜美,带一点微笑感)欢迎使用 VoxCPM2!",
    cfg_value=2.0,
    inference_timesteps=10,
)
sf.write("voice_design.wav", wav, model.tts_model.sample_rate)
🎛️ 可控语音克隆
# 克隆音色,同时可调整情感和风格
wav = model.generate(
    text="(语速稍快,语气轻快活泼)这是一段可控克隆语音演示。",
    reference_wav_path="path/to/your_voice.wav",  # 参考音频,3-10秒即可
    cfg_value=2.0,
    inference_timesteps=10,
)
sf.write("controllable_clone.wav", wav, model.tts_model.sample_rate)
🎙️ 极致克隆(最高相似度)
# 提供参考音频 + 对应文本,实现最高保真克隆
wav = model.generate(
    text="这是极致克隆模式,将完整复现原始声音的每一个细节。",
    prompt_wav_path="path/to/voice.wav",
    prompt_text="参考音频对应的文字内容。",  # 参考音频的转录文本
    reference_wav_path="path/to/voice.wav",
)
sf.write("ultimate_clone.wav", wav, model.tts_model.sample_rate)
⚡ 实时流式输出
import numpy as np

chunks = []
for chunk in model.generate_streaming(
    text="实时流式语音合成,让响应更快!",
):
    chunks.append(chunk)
    # 可以在此实时播放 chunk
wav = np.concatenate(chunks)
sf.write("streaming.wav", wav, model.tts_model.sample_rate)
命令行工具(CLI)
# 声音设计
voxcpm design \
  --text "VoxCPM2 带来专业级多语言语音合成。" \
  --control "年轻男性,沉稳低沉,播音风格" \
  --output out.wav

# 语音克隆
voxcpm clone \
  --text "这是一段克隆演示。" \
  --reference-audio my_voice.wav \
  --output clone.wav

# 批量处理
voxcpm batch --input texts.txt --output-dir outputs/
注意:VoxCPM2 需要约 8GB 显存,使用 Nano-VLLM 推理引擎可将 RTF 从 0.30 提升到 0.13,适合生产环境部署。
📊 与竞品对比
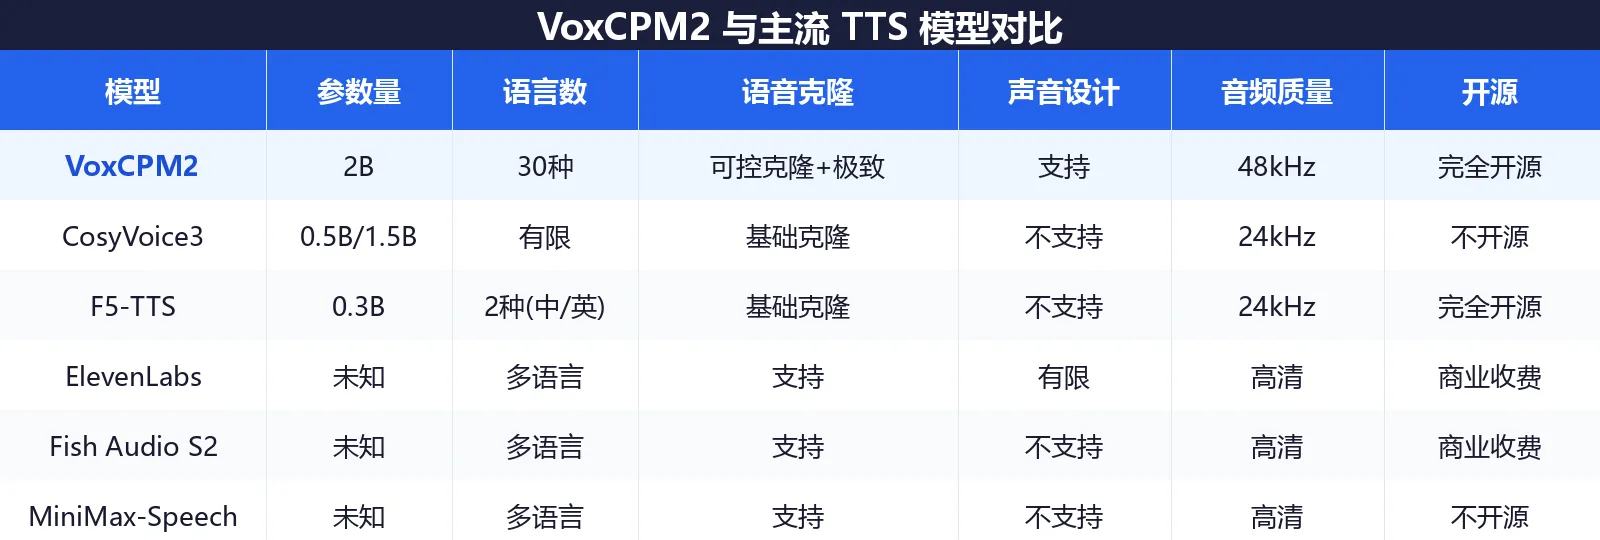
VoxCPM2 在 Seed-TTS-eval 标准基准上取得 SOTA 级别表现:英文 WER 仅 1.65%,中文 CER 仅 1.18%,声音相似度(SIM)大幅领先 F5-TTS 等主流开源模型。
💡 适用场景
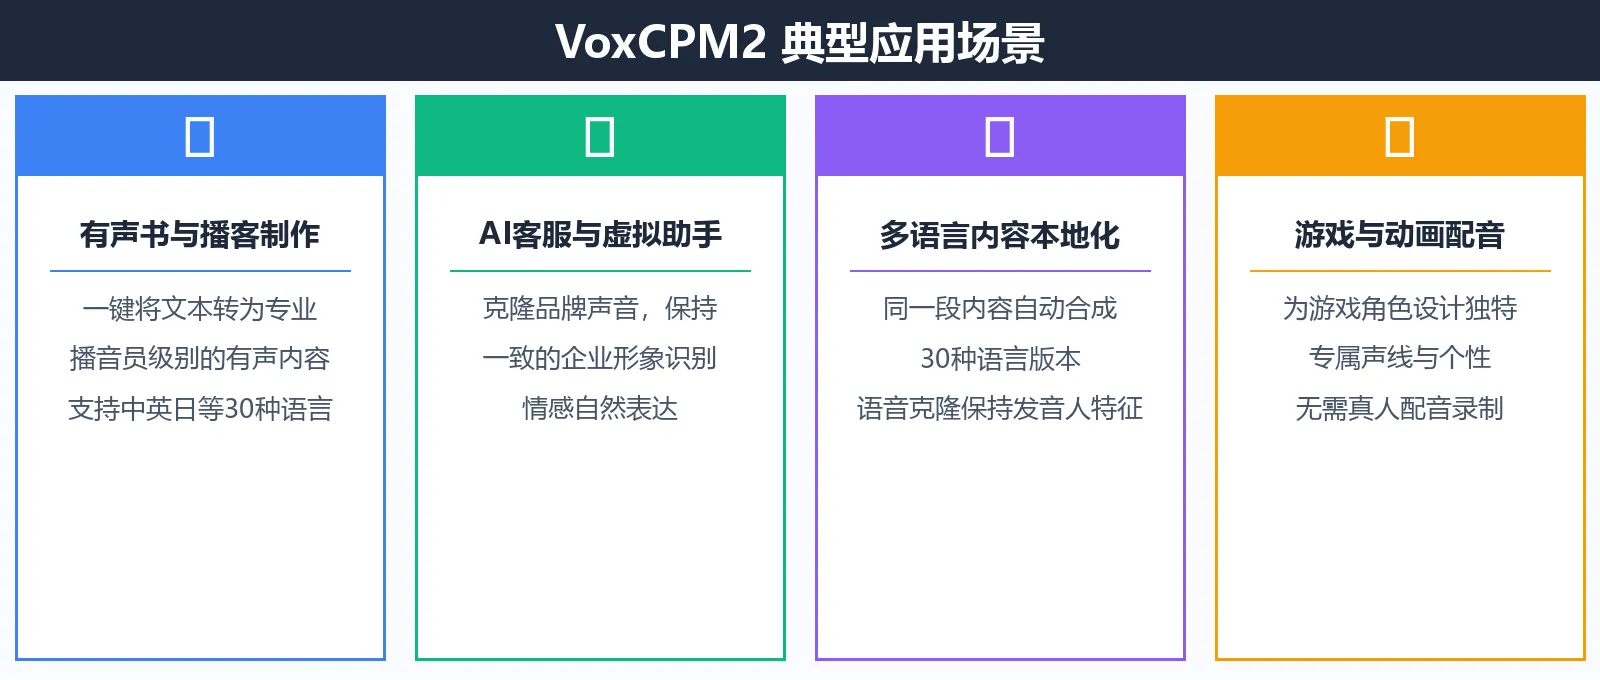
场景一:有声书 & 播客制作
功能说明:将文章、书稿或剧本直接转为高质量有声内容,支持多角色声音设计,可为每个角色分配独特音色。
输入要求:纯文本(支持中文、英文、日文等 30 种语言),可附加声音风格描述。
输出效果:48kHz 高保真音频,自然停顿、情感韵律媲美专业配音员。
适用场景:有声书出版、播客节目制作、短视频旁白配音。
场景二:企业 AI 客服克隆品牌声音
功能说明:录制 5-10 秒原声,即可克隆出高度相似的声音,保持企业形象一致性。使用可控克隆模式,还能在保留音色的同时调整情感和语速。
输入要求:3-10 秒高质量参考音频 + 合成文本,可选提供原始录音文本以提升克隆精度。
输出效果:复现原始声音的音色、节奏、情感风格,SIM 相似度超过 77%。
适用场景:AI 客服系统、虚拟助手配音、品牌声音资产保护。
场景三:多语言内容本地化
功能说明:同一段内容可同时合成 30 种语言版本,声音克隆后可跨语言合成,让主播用外语"说话"。
输入要求:目标语言文本,无需额外配置。
输出效果:自然流畅的多语言语音,支持阿拉伯语、法语、日语等所有主流语言。
适用场景:国际化应用、多语言有声书、跨语言配音。
用户群体总结
- ✅ 内容创作者:快速生成高质量旁白,节省配音成本
- ✅ AI 开发者:API 集成、批量处理、生产部署,一站式解决
- ✅ 研究人员:完全开源,支持 SFT/LoRA 微调,可定制领域声音
- ✅ 企业用户:Apache-2.0 协议,可商用无顾虑
- ❌ 不适合:不支持实时双工对话(非交互式 TTS),低显存设备(< 8GB)效果受限
📦 版本对比与选择
| 版本 | 参数量 | 语言数 | 声音设计 | 可控克隆 | 音质 | 显存需求 |
|---|---|---|---|---|---|---|
| VoxCPM2(推荐) | 2B | 30种 | 支持 | 支持 | 48kHz | ~8GB |
| VoxCPM1.5 | 0.6B | 2种 | 不支持 | 不支持 | 44.1kHz | ~6GB |
| VoxCPM-0.5B | 0.5B | 2种 | 不支持 | 不支持 | 16kHz | ~5GB |
💰 许可证与获取
开源协议: Apache-2.0,完全免费,允许商业使用。
模型权重下载:
- 🤗 HuggingFace:openbmb/VoxCPM2
- 🤖 ModelScope:OpenBMB/VoxCPM2(国内用户推荐)
💡 国内用户福利:VoxCPM2 已上架 ModelScope 魔搭社区,无需科学上网即可下载模型权重,并可直接在 HuggingFace Spaces 体验在线 Demo!
🎯 总结
VoxCPM2 是目前开源社区中技术规格最全、性能最强的 TTS 模型之一。它不只是"更像人"的语音合成,更将语音创作的主动权真正交到了用户手中——无论是凭空设计新声音、克隆任意声音、还是多语言合成,VoxCPM2 都能一招搞定。
推荐指数: ⭐⭐⭐⭐⭐(满分 5 星)
适合人群: 内容创作者、AI 开发者、企业语音应用、语音研究人员
在线体验: HuggingFace Demo
GitHub 仓库: OpenBMB/VoxCPM
本文由 AI 辅助生成,数据截至 2026 年 4 月 13 日,最新信息请以官网为准。