【今日推荐 PersonaPlex】:NVIDIA 开源全双工语音 AI,让对话终于"像人一样"
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../PersonaPlex-recommend.pptx../../PersonaPlex-recommend.mp4本文目录
【今日推荐 PersonaPlex】:NVIDIA 开源全双工语音 AI,让对话终于"像人一样"
NVIDIA 最新开源项目 PersonaPlex,7B 参数全双工对话模型,实时语音 + 角色自定义双管齐下,打断自然、延迟仅 0.17 秒,GitHub 热榜本周新增超 2300 星,MIT 协议免费商用。


🚀 什么是 PersonaPlex?
你有没有和 AI 语音助手对话时,感觉明显"不像人"?要么是你说完一句话才能得到回应,要么打断它就卡壳,要么声音永远是同一个机械腔调……
这背后的根本原因,是传统语音 AI 都采用"级联系统":语音识别 → 大语言模型 → 语音合成,三个环节串联,天然带来延迟和机械感。即便近年来全双工模型(如 Moshi)解决了自然度问题,却又锁死了声音和角色,无法定制。
PersonaPlex 同时解决了这两个矛盾 ——
2026 年 4 月初,NVIDIA ADLR 团队在 GitHub 正式开源 PersonaPlex:一个基于 Moshi 架构的 70 亿参数全双工语音对话模型,能够通过文本提示词定义"角色",通过音频条件定义"声音",实现自然对话的同时完全自定义人设。
核心突破:全双工(同时听说)+ 角色/语音双重可控,这是业界首个同时实现这两个目标的开源模型。
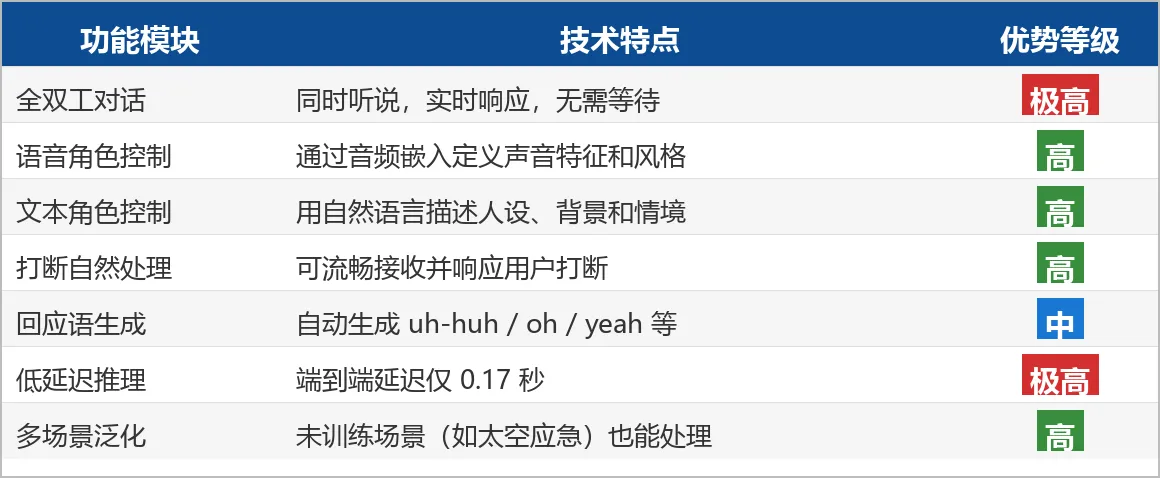
✨ 核心功能一览
🏗️ 技术架构
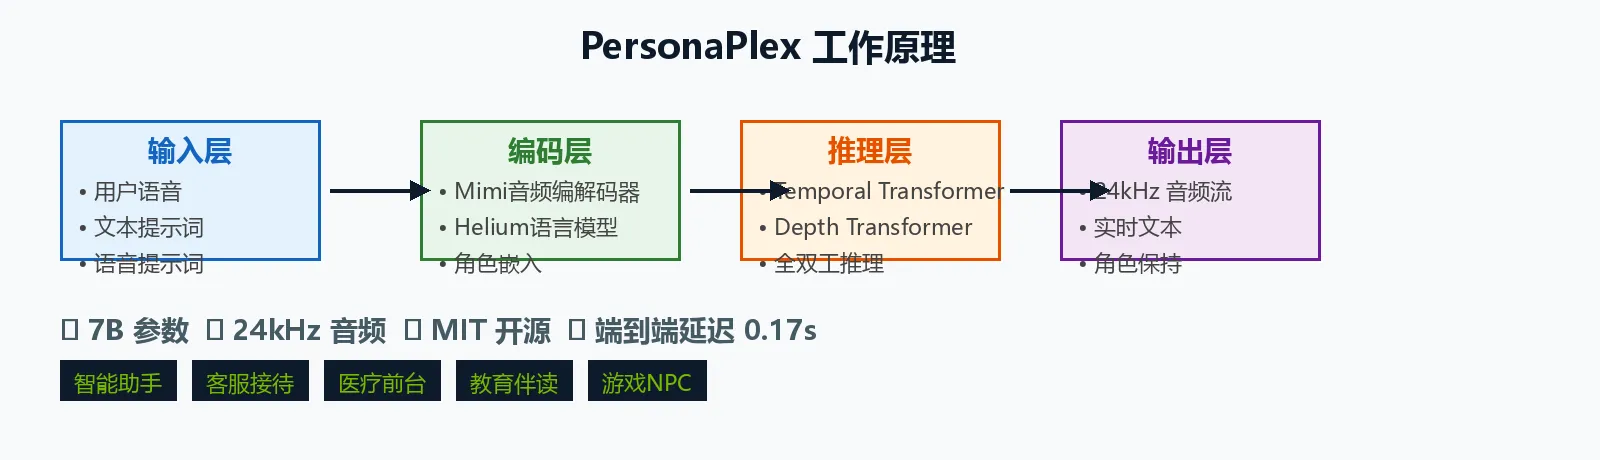
PersonaPlex 基于 Kyutai 开源的 Moshi 架构改进而来,核心由三部分组成:
- Mimi 神经音频编解码器:将输入音频压缩成语义 Token,再解码回 24kHz 高质量音频
- Helium 语言模型:负责语义理解与生成
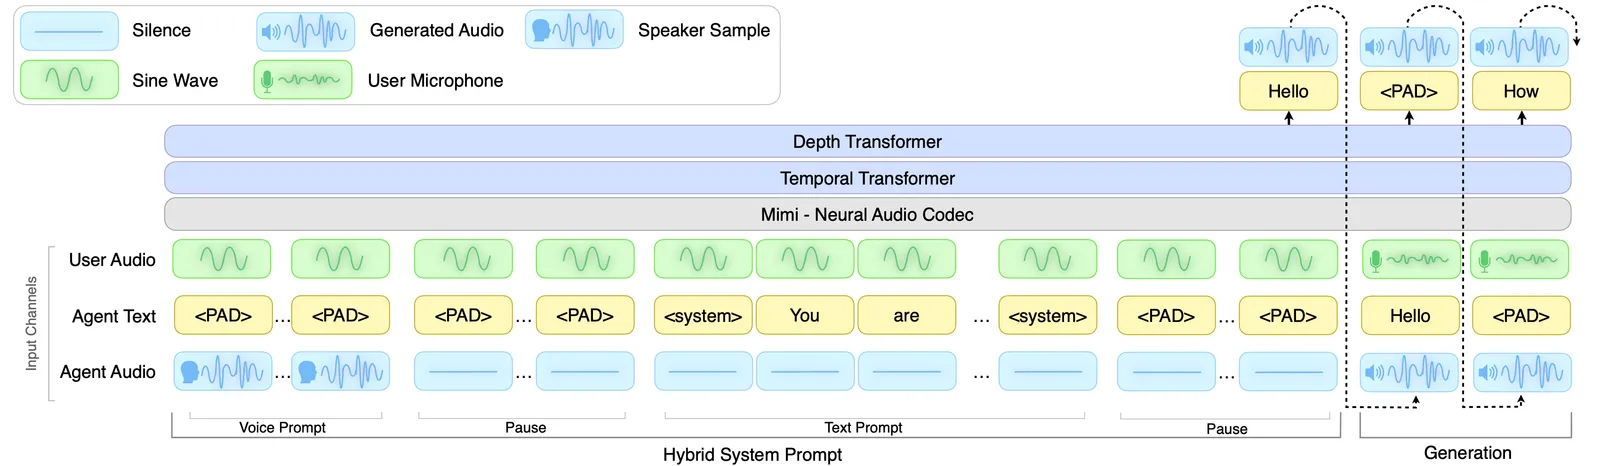
- Temporal + Depth Transformer:双重 Transformer 结合,支持全双工推理
以下是官方发布的架构图(来自 GitHub 仓库):
🛠️ 快速上手:5 分钟本地跑通
1. 安装依赖
# Ubuntu/Debian 系统安装音频编解码库
sudo apt install libopus-dev

# Fedora/RHEL 系统
sudo dnf install opus-devel
2. 克隆仓库并安装模型包
git clone https://github.com/NVIDIA/personaplex.git
cd personaplex

# 安装 moshi 包
pip install moshi/.

# 如果是 Blackwell GPU(RTX 50 系),还需额外安装
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu130
3. 授权并设置 HuggingFace Token
# 在 HuggingFace 接受模型授权(MIT 许可)后设置 Token
export HF_TOKEN=<YOUR_HUGGINGFACE_TOKEN>
4. 启动实时服务器
# 一行命令启动实时对话服务(自动生成临时 SSL 证书)
SSL_DIR=$(mktemp -d); python -m moshi.server --ssl "$SSL_DIR"

# GPU 内存不足时加 --cpu-offload
pip install accelerate
SSL_DIR=$(mktemp -d); python -m moshi.server --ssl "$SSL_DIR" --cpu-offload
启动后在浏览器打开 localhost:8998 即可体验实时对话。
5. 离线评估(测试角色 + 语音控制)
# 仅用语音提示词(控制声音风格)
HF_TOKEN=<TOKEN> \
python -m moshi.offline \
  --voice-prompt "NATF2.pt" \
  --input-wav "assets/test/input_assistant.wav" \
  --seed 42424242 \
  --output-wav "output.wav" \
  --output-text "output.json"

# 语音 + 文本提示词(同时控制声音和角色)
HF_TOKEN=<TOKEN> \
python -m moshi.offline \
  --voice-prompt "NATM1.pt" \
  --text-prompt "$(cat assets/test/prompt_service.txt)" \
  --input-wav "assets/test/input_service.wav" \
  --seed 42424242 \
  --output-wav "output.wav" \
  --output-text "output.json"
内置语音标签快速参考:女声 NATF0-F3(自然)/ VARF0-F4(多样),男声 NATM0-M3 / VARM0-M4,共 18 个预设语音,直接调用无需训练!
💡 适用场景
场景一:AI 智能助手(全功能体验)
功能说明:PersonaPlex 最基础的应用场景是通用 AI 助手。用户和 AI 可以自由打断对方,对话节奏就像两个人实时通话,再无"等待应答"的尴尬停顿。
输入要求:一个文本提示词(描述助手的人设、性格、语气),可选语音提示词控制音色。
输出效果:实时语音流,端到端延迟仅 0.17 秒,角色行为在整个对话中保持一致。
适用场景:智能家居语音助手、移动端 AI 伴侣、个性化虚拟助手开发。
场景二:企业客服 / 前台接待
功能说明:通过自定义文本提示词,PersonaPlex 可以扮演"银行客服"、"医疗前台"、"酒店礼宾"等专业角色,具备对应领域的话术风格和处理逻辑,无需微调模型本身。
输入要求:包含职责描述的文本提示词(例如"你是一家银行的客服,负责解答账户相关问题")。
输出效果:全程维持专业语气,遇到超出范围的问题会自然引导,比固定话术树更灵活。
适用场景:呼叫中心 AI 值守、企业前台自动化、24 小时客服机器人。
场景三:教育陪伴 / 游戏 NPC
功能说明:PersonaPlex 的"角色泛化能力"超乎预期——论文中测试了完全未训练过的场景(如太空应急对话),模型依然能维持角色扮演并正确响应。这意味着它非常适合扮演个性各异的 NPC 角色。
输入要求:创意性的角色描述,例如"你是一个生活在公元 2100 年的宇航员工程师"。
输出效果:角色扮演稳定,语气、知识背景与设定一致,可配合不同语音提示词营造差异化体验。
适用场景:互动式语言学习陪练、剧情类游戏 NPC、沉浸式 XR 体验。
用户群体总结
- ✅ AI 应用开发者:基于 MIT 协议自由集成到商业产品,无需从零研发语音交互
- ✅ 研究人员:全双工语音模型基线,角色控制能力的学术研究起点
- ✅ 企业落地团队:替换昂贵的级联系统,大幅降低语音 AI 部署成本
- ✅ 独立开发者:内置 18 个预设语音,5 分钟即可本地跑通,极低上手门槛
- ❌ 不适合:对话内容需要实时联网搜索的场景(模型本身不含 RAG 能力);极度低端硬件(7B 模型至少需要 16GB+ 显存,CPU 模式较慢)
📊 与竞品横向对比
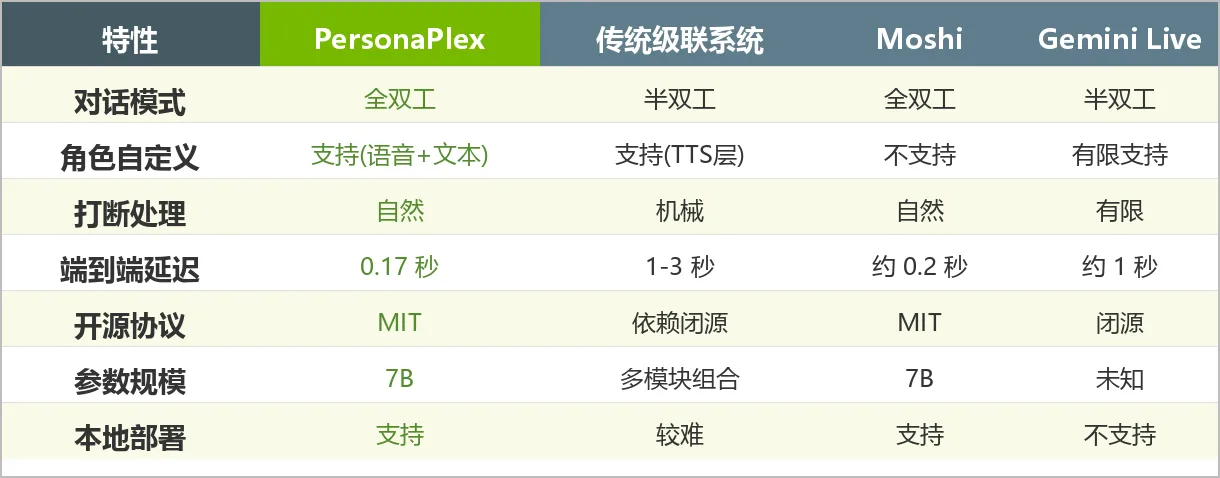
PersonaPlex 在 开源可商用 + 全双工 + 角色自定义 三者同时满足这一维度上,目前尚无可以直接对比的竞品。
传统级联系统虽然功能成熟、角色可定制,但延迟高达 1-3 秒,机械感强烈;Moshi 虽然实现了全双工,但无法自定义角色和声音;Gemini Live 等商业产品功能强大但闭源且不可本地部署。
PersonaPlex 是目前唯一一个能在本地部署、完全开源、同时支持全双工对话 + 角色/语音双重可控的模型。
📈 训练数据与模型规格
| 规格项 | 数值 |
|---|---|
| 参数规模 | 70 亿(7B) |
| 音频采样率 | 24kHz |
| 基础架构 | Moshi(Kyutai) |
| 底层语言模型 | Helium |
| 训练数据总量 | 约 2,250 小时 |
| 真实对话数据 | Fisher English 语料库,7,303 个对话 |
| 合成对话数据 | 144,732 个,涵盖助手 + 客服场景 |
| 端到端延迟 | 约 0.17 秒 |
| 代码协议 | MIT License |
| 模型权重协议 | NVIDIA Open Model License |
💰 费用与部署
- 代码:完全开源,MIT License,免费商用
- 模型权重:NVIDIA Open Model License,允许研究和商业使用(需接受条款)
- HuggingFace 下载:免费,需注册账户并接受协议
- 算力需求:7B 模型建议 16GB+ 显存(支持 CPU Offload,可在消费级 GPU 运行)
💡 开发者福利:MIT 协议代码 + 免费模型权重,可以直接集成进商业产品,不用担心授权问题。
🎯 总结
PersonaPlex 代表了语音 AI 的一个重要里程碑:全双工对话不再意味着放弃角色控制。NVIDIA 用 7B 参数、不到 2,300 小时训练数据,证明了高自然度对话和灵活角色扮演可以同时实现。
对于正在构建语音交互产品的开发团队来说,PersonaPlex 是目前最值得关注的开源基座之一:上手门槛低、MIT 授权无顾虑、本地部署保护数据隐私。
推荐指数: ⭐⭐⭐⭐⭐
适合人群: AI 应用开发者、企业客服团队、研究人员、独立开发者
GitHub 仓库: NVIDIA/personaplex
HuggingFace 模型: nvidia/personaplex-7b-v1
官方演示页: NVIDIA ADLR PersonaPlex
本文数据截至 2026 年 4 月 12 日,最新信息请以官方仓库为准。