Unlimited-OCR
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../Unlimited-OCR-recommend.pptx../../Unlimited-OCR-recommend.mp4本文目录
📌 核心价值:百度 6 月 22 日开源的 Unlimited-OCR,3B 总参 500M 激活就能在 OmniDocBench v1.5 拿下 93.23%、v1.6 拿下 93.92%,一口气解析 40 页不失忆,端到端 OCR 新王者。
用 R-SWA 把人类「抄书时只回看最近几行」的注意力方式塞进注意力层,KV 缓存变成恒定容量的队列,10 万 token 和 1 万 token 内存占用完全一样。
🚀 什么是 Unlimited-OCR?
2026 年 6 月 22 日,百度在 GitHub 和 Hugging Face 同步开源了 Unlimited-OCR。这个被网友戏称为「闷声干大事」的项目,一发布就冲上了 GitHub Trending 第一,把 235B 的 Qwen3-VL、72B 的 Qwen2.5-VL 和不公布参数量的 Gemini-2.5 Pro 全甩在身后。
核心定位:3B 总参、500M 激活、OmniDocBench v1.5 拿到 93.23%,刷新端到端 OCR 的 SOTA。
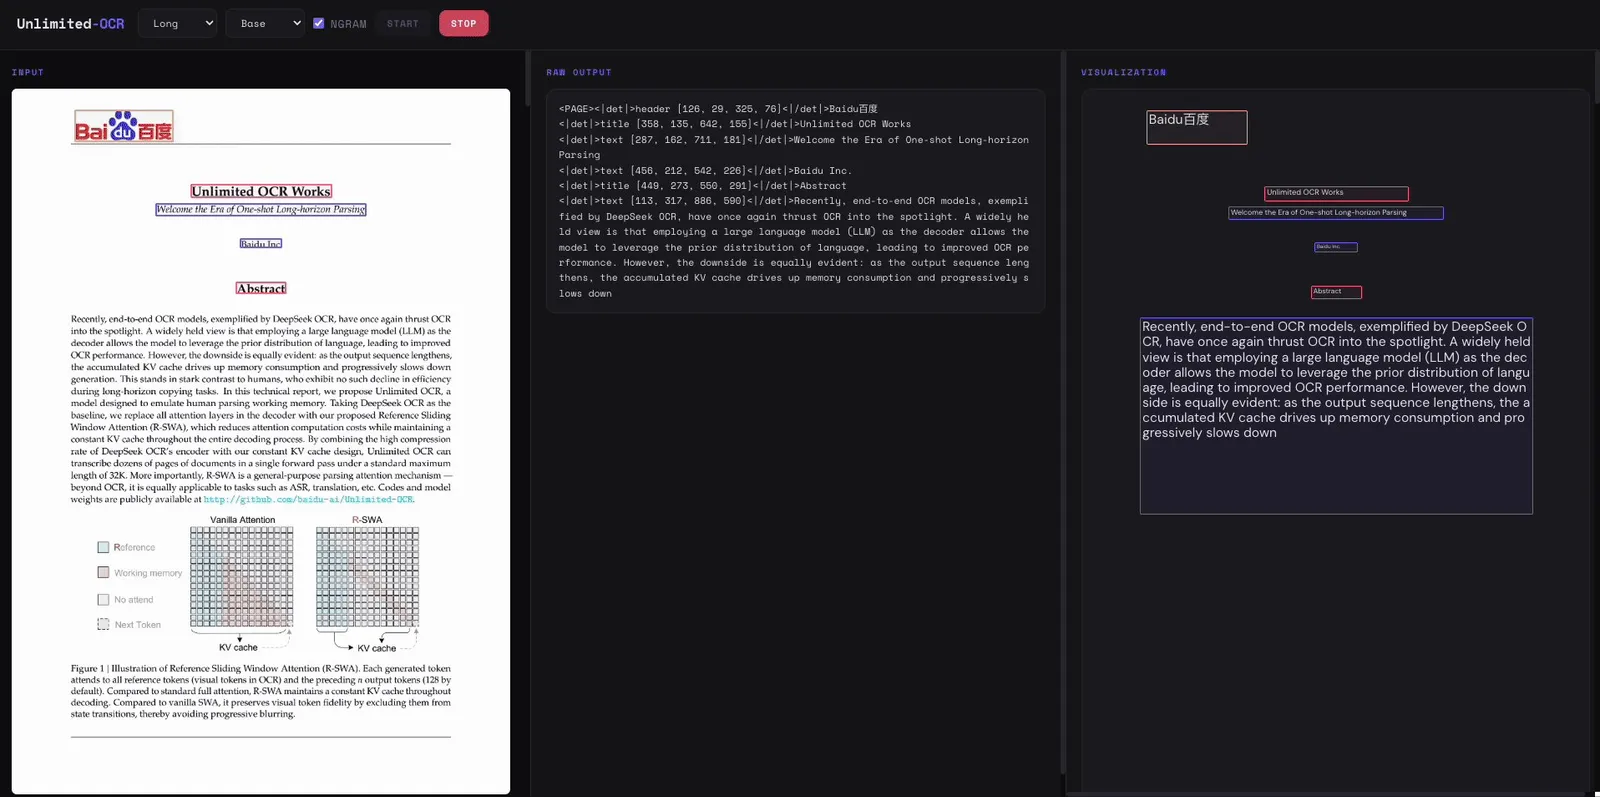
最让人震惊的不是跑分,而是它能「一口气读完 40 多页文档,不失忆、不降速」。以前所有 OCR 模型都要靠外部调度器把 40 页切成 40 个互不相干的小任务,每处理完一页就把记忆清空;Unlimited-OCR 一次前向推理就能从第一页读到最后一页。
项目的 GitHub 仓库 24 小时内突破 300 star,核心贡献者 Huanhuan Liu 任项目 Leader,一位署名「YY†」的技术总监(网友推测疑似 DeepSeek OCR 出走大神魏浩然)。


✨ 核心功能一览
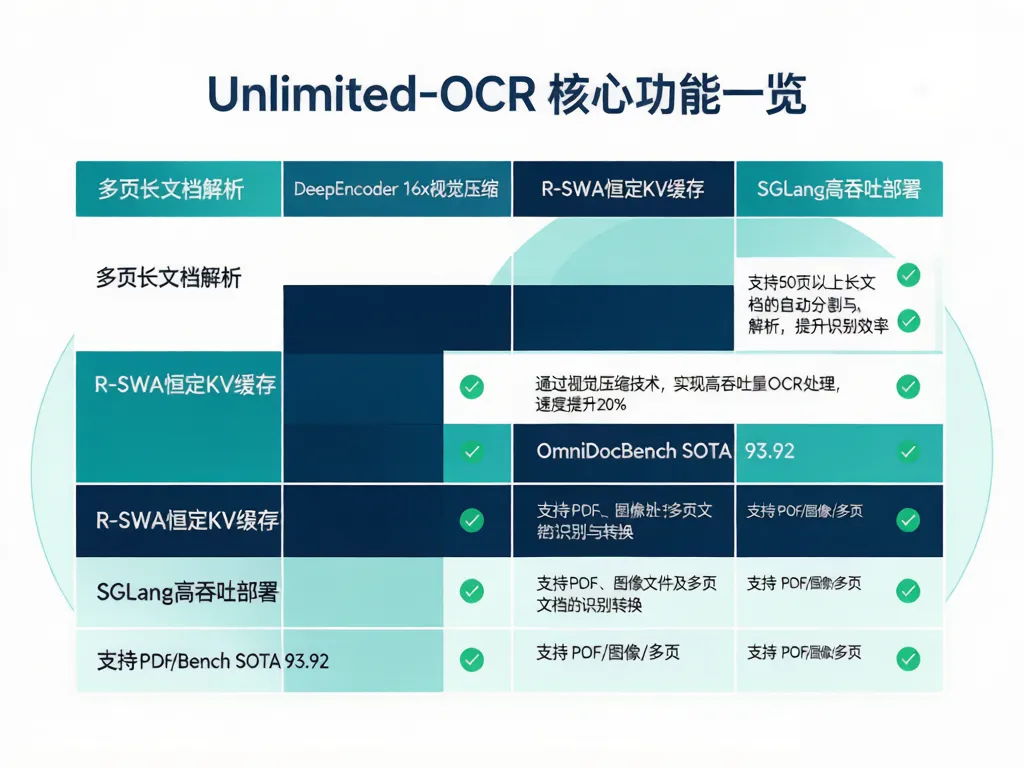
关键技术:DeepEncoder + R-SWA 双剑合璧,让 40 页长文档真正做到「一次推理到底」。
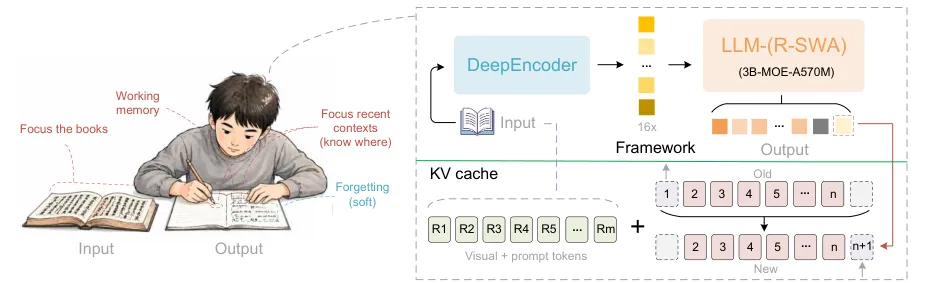
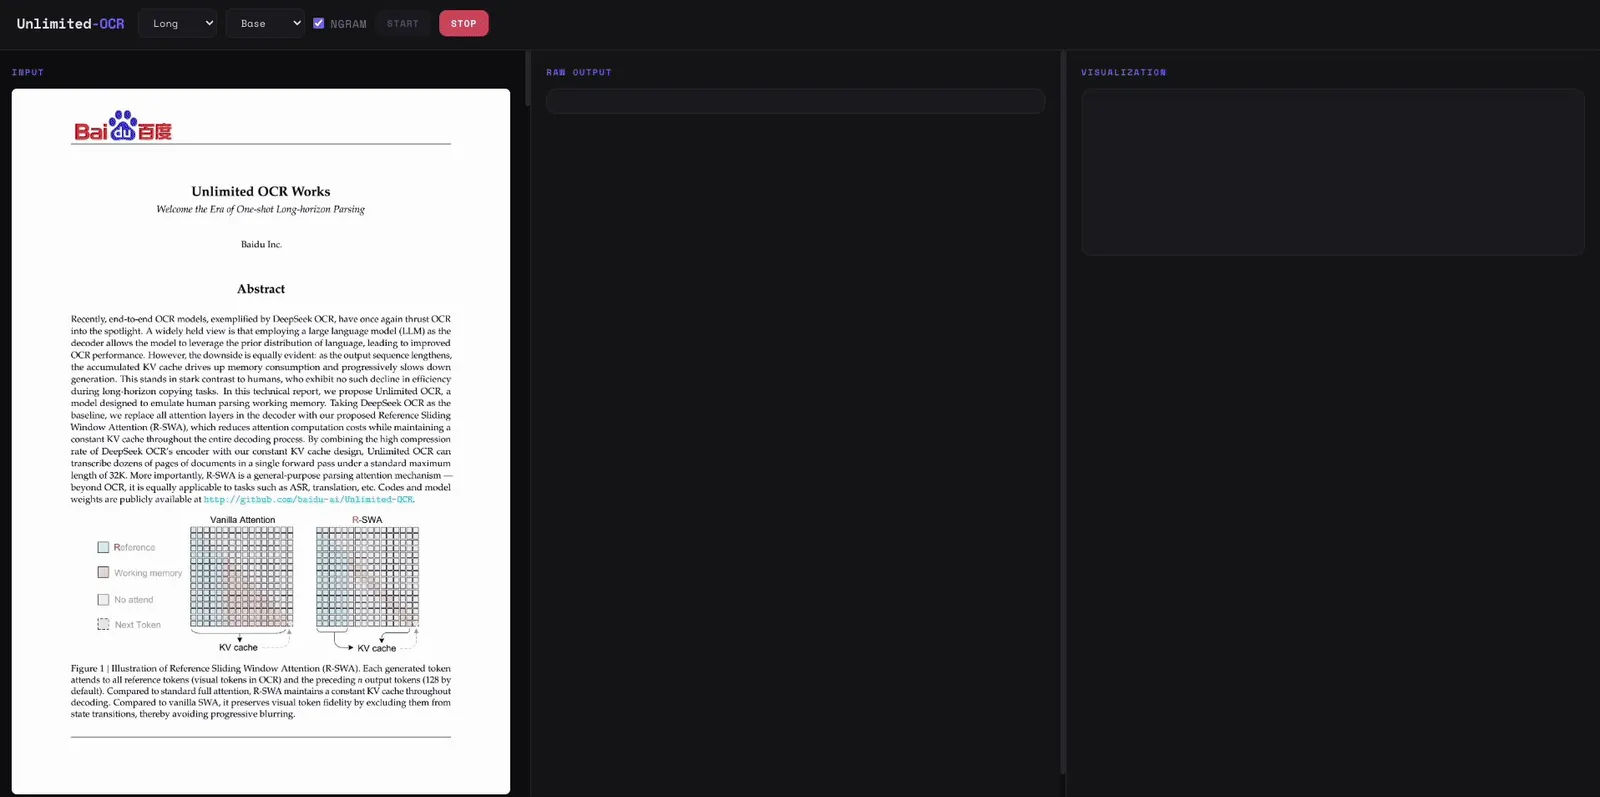
R-SWA:参考滑动窗口注意力
这是 Unlimited-OCR 报告里点名的核心技术,灵感来自人类抄书时的注意力模式:
- 眼睛盯三个点:原书、刚写下的一小段、即将要写的下一个字
- 早些写过的内容慢慢淡出脑海:最近的上下文用来盯住当前进度
- 关键能力叫「软遗忘」(soft forgetting):该忘就忘,极低认知负荷下扛住超长任务
落到实现上,R-SWA 每生成一个 token 都会去看全部「参考 token」(整张图像的视觉 token + 提示词),保证模型始终「看得见」完整原文;但在输出这一侧只回看前面 128 个 token。KV 缓存因此变成一个固定容量的队列,输出 1 万 token 和 10 万 token 内存占用完全一样。
DeepEncoder:16 倍视觉压缩
这个最初在 DeepSeek-OCR 中登场的编码器,能把一张 1024×1024 的 PDF 页面压缩到仅仅 256 个视觉 token,压缩率高达 16 倍。更妙的是,视觉 token 在 R-SWA 下不参与状态转移,无论文档多长,图像信息永远清清楚楚,不会随解码过程逐渐退化。
单模型支持三种场景
# 单图 (gundam 模式: base_size=1024, image_size=640, crop_mode=True)
model.infer(
    tokenizer,
    prompt='<image>document parsing.',
    image_file='your_image.jpg',
    output_path='your/output/dir',
    base_size=1024, image_size=640, crop_mode=True,
    max_length=32768,
    no_repeat_ngram_size=35, ngram_window=128,
)

# 多页 (base 模式: image_size=1024)
model.infer_multi(
    tokenizer,
    prompt='<image>Multi page parsing.',
    image_files=['page1.png', 'page2.png', 'page3.png'],
    output_path='your/output/dir',
    image_size=1024,
    max_length=32768,
)

# PDF(先 PyMuPDF 转图,再走多页接口)
def pdf_to_images(pdf_path, dpi=300):
    import fitz, tempfile, os
    doc = fitz.open(pdf_path)
    tmp_dir = tempfile.mkdtemp(prefix='pdf_ocr_')
    mat = fitz.Matrix(dpi / 72, dpi / 72)
    paths = []
    for i, page in enumerate(doc):
        out = os.path.join(tmp_dir, f'page_{i+1:04d}.png')
        page.get_pixmap(matrix=mat).save(out)
        paths.append(out)
    doc.close()
    return paths
🛠️ 快速上手:5 分钟跑通示例
环境准备
# Python 3.12.3 + CUDA 12.9
pip install torch==2.10.0 torchvision==0.25.0
pip install transformers==4.57.1 Pillow==12.1.1
pip install matplotlib==3.10.8 einops==0.8.2 addict==2.4.0 easydict==1.13
pip install pymupdf==1.27.2.2 psutil==7.2.2
Transformers 推理(最简版)
import torch
from transformers import AutoModel, AutoTokenizer

model_name = 'baidu/Unlimited-OCR'
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
model = AutoModel.from_pretrained(
    model_name,
    trust_remote_code=True,
    use_safetensors=True,
    torch_dtype=torch.bfloat16,
).eval().cuda()

# 单图文档解析
model.infer(
    tokenizer,
    prompt='<image>document parsing.',
    image_file='your_image.jpg',
    output_path='./output',
    base_size=1024, image_size=640, crop_mode=True,
    max_length=32768,
    no_repeat_ngram_size=35, ngram_window=128,
    save_results=True,
)
SGLang 高吞吐部署
# uv venv(推荐)
uv venv --python 3.12
source .venv/bin/activate
uv pip install wheel/sglang-0.0.0.dev11416+g92e8bb79e-py3-none-any.whl
uv pip install kernels==0.11.7 pymupdf==1.27.2.2

# 启动 OpenAI 兼容服务
python -m sglang.launch_server \
    --model baidu/Unlimited-OCR \
    --served-model-name Unlimited-OCR \
    --attention-backend fa3 \
    --page-size 1 \
    --mem-fraction-static 0.8 \
    --context-length 32768 \
    --enable-custom-logit-processor \
    --disable-overlap-schedule \
    --host 0.0.0.0 --port 10000
注意:SGLang 部署需要 kernels==0.11.7,PyMuPDF 用于 PDF 转图,自定义 logit 处理器负责禁用 N-gram 重复。
批量推理
# 图片目录(并发 8 路)
python infer.py \
    --image_dir ./examples/images \
    --output_dir ./outputs \
    --concurrency 8 \
    --image_mode gundam

# PDF 文档
python infer.py \
    --pdf ./examples/document.pdf \
    --output_dir ./outputs \
    --concurrency 8 \
    --image_mode gundam
📊 与竞品对比
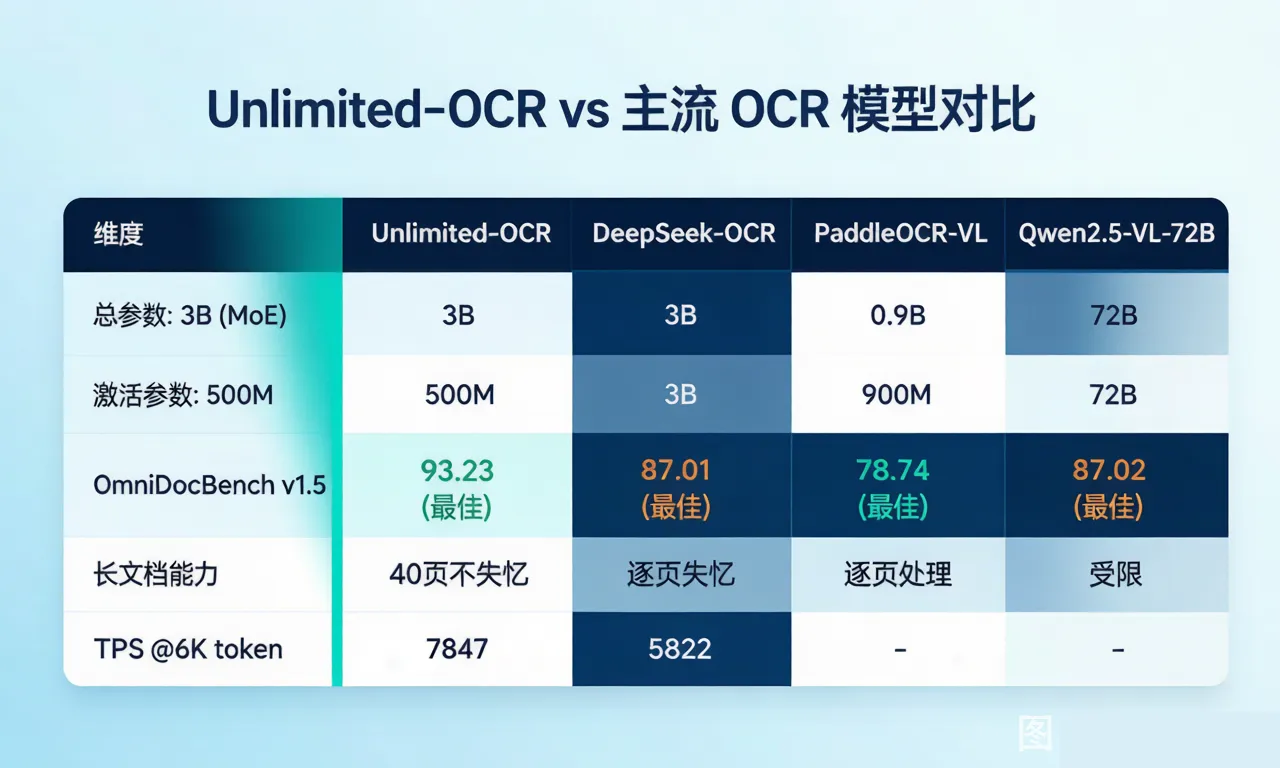
OmniDocBench v1.5 跑分:Unlimited-OCR 93.23%,DeepSeek-OCR 87.01%,提升 6.22 个百分点。
详细数据(来自百度技术报告):
| 指标 | Unlimited-OCR | DeepSeek-OCR | PaddleOCR-VL | Qwen2.5-VL-72B |
|---|---|---|---|---|
| 总参数 | 3B (MoE) | 3B | 0.9B | 72B |
| 激活参数 | 500M | 3B | 900M | 72B |
| OmniDocBench v1.5 | 93.23 | 87.01 | 78.74 | 87.02 |
| OmniDocBench v1.6 | 93.92 | — | — | — |
| 文本编辑距离 | 0.038 | 0.073 | — | — |
| 公式 CDM | 92.61 | 83.37 | — | — |
| 表格 TEDS | 90.93 | 84.97 | — | — |
| TPS @6K token | 7847 | 5822 | — | — |
效率同样碾压:DeepSeek-OCR 的标准 MHA 随解码步数增加每步耗时稳步攀升,而 Unlimited-OCR 的 R-SWA 从头到尾一条平线。
💡 适用场景
场景 1:长文档批量解析
功能说明:以前处理一份 40 页的论文需要先拆页、循环调用 40 次 OCR、再拼接结果,每一页都要重新加载模型。Unlimited-OCR 用一次前向推理就能从第一页读到最后一页,KV 缓存恒定,编辑距离仅 0.057。
输入要求:PDF 文件(通过 PyMuPDF 转 PNG)或 20+ 张同分辨率图像(建议 1024×1024 起步)
输出效果:直接得到完整 Markdown 文本,公式 / 表格 / 阅读顺序一并识别
适用场景:学术论文批量入库、企业合同数字化、扫描版电子书 OCR
场景 2:复杂排版文档
功能说明:百度技术报告里特别强调 Unlimited-OCR 在九大文档类型(PPT、论文、杂志、报纸、试卷、书籍、笔记、表格、票据)上没有短板。文本和阅读顺序两项全面超越 DeepSeek OCR,且在七个类别中领先 DeepSeek OCR 2。
输入要求:彩色扫描图,建议分辨率 ≥ 300 DPI,背景清晰
输出效果:保留原始排版层级,自动识别公式(CDM 92.61)和表格(TEDS 90.93)
适用场景:扫描版教材 OCR、古籍数字化、研究报告归档
场景 3:高吞吐 API 服务
功能说明:通过 SGLang 部署成 OpenAI 兼容的 API 服务,单卡 H100 即可支撑并发请求。DeepSeek-OCR 的标准 MHA 随解码步数增加每步耗时稳步攀升,Unlimited-OCR 的 R-SWA 从头到尾 TPS 稳定在 7800+,比 DeepSeek-OCR 的 5822 高 35%。
输入要求:OpenAI Chat Completions 格式(image_url 字段 base64 编码),Prompt 区分单图 / 多图
输出效果:流式返回 Markdown 文本,单文档 6K token 输出仅需约 0.76 秒
适用场景:企业内部 OCR SaaS、票据识别 API、长文档批量入库
用户群体总结
- ✅ 企业 IT 团队:合同 / 票据 / 报告 OCR,替换 PaddleOCR + 自研调度器的旧方案
- ✅ AI 应用开发者:通过 SGLang 部署 API 服务,集成到 RAG / Agent 工作流
- ✅ 学术研究者:长文档 OCR SOTA 复现,研究 R-SWA 在 ASR / 翻译场景的扩展
- ✅ 独立开发者:单卡推理 + SGLang 部署,构建小型 OCR 服务无压力
- ❌ 不适合:超大规模印刷字体场景(如街景招牌识别),仍需传统 PaddleOCR 检测+识别 pipeline
💰 定价与开源协议
开源协议:MIT License
完全免费、可商用、可二次分发,唯一要求是保留版权声明。
- GitHub 仓库:https://github.com/baidu/Unlimited-OCR
- Hugging Face:https://huggingface.co/baidu/Unlimited-OCR
- 模型权重:3B MoE,bf16 约 6GB,单卡 H100 / A100 / 4090 即可推理
- 推理后端:Transformers(开发调试)+ SGLang(生产部署)
- 训练成本:仅在 DeepSeek-OCR 基础上继续训练 4000 步
💡 新用户福利:MIT 协议商用无门槛,单卡即可部署 40 页长文档 OCR,比 72B 闭源多模态模型还准。
🎯 总结
Unlimited-OCR 是 2026 年 6 月中文 AI 圈最值得关注的开源项目之一。它用 R-SWA 这一行注意力创新,把「长文档 OCR 失忆」这个困扰行业多年的工程难题变成了「免费的午餐」:KV 缓存恒定、计算量恒定、准确率更高、速度更快。
3B 总参 500M 激活就能在 OmniDocBench v1.6 拿下 93.92%,反超 235B 的 Qwen3-VL 和 72B 的 Qwen2.5-VL — 这种「小模型打大模型」的剧本,与之前 DeepSeek-OCR 横扫 OCR 榜单时的剧情几乎一模一样。
更值得期待的是技术报告末尾那句「下一步,上下文窗口训到 128K,构建 prefill pool 让模型学会自动翻页」— 一旦 R-SWA 推广到 ASR 和翻译,百度手里握着的就不只是一个 OCR 模型,而是一套通用长程解析的技术框架。
推荐指数: ⭐⭐⭐⭐⭐(满分 5 星)
适合人群: 企业 OCR 团队 / AI 应用开发者 / 长文档处理研究者
立即体验: GitHub baidu/Unlimited-OCR
GitHub 仓库: baidu/Unlimited-OCR
数据截至 2026-06-23,最新信息请以 GitHub 为准。