OmniVoice
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../OmniVoice-recommend.pptx../../OmniVoice-recommend.mp4本文目录
📌 核心价值:支持 600+ 语种的最强开源语音克隆 TTS,3 秒复刻任意声音
小米 k2-fsa 团队开源的 OmniVoice,基于扩散语言模型架构,实现 0.8B 参数覆盖 646 种语言,词错率仅 0.84%,推理速度比实时快 40 倍,性能全面超越 ElevenLabs v2。
🚀 什么是 OmniVoice?
OmniVoice 是小米 AI 实验室旗下新一代 Kaldi 团队(k2-fsa)于 2026 年 4 月正式开源的大规模多语言零样本文本转语音(TTS)模型。
它在 HuggingFace 上开源了模型权重,采用 Apache-2.0 协议,个人和商业均可免费使用。


核心定位:目前语言覆盖最广的开源 TTS 模型,单阶段扩散架构突破传统两段式瓶颈
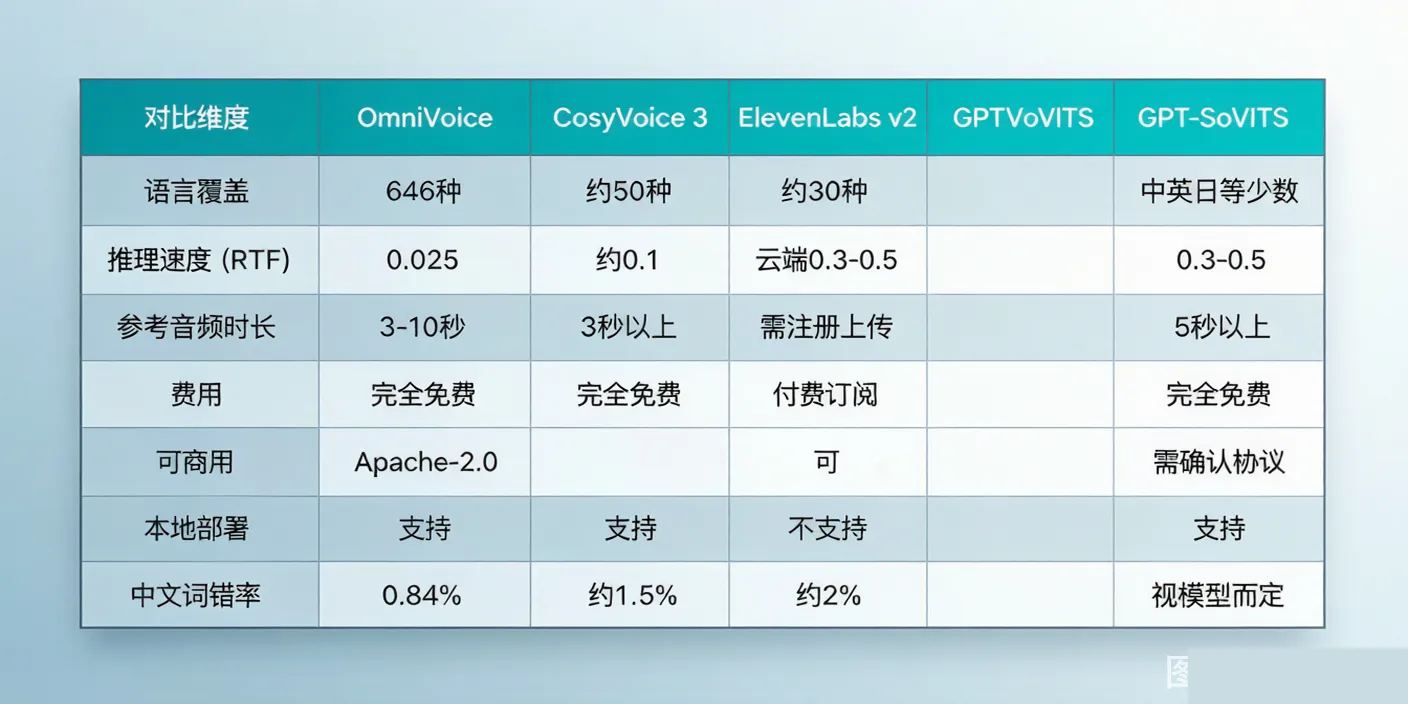
相比 GPT-SoVITS、CosyVoice 等主流开源 TTS,OmniVoice 在语言覆盖(646 种 vs 几十种)、推理速度(RTF 0.025,快 40 倍)、词错率(中文仅 0.84%)三个核心指标上全部领先。
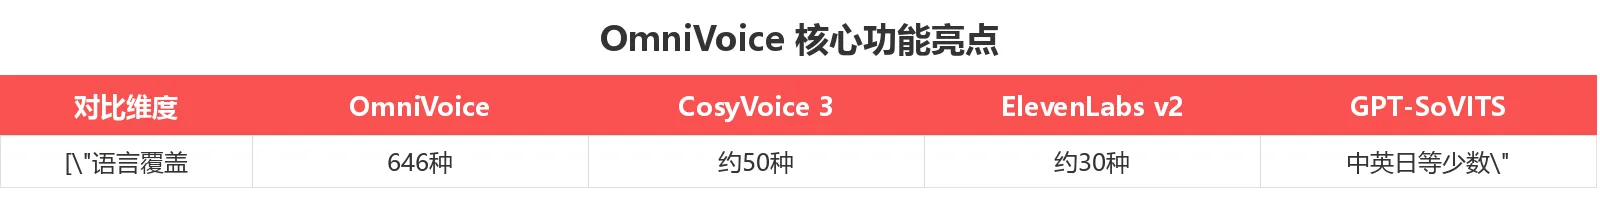
✨ 核心功能一览
🛠️ 快速上手:5 分钟跑通示例
安装
推荐用 pip 安装(无需克隆仓库):
# NVIDIA GPU 用户
pip install torch==2.8.0+cu128 torchaudio==2.8.0+cu128 --extra-index-url https://download.pytorch.org/whl/cu128
pip install omnivoice

# Apple Silicon 用户
pip install torch==2.8.0 torchaudio==2.8.0
pip install omnivoice
Python API 调用
from omnivoice import OmniVoice
import soundfile as sf
import torch

# 加载模型(NVIDIA GPU)
model = OmniVoice.from_pretrained(
    "k2-fsa/OmniVoice",
    device_map="cuda:0",
    dtype=torch.float16
)

# 语音克隆:给一段 3-10 秒的参考音频
audio = model.generate(
    text="你好,这是一个零样本语音克隆的测试。",
    ref_audio="ref.wav",       # 参考音频(3-10 秒即可)
    ref_text="参考音频的文本",  # 可选,不填会自动用 Whisper 转录
)

# 保存为 WAV 文件(24kHz)
sf.write("output.wav", audio[0], 24000)
注意:参考音频建议 3-10 秒即可,太长的音频反而会降低推理速度
Web 界面(无需写代码)
omnivoice-demo --ip 0.0.0.0 --port 8001
启动后浏览器访问 http://localhost:8001,即可通过 Gradio 界面上传参考音频、输入文本、生成语音。
📊 与竞品对比
💡 适用场景
功能演示 1:语音克隆
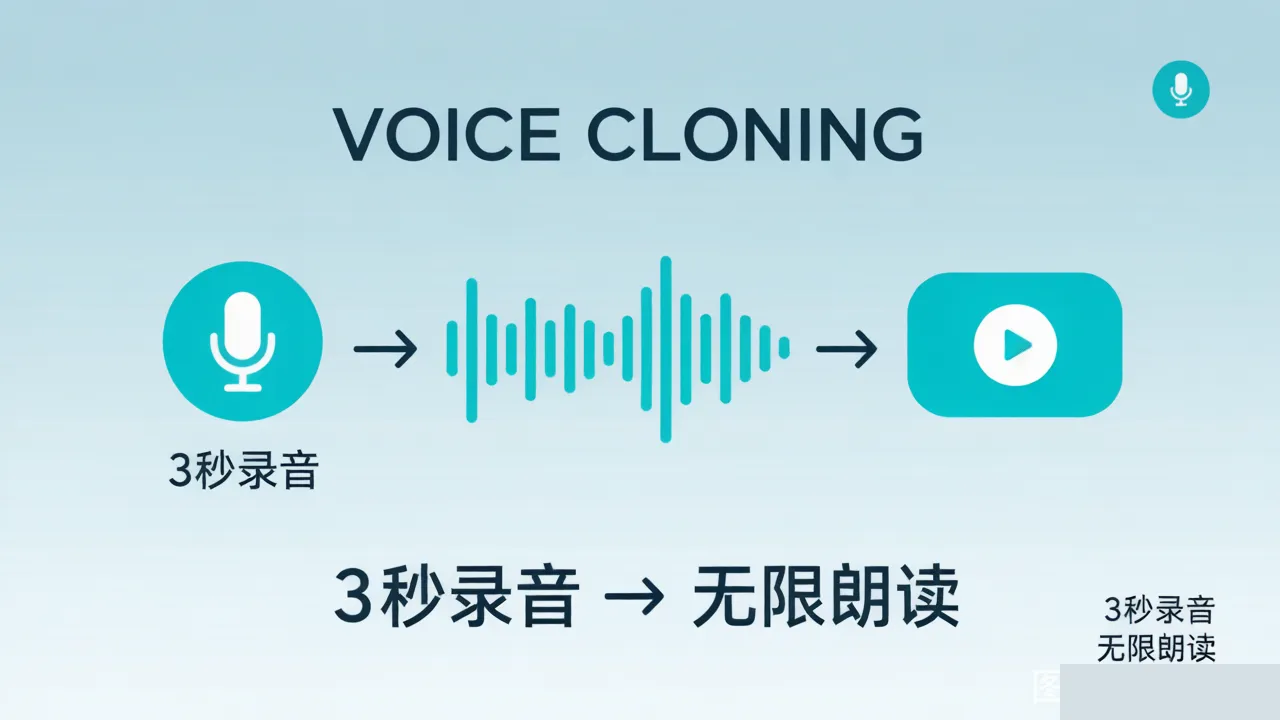
功能说明:上传一段 3-10 秒的参考音频,模型即可学会该声音的特征,之后用这个声音朗读任意文本。不需要额外训练或微调。
输入要求:一段 3-10 秒的 WAV/MP3 音频(手机录音即可,模型内置去噪)
输出效果:高保真语音克隆,音色、语调、口音均忠实还原
适用场景:有声书配音、视频字幕配音、个人声音数字孪生
功能演示 2:声音设计
功能说明:不需要参考音频,直接通过文字描述生成指定特征的声音。支持性别、年龄、音调、方言口音、耳语风格等自由组合。
输入要求:文本描述,如 "female, low pitch, British accent"
输出效果:生成符合描述的全新声音,可自由组合多个属性
适用场景:游戏 NPC 配音、有声书多角色生成、虚拟主播、批量内容制作
功能演示 3:多语言与方言
功能说明:全球最广泛的语种覆盖——646 种语言和方言。支持跨语言语音克隆(用中文录音生成日语语音,声音特征保持不变),并内置中文方言支持(四川话、广东话、陕西话等)。
输入要求:目标语言文本 + 可选参考音频
输出效果:自然流畅的多语言语音合成,保留说话人声线特征
适用场景:全球内容本地化、多语言教学、跨国企业培训、方言保护
额外能力:细粒度语音控制
除三大核心功能外,OmniVoice 还支持:
- 非语言符号:在文本中插入
[laughter]、[sigh]等标签,生成带笑声、叹气的语音 - 发音纠正:中文用拼音标注(如
打ZHE2出售),英文用 CMU 音素词典纠正发音 - 多说话人对话:用
[Speaker_1]:、[Speaker_2]:标签一次性生成多人对话音频
用户群体总结
- ✅ 内容创作者:有声书、播客、短视频配音,快速生成高质量语音
- ✅ 开发者:Apache-2.0 开源协议,可商用,API 简洁易集成
- ✅ 出海企业:600+ 语种覆盖,一次部署即可全球化内容本地化
- ❌ 不适合:对超低功耗设备有严格要求(需 6GB+ 显存,CPU 运行极慢)
💰 定价方案
完全免费开源
开源协议: Apache-2.0
模型权重在 HuggingFace 开源(k2-fsa/OmniVoice),代码在 GitHub 开源,个人和商业均可免费使用。
💡 在线免费试用:直接访问 HuggingFace Space 或 Google Colab 无需本地部署即可体验
🎯 总结
OmniVoice 是 2026 年 TTS 领域最令人瞩目的开源项目之一。646 种语言覆盖 + SOTA 级质量 + 40 倍实时速度 + Apache-2.0 免费商用,每个维度都能打。如果你需要一个开源的、可商用的、多语言 TTS 方案,OmniVoice 是目前最佳选择。
推荐指数: ⭐⭐⭐⭐⭐(满分 5 星)
适合人群:需要多语言语音合成的开发者、内容创作者、出海企业
立即体验: HuggingFace Space 在线 Demo
GitHub 仓库: k2-fsa/OmniVoice
数据截至 2026 年 6 月,最新信息请以官网和论文为准。