TalkingHead
本文目录
📌 核心价值:纯浏览器端运行的 3D 数字人框架,零后端零 GPU,开箱即用对接 OpenAI/Gemini/Grok
TalkingHead 是一个基于 JavaScript + ThreeJS 的开源 3D 数字人框架,支持实时唇形同步、8 种情绪切换、多语言唇形匹配,无需后端服务、纯前端 WebGL 渲染,完全可在浏览器内驱动一个会说话、有表情的 3D 数字人。


🚀 什么是 TalkingHead?
TalkingHead (3D) 是一个浏览器端 JavaScript 类,能让你的网页中"活起来"一个会说话、有表情、能做动作的 3D 数字人。它的核心定位与市场上常见的 2D 真人数字人(Wav2Lip / MuseTalk / HeyGen 等)截然不同:
- 3D 全身体渲染(不是 2D 真人视频)
- 纯浏览器端运行(不需要 GPU 服务器)
- MIT 完全开源(v1.7.0 已稳定发布,2025 年 12 月 8 日)
- 1.3k Stars + 311 Forks + 11 个 Releases
核心差异化:它把"3D 数字人"这件事从 GPU 服务器搬进了浏览器,前端工程师 5 分钟就能集成
仓库地址:met4citizen/TalkingHead(MIT License)
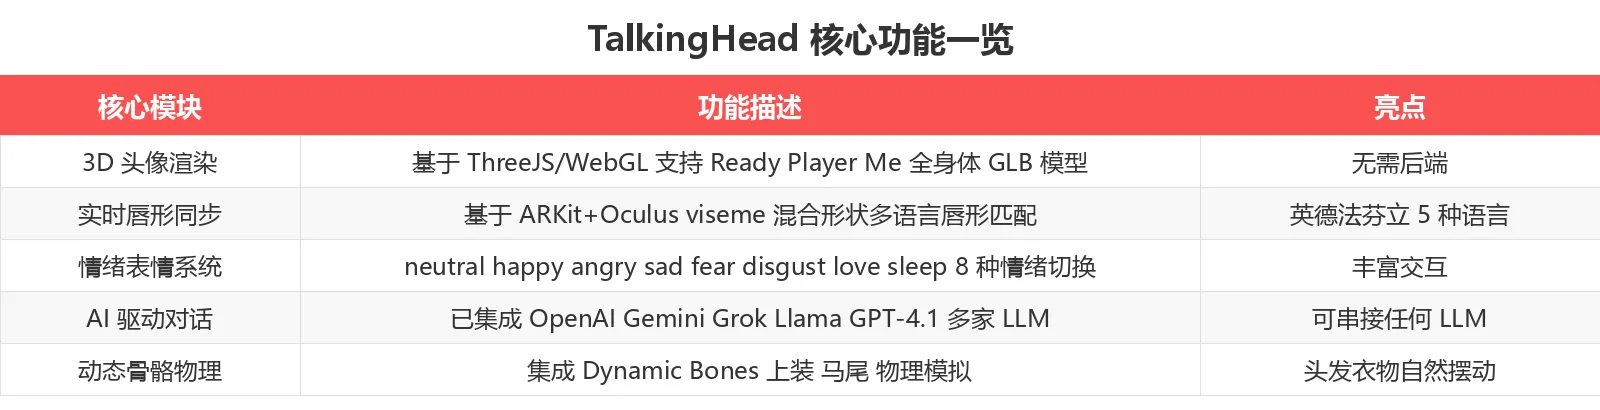
✨ 核心功能一览
🛠️ 快速上手:5 分钟集成一个会说话的 3D 数字人
安装与 CDN 引入
TalkingHead 完全通过 CDN 引入,无需 npm 安装、无需构建工具。HTML 中加入 importmap 即可:
<script type="importmap">
{
  "imports": {
    "three": "https://cdn.jsdelivr.net/npm/three@0.180.0/build/three.module.js/+esm",
    "three/addons/": "https://cdn.jsdelivr.net/npm/three@0.180.0/examples/jsm/",
    "talkinghead": "https://cdn.jsdelivr.net/gh/met4citizen/TalkingHead@1.7/modules/talkinghead.mjs"
  }
}
</script>
初始化 TalkingHead 实例
import { TalkingHead } from "talkinghead";

// 创建头像渲染容器
const nodeAvatar = document.getElementById('avatar');

// 关键配置:TTS 端点 + 唇形模块 + 语音增益
const head = new TalkingHead(nodeAvatar, {
  ttsEndpoint: "/gtts/",          // 自建 Google TTS 代理端点
  jwtGet: jwtGet,                  // 鉴权函数(防止 API key 泄露)
  lipsyncModules: ["en", "fi"],   // 加载英语+芬兰语唇形模块
  mixerGainSpeech: 3               // 语音输出增益
});
加载并显示一个 Ready Player Me 头像
try {
  await head.showAvatar({
    url: './avatars/avaturn.glb',     // GLB 模型(支持 Ready Player Me)
    body: 'F',                         // 体型(F/M)
    avatarMood: 'neutral',             // 初始情绪
    ttsLang: "en-GB",                  // TTS 语言
    ttsVoice: "en-GB-Standard-A",      // TTS 音色
    lipsyncLang: 'en',                 // 唇形同步语言
    baseline: {
      headRotateX: -0.05,              // 默认头部姿态
      eyeBlinkLeft: 0.15,
      eyeBlinkRight: 0.15
    }
  });
} catch (error) {
  console.log(error);
}
让头像说话
nodeSpeak.addEventListener('click', function () {
  const text = document.getElementById('text').value;
  if (text) {
    head.speakText(text);  // 同步执行 TTS + 唇形 + 表情
  }
});
注意:.glb 模型必须具备 Mixamo 兼容骨骼绑定 + ARKit/Oculus viseme 混合形状,否则唇形不会动
📊 与竞品对比
TalkingHead 与其他主流数字人方案的对比:
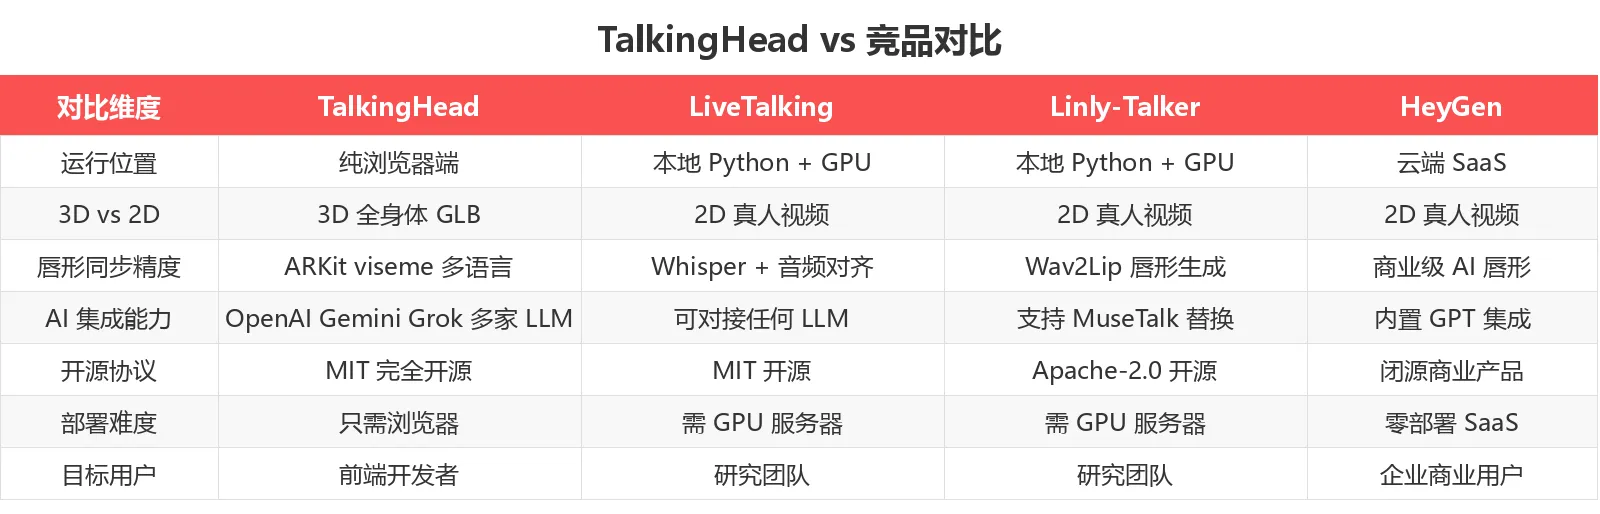
核心优势对比:TalkingHead 是当前唯一纯浏览器端 + 3D 全身体 + MIT 开源的方案,LiveTalking/Linly-Talker 都需要本地 GPU 服务器,而 HeyGen 是闭源 SaaS
💡 适用场景
场景 1:AI 聊天机器人前端
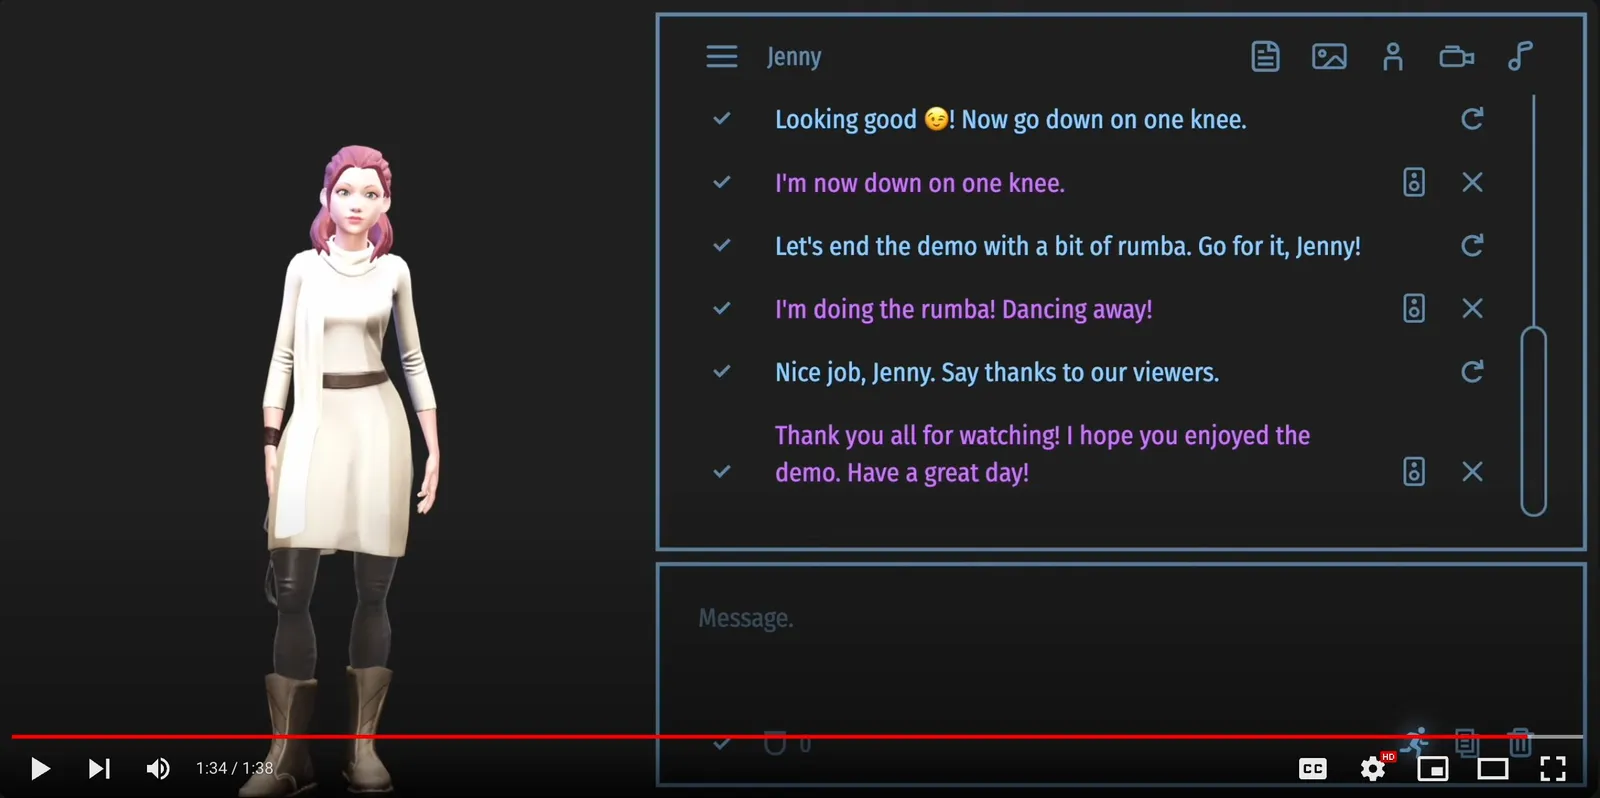
功能说明:将 TalkingHead 作为前端组件,串接 OpenAI / Gemini / Grok / Llama 等 LLM,让 AI 回复时数字人同步说话、做表情。
输入要求:
- 一个
.glb格式的 3D 头像(推荐 Ready Player Me 免费生成) - 一个 LLM API key(OpenAI / Google / xAI 任选)
- 一个 TTS 端点(Google Cloud TTS / ElevenLabs / Azure / Microsoft)
输出效果:用户在浏览器看到一个会说话、眨眼、转头、表情变化的 3D 数字人,所有计算都在客户端完成。
适用场景:
- 客服机器人网页版(替代纯文字 chatbot)
- AI 教学助手(个性化教师形象)
- 心理咨询机器人(更有温度的交互)
场景 2:多 AI 群组对话(DialogLab)
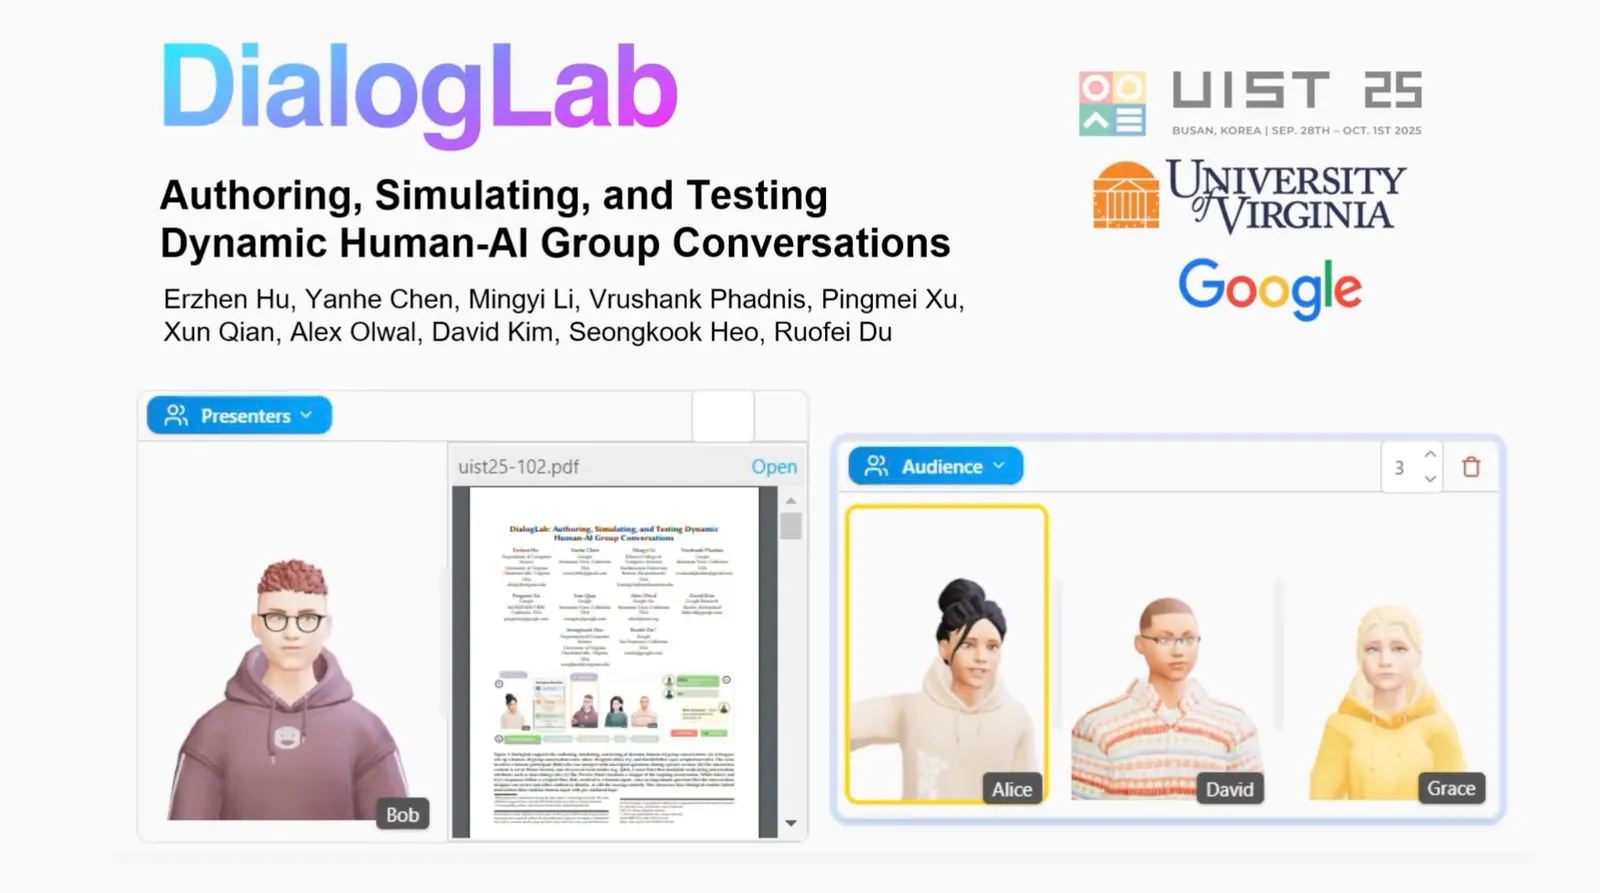
功能说明:DialogLab 是一个多 AI 角色群组对话研究项目,TalkingHead 同时驱动多个 3D 数字人,让它们在一个虚拟会议室里讨论问题。
输入要求:
- 多个
.glb头像(每个 AI 角色一个) - 多个 LLM 实例(每个角色绑定不同的 system prompt)
- DialogLab 调度器(决定哪个角色该说话)
输出效果:你看到一个 3D 虚拟会议室,多个数字人轮流发言、表情变化、眼神交流,完全在浏览器内运行。
适用场景:
- 学术研究:人类与多 AI 协作的群组动力学
- 教育:虚拟历史人物圆桌讨论(孔子 vs 苏格拉底)
- 创意写作:多角色 AI 协作剧本创作
场景 3:拍照生成个性化头像(Avaturn)
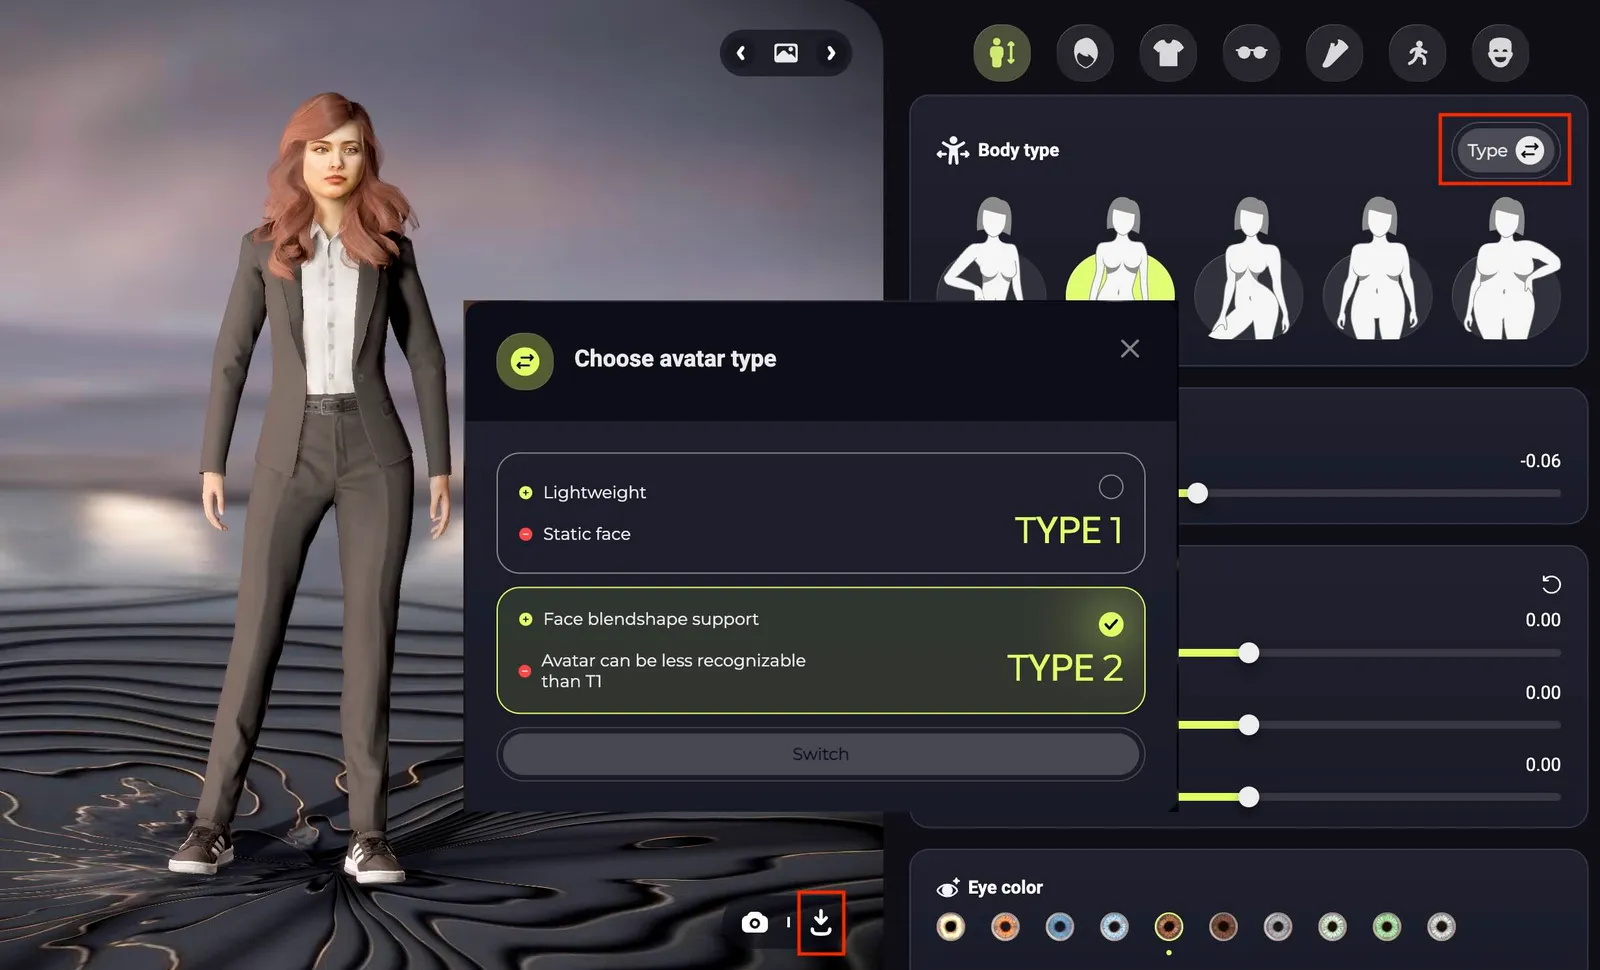
功能说明:Avaturn 是一款用手机自拍生成 3D 头像的服务,结合 TalkingHead 后,你可以在 30 秒内拥有一个"长得像自己"的 3D 数字人分身。
输入要求:
- 一张正面自拍照片
- 选择发型、服装、肤色等参数
- 导出
.glb文件并嵌入 TalkingHead
输出效果:用户在浏览器看到一个和自己长得很像的 3D 数字人,可以让它说话、做动作、上直播。
适用场景:
- 虚拟主播(VTuber):用真实形象做直播
- 视频会议:不想露脸时用 3D 形象代替
- 数字孪生:MIT Media Lab 用此技术做"数字孪生约会"
场景 4:浏览器内 AI 全语音对话(EdgeSpeaker)
这是 README 中列出的真实应用案例之一,配套工具叫 EdgeSpeaker,集成 Kokoro(浏览器内 TTS)+ Whisper(语音识别)+ Llama 3.2(LLM),配合 TalkingHead 实现"打开网页就能跟 AI 说话、看 AI 表情回应"的完整体验。
用户群体总结
- ✅ 前端开发者:5 分钟集成,零后端部署
- ✅ AI 应用团队:快速搭建 AI 数字人 demo
- ✅ 教育/学术机构:虚拟教师、群组对话研究
- ✅ 创意工作者:VTuber、数字孪生、短视频
- ❌ 不适合:需要 2D 真人写实效果(请用 HeyGen/Linly-Talker)
💰 定价方案
TalkingHead 本身 完全免费 + MIT 开源,可商用、无任何限制。
- 开源协议: MIT License
- 配套成本:
- Ready Player Me 头像:免费(基础款)/ 付费(高级款)
- TTS 服务:Google Cloud 有免费额度,ElevenLabs 按字符收费
- LLM:OpenAI / Gemini / Grok 按 token 收费
💡 零部署成本:所有计算都在浏览器完成,只有 LLM 和 TTS API 按用量计费
🎯 总结
TalkingHead 是 2025-2026 年最值得关注的浏览器端 3D 数字人框架,它解决了传统数字人方案的痛点:不需要 GPU 服务器、不需要后端服务、不需要 SaaS 订阅,前端工程师用 5 行 JavaScript 就能让网页活起来一个会说话、有表情的 3D 数字人。
它已被多个学术项目(UVA DialogLab、MIT Media Lab、CHI 2025)和商业产品(EdgeSpeaker、HeadAudio、Olivia)采用,社区活跃、文档完善。
推荐指数: ⭐⭐⭐⭐⭐(满分 5 星)
适合人群: 前端开发者、AI 应用工程师、教育科研团队、虚拟内容创作者
立即体验: TalkingHead 官网 Demo
GitHub 仓库: met4citizen/TalkingHead
数据截至 2026-06-14,最新信息请以官网为准。