OmniLottie
本文目录
📌 核心价值:复旦大学 OpenVGLab 团队开源的全球首个端到端多模态 Lottie 动画生成器,CVPR 2026 接收,文本/图像/视频三模态输入直接产出生产级 Lottie 动画 JSON。
设计师还在为一组 Loading 动画耗上一整天?让 VLM 直接"说"出 Lottie。
🚀 什么是 OmniLottie?
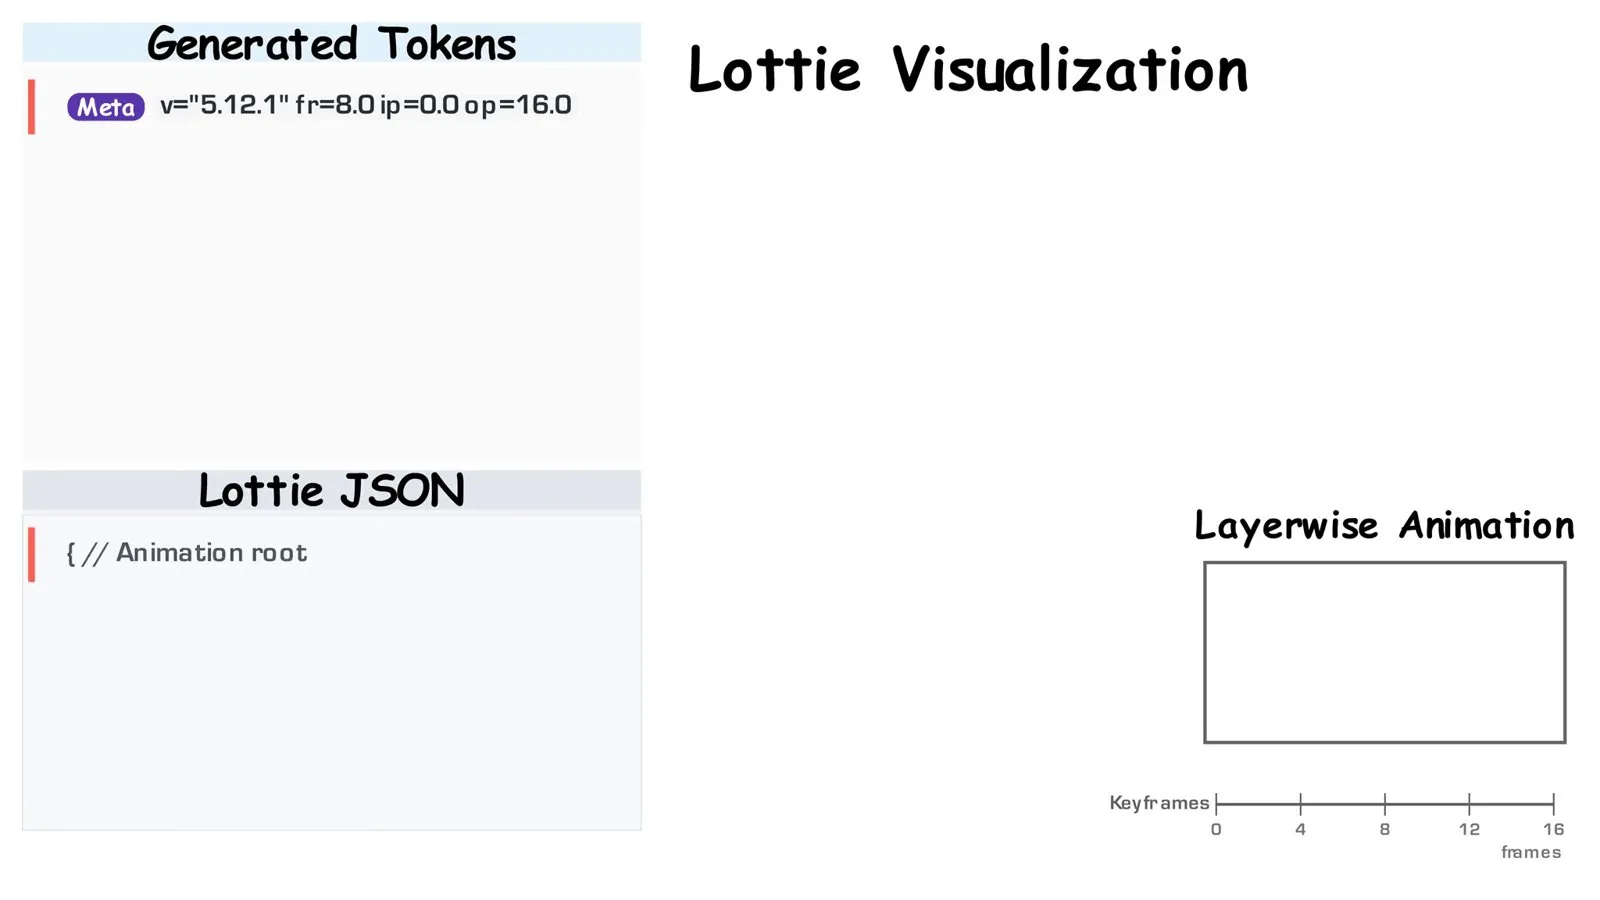
OmniLottie 是复旦大学 OpenVGLab 实验室(Open Vision & Graphics Lab)开源的多模态矢量动画生成框架,CVPR 2026 已接收。它是全球首个支持文本、图像、视频三种模态输入的端到端 Lottie 生成器,底层基于 Qwen2.5-VL 视觉语言模型扩展而来。


核心定位:把"JSON 写不出来"的设计师,从手撕 Lottie Spec 的苦海里捞出来。
伴随模型一同发布的还有:
- MMLottie-2M:200 万条多模态标注的 Lottie 动画数据集
- MMLottieBench:900 样本(real/synthetic 各 450)的标准化评估协议
- LottieTokenizer:将原始 Lottie JSON 压缩为紧凑指令序列(10× 压缩率)
✨ 核心功能一览
| 功能模块 | 描述 | 亮点 |
|---|---|---|
| 多模态输入 | 文本 / 图像 / 视频三模态指令 | 全球首个端到端支持 |
| VLM 架构 | 基于 Qwen2.5-VL 扩展的 4B 模型(8.46 GB) | 无需复杂 pipeline |
| 参数化 Token | LottieTokenizer 将 JSON 转为指令序列 | 10× 数据压缩 |
| 双格式推理 | 原生 PyTorch + HuggingFace 格式 | 部署灵活 |
| Gradio Demo | 官方提供 HF Spaces 在线交互 | 零代码体验 |
| ComfyUI 插件 | 社区贡献的 ComfyUI 节点 | 融入 AIGC 工作流 |
| MMLottie-2M | 200 万标注 Lottie 数据集 | 学术研究基准 |
| MMLottieBench | 900 样本标准化评测 | 公平对比 |
🛠️ 快速上手:5 分钟跑通示例
环境准备
# 推荐:使用 HuggingFace 格式(更轻量)
pip install huggingface-hub

# 下载模型(约 8.46 GB)
huggingface-cli download OmniLottie/OmniLottie --local-dir /PATH/TO/OmniLottie
核心代码示例
Text-to-Lottie(文本生成):
python inference_hf.py \
    --model_path OmniLottie/OmniLottie \
    --text "A bouncing ball" \
    --output output.json
Image-to-Lottie(图像生成):
python inference_hf.py \
    --model_path OmniLottie/OmniLottie \
    --image image.png \
    --text "rotating animation" \
    --output output.json
Video-to-Lottie(视频重建):
python inference_hf.py \
    --model_path OmniLottie/OmniLottie \
    --video video.mp4 \
    --output output.json
启动 Gradio 可视化 Demo:
MODEL_PATH=/PATH/TO/OmniLottie python app_hf.py
注意:模型权重 8.46 GB,建议至少 16GB 显存 GPU(如 RTX 4090 / A100);CPU 推理速度较慢。
📊 与同类方案对比
| 对比维度 | OmniLottie | diffusionstudio/lottie | 传统手工 |
|---|---|---|---|
| 多模态输入 | 文本+图像+视频 | 仅文本 | 不支持 |
| 模型规模 | 4B (8.46 GB) | 轻量(基于 Claude Code) | 无 |
| 输出质量 | 生产级 Lottie JSON | 可用但简单 | 完全可控 |
| 学术背书 | CVPR 2026 | 社区项目 | 无 |
| 数据集规模 | MMLottie-2M(200 万) | 无 | 无 |
| 标准化评测 | MMLottieBench | 无 | 无 |
| ComfyUI 集成 | ✅ 社区插件 | ❌ | ❌ |
| 使用门槛 | 需 GPU + Python | 仅需 Claude API | 需 Lottie Spec 知识 |
💡 适用场景
场景 1:UI/UX 加载动画自动生成
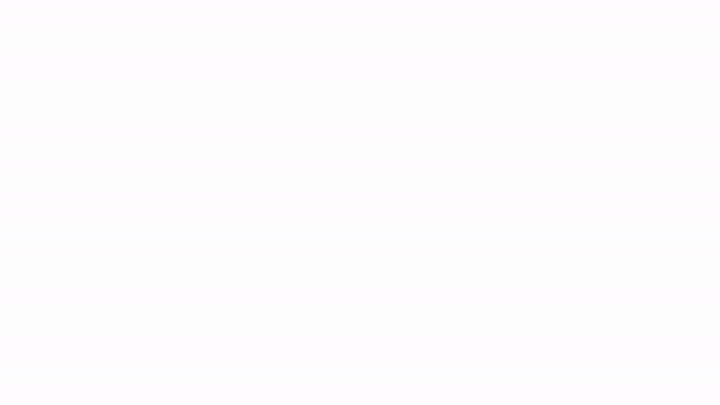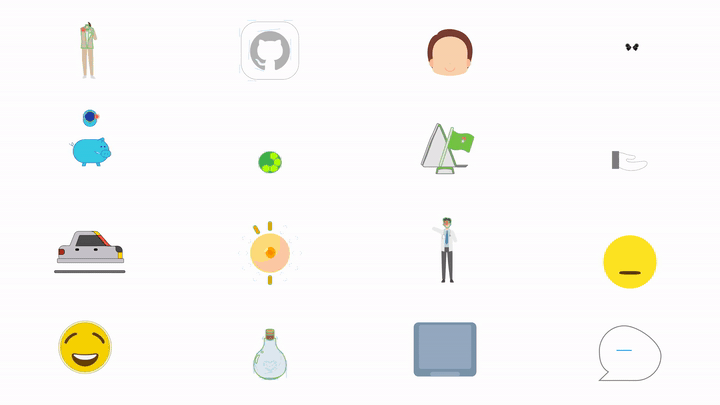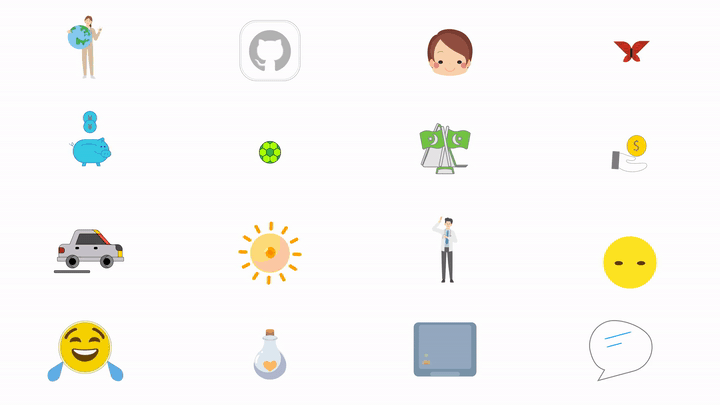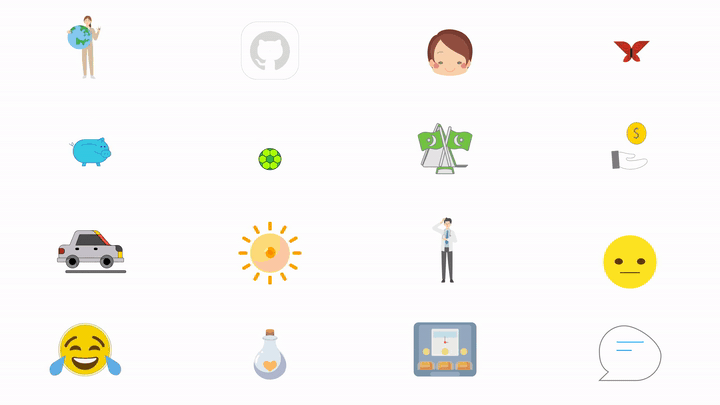
功能说明:设计师只需要描述一句"一个青色长条形笑脸,两个粉色椭圆眼睛带蓝色瞳孔,水平旋转并闪烁星星",模型即产出对应 Lottie JSON。
输入要求:自然语言描述(支持中英文)+ 可选参考图
输出效果:可直接嵌入 Web/iOS/Android 的 Lottie JSON 文件(体积 KB 级)
适用场景:Loading 动画、空状态插画、引导页过渡效果批量生产
场景 2:图像驱动 Lottie 动画化
功能说明:给定一张静态设计稿(如 logo、icon、IP 形象),配合文本指令,模型自动产出可动的 Lottie 矢量动画。
输入要求:参考图(PNG/JPG)+ 动作描述文本
输出效果:保留原图视觉特征的 Lottie 动画
适用场景:电商商品图标动效、品牌 IP 形象动画化、营销活动素材
场景 3:视频转矢量 Lottie
功能说明:将一段真实视频转换为可缩放、跨平台的 Lottie 动画,避免 GIF 模糊 / 文件巨大的问题。
输入要求:视频文件(MP4 等)
输出效果:保持视觉风格的 Lottie 动画,文件大小通常 < 50KB
适用场景:演示视频片段矢量化、教学视频关键帧动效、跨平台宣传素材
场景 4:MMLottieBench 学术评测

功能说明:基于 MMLottieBench(900 样本:real 450 + synthetic 450)的标准化评估协议,可公平对比不同 Lottie 生成模型。
输入要求:待评测的 Lottie 生成模型 + 测试样本
输出效果:可重复的量化指标(视觉相似度、运动一致性等)
适用场景:学术论文实验对比、AIGC 模型 benchmark、自研模型迭代验证
用户群体总结
- ✅ 前端/UI 设计师:摆脱手写 Lottie JSON,提升 10× 效率
- ✅ 独立开发者 / 创业团队:快速产出 App 动效素材,降低设计成本
- ✅ 学术研究者:VLM + 矢量生成的前沿 benchmark
- ✅ ComfyUI 用户:通过插件融入 AIGC 创意工作流
- ❌ 不适合:需要 100% 像素级精确控制的设计场景(仍需手工调 Lottie Spec)
💰 定价方案
完全开源免费!
- 代码:Apache License 2.0(可商用)
- 模型权重:免费可下载(HuggingFace)
- MMLottie-2M 数据集:CC BY-NC-SA 4.0(仅供非商业研究使用)
- 学术论文:可免费下载(arXiv:2603.02138)
开源协议:Apache-2.0
💡 商业使用建议:代码 + 模型可商用,但若需使用 MMLottie-2M 数据集训练衍生模型,仅限非商业用途。
🎯 总结
OmniLottie 重新定义了矢量动画的生产方式——用自然语言直接"说"出 Lottie,配合 200 万条 MMLottie-2M 数据集与 4B 参数 VLM 模型,让端到端的多模态矢量动画生成首次成为可能。对于前端设计师、独立开发者、AIGC 创意工作者来说,这是 2026 年最值得关注的生产力工具之一。
推荐指数: ⭐⭐⭐⭐⭐(满分5星)
适合人群: 前端 / UI 设计师、独立开发者、AIGC 研究者、ComfyUI 玩家
立即体验: HuggingFace Demo | Gradio 本地部署
GitHub 仓库:OpenVGLab/OmniLottie
数据截至 2026-06-15,最新信息请以 GitHub 仓库 为准。