SenseVoice 阿里开源语音大模型
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../SenseVoice-recommend.pptx../../SenseVoice-recommend.mp4本文目录
SenseVoice 阿里开源语音大模型
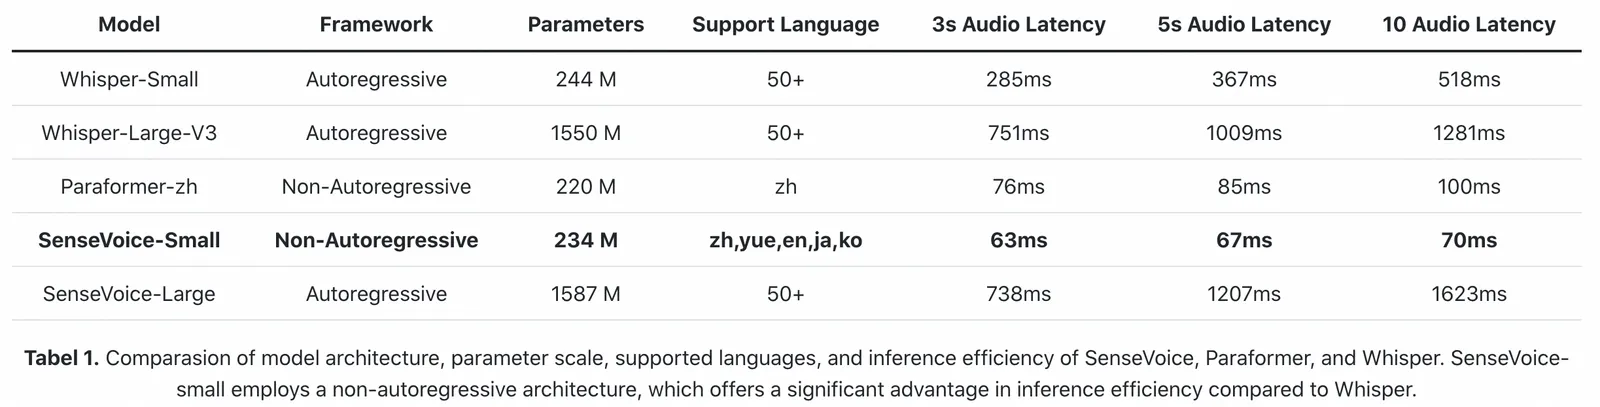
📌 核心价值:阿里通义实验室开源的极速多语言语音理解模型,处理 10 秒音频仅需 70ms,比 Whisper-Large 快 15 倍
同时支持语音识别(ASR)、语种识别(LID)、情感识别(SER)、音频事件检测(AED)四大能力,50+ 语言通用,q8 量化后仅 254MB,移动端/边缘设备也能跑。
🚀 什么是 SenseVoice?
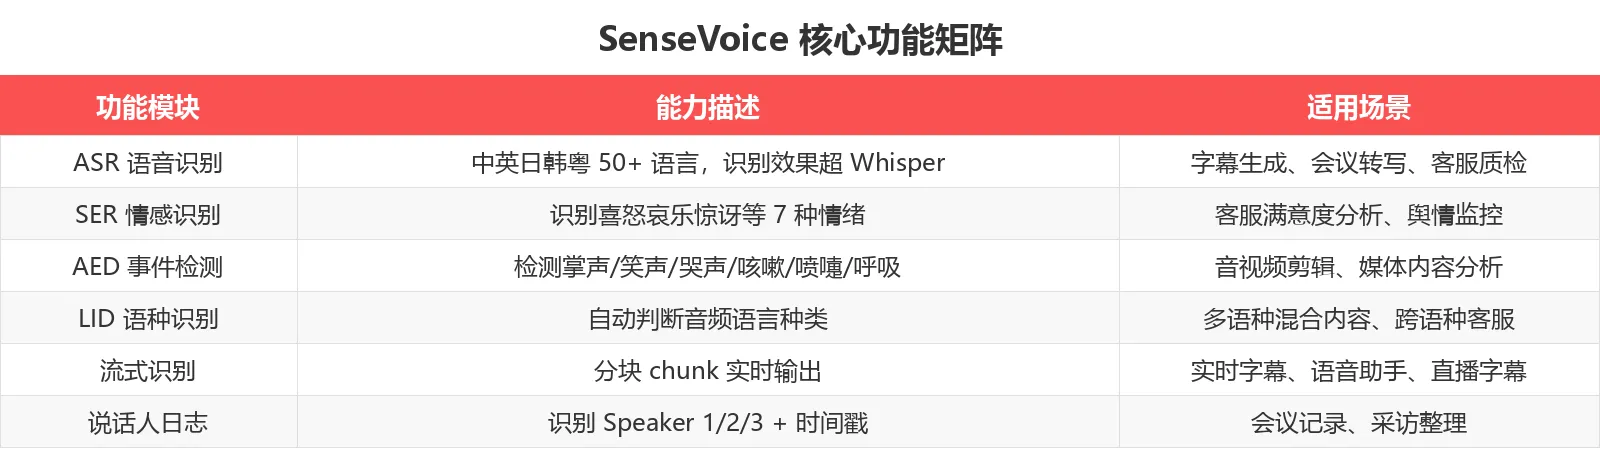
SenseVoice 是阿里通义实验室 FunAudioLLM 家族开源的核心模型,专门解决"语音理解"这一难题。不同于 OpenAI Whisper 只能做"语音→文字"的单一转换,SenseVoice 在一个模型里同时集成 4 大能力:
- ASR(自动语音识别):把音频转成文字
- LID(语种识别):自动判断说的是中文、英文还是粤语
- SER(情感识别):识别说话人是开心、难过还是愤怒
- AED(音频事件检测):识别背景音是掌声、笑声还是咳嗽
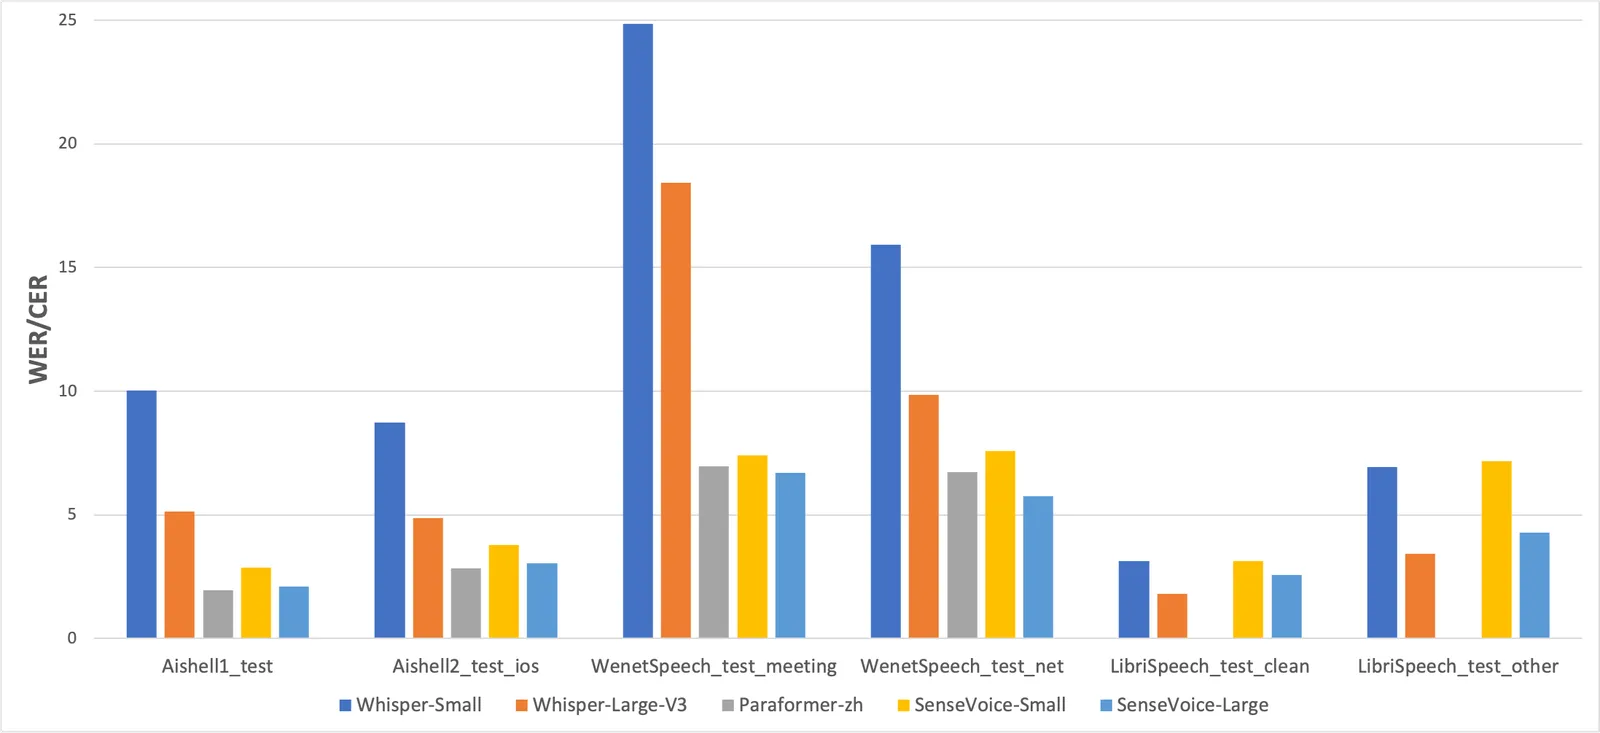
模型用 40 万小时 多语言音频数据训练,覆盖中文、英文、粤语、日语、韩语等 50+ 种语言。在中文识别(CER)和粤语识别上效果都显著优于 OpenAI Whisper 同尺寸模型。


核心定位:Whisper 的中文/粤语加强版 + 情感事件检测 + 推理速度 15x 提升
✨ 核心功能一览
🛠️ 快速上手:5 分钟跑通示例
安装 FunASR
# 推荐使用 ModelScope 源(国内下载快)
pip install funasr modelscope

# 如果用 HuggingFace 源
pip install funasr huggingface_hub
一行代码跑通 ASR
from funasr import AutoModel
from funasr.utils.postprocess_utils import rich_transcription_postprocess

# 加载模型(首次会自动下载 ~234MB)
model = AutoModel(model="iic/SenseVoiceSmall", trust_remote_code=True)

# 识别一段音频
res = model.generate(
    input="test.wav",
    language="auto",   # 自动检测语种:zh/en/yue/ja/ko
    use_itn=True,      # 数字归一化("一百" → "100")
)
text = rich_transcription_postprocess(res[0]["text"])
print(text)
# 输出示例:<|zh|><|HAPPY|>大家好,欢迎使用 SenseVoice 语音识别!
注意:输出文本中的 <|zh|>、<|HAPPY|> 是特殊标签,前者是语种,后者是情感。这种"自包含标签"是 SenseVoice 区别于 Whisper 的关键设计——一个模型同时输出多维度信息。
流式实时识别(语音助手场景)
from funasr import AutoModel

model = AutoModel(model="iic/SenseVoiceSmall", trust_remote_code=True)

# 流式识别:边录边出文字
res = model.generate(
    input="microphone",          # 麦克风输入
    language="zh",
    use_itn=True,
    stream=True,                 # 开启流式
    chunk_size=[0, 10, 5],       # 音频分块:[左窗长, 右窗长, 块长]
)
# 实时输出识别片段
for chunk in res:
    print(rich_transcription_postprocess(chunk["text"]), end="", flush=True)
llama.cpp / GGUF 部署(无需 Python、无需 GPU)
# 1. 下载 GGUF 量化模型(q8 仅 254MB)
bash download-funasr-model.sh sensevoice ./gguf

# 2. 编译 llama-funasr-sensevoice 可执行文件
git clone https://github.com/FunAudioLLM/SenseVoice.cpp
cd SenseVoice.cpp && cmake -B build && cmake --build build -j

# 3. 命令行直接跑(类似 whisper.cpp,但中文/粤语更强)
./build/bin/llama-funasr-sensevoice \
    -m ./gguf/SenseVoiceSmall-f16.gguf \
    --vad ./gguf/fsmn-vad.gguf \
    -a ./test.wav \
    -l zh
📊 与竞品对比
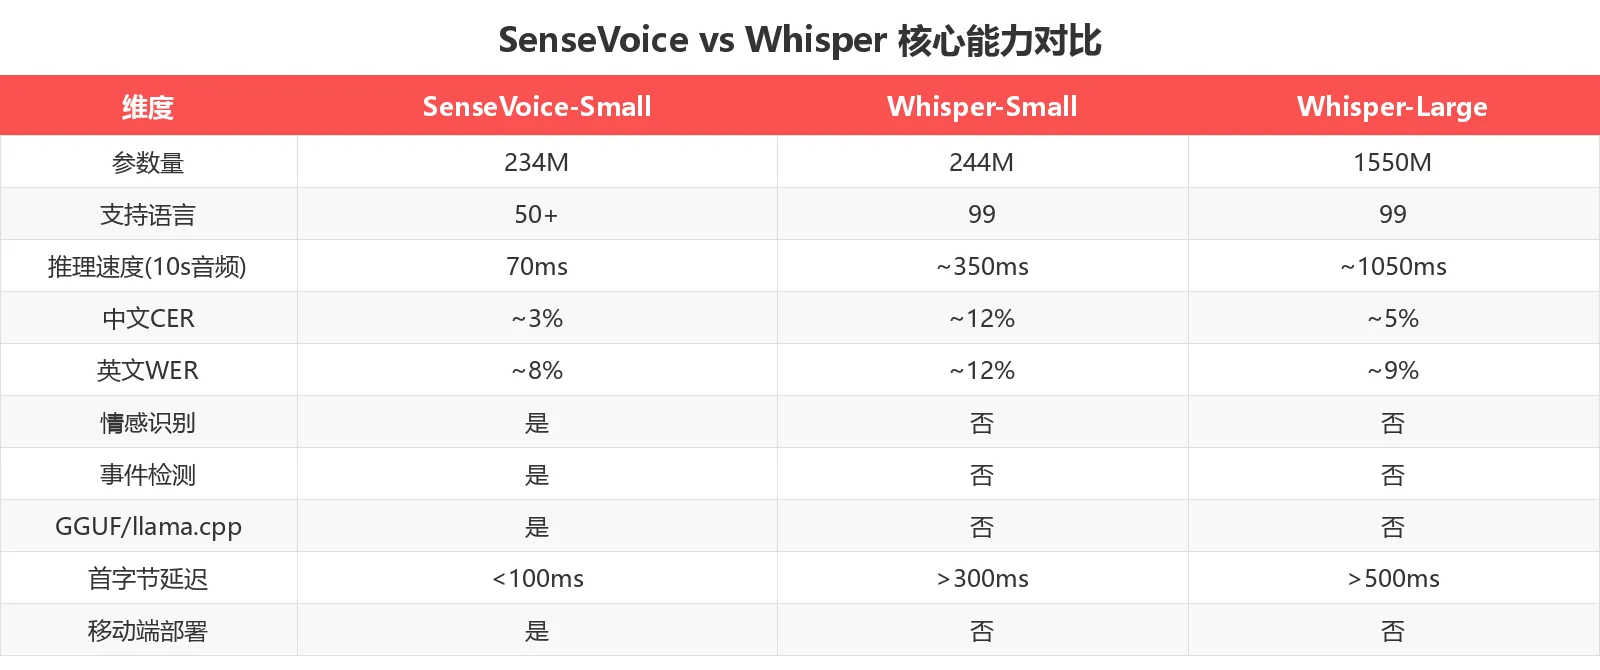
核心优势总结:SenseVoice-Small 234M 参数,推理速度比 Whisper-Large(1550M)快 15 倍,但中文 CER 低至 ~3%(Whisper-Large 是 ~5%)。换言之,用 1/7 的参数量、15x 的速度,拿到比 Whisper-Large 更好的中文识别效果。
💡 适用场景
场景 1:会议录音转写 + 说话人分离
功能说明:SenseVoice 不仅能识别中文、英文、粤语等 50+ 语言,还能自动在输出文本中标注语种标签 <|zh|>、<|yue|>。最新的 2026/05 版本新增了说话人日志(Speaker Diarization),可以自动识别"Speaker 1"、"Speaker 2",并给出每段话的时间戳。
输入要求:mp3/wav 音频文件,任意长度(流式 API 支持实时)
输出效果:
<|zh|><|NEUTRAL|>Speaker 1 [00:00-00:15]: 大家好,今天我们讨论项目进展
<|zh|><|HAPPY|>Speaker 2 [00:15-00:32]: 好的,我这边进展很顺利
<|en|><|NEUTRAL|>Speaker 1 [00:32-00:48>: The first demo is ready
适用场景:会议记录、采访整理、播客转字幕、客服对话分析
场景 2:粤语/英语/普通话混说识别
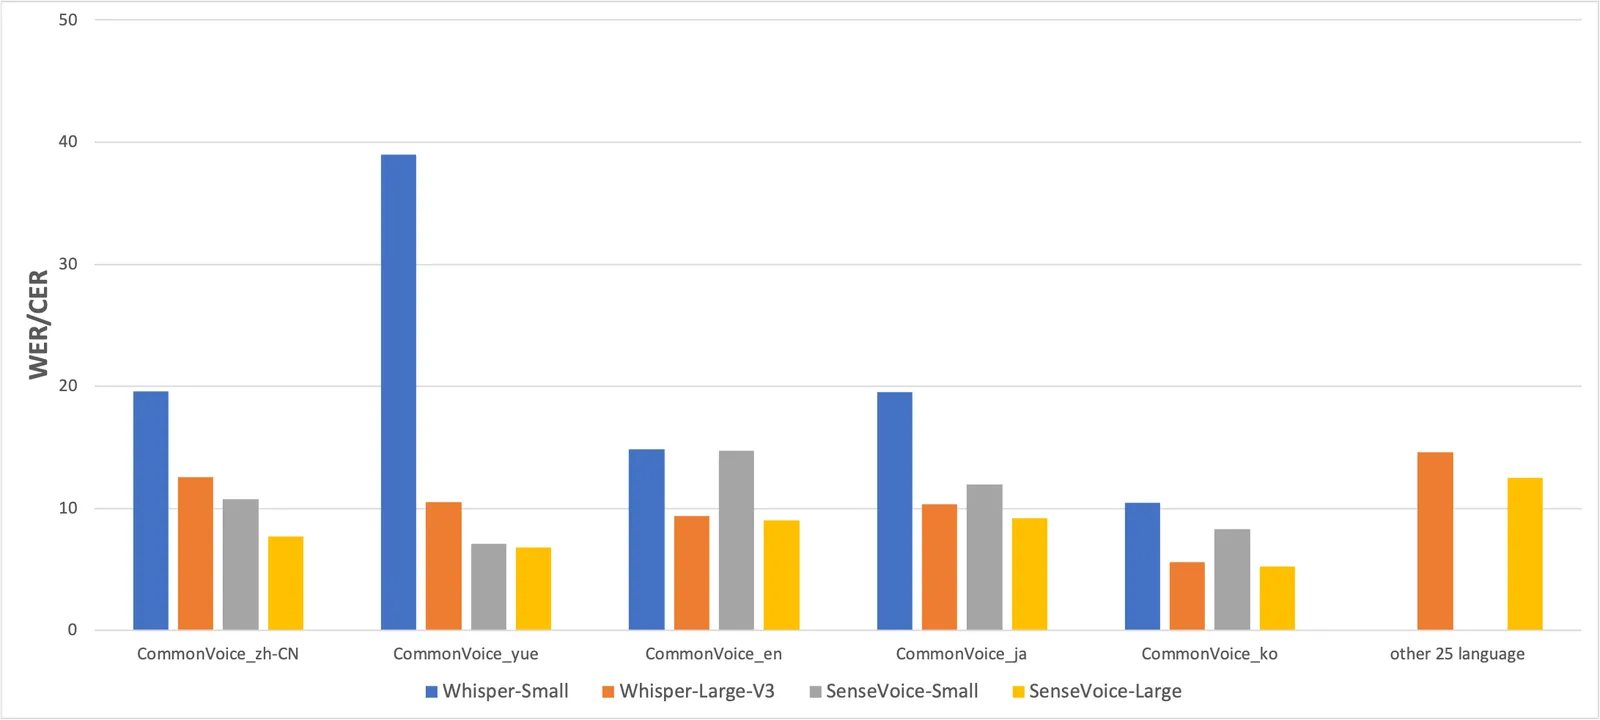
功能说明:SenseVoice 训练数据专门覆盖中文普通话、粤语、英语三语,能在混合语种音频中自动切换识别。这对于粤港澳大湾区、跨境电商客服、外贸直播等场景价值极大。Whisper 在粤语识别上一直偏弱,SenseVoice 直接超越。
输入要求:包含多语种混合的音频
输出效果:自动判断每句话的语种,并应用对应语种的标点和分词规则
适用场景:粤港澳跨境业务、双语直播、跨国会议、外语学习 App
场景 3:情感识别(客服满意度分析)
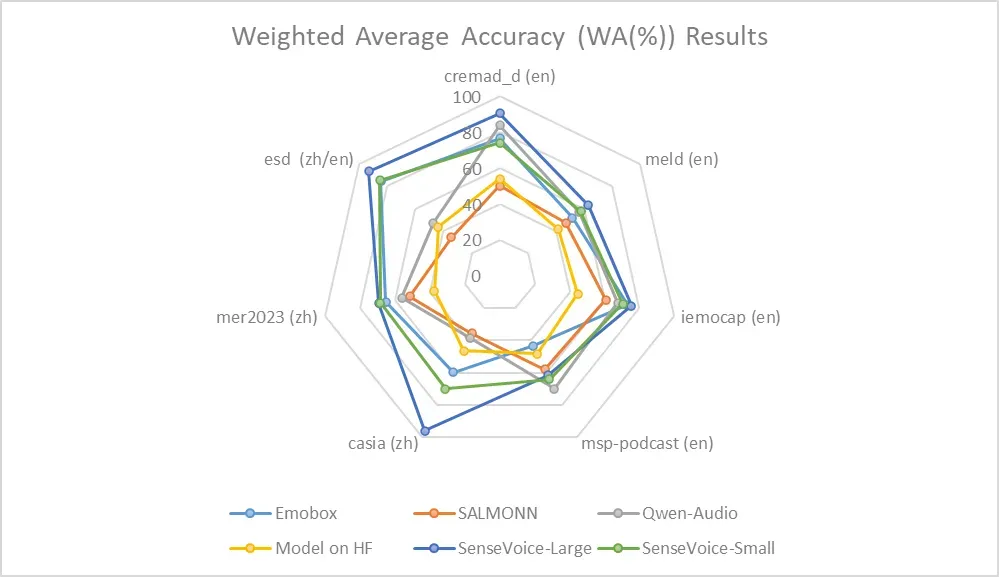
功能说明:SenseVoice 内置 7 种情感识别(喜怒哀乐惊讶厌恶恐惧中性),输出格式为 <|HAPPY|>、<|ANGRY|> 等标签。客服场景下,可以自动标记"客户在生气"或"客户很满意",结合 ASR 转写的话术做满意度评估。
输入要求:客服通话录音
输出效果:
<|ANGRY|>你们这个产品怎么回事,根本不能用!
<|SAD|>我希望你们能改进一下...
<|HAPPY|>感谢客服小姐姐的耐心解答
适用场景:客服质检、舆情监控、心理评估、智能音箱情感反馈
场景 4:音频事件检测(剪辑/标注辅助)
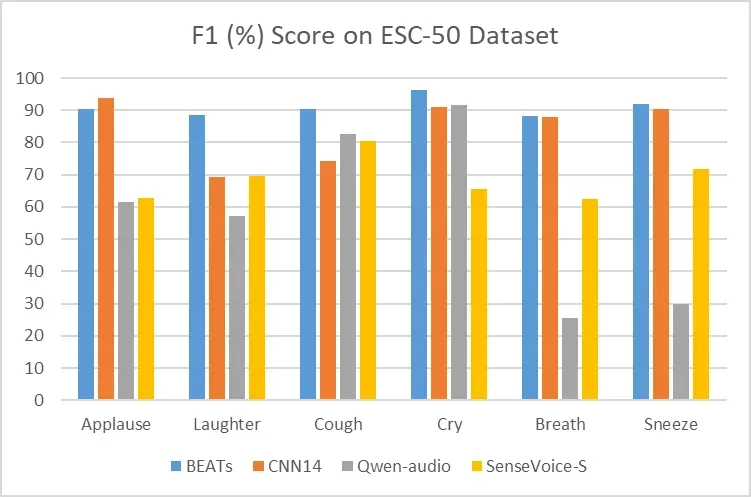
功能说明:SenseVoice 能识别音频中的非语音事件,包括 BGM(背景音乐)、Applause(掌声)、Laughter(笑声)、Cry(哭声)、Cough(咳嗽)、Sneeze(喷嚏)、Breath(呼吸) 等。视频剪辑师可以用它自动找"笑声点"、"掌声点"作为剪辑锚点。
输入要求:音视频文件
输出效果:
[00:12.3] <|Applause|>  ← 自动标注掌声
[00:18.7] <|Laughter|>  ← 自动标注笑声
[00:25.0] <|Speech|>大家好...  ← 自动识别语音起止
适用场景:播客剪辑、视频自动字幕标注、媒体内容分析、无障碍辅助(识别哭声/咳嗽用于看护)
场景 5:WebUI 可视化体验
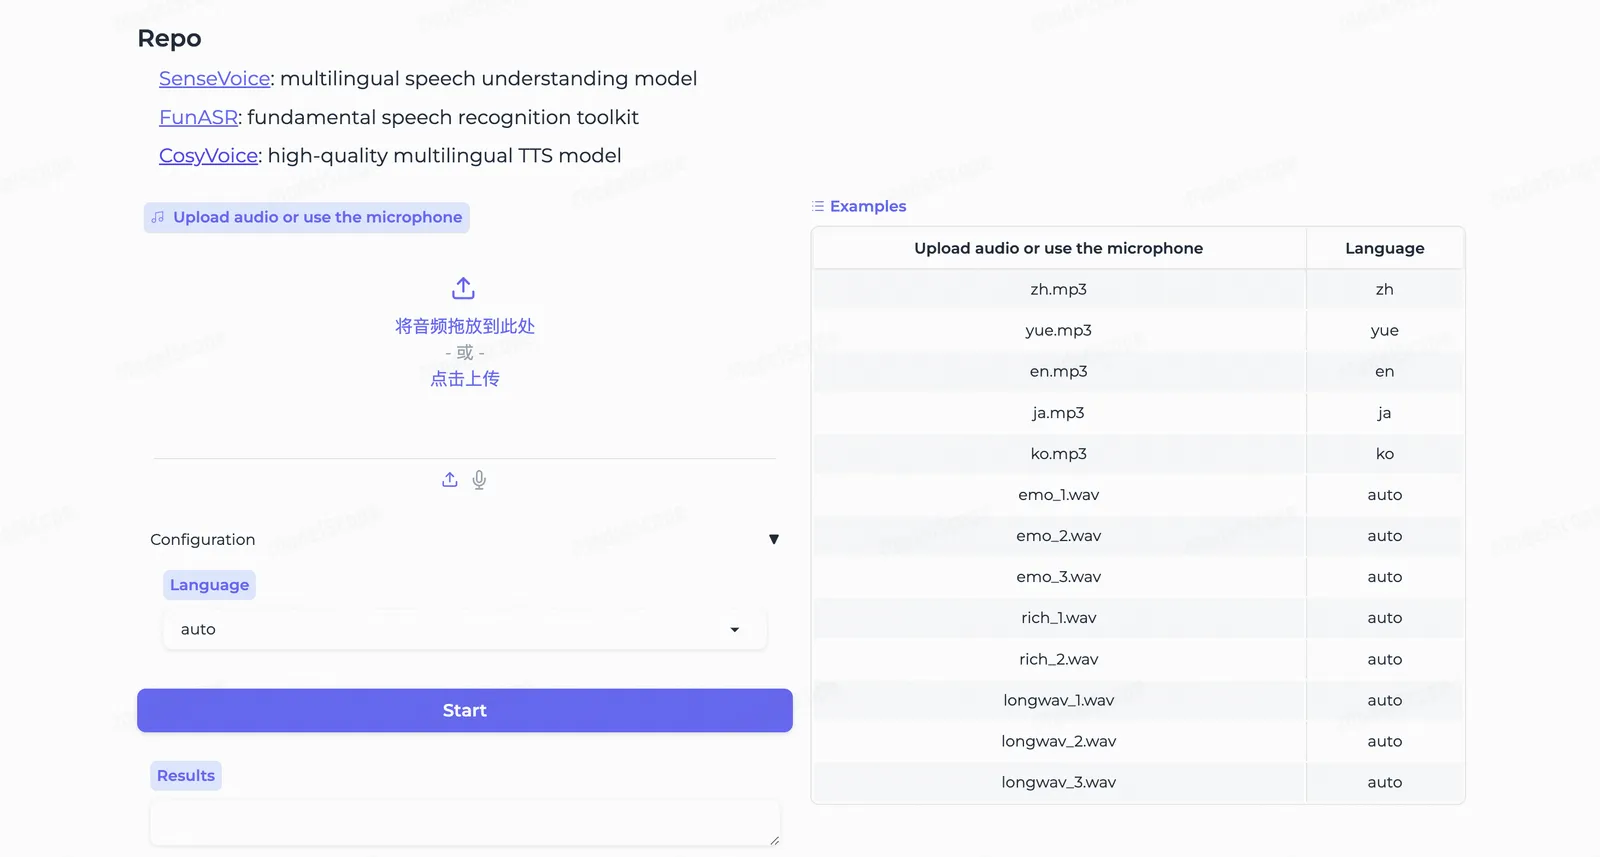
功能说明:官方提供了基于 Gradio 的 WebUI,下载模型后直接 python webui.py 就能在浏览器中拖入音频文件、看识别结果、试听对照。适合快速验证效果和非开发同学使用。
输入要求:浏览器访问 http://localhost:7860
输出效果:可视化界面,显示 ASR 文本、语种标签、情感标签、事件标签
适用场景:技术选型对比、Demo 演示、教学场景、效果评估
场景 6:推理流程(FastAPI / Docker 部署)
功能说明:SenseVoice 提供了完整的部署方案,包括 FastAPI 服务、Docker 镜像、Docker Compose 编排。生产环境可以用 VAD 模型先切分长音频(fsmn-vad),再分片送入 SenseVoice 处理,避免 OOM;推理完成后用标点模型(ct-punc)补全标点。
输入要求:长音频文件(数小时会议录音)
输出效果:分片处理 + 说话人合并 + 时间戳对齐的完整转写
适用场景:长会议录音、客服通话系统、音视频字幕生产
用户群体总结
- ✅ AI 应用开发者:需要本地化、低延迟、多语种的语音理解能力
- ✅ 客服/外呼系统:需要情感识别 + 说话人分离 + ASR 联合分析
- ✅ 媒体/视频剪辑师:需要事件检测(掌声/笑声锚点)+ 字幕生成
- ✅ 跨境电商/外贸团队:需要中英粤混合识别
- ✅ 教育/科研机构:需要一个开源、可商用、轻量的语音基础模型
- ❌ 不适合:需要在线 SaaS 服务的用户(SenseVoice 是本地模型,需要自己部署)
💰 定价方案
完全开源免费:
- 模型权重:Apache-2.0 协议,商用免费
- 代码仓库:https://github.com/FunAudioLLM/SenseVoice
- 模型下载:
- GGUF 量化版:https://huggingface.co/FunAudioLLM/SenseVoiceSmall-GGUF(q8 仅 254MB)
硬件要求:
| 部署方式 | 最低配置 |
|---|---|
| SenseVoice-Small FP16 | GPU 4GB(如 RTX 3050) |
| SenseVoice-Small INT8 (ONNX) | CPU 可跑,移动端可用 |
| SenseVoice-Small GGUF q8 | 任意 CPU,单核也能跑 |
| SenseVoice-Large(未开源) | GPU 16GB+ |
💡 对比 Whisper:Whisper-Large-v3 商用必须遵守 OpenAI 条款,而 SenseVoice Apache-2.0 完全无限制。
🎯 总结
SenseVoice 是一款"小而强"的多语言语音理解模型,对中文和粤语的识别能力远超 Whisper 同尺寸模型,同时集成情感识别、事件检测、说话人分离等 Whisper 没有的能力,加上 15x 的推理速度优势,是 2026 年本地化语音 AI 应用的首选基础模型。
推荐指数:⭐⭐⭐⭐⭐(满分 5 星)
适合人群:需要在本地部署、低延迟、多语种、含情感/事件检测的语音 AI 应用的开发者
立即体验:
- GitHub 仓库:FunAudioLLM/SenseVoice
- ModelScope 模型:iic/SenseVoiceSmall
- HuggingFace 模型:FunAudioLLM/SenseVoiceSmall
开源协议: Apache-2.0
数据截至 2026-06-24,最新信息请以官方 GitHub 仓库为准。