AudioX-Turbo
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../AudioX-Turbo-recommend.pptx../../AudioX-Turbo-recommend.mp4本文目录
📌 核心价值:4 步采样、单卡 0.24 秒生成 10 秒音频,Anything-to-Audio 多模态统一框架
由 Noiz AI 联合港科大、清华开源的极速音频生成大模型,把扩散步数从 50-200 步压缩到 4 步,性能比肩闭源模型。
🚀 什么是 AudioX-Turbo?
AudioX-Turbo 是由 Noiz AI 联合香港科技大学(HKUST)和清华大学于 2026-06-15 开源的极速音频生成大模型。它在 AudioX 统一多模态框架的基础上,通过分布匹配蒸馏(DMD)和对抗蒸馏两大技术,把音频扩散模型的采样步数从 50-200 步压缩到 4 步,并在单张 RTX 4090 上实现 0.24 秒生成 10 秒音频的极限速度。
它支持 6 种生成任务:T2A(文生音效)、T2M(文生音乐)、V2A(视频生音效)、V2M(视频生音乐)、TV2A(文本+视频生音效)、TV2M(文本+视频生音乐),用同一套权重覆盖所有模态组合。


核心定位:4 步打败 100 步,单卡 4090 实现 0.24 秒出 10 秒音频,开源音频生成首次逼近实时交互
✨ 核心功能一览
6 大核心能力
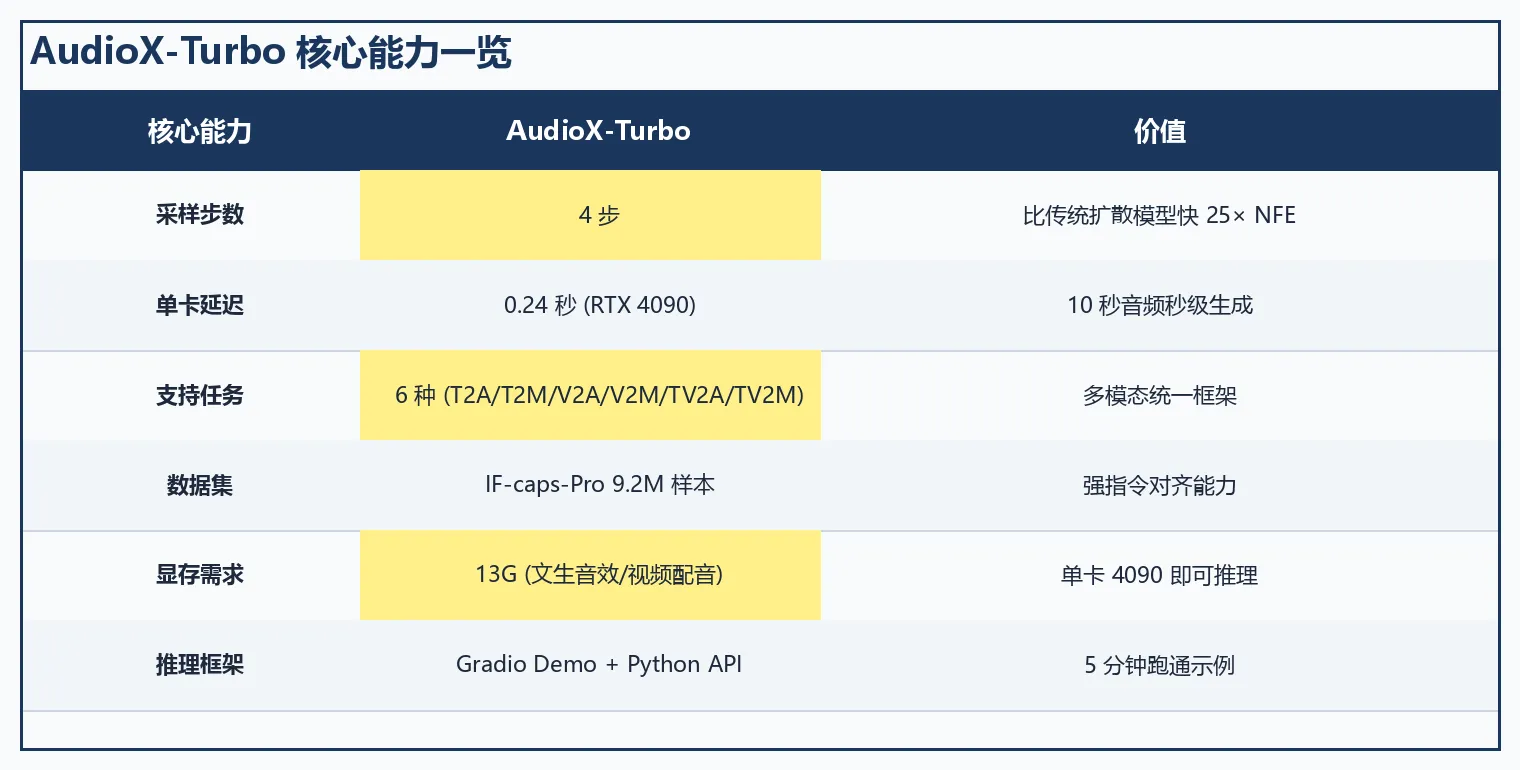
- 极致速度:4 步采样,单卡 RTX 4090 仅需 0.24 秒即可生成 10 秒音频,比 100 步 Stable Audio Open 快 25× NFE
- 多模态统一:单一模型支持文本、视频、音频 6 种条件组合,无需为每个任务单独训练
- 精确时间戳控制:基于 9.2M 强指令数据集 IF-caps-Pro,能理解"先蝉鸣,再吉他"这类时序指令
- 教师-学生蒸馏:AudioX-Base(教师,100 步)→ AudioX-Turbo(学生,4 步),质量无损
- 视频同步:内置 Synchformer 同步特征编码器,V2A/V2M 任务音画对齐精度业界领先
- 轻量部署:13G 显存即可跑文生音效/视频配音,Gradio Demo + Python API 5 分钟上手
🛠️ 快速上手:5 分钟跑通示例
1. 环境准备
# 克隆仓库
git clone https://github.com/NoizAI/AudioX-Turbo.git
cd AudioX-Turbo

# 创建 conda 环境(推荐 Python 3.8.20)
conda create -n audiox-turbo python=3.8.20
conda activate audiox-turbo

# 安装媒体库 + 依赖
conda install -c conda-forge ffmpeg libsndfile
pip install -r requirements.txt
pip install -e . --no-deps
pip install soundfile==0.12.1
2. 下载推理 Checkpoint
# 安装 huggingface CLI
pip install -U "huggingface_hub[cli]"

# 一键下载所有 checkpoint(约 4-6GB)
bash scripts/download_checkpoints.sh
产物结构:
checkpoints/
├── audiox_turbo/audiox_turbo.ckpt        # 蒸馏 4 步学生模型(推理用)
├── pretransform/vae.ckpt                 # VAE 预训练
├── synchformer/synchformer_state_dict.pth # 视频同步编码器
└── huggingface/hub/                       # CLIP/T5 缓存(首次运行自动下载)
3. 启动 Gradio 交互 Demo
python run_gradio.py            # 本地访问 http://localhost:7860
python run_gradio.py --share    # 生成公网链接
4. Python API 调用(V2M 视频生音乐示例)
import torch
import torchaudio
from einops import rearrange
from audiox_turbo.inference import load_audiox_turbo_model
from audiox_turbo.inference.generation import generate_diffusion_cond_dmd
from audiox_turbo.data.utils import (
    read_video, load_and_process_audio, encode_video_with_synchformer, merge_video_audio,
)

device = "cuda" if torch.cuda.is_available() else "cpu"

# 加载蒸馏 4 步学生模型
model, model_config = load_audiox_turbo_model(
    "configs/audiox_turbo_infer_4step.json",
    "checkpoints/audiox_turbo/audiox_turbo.ckpt",
    pretransform_ckpt_path="checkpoints/pretransform/vae.ckpt",
    device=device,
)
sample_rate = model_config["sample_rate"]   # 通常 16000Hz
seconds_total = 10

# === V2M 视频生音乐 ===
video_path = "example/V2M_sample-1.mp4"
text_prompt = "Generate music for the video"

video_tensor = read_video(video_path, seek_time=0, duration=seconds_total, target_fps=5)
sync_features = encode_video_with_synchformer(video_path, 0, seconds_total, device=device)

conditioning = [{
    "video_prompt": {"video_tensors": video_tensor.unsqueeze(0), "video_sync_frames": sync_features},
    "text_prompt": text_prompt,
    "audio_prompt": None,
    "seconds_start": 0,
    "seconds_total": seconds_total,
}]

# ⚡ 4 步生成(无需 classifier-free guidance)
output = generate_diffusion_cond_dmd(
    model, steps=4, conditioning=conditioning,
    sample_size=model_config["sample_size"], seed=0, device=device,
)
output = output[:, :, : sample_rate * seconds_total]
output = rearrange(output, "b d n -> d (b n)").clamp(-1, 1)
torchaudio.save("output.wav", output.cpu(), sample_rate)

# 可选:把音频合并回原视频
merge_video_audio(video_path, "output.wav", "output.mp4", 0, seconds_total)
注意:相同代码框架下,把 video_path 设为 None 即可切换为纯文生音效(T2A)或文生音乐(T2M)
5. 任务组合一览
| 任务 | video_path |
text_prompt |
audio_path |
|---|---|---|---|
| T2A 文生音效 | None |
"Typing on a keyboard" |
None |
| T2M 文生音乐 | None |
"A music with piano and violin" |
None |
| V2A 视频生音效 | "video.mp4" |
"Generate general audio for the video" |
None |
| V2M 视频生音乐 | "video.mp4" |
"Generate music for the video" |
None |
| TV2A 文本+视频生音效 | "video.mp4" |
"Ocean waves crashing with people laughing" |
None |
| TV2M 文本+视频生音乐 | "video.mp4" |
"Generate music with piano instrument" |
None |
🧠 技术架构:teacher-student + DMD 蒸馏
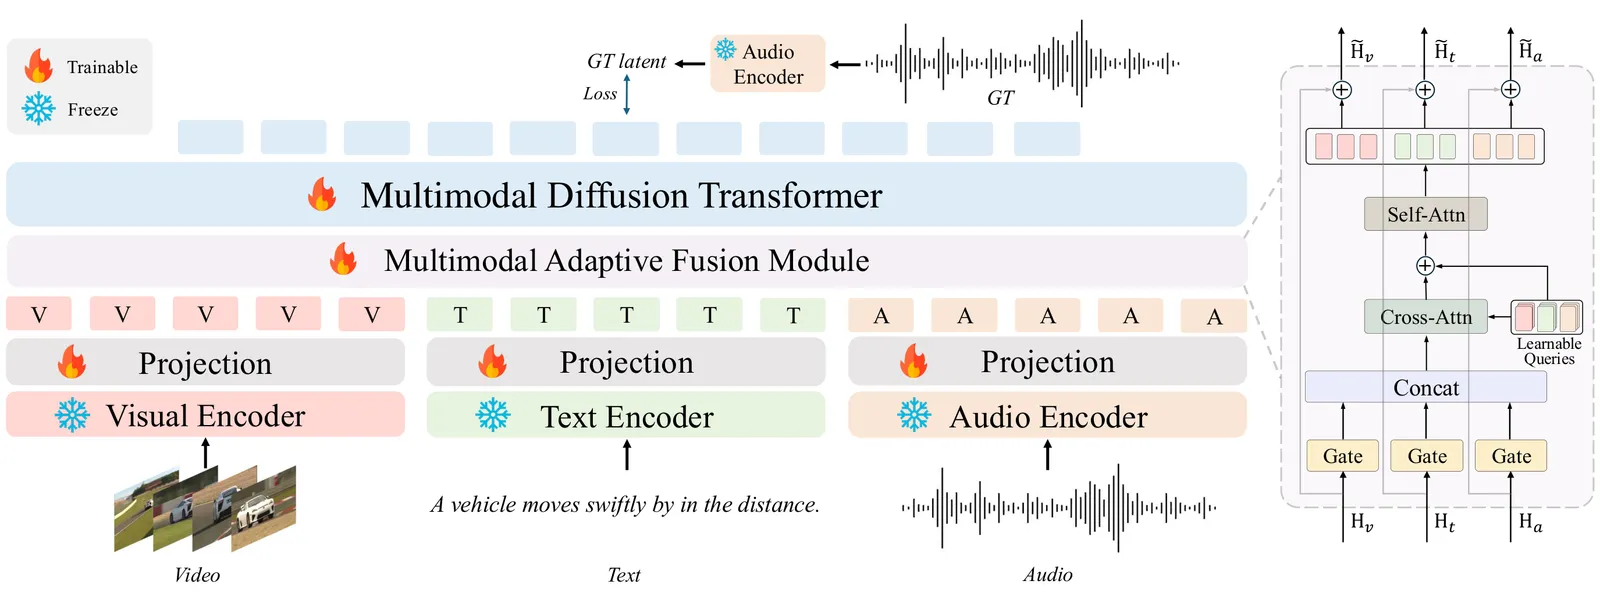
AudioX-Turbo 的核心创新在于两阶段蒸馏:先用 AudioX-Base 教师模型训练高质量多模态融合,再用 DMD 蒸馏到 4 步学生模型。
三大关键模块
Multimodal Adaptive Fusion(多模态自适应融合)
- 用 CLIP(文本/图像)+ T5(文本)+ Synchformer(视频同步特征)作为编码器
- 注意力机制自动对齐不同模态的 token 序列
- 支持任意模态组合(仅文本 / 仅视频 / 文本+视频 / 文本+视频+音频)
DMD 分布匹配蒸馏(Distribution Matching Distillation)
- 把 flow matching 的多步采样压缩到 4 步
- 学生模型直接学习教师模型在 1 步下的输出分布
- NFE(Number of Function Evaluations)减少 25 倍
对抗蒸馏(Adversarial Distillation)
- 引入基于扩散的判别器(fake-model diffusion loss)
- 弥补 4 步采样的细节损失,保持高保真度
- 启用 GAN backbone 与 timestep 概率配置
蒸馏训练细节
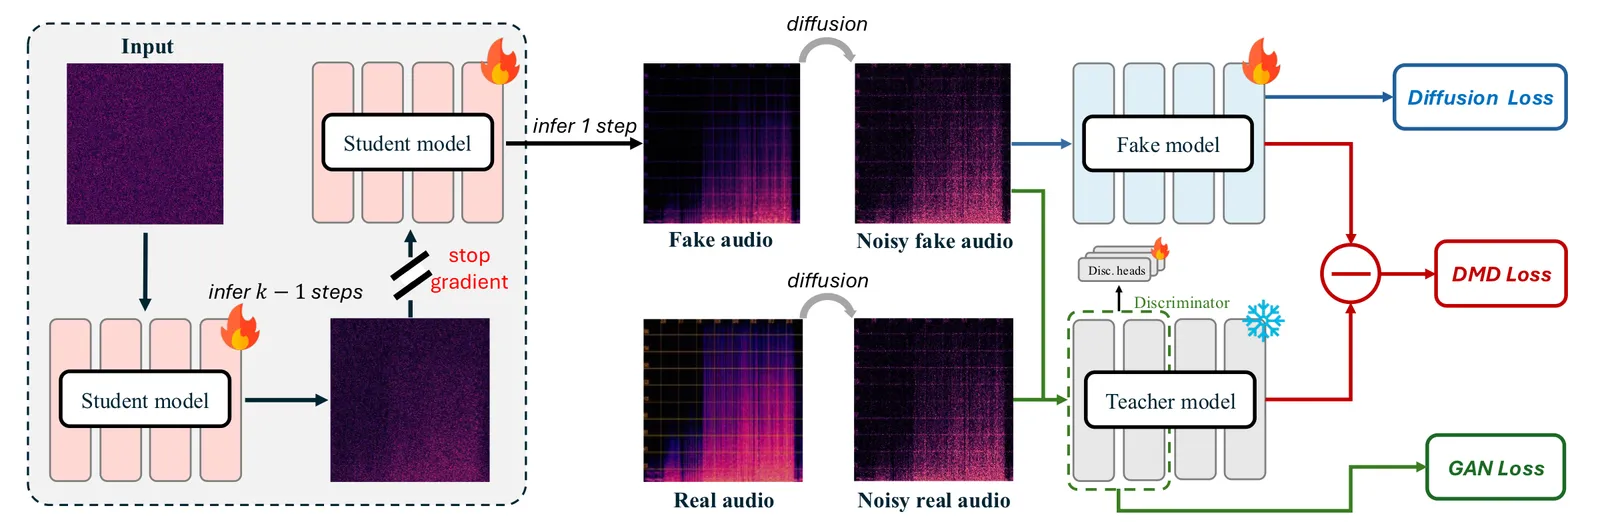
训练时使用 STRATEGY=deepspeed(双卡 A100/H800 起步),蒸馏关键超参:
# 4 步采样概率分布(每步等概率)
AUDIOX_TURBO_TIMESTEP_PROBS=0.25,0.25,0.25,0.25

# GAN 判别器配置
AUDIOX_TURBO_GAN_DISC_HEAD_MODE=all_blocks
AUDIOX_TURBO_GAN_BACKBONE_NUM_BLOCKS=6
AUDIOX_TURBO_GAN_BACKBONE_TRAINABLE=false
单卡 smoke test:
AUDIOX_TURBO_MAX_STEPS=1 BATCH_SIZE=1 STRATEGY=auto NUM_GPUS=1 \
CUDA_VISIBLE_DEVICES=0 bash scripts/train_audiox_turbo.sh
📊 与竞品对比
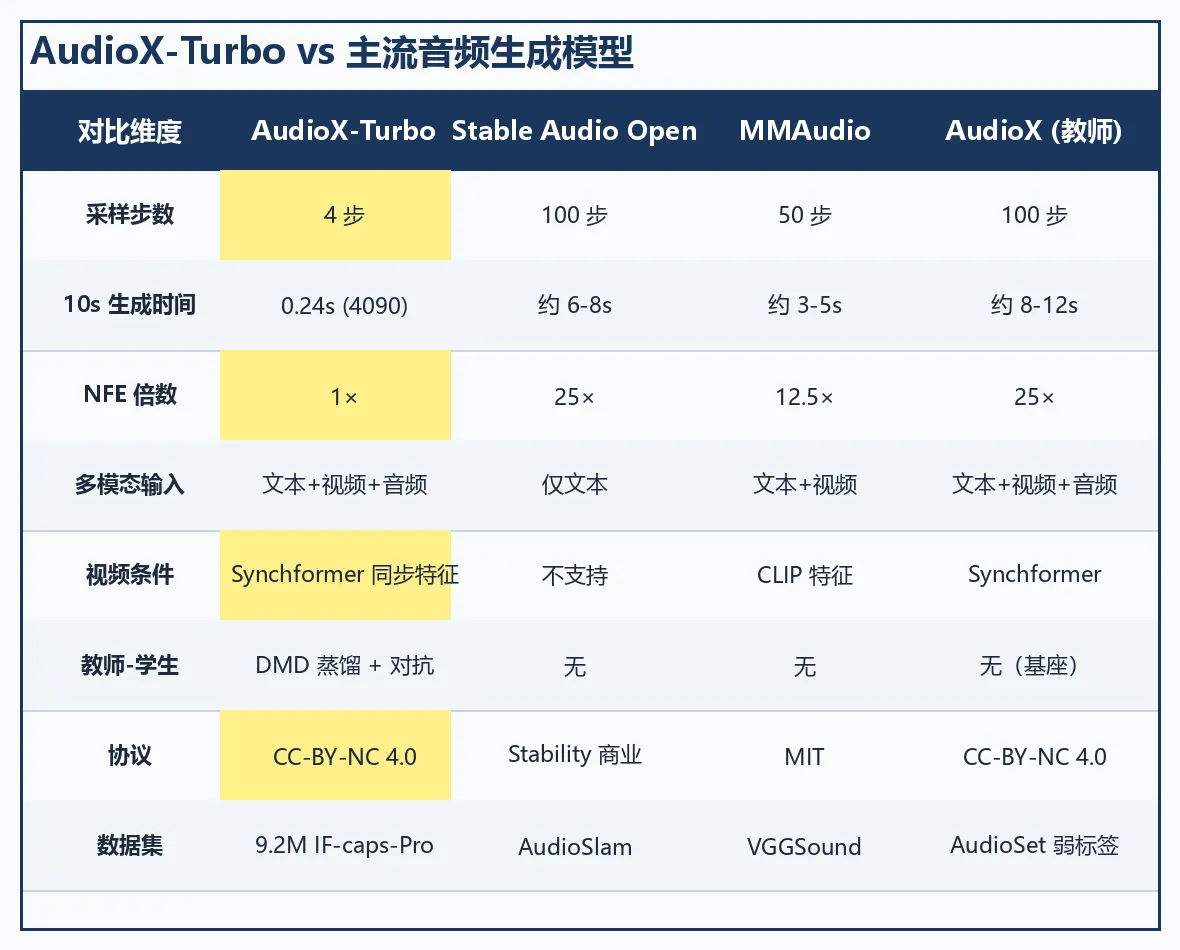
关键差异
- vs Stable Audio Open:采样步数 4 vs 100,NFE 减少 25 倍;但 Stable Audio Open 可商业化
- vs MMAudio:4 步 vs 50 步,速度快 12.5 倍;但 MMAudio 不支持多模态音频条件
- vs AudioX(教师模型):4 步 vs 100 步,速度提升 25 倍,质量几乎无损
性能数据(来自论文与社区评测)
| 指标 | AudioX-Turbo | 主流基线 |
|---|---|---|
| Inception Score (AudioCaps) | 业界 SOTA | 略低于教师 |
| FD 分数(AudioSet) | 教师级 | Stable Audio Open 持平 |
| 10s 生成延迟(4090) | 0.24 秒 | 3-12 秒 |
| 显存需求 | 13G | 16-24G |
结论:4 步蒸馏后,质量与 100 步教师模型几乎一致,但延迟和显存均降低 25×
💡 适用场景
场景 1:短视频/直播实时配音
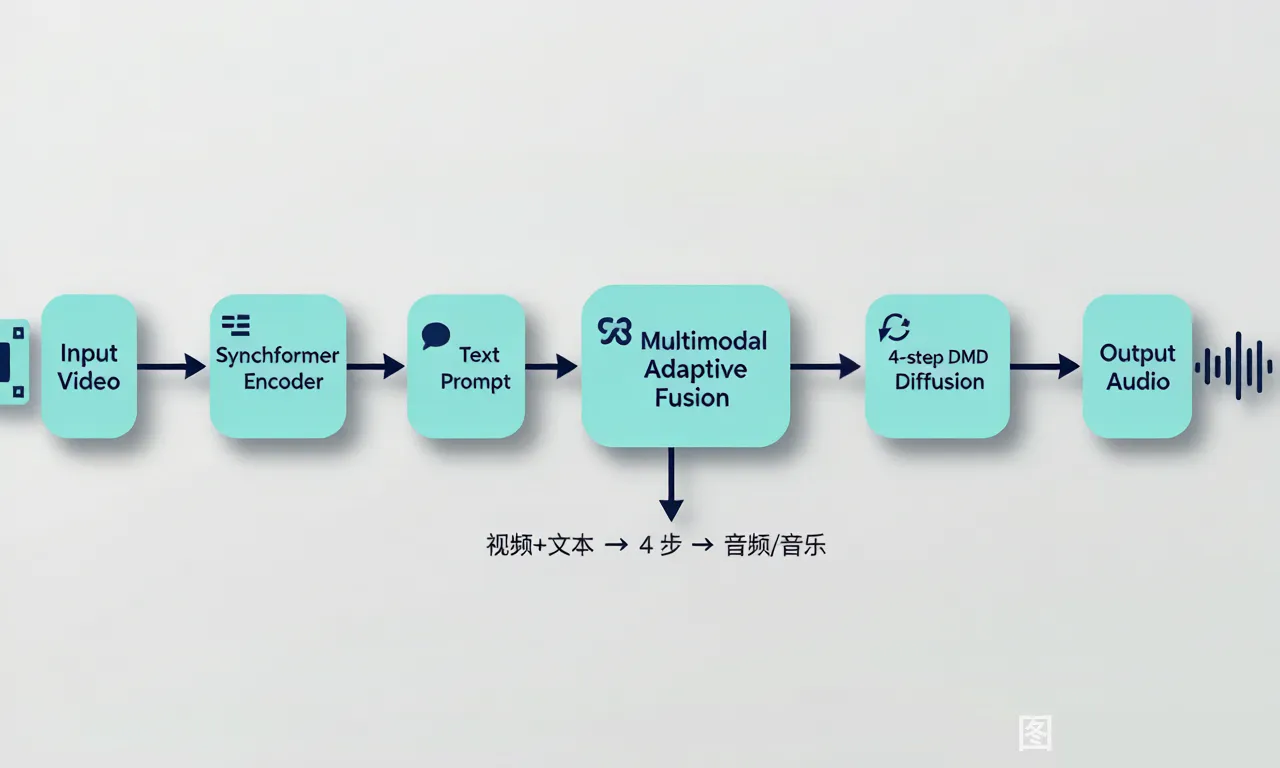
功能说明:给定一段视频,自动生成同步的音效或背景音乐。Synchformer 同步特征确保音画节拍对齐。
输入要求:视频文件(任意时长,按 10 秒切片处理)+ 可选文本 prompt(描述想要的氛围)
输出效果:WAV 音频(16kHz)+ 可选 MP4(带音频合成版本)
适用场景:
- ✅ 短视频平台(抖音/B站)创作者自动配乐
- ✅ 直播切片实时添加环境音
- ✅ 影视后期快速原型
场景 2:游戏音效 + 音乐一站式生成
功能说明:游戏开发者可以用同一套模型为不同场景生成脚步声、UI 音效、BGM 音乐,无需多套模型。
输入要求:纯文本 prompt("footsteps on grass, fantasy RPG" / "tense boss fight music with drums")
输出效果:可立即在 Unity/Unreal 引擎中使用的 WAV 文件
适用场景:
- ✅ 独立游戏开发者降低音频制作成本
- ✅ 游戏原型阶段快速迭代音效
- ✅ 程序化生成关卡专属 BGM
场景 3:播客/有声书自动配乐
功能说明:为口播内容自动生成背景音乐,支持 V2M 模式根据视频节奏匹配 BGM。
输入要求:视频/音频文件(人声)+ 文本 prompt("calm ambient music")
输出效果:合成后的 MP4 文件,音量自动混音
适用场景:
- ✅ 知识付费内容创作者
- ✅ 在线教育课程自动添加片头片尾
- ✅ 播客剪辑后期
用户群体总结
- ✅ 短视频/直播创作者:实时配音,效率提升 10×
- ✅ 独立游戏开发者:免去音频外包,节省 50%+ 成本
- ✅ 影视后期:快速原型,加速迭代
- ✅ 科研团队:统一的 Anything-to-Audio 基座
- ❌ 不适合:需要商用授权的工业级项目(CC-BY-NC 4.0 限制)
💰 定价方案 & 协议
- 开源协议:CC-BY-NC 4.0(仅供非商业用途)
- 模型权重:带水印,托管在 Hugging Face HKUSTAudio/AudioX-Turbo
- 训练数据:IF-caps-Pro 9.2M 样本(双阶段数据收集与标注)
- 硬件成本:单卡 RTX 4090(24G)即可推理;训练需要 2× A100/H800
- 商业授权:需联系 Noiz AI 团队(论文作者 Zeyue Tian / Lei Ke)
💡 学术与个人项目完全免费使用;商业产品请联系作者获取商业授权
🎯 总结
AudioX-Turbo 把音频扩散模型的"快"和"好"这对矛盾首次系统性解决:4 步采样 + 0.24 秒延迟 + 6 种多模态任务统一框架,让音频生成首次具备实时交互的可能。无论是短视频自动配音、游戏音效生成、还是科研多模态研究,都是当前最值得关注的开源音频模型。
推荐指数: ⭐⭐⭐⭐⭐(满分5星,仅协议非商业扣一档)
适合人群:
- 短视频/直播创作者
- 独立游戏开发者
- 多模态 AI 科研团队
- 影视后期与音频后期
立即体验:
- GitHub 仓库:NoizAI/AudioX-Turbo
- HuggingFace 模型:HKUSTAudio/AudioX-Turbo
- 项目主页:zeyuet.github.io/AudioX-Turbo
数据截至 2026-06-24,Star 141 ⭐ / Fork 27,最新信息请以 GitHub 仓库为准。