SAG
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../SAG-recommend.pptx../../SAG-recommend.mp4本文目录
📌 核心价值:比 HippoRAG 2 多跳召回 Recall@2 提升 11.16 个百分点,开箱即用的下一代 RAG 检索框架
别再往模型里塞一堆 chunk 了!SAG 用「事件 + 实体」双层结构组织文档知识,多跳召回直接起飞。
🚀 什么是 SAG?
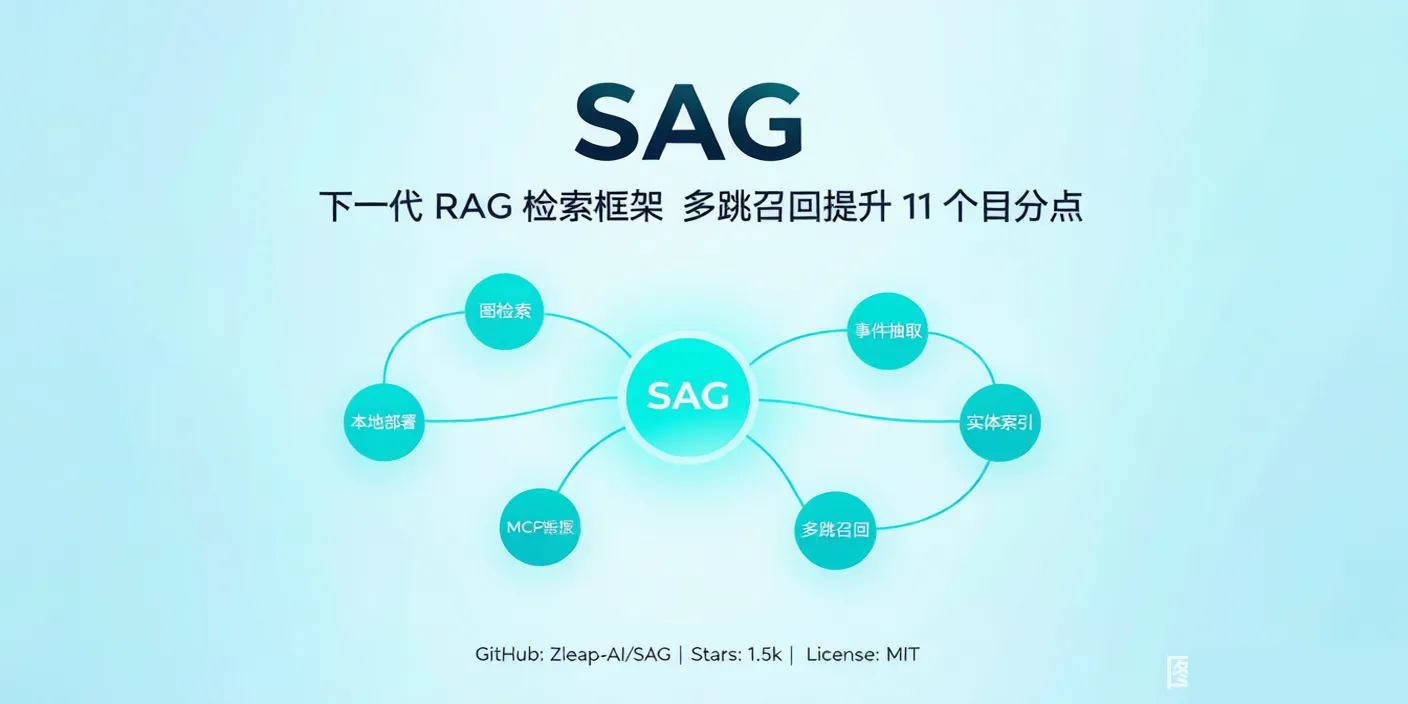
SAG(Search-Augmented Generation / SQL-Driven Smart Auto Graph Engine)是一个专为 AI Agent 设计的下一代 RAG 检索框架,由 Zleap-AI 开源。


与传统的「往模型里塞更多 chunk」思路不同,SAG 采用一种更轻量的结构来组织文档知识:
chunk  →  event  (完整语义单元)
chunk  →  entities (多维实体抽取)
event  ←→  entities  (多跳关联)
每个文本块自动抽取一个完整事件(event)和多个实体(entities)。事件保留原文的完整语义,实体构建索引并支持关系扩展。检索时,先从匹配的事件出发,再通过多跳召回继续挖掘,无需重建重型知识图谱。
核心定位:在 HotpotQA / 2WikiMultiHop / MuSiQue 三大多跳问答基准上,Recall@2 平均从 HippoRAG 2 的 68.14% 提升到 79.30%(+11.16pp,相对提升约 16.4%)
SAG 同时附带一个开箱即用的本地工作台——上传 Markdown/TXT 文档后自动完成分块、向量化、事件抽取、实体抽取、关系组织,你可以用类 ChatGPT 界面问答、检视 chunks / events / entities / embeddings / 搜索 trace / 原始模型日志,还能探索知识图谱。
✨ 核心功能一览
| 功能模块 | 描述 | 亮点 |
|---|---|---|
| 项目管理 | 多项目隔离,每个项目独立文档库与配置 | 支持多知识库并行 |
| 多文档上传 | 支持 Markdown / TXT 格式批量导入 | 自动分块 + 事件/实体抽取 |
| 文档处理结果检视 | 可视化查看 chunks / events / entities / embeddings | 透明可调试 |
| 对话式检索 | 类 ChatGPT 界面,支持多轮对话 | 引用源文档链接 |
| 检索 trace 可视化 | 完整展示召回路径与命中分数 | 支持多跳召回调试 |
| 知识图谱探索 | 可视化 event ↔ entities 关联网络 | 辅助发现隐藏关系 |
| MCP 集成 | 支持 Model Context Protocol stdio 服务 | 可被 Claude / Cursor / 其他 Agent 直接调用 |
| 双检索模式 | fast(BM25 全文本) / standard(LLM 实体抽取) | 速度与精度自由切换 |
🛠️ 快速上手:5 分钟跑通示例
1. 克隆与配置
git clone https://github.com/Zleap-AI/SAG.git
cd SAG
cp .env.example .env
2. 启动 PostgreSQL(含 pgvector)
# 方式 A:使用 Docker
docker compose up -d

# 方式 B:macOS 本地 PostgreSQL 17
brew install postgresql@17 pgvector
brew services start postgresql@17
/opt/homebrew/opt/postgresql@17/bin/createdb sag_lite
/opt/homebrew/opt/postgresql@17/bin/psql -d sag_lite -c 'create extension if not exists vector;'
3. 安装依赖与初始化数据库
npm install
npm run db:setup
4. 配置 LLM / Embedding / Rerank
.env 文件中填入你的 API(兼容 OpenAI 协议):
EMBEDDING_BASE_URL=https://api.302ai.cn/v1
EMBEDDING_MODEL=text-embedding-3-large
EMBEDDING_DIMENSIONS=1024

LLM_BASE_URL=https://api.302ai.cn/v1
LLM_MODEL=qwen3.6-flash

RERANK_MODEL=qwen3-rerank
DEFAULT_SEARCH_MODE=fast
5. 启动开发服务器
npm run dev
默认地址:
- WebUI:
http://localhost:5173 - API:
http://localhost:4173
注意:SAG 默认走标准 BM25 / 全文索引快速模式,无需 GPU;切到 standard 模式会调用 LLM 抽取实体,精度更高但更慢。
6. MCP 集成配置
SAG 暴露了 MCP stdio 服务,可以直接被 Claude Desktop、Cursor 等 Agent 调用:
{
  "mcpServers": {
    "sag": {
      "command": "npm",
      "args": ["run", "mcp"],
      "env": {
        "SAG_MCP_SOURCE_ID": "current_project_id"
      }
    }
  }
}
7. HTTP API 调用示例
# 创建项目
curl -X POST http://localhost:4173/api/projects \
  -H 'Content-Type: application/json' \
  -d '{"name":"Demo Project"}'

# 摄取文档
curl -X POST http://localhost:4173/ingest \
  -H 'Content-Type: application/json' \
  -d '{"sourceId":"project_id","title":"Demo","content":"# Demo\n\nSAG can search project documents.","extract":true}'

# 执行多跳检索
curl -X POST http://localhost:4173/api/search \
  -H 'Content-Type: application/json' \
  -d '{"query":"Why is SAG suitable for multi-hop retrieval?","sourceIds":["project_id"],"strategy":"multi","searchMode":"fast","topK":5,"returnTrace":true}'
📊 与主流 RAG 方案对比
| 对比维度 | SAG | HippoRAG 2 | 传统 Vector RAG | GraphRAG(微软) |
|---|---|---|---|---|
| 多跳 Recall@2 | 79.30% | 68.14% | 40-55% | 55-65% |
| 索引构建成本 | 低(事件+实体) | 中(OpenIE 三元组) | 低(仅向量) | 极高(全量 LLM 抽取) |
| 动态数据适配 | ✅ 增量更新 | 需重建 | ✅ | ❌ 需重建 |
| 知识图谱可视化 | ✅ 内置 WebUI | ❌ | ❌ | ✅ 内置 |
| MCP 集成 | ✅ 原生支持 | ❌ | ❌ | ❌ |
| 本地部署 | ✅ TypeScript 一键启动 | ✅ | ✅ | 较复杂 |
| 中文友好度 | ✅ 事件抽取完整保留语义 | 中 | 中 | ✅ |
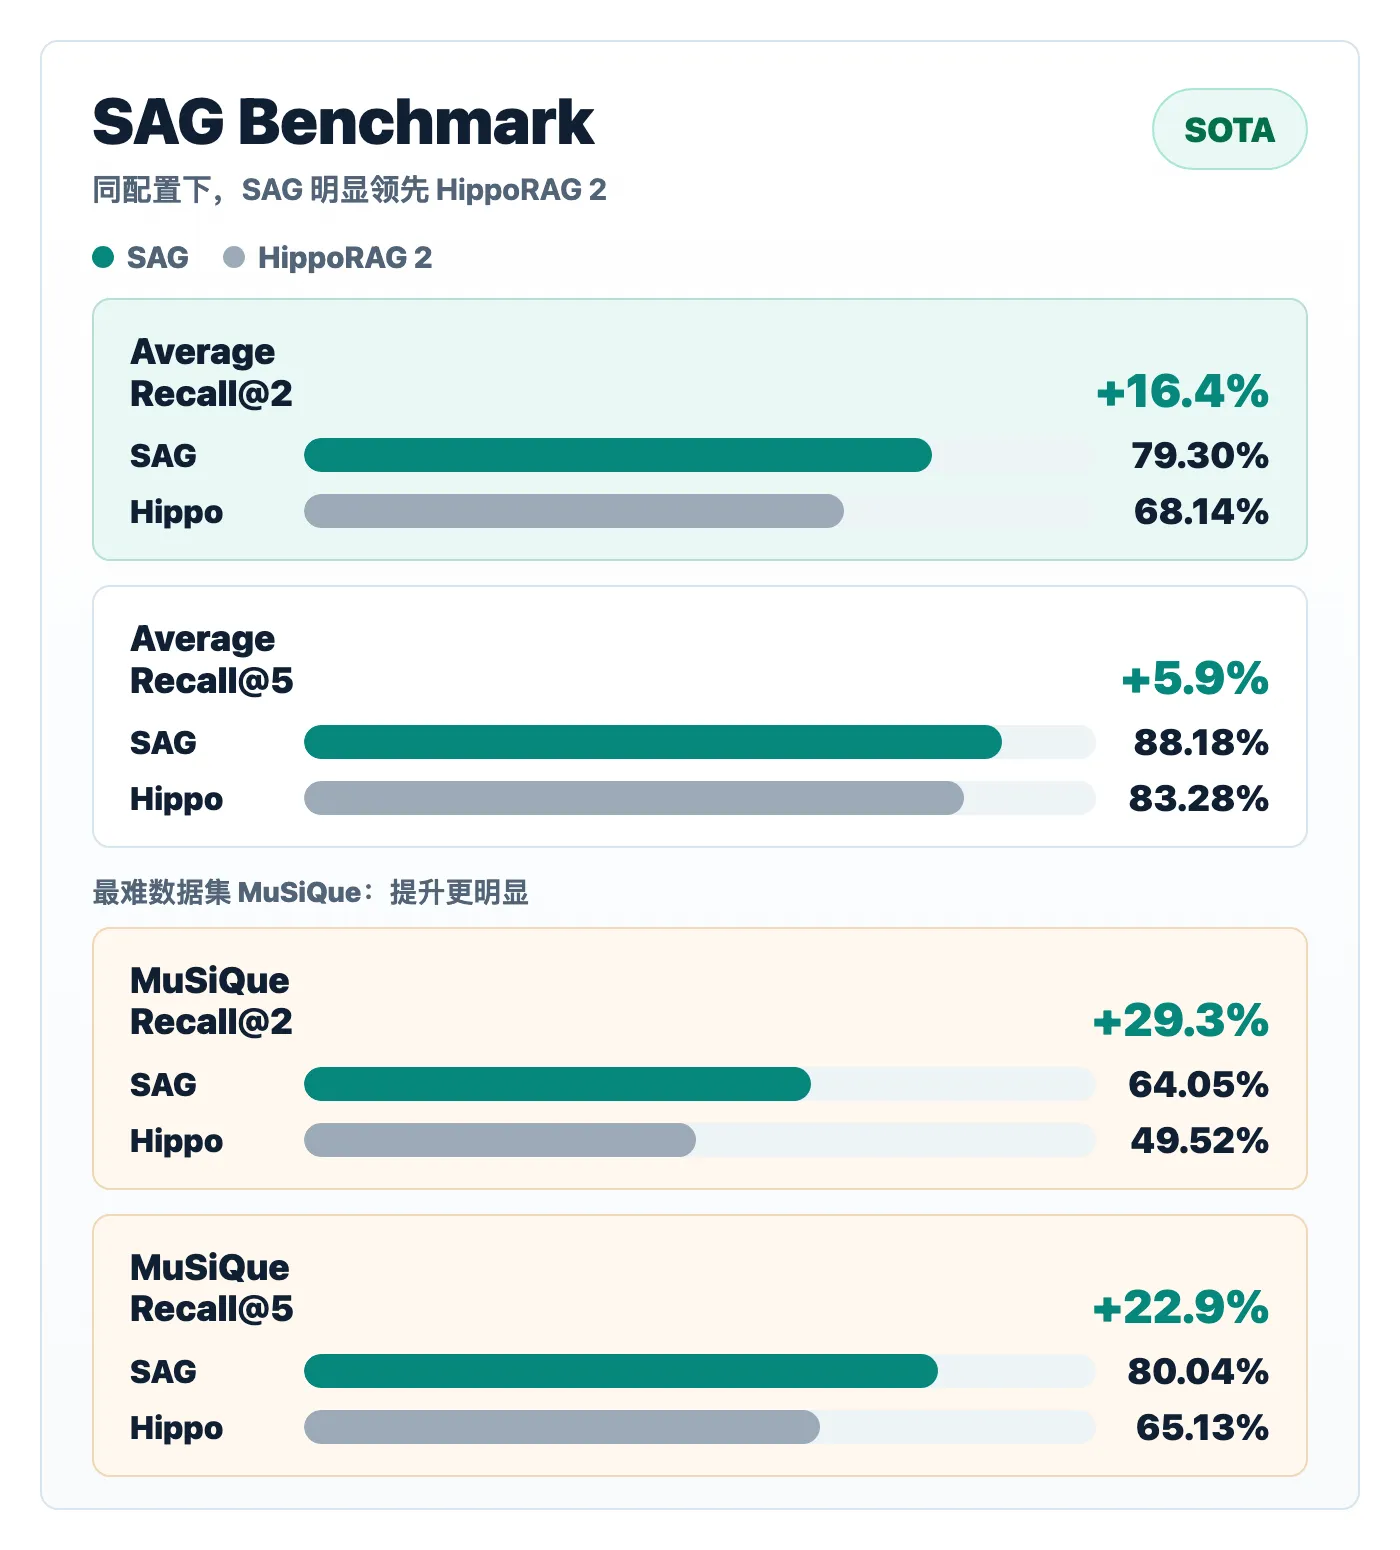
关键优势:SAG 用「事件 + 实体」双层结构取代传统三元组,避免了图谱重建的代价,同时把多跳召回精度做到了 SOTA。
💡 适用场景
场景 1:项目文档智能问答
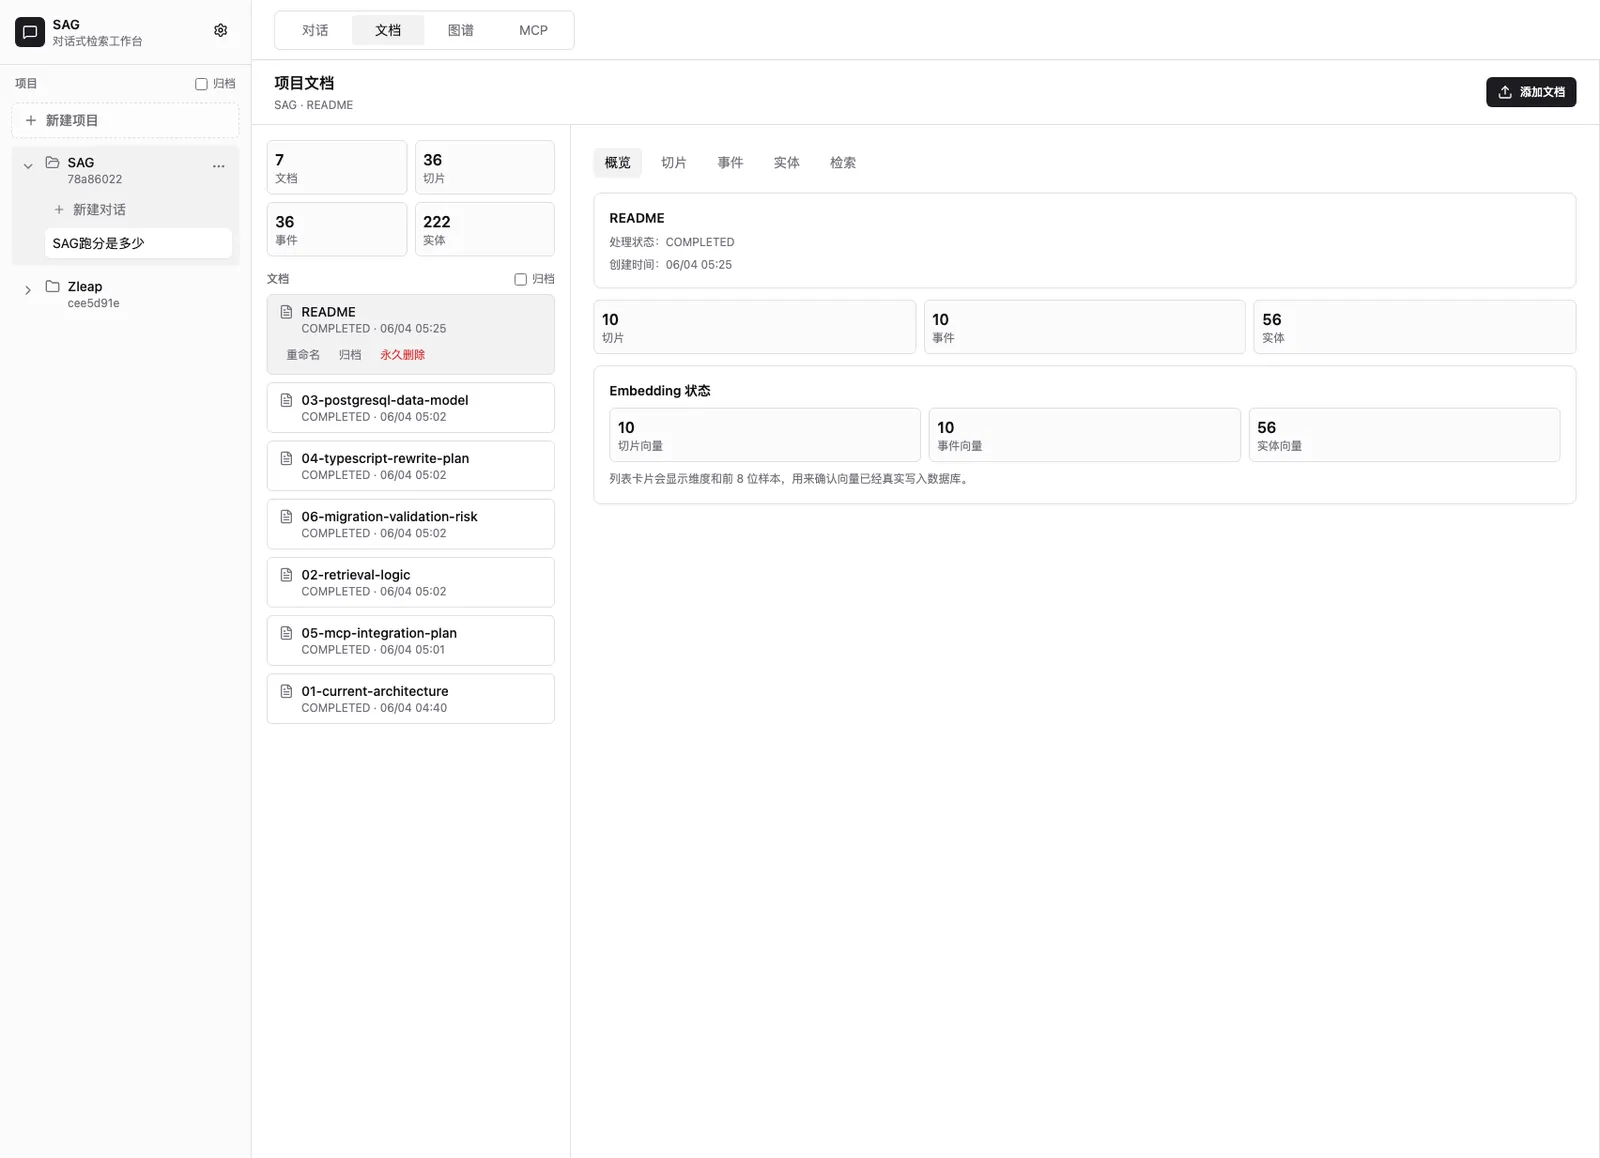
功能说明:把团队的项目文档(产品需求、技术方案、会议纪要)批量上传到 SAG,自动分块 + 事件抽取 + 实体索引。
输入要求:Markdown / TXT 格式的文档
输出效果:类 ChatGPT 问答界面,每条回答附带源文档引用链接,可点开核对原文
适用场景:
- ✅ 新人入职快速了解项目背景
- ✅ 跨团队检索历史方案与决策
- ✅ 自动回答「我们 XX 功能最早是谁提的?」类问题
场景 2:对话式检索 + 引用溯源
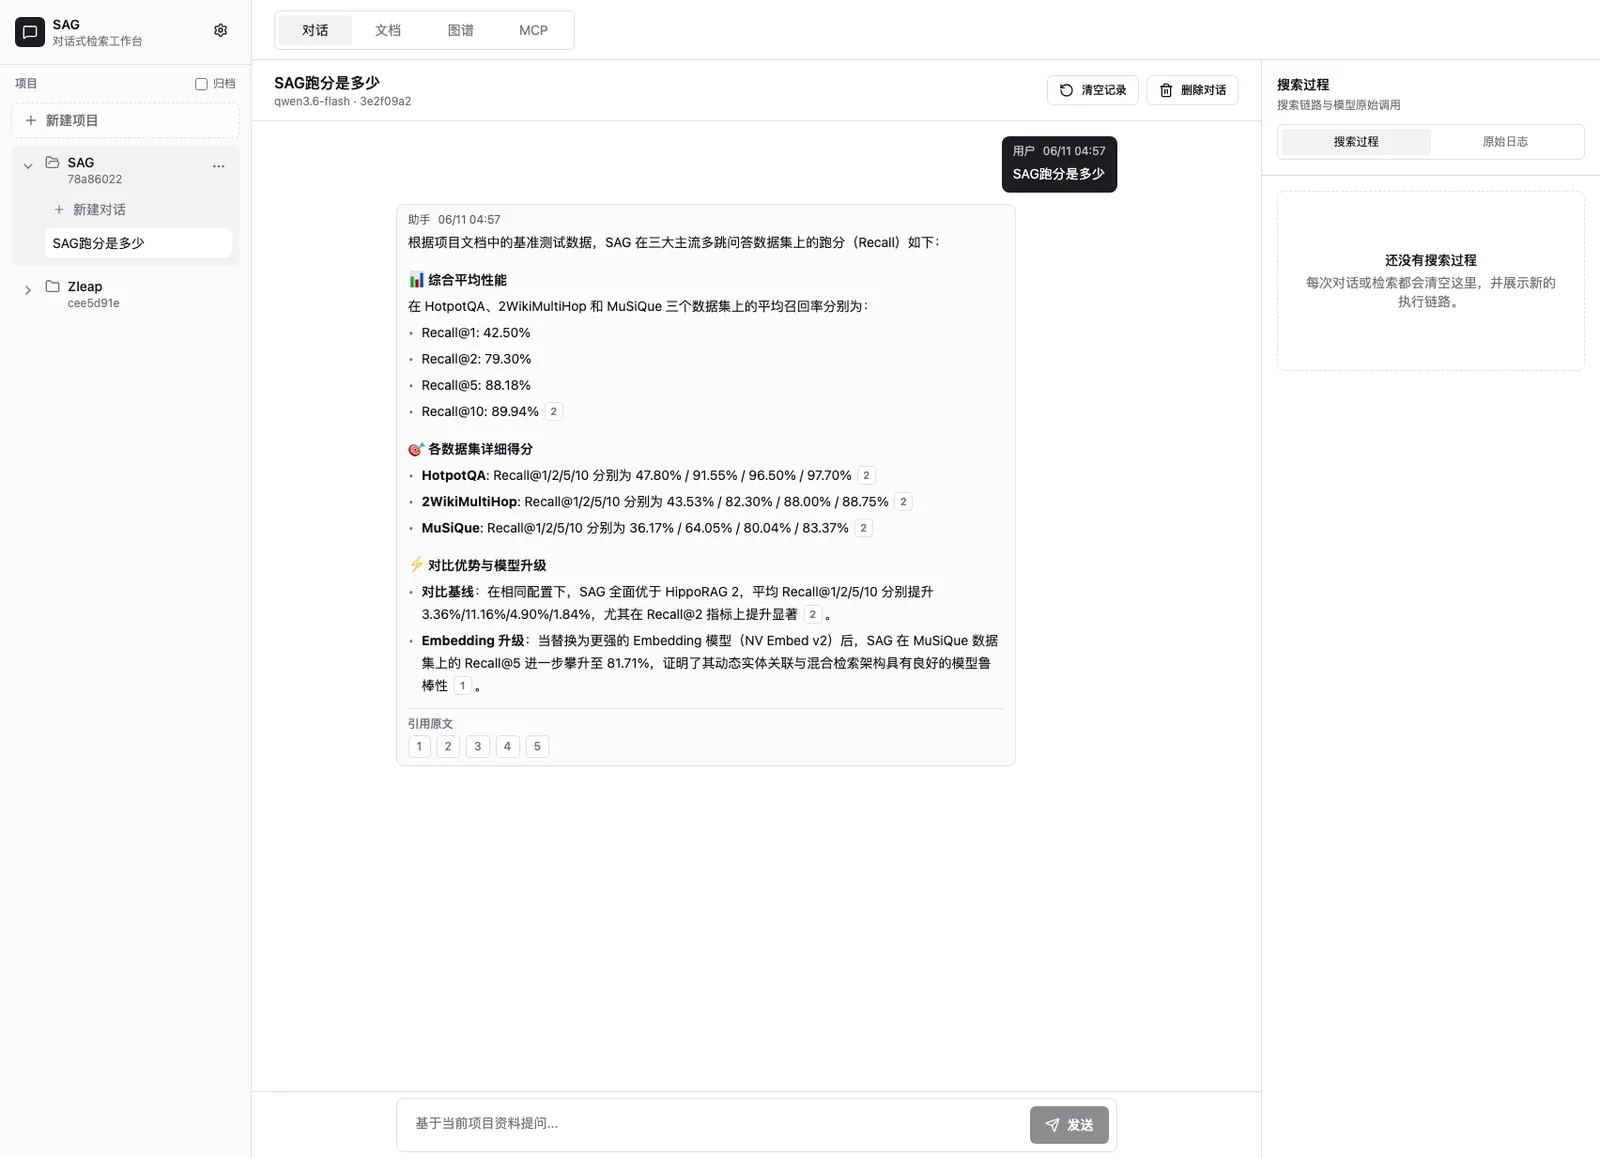
功能说明:支持多轮对话,每轮答案都标注引用的 chunks 与 events,调试可看到完整 trace。
输入要求:自然语言提问
输出效果:答案 + 引用文档片段 + 检索 trace(哪些事件被命中、哪些实体被扩展召回)
适用场景:
- ✅ 客户支持:让 AI 回答「我们 XX 产品保修期多久?」并附引文
- ✅ 法律 / 合同检索:精准定位条款出处
- ✅ 学术研究:基于论文集做问答
场景 3:知识图谱探索
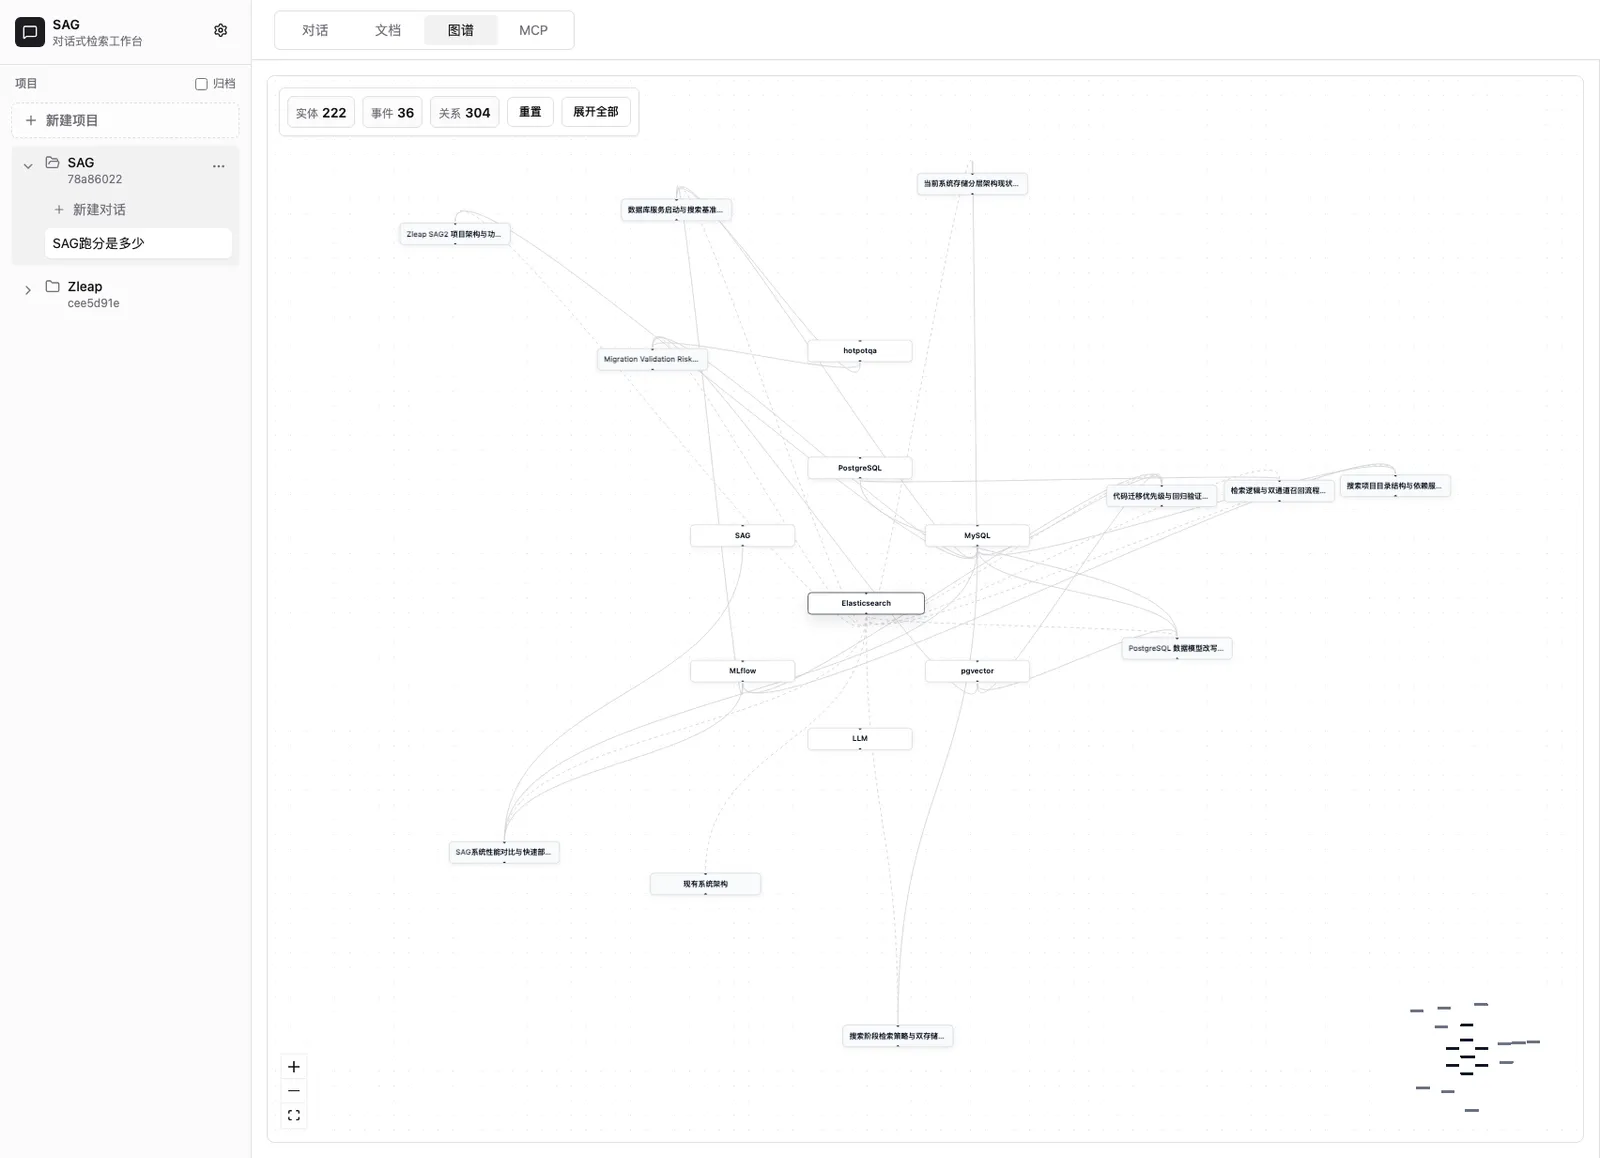
功能说明:把所有文档的事件和实体构建成可视化网络,点击节点即可看到关联文档。
输入要求:已上传并处理过的文档
输出效果:交互式图谱,节点 = 实体,边 = 事件关联
适用场景:
- ✅ 发现文档间的隐藏关联
- ✅ 梳理人物 / 公司 / 项目的关系网络
- ✅ 辅助做竞品分析 / 行业研究
用户群体总结
- ✅ 个人 AI 知识库:把笔记 / 文档 / 收藏变成可检索、可关联的知识体系
- ✅ 企业内部知识中枢:作为团队 AI 的记忆中枢,让 AI 真正「懂」业务
- ✅ RAG / Agent 原型验证:内置 trace + 日志,方便调优 pipeline
- ✅ MCP 工具开发:MCP stdio 服务可直接被 Claude / Cursor 调用
- ❌ 不适合:超大规模(>1M 文档)生产环境(SAG 当前定位为中小规模 workbench)
📐 SAG 架构解析
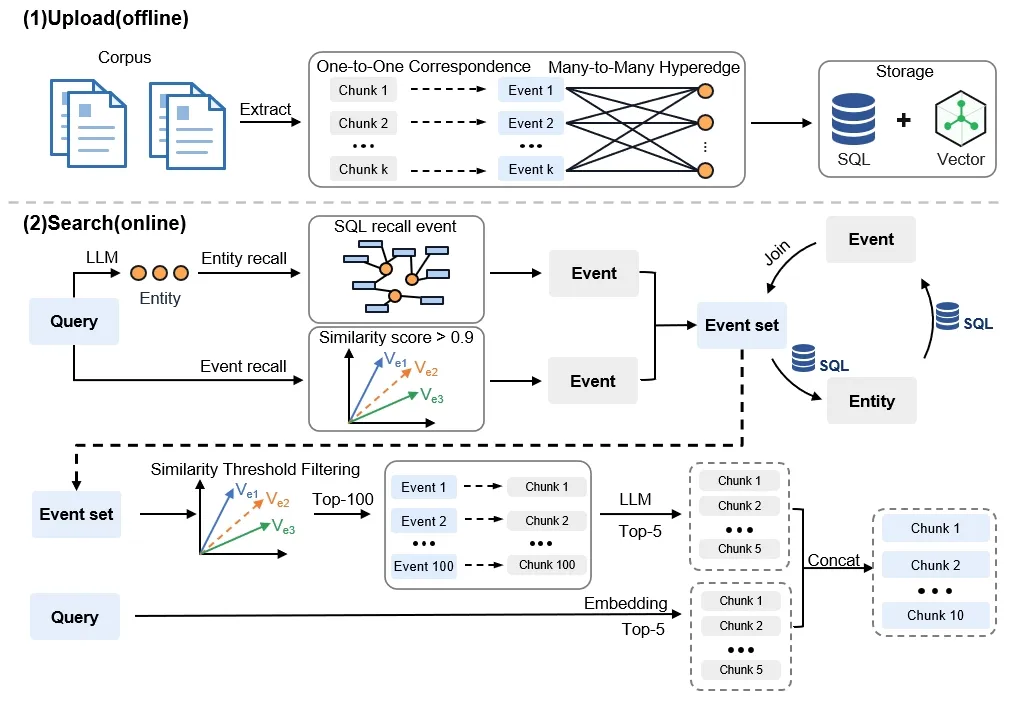
SAG 的核心 pipeline:
- 文档摄取(Ingestion):Markdown / TXT → 分块 → LLM 抽取事件 + 实体 → 写入 PostgreSQL(pgvector + 全文索引)
- 检索(Search):用户 query → BM25 全文召回候选事件 → 多跳关联扩展 → Rerank → topK 结果
- 生成(Generation,可选):将召回的事件 + 实体 + query 一起送入 LLM 生成最终答案
- 可视化(Observability):所有 trace / 嵌入 / 原始日志都可在 WebUI 中查看
技术栈:TypeScript 全栈(前端 React + Vite + Tailwind CSS,后端 Fastify + MCP TypeScript SDK),数据层 PostgreSQL + pgvector + 全文搜索 + SQL 多跳查询,模型层 OpenAI 兼容 LLM / Embedding / Rerank API。
💰 开源协议与部署
- 开源协议:MIT License(可商用、可二次分发)
- GitHub 仓库:Zleap-AI/SAG
- 配套论文:arXiv:2606.15971
- 基准测试代码:Zleap-AI/SAG-Benchmark
💡 完全免费 + 本地部署 + MCP 原生支持,是构建个人 / 团队 AI 知识库的最优解之一。
🎯 总结
SAG 用「事件 + 实体」双层结构打破了传统 RAG 在多跳召回上的瓶颈,Recall@2 直接提升 11.16 个百分点,同时保持了轻量化的索引成本和动态数据适配能力。配合原生 MCP 集成和完整的本地工作台,无论是个人知识库还是企业级文档中枢,都能直接落地。
推荐指数: ⭐⭐⭐⭐⭐(满分5星)
适合人群:
- 想要搭建本地 AI 知识库的开发者 / 研究者
- 需要多跳检索精度的 RAG / Agent 项目
- 寻求 ChatGPT 体验 + 文档引用 + 图谱可视化的团队
立即体验:
- GitHub 仓库:Zleap-AI/SAG
- 论文:arXiv:2606.15971
数据截至 2026-06-24,最新信息请以 GitHub 仓库为准。