Open-LLM-VTuber
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../Open_LLM-VTuber-recommend.pptx../../Open_LLM-VTuber-recommend.mp4本文目录
📌 核心价值:把"AI 说话中插嘴"做成一等公民的开源桌面伴侣
Open-LLM-VTuber 用 VAD 状态机 + asyncio 任务取消,把"麦克风 → VAD → ASR → 流式 LLM → TTS → Live2D"做成一条支持任意环节被打断的实时管线,单 Python 进程即可本地离线运行。
🚀 什么是 Open-LLM-VTuber?
Open-LLM-VTuber 是一个开源的语音交互式 AI 伙伴,主打"免提打断 + Live2D 表情 + 完全本地离线"。项目最初目标是利用开源方案在 Windows 之外的平台上复刻闭源 AI 虚拟主播 neuro-sama 的体验。
- 🖥️ 跨平台:完美兼容 Windows / macOS / Linux,支持 NVIDIA 和非 NVIDIA GPU
- 🔒 离线模式:使用本地模型完全离线运行,对话数据保留在设备上
- 💻 双形态:Web 版 + 桌面客户端,桌面客户端支持透明背景桌面宠物模式
- 👁️ 视觉感知:支持摄像头、屏幕录制、截图三种输入源
- 🫱 触摸反馈:点击或拖拽与 Live2D 角色交互
- 💭 AI 主动说话:可让 AI 主动发起对话或内心独白显示
- 🌍 TTS 翻译:可用中文聊天,让 AI 用日语语音回复


核心定位:当前最强的开源 neuro-sama 复刻方案,工程参考价值高于产品价值
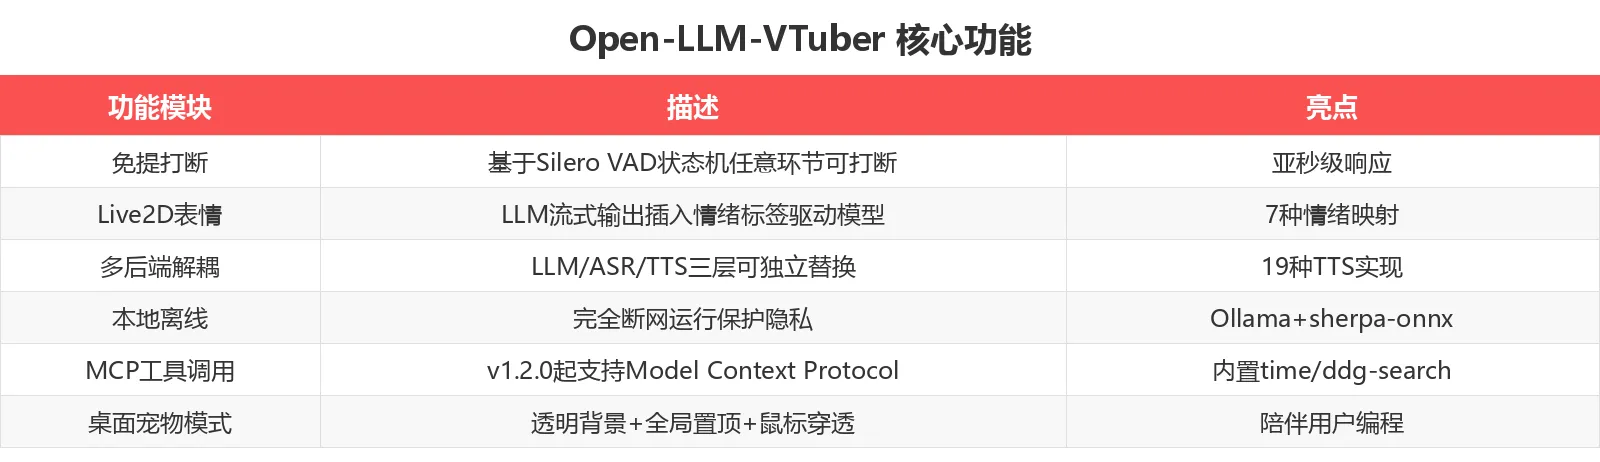
✨ 核心功能一览
🛠️ 5 分钟跑通最小链路
安装步骤
# 1. 克隆仓库(带 frontend 子模块)
git clone --recurse-submodules https://github.com/Open-LLM-VTuber/Open-LLM-VTuber.git
cd Open-LLM-VTuber

# 2. 安装 uv(项目推荐的依赖管理器)
brew install uv  # macOS
# 或访问 https://docs.astral.sh/uv/

# 3. 同步依赖
uv sync

# 4. 启动服务
uv run run_server.py
启动后访问 http://localhost:8000,首次启动会提示从 config_templates/ 复制 conf.yaml 模板并填写 LLM/ASR/TTS 后端信息。
推荐"零云纯本地"配置组合
| 层级 | 推荐组件 | 离线可用 |
|---|---|---|
| LLM | Ollama + Qwen2.5 / Llama3.1 | ✅ |
| ASR | sherpa-onnx + SenseVoiceSmall | ✅ |
| TTS | Edge TTS / CosyVoice / pyttsx3 | Edge 需联网,CosyVoice 离线 |
| VAD | Silero VAD(已内置) | ✅ |
注意:麦克风 API 仅在 https 或 localhost 下能拿到 getUserMedia,远程访问需反代 + HTTPS
关键代码:Agent 装饰器链
Open-LLM-VTuber 最 Pythonic 的设计是用 4 个装饰器 把 AsyncIterator[str] 改写为 4 类信号:
@actions_extractor(live2d_model)            # 抽出情绪标签 → Live2D 表情
@display_processor()                         # 解析 display_text → 内心独白
@tts_filter(tts_preprocessor_config)        # 过滤 TTS 不能念的字符
@sentence_divider(faster_first_response=True)  # 切成完整句
async def chat(memory, user_input):
    ...
实际执行顺序(装饰器从下往上):
chat → sentence_divider → tts_filter → display_processor → actions_extractor
关键代码:VAD 状态机配置
class SileroVADConfig(BaseModel):
    orig_sr: int = 16000
    prob_threshold: float = 0.4      # 帧级语音概率阈值
    db_threshold: int = 60           # 帧级音量阈值(过滤 AI 回灌)
    required_hits: int = 3           # 连续 3 帧 ≈ 0.096s 才确认开始
    required_misses: int = 24        # 连续 24 帧 ≈ 0.768s 才确认结束
    smoothing_window: int = 5        # 滑动窗口平滑
db_threshold=60 用于过滤 AI 自己 TTS 播出的回灌音,required_misses=24 避免 AI 句子间短暂停顿被误判为"用户开口"。
📊 与竞品对比
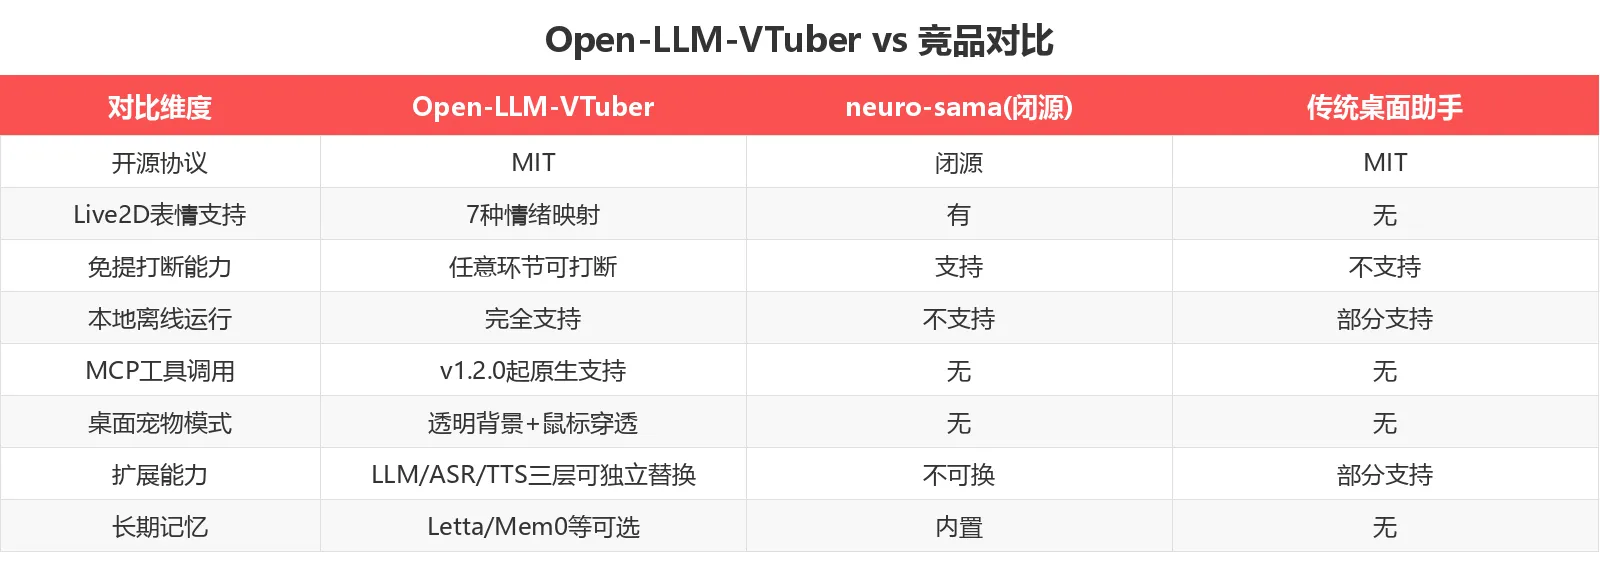
对比结论:Open-LLM-VTuber 是目前唯一同时具备「开源 + 免提打断 + 本地离线 + Live2D 表情 + MCP 工具调用」的开源方案
💡 适用场景
场景 1:免提打断的真实对话
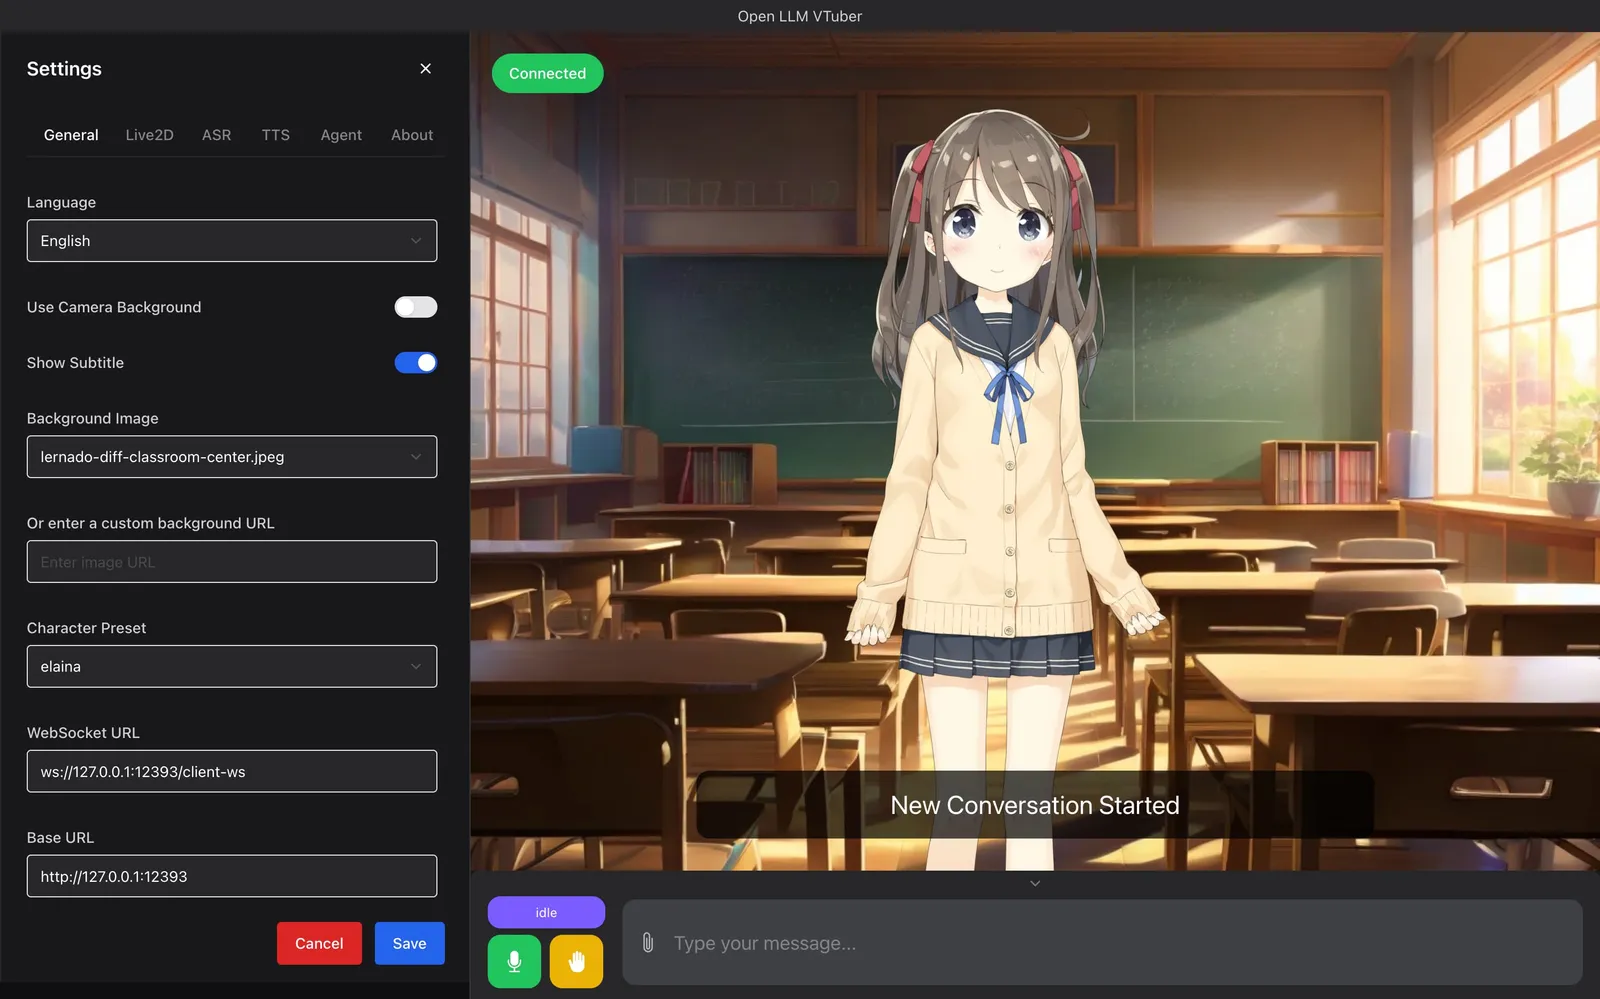
功能说明:基于 Silero VAD 状态机的三态状态机(IDLE / ACTIVE / INACTIVE),AI 正在念长段回答时用户可随时开口,亚秒级响应停下、收听、接话,无需按住说话键。
输入要求:默认麦克风,浏览器需授权 getUserMedia
输出效果:实时打断 + 接话 + 上下文保留(被打断的回合会插入 [Interrupted by user] 系统消息)
适用场景:编程时陪聊、做饭时闲聊、直播弹幕交互
场景 2:Live2D 表情驱动
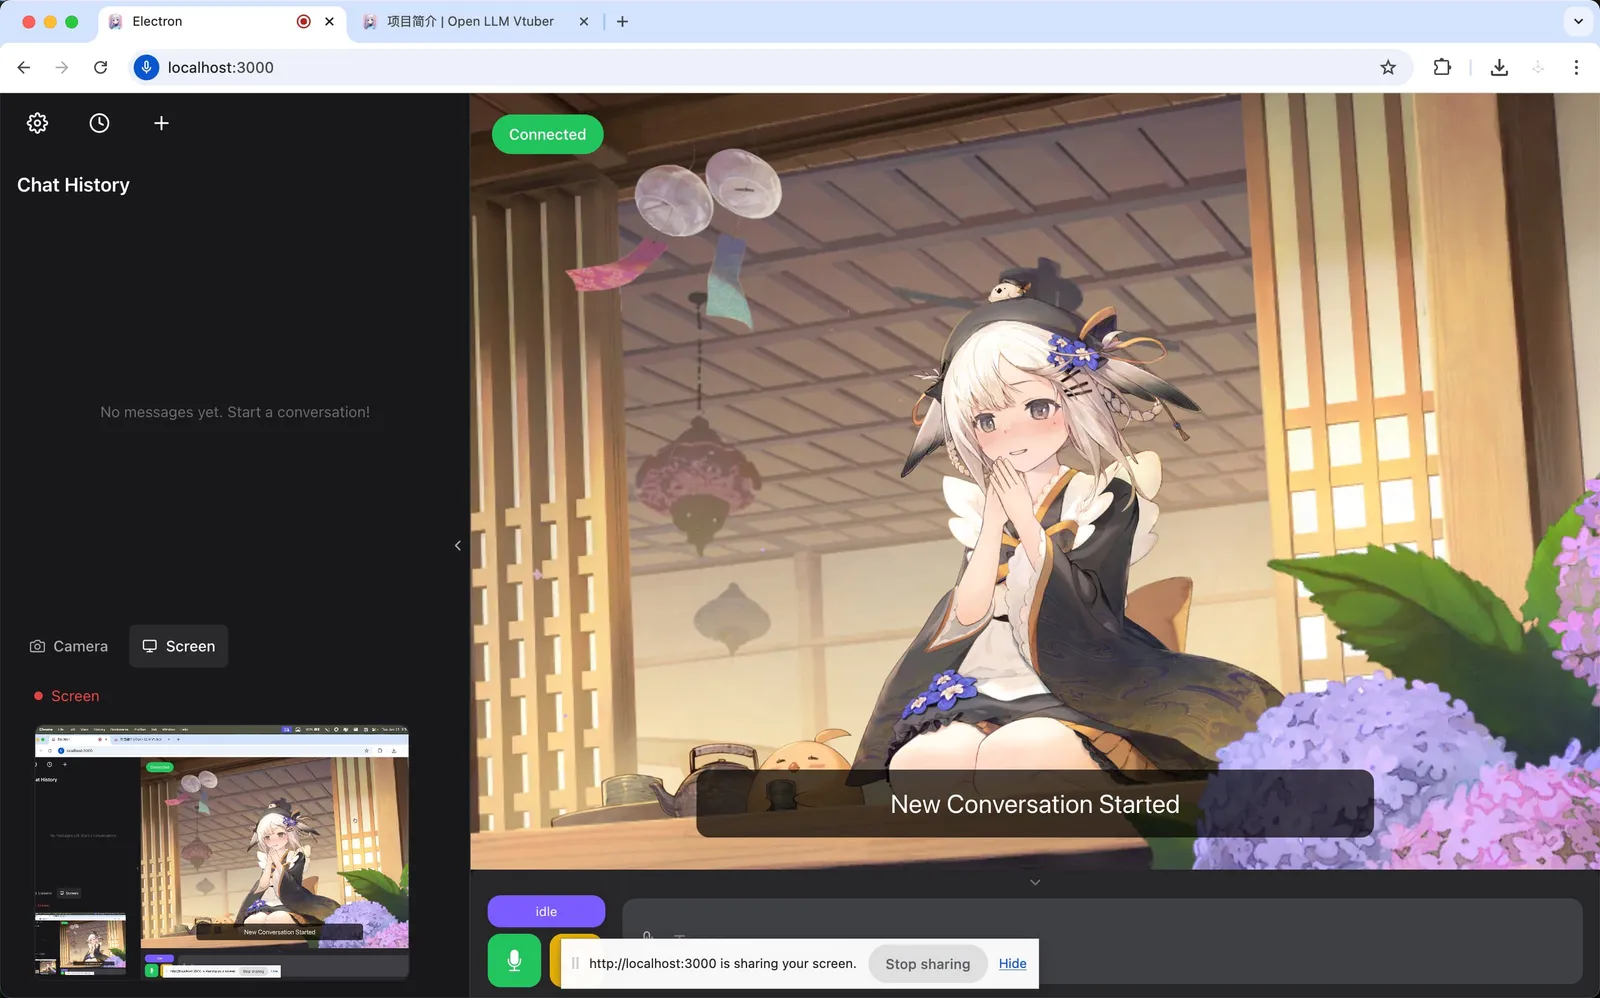
功能说明:LLM 在流式输出中插入结构化情绪标签(如 [joy]),后端解析后通过 WebSocket 推送给前端 Live2D SDK,自动切换表情。
输入要求:自定义 Live2D 模型 + 配置 model_dict.json 中的 emotionMap
输出效果:7 种情绪映射(fear/anger/disgust/sadness/joy/neutral/surprise)
适用场景:虚拟伴侣、虚拟客服、虚拟陪伴角色
场景 3:桌面宠物模式
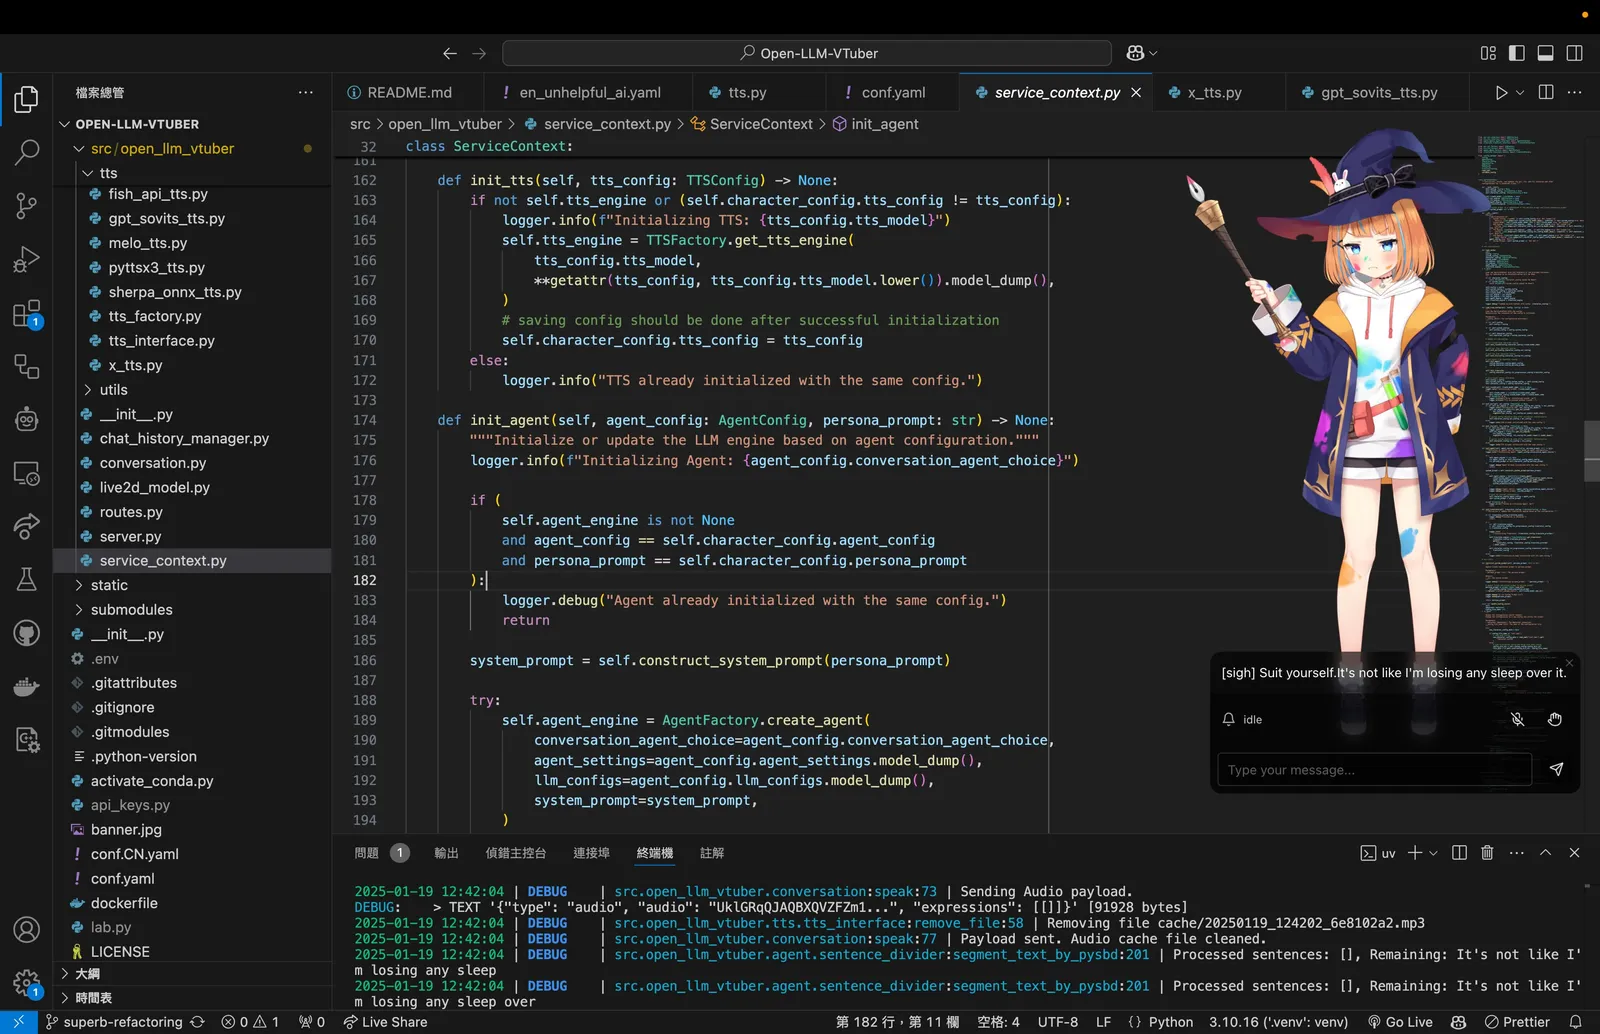
功能说明:透明背景 + 全局置顶 + 鼠标穿透,让 AI 伴侣"贴"在你屏幕的任何位置(VSCode 上方、桌面角落)。
输入要求:桌面客户端 + Live2D 模型
输出效果:AI 伴侣陪伴你编程/工作/学习,不阻挡任何操作
适用场景:编程陪伴、学习陪伴、孤独陪伴
场景 4:App 桌面模式
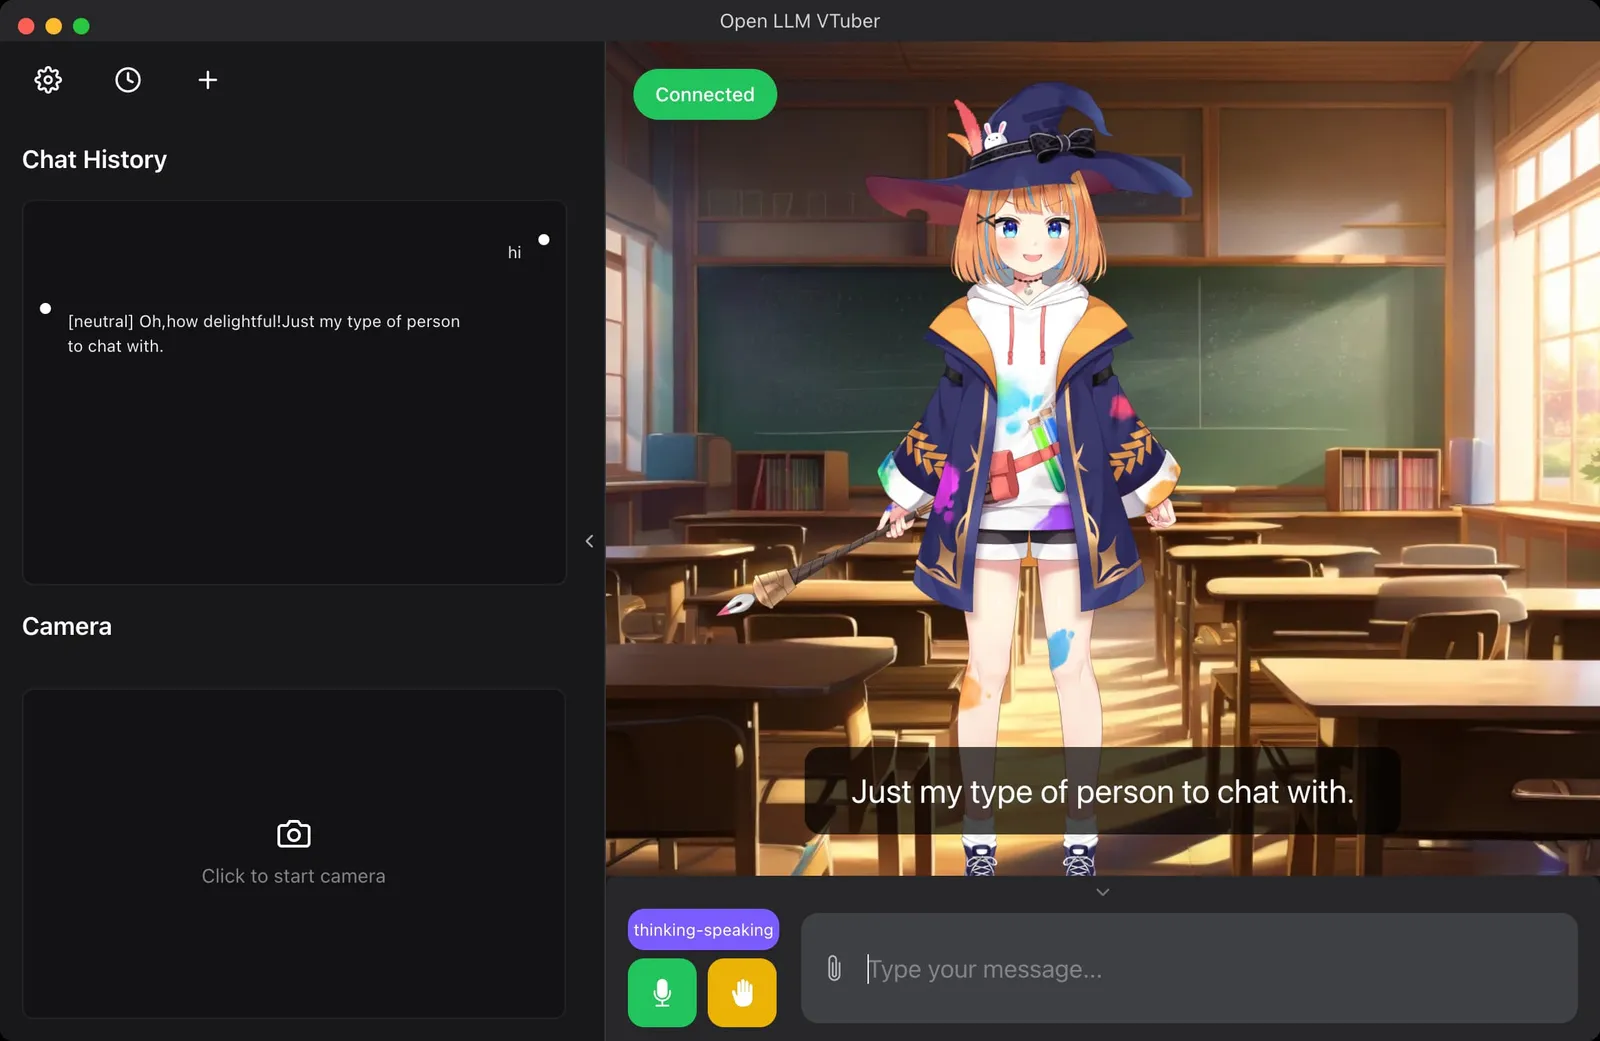
功能说明:除宠物模式外,还提供传统的窗口模式,适合桌面助手场景。
输入要求:桌面客户端安装
输出效果:标准窗口 + 完整功能
适用场景:替代传统桌面助手
场景 5:B 站直播弹幕接入
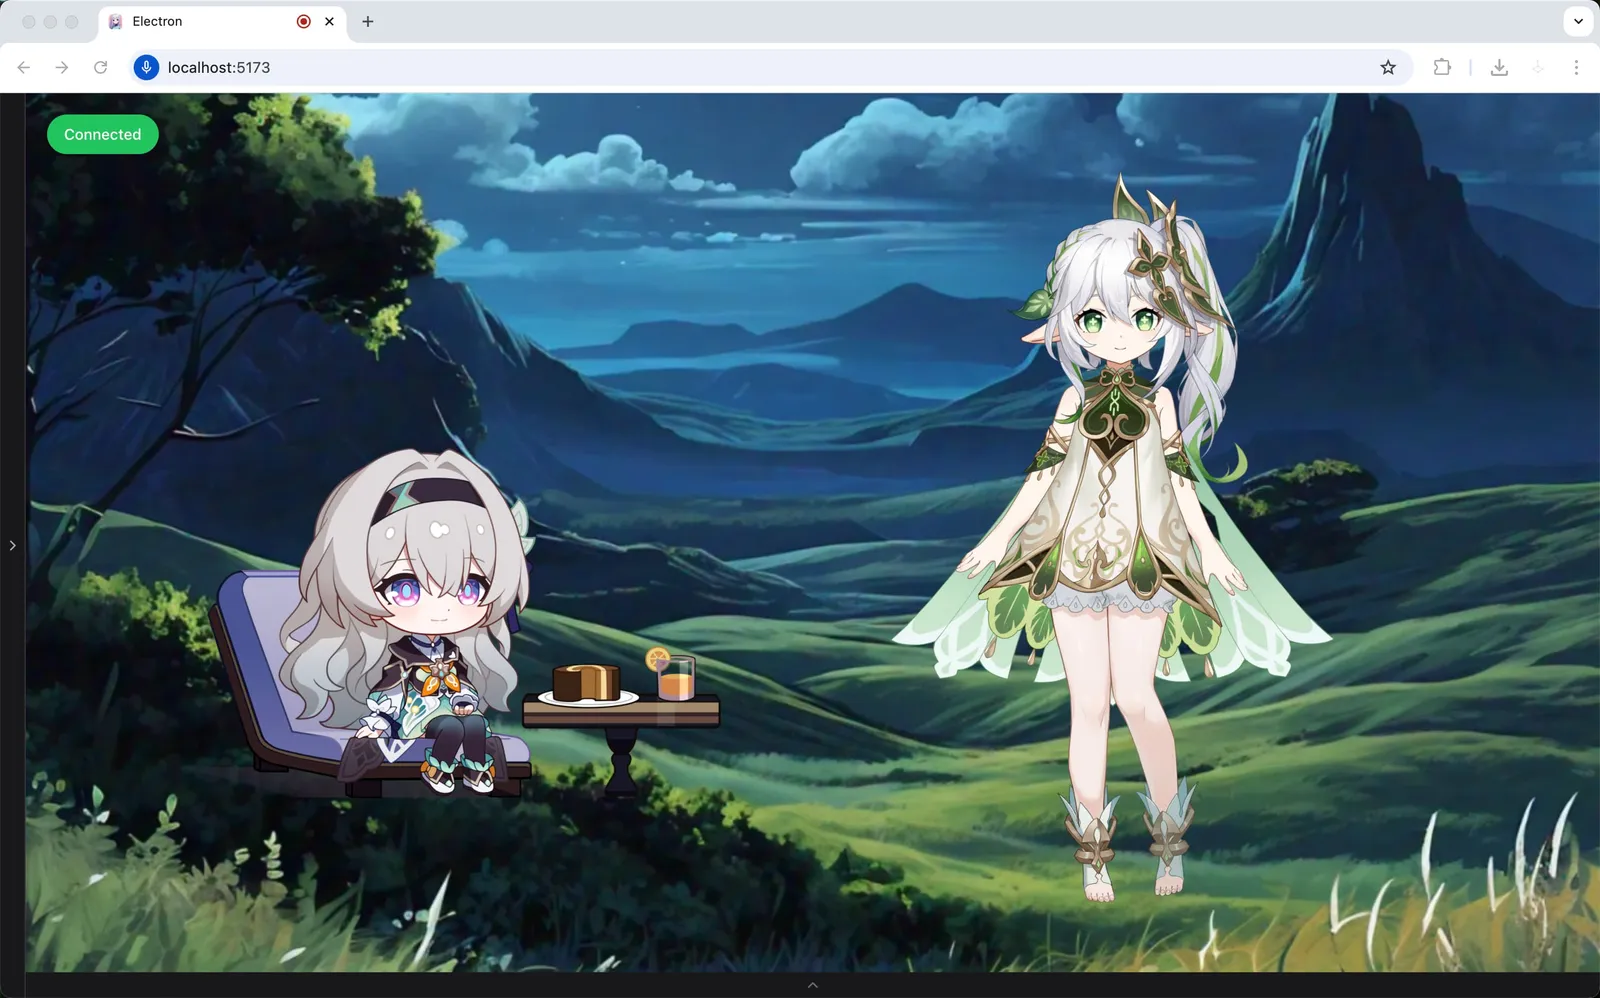
功能说明:内置 B 站直播弹幕转 user_input 逻辑,可让 AI 实时回复直播间弹幕,做"直播间 AI 数字人"。
输入要求:B 站直播间房间号 + 弹幕 API 凭证
输出效果:AI 实时回复观众弹幕
适用场景:直播数字人、虚拟主播、教育直播间
用户群体总结
- ✅ AI 数字人爱好者:最强开源数字人方案
- ✅ AI Agent 研究者:完整的"语音 + LLM + Live2D + 打断"开源参考架构
- ✅ 程序员陪聊用户:VSCode 陪伴模式
- ✅ 直播主播:B 站弹幕接入
- ✅ 虚拟伴侣/客服:可换 Live2D 模型 + 声音克隆
- ❌ 不适合:仅需要"按按钮问一句"助手(用 LangChain 桌面化更轻)
💰 开源协议
开源协议: MIT License(v1.2.0 起回滚至 MIT)
⚠️ 注意:Live2D 样例模型单独遵循 Live2D Free Material License Agreement,中型或大型企业商用需额外获取 Live2D Inc. 授权
🎯 总结
Open-LLM-VTuber 把"全双工语音交互"中最难做的"被打断",通过 VAD 状态机 + asyncio.Task.cancel() + 装饰器链 这三板斧做成了一等公民。11.8k stars 和 MIT 协议使其成为想要研究语音 Agent 实时管线的工程师的优秀开源学习材料。
推荐指数: ⭐⭐⭐⭐⭐(满分 5 星,数字人方向必看)
适合人群: AI 数字人爱好者、AI Agent 研究者、直播主播、虚拟伴侣需求者
立即体验: Open-LLM-VTuber GitHub
官方文档: docs.llmvtuber.com
数据截至 2026-06-24,最新信息请以 GitHub 仓库为准。