OptMem
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../OptMem-recommend.pptx../../OptMem-recommend.mp4本文目录
📌 核心价值:426 token 的 prompt 块,把永久记忆塞进任意 AI Agent
给 Claude Code、Codex、pi shell 一次安装,你的 Agent 跨会话、跨模型、跨供应商都不再"金鱼脑"。
🚀 什么是 OptMem?
OptMem 是 HVM/Kind 作者 Victor Taelin 在 2026-07-25 开源的"AI Agent 永久记忆"系统。
它由两件东西组成:一个 426-token 的 prompt 块(自动打印,粘贴进 AGENTS.md 或 CLAUDE.md 就完事) + 一个 31KB 的 Python 3 文件 ~/.optmem/memo(零依赖,不挑 Python 版本)。
curl -fsSL https://raw.githubusercontent.com/VictorTaelin/OptMem/main/install.sh | sh
把自动打印出来的 ## Memory 块粘贴到 Agent 的 AGENTS.md 顶部就装完了。重跑这一行会自动更新。


核心定位:7 条命令 + 1 个 prompt 块,把"会话间记忆断层"问题降到运维 0 成本
发布 6 天已经 934⭐。从 README 内置的开发者视角看,OptMem 解决的不是"怎么存得最聪明",而是"怎么让模型每次醒来都能用回自己"。
✨ 6 条命令速查
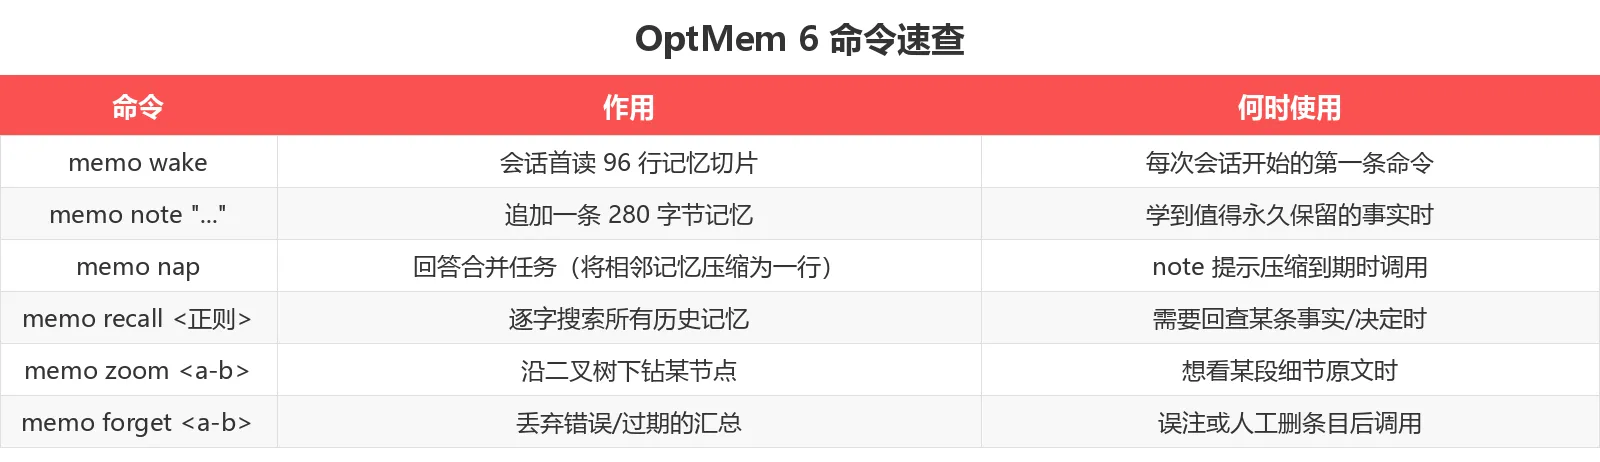
关键观察:所有"压缩/合并"动作都由 Agent 自己在 note 后触发 merge 提示完成,没有任何后台进程
🧠 核心机制:二叉合并树(Binary Merge Tree)
OptMem 不搞向量数据库、不算 embedding。记忆就是纯文本按行追加 + 一棵可重建的二叉合并树:
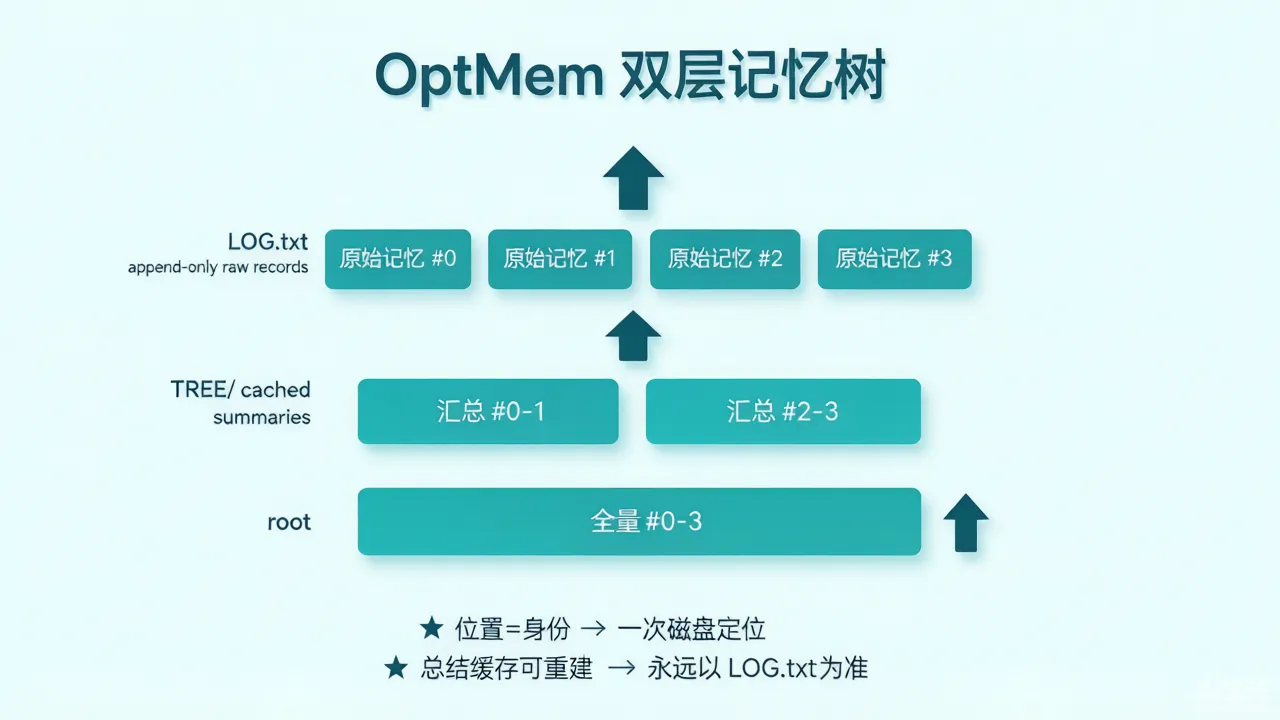
两个核心数据结构:
| 路径 | 角色 | 操作 |
|---|---|---|
~/.optmem/memory/LOG.txt |
唯一真相源(append-only,永不修改) | note 追加一行 |
~/.optmem/memory/TREE/ |
总结缓存(丢了能从 LOG 重算) | nap 重新生成 |
为什么"位置即身份"?
- 每条记录固定 280 字节 → 第 N 条就一定在
LOG.txt第N×280字节 - 读取不需要扫描 → 一次磁盘 seek,O(1)
- 项目自报:100 万条记忆(608MB)时
wake耗时 0.03 秒
关键设计:总结缓存永远可以丢弃重建,LOG.txt 才是唯一真相源。这意味着你可以把整个 memory/ 目录放 git 里做版本控制,没有任何外部依赖
🔁 工作流:会话开始到结束
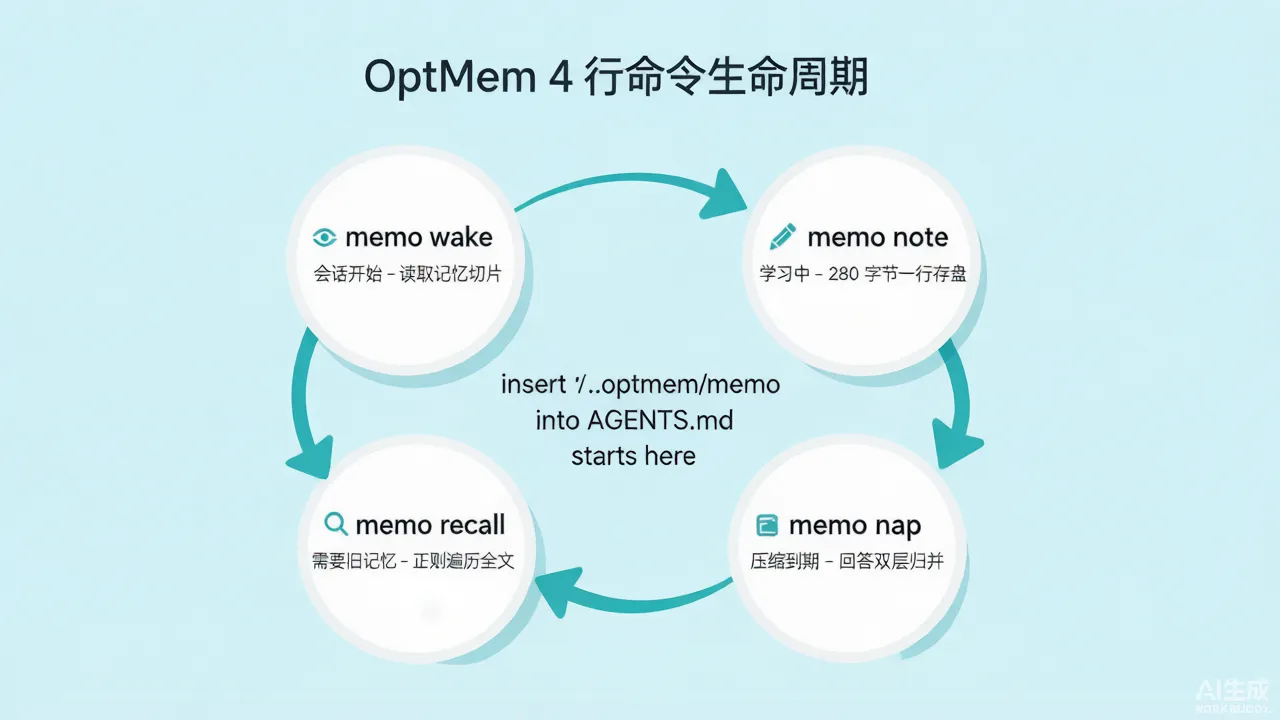
重点:每条 note 命令的输出里都嵌着合并任务,Agent 必须先回答合并、再继续工作——这就是"零后台进程"的设计代价
🛠 5 分钟上手
安装
# 一行装完,自动打印需要粘贴的 prompt 块
curl -fsSL https://raw.githubusercontent.com/VictorTaelin/OptMem/main/install.sh | sh

# 把打印出来的 ## Memory 块粘贴到 ~/.claude/CLAUDE.md 或 ~/.codex/AGENTS.md 顶部
# 重启你的 Agent(Claude Code / Codex / pi shell / 任何 harness 都行)
Windows 用户:项目从一开始就是 Windows 原生支持的,WINDOWS.md 里说明用 msvcrt 文件锁代替 fcntl,8 个并行进程 × 200 条笔记 = 1600/1600 全部入库,无需 WSL。
调参:唯一的 knob
memo config                  # 查看当前大小
memo config WAKE_LINES=300   # 把 wake 读取量改成 300 行
memo config WAKE_LINES=      # 清空自定义,回到默认值
WAKE_LINES 是唯一值得碰的设置 —— 它决定 wake 时 Agent 能"看见"多少上下文(默认 96 行 ≈ 8k tokens)。改它立刻生效,不需要重新计算——这是因为 TREE 是一颗缓存树,不是数据库里的物化视图。
把 memory 迁出 ~/.optmem
export MEMORY_DIR=/path/to/synced/folder # 比如 Dropbox、iCloud、或一个 git 仓库
把 $MEMORY_DIR 设到任何同步目录就实现"多机共享同一份记忆"。因为 storage 是普通文本,git 天然成为版本控制工具。
💡 适用场景
场景 1:跨会话延续编码上下文
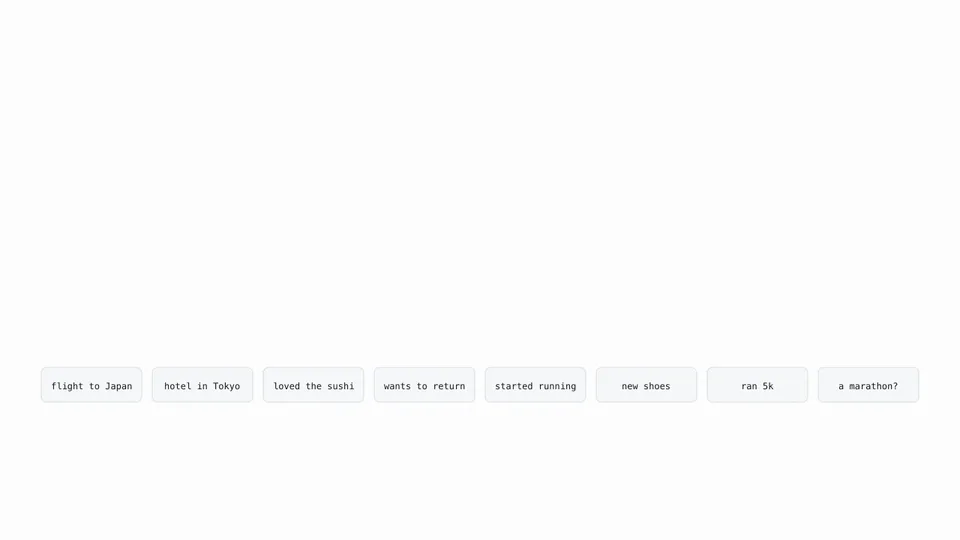
功能说明:你让 Codex 帮你重构一个 30 文件的旧项目,第一天花 4 小时搞到一半,关机后第三天开新会话——按理说 Agent 一切归零,要重头讲背景、约束、前几天的取舍。
输入要求:第一轮教会 Agent 调用 memo note "...",把每条约定/踩坑/决定写到记忆里。
输出效果:第三天 memo wake 输出第一天到第二天累计的 96 条切片(包括近 4 条原文 + 上面的合并摘要)——Agent 一眼"看见"自己前两天做了哪些决定、为什么这样设计、被你纠正过哪些偏好。
适用场景:
- 重构/迁移老项目需要跨越多次长会话
- 多人协作同一 Agent、多个 Agent 同时维护同一 codebase
- 需要"教 AI 你团队"的命名规范、code review 口味、测试约定
适合人群:连续 2-3 天以上做同一项目的工程师;不愿每次重新交代背景的独立开发者
场景 2:用普通文本做私域笔记
功能说明:把 OptMem 当"纯文本版的 Roam Research"来用 —— memo note "今天发现 xxx"、memo recall "yyy" 搜整本日志,没有任何云、没有任何 embedding 模型、不锁供应商。
输入要求:每条笔记控在 280 字节(一行内);触发合并时愿意花 1 分钟回答压缩 prompt。
输出效果:recall <正则> 是逐字搜索,不搞语义相似,所以找"上次我们聊过 xxx"非常准;但缺点是没法做"意思差不多"的回查——记得这种设计取舍。
适用场景:
- 私域写作/日记/读书笔记,担心被云端索引
- 把你和 AI 之间"有保留价值"的对话沉淀为可检索语料
- 给团队/家人留一份"AI 视角下我这一周在忙什么"的审计记录
适合人群:讨厌 Notion/Obsidian 云锁定的隐私党;想把 Agent 真实产出纳入个人知识库的写作者
场景 3:多 Agent / Subagent 的权限隔离
功能说明:OptMem 的 prompt 块自带一条"subagent 不要调用 memo"的红线 —— 因为并行 session 都可能写记忆,而 subagent 无法判断"这条信息是否已经被记过",它的笔记会重复且不准确。
输入要求:当你在 AGENTS.md 里写"spawn 一个 subagent"时,必须在 prompt 里追加一句 You are a subagent. Don't run memo.
输出效果:主 session 的记忆保持干净不被子任务污染;subagent 自己临时的小记忆用别的方案(如对话内 inline notes)。
适用场景:
- 用 Task tool 派生的 subagent 链
- 任何"主 Agent 派单给 N 个并行子 Agent"的 multi-agent 框架
- 想让"人格化助理"和"执行子任务机器人"分账不同的记忆库
核心红线:忘掉这条 = 你的 LOG.txt 会被 subagent 的临时决策污染,且无法用 forget 干净清理
用户群体总结
- ✅ 连续长会话的工程师:避免每次重复背景,跨会话保留 96 行 ≈ 8k tokens 的"近期原文 + 历史摘要"
- ✅ 跨模型迁移的团队:今天用 Claude、明天换 Codex,记忆都在 disk 上不丢
- ✅ 隐私敏感的内容创作者:所有记忆在
$HOME/.optmem/memory/LOG.txt,无云、无 embedding、无第三方 - ✅ 多 Agent 编排的开发者:明确的主/sub 边界 + 一致存储格式
- ❌ 不适合:希望"按语义召回"的场景 —— OptMem 只做正则搜索+二叉树合并,没有向量检索
📊 与其他 AI 记忆方案横评
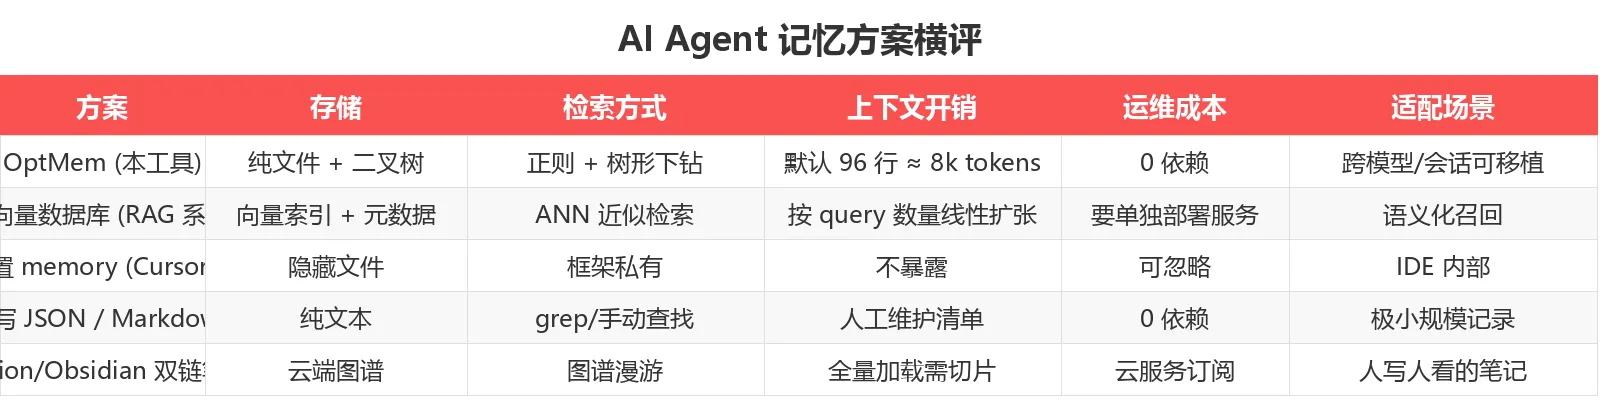
关键取舍:OptMem 用"零运维/纯文件/正则检索"换掉"向量库/embed 调用/语义召回"。如果你要的是"意思差不多的回查",向量方案仍有优势;如果你要的是"零依赖、跨平台、跨模型可移植",OptMem 是目前我能看到的最朴素的方案
🎯 总结
OptMem 是 HVM 作者 Victor Taelin 给"每天跟同一个 Agent 合作"的人做的一份底座工程:没有花哨的 RAG、没有向量数据库、没有云端、没有锁定的供应商。你 5 分钟装完,往 AGENTS.md 贴一段 prompt,Agent 从此跨会话还记得你。
推荐指数: ⭐⭐⭐⭐☆(4.5/5)
适合人群:
- 连续长会话的工程师/独立开发者
- 不想被任何 AI 工具绑定的隐私党
- 想让 multi-agent 系统有个干净记忆底座的架构师
立省 5 分钟: 不要试着去"优化 OptMem"——它的 TREE 缓存就是设计成可以丢的。先把 curl | sh 跑起来用一周,再决定要不要 fork。
立即体验:
curl -fsSL https://raw.githubusercontent.com/VictorTaelin/OptMem/main/install.sh | sh
GitHub 仓库: VictorTaelin/OptMem
数据截至 2026-07-31,最新信息请以官网为准。