GPT-Image-2
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../GPT-Image-2-recommend.pptx../../GPT-Image-2-recommend.mp4本文目录
📌 核心价值:OpenAI 图像生成的"GPT-3 到 GPT-5"时刻——99% 文字渲染准确率 + 自回归单阶段架构,LM Arena 三榜第一 1512 Elo 碾压第二名 242 分
2026 年 4 月 21 日正式发布,Sam Altman 称其飞跃"相当于从 GPT-3 一步到 GPT-5"。文字渲染 99% 准确率覆盖中/日/韩/阿/希/印六种语言,最大 3840px 分辨率,单次前向推理仅需 ~3 秒。
🚀 什么是 GPT-Image-2?
GPT-Image-2(ChatGPT Images 2.0)是 OpenAI 于 2026 年 4 月 21 日正式发布的下一代图像生成模型。它不是 DALL-E 4——OpenAI 研究科学家 Boyuan Chen 表示,GPT-Image-2 的架构是"从头重建",而非对 DALL-E 的改进。配合发布的时间节点是 2026 年 5 月 12 日,DALL-E 2 和 DALL-E 3 正式关停——扩散模型时代就此落幕。
发布 12 小时后,GPT-Image-2 强势斩获 LM Arena 图像生成排行榜全类别第一名,创造该榜单历史最大领先幅度(+242 分 Elo)。要知道 GPT-4o 当年在 NLP 榜单的领先优势也没有这么悬殊。发布首日,Figma、Canva、Adobe Firefly、fal.ai 等主流设计工具均宣布集成。
核心定位:从"扩散去噪"到"自回归推理"的范式转换——图像生成也进入了"推理时代"
✨ 核心能力一览
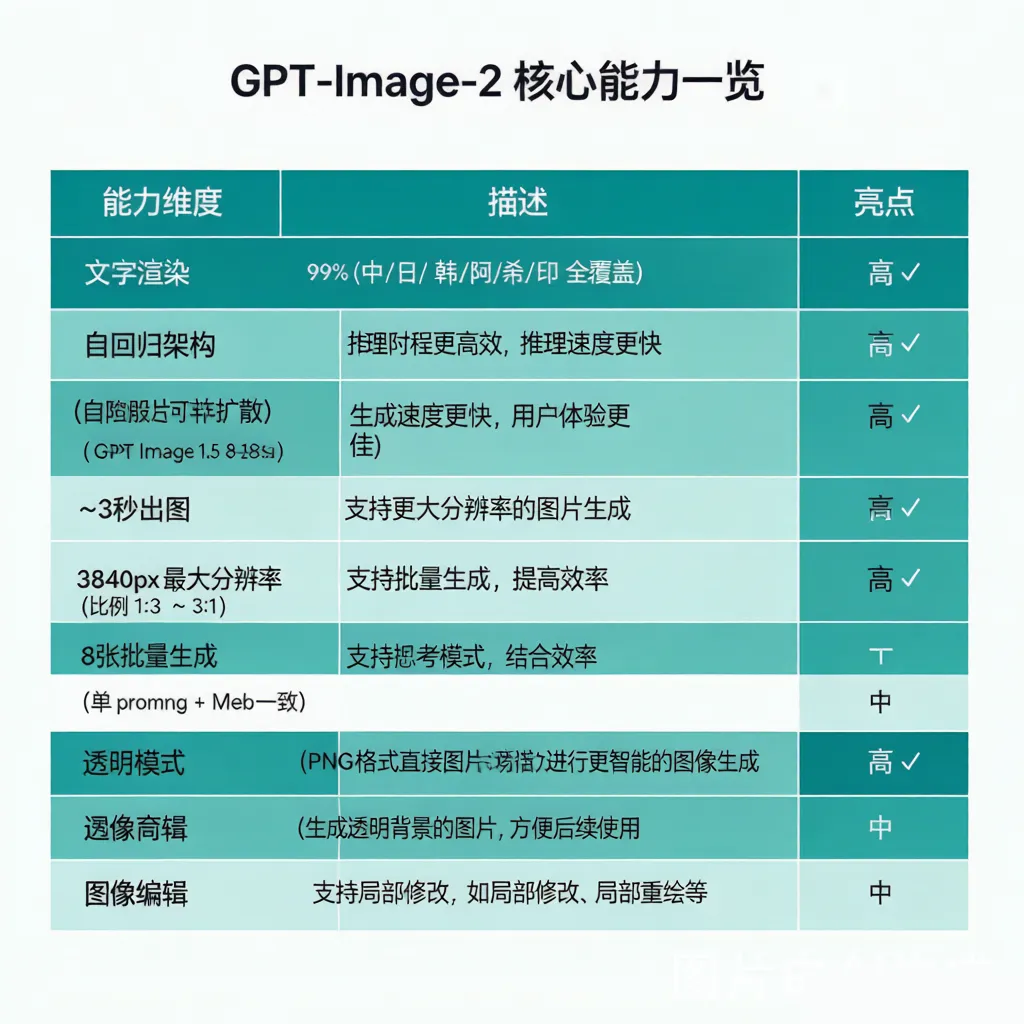
八大能力亮点
- 文字渲染 99%:中文、日文、韩文、阿拉伯文、希伯来文、印地文均支持,约 99% 准确率——这是商业设计(海报、PPT、UI mockup)的关键能力
- 自回归架构:单阶段推理,非扩散模型;与 LLM scaling law 一致
- ~3 秒出图:1024×1024 生成仅需 3 秒(GPT Image 1.5 需 8-18 秒)
- 3840px 最大分辨率:支持 1:3 到 3:1 任意比例
- 8 张批量生成:单 prompt 最多输出 8 张风格一致图像
- 思考模式:集成 reasoning + web search,处理复杂 prompt
- 透明背景:PNG 格式直接导出透明背景
- 图像编辑:支持 inpainting(通过 mask 局部修改)
🛠️ 技术架构
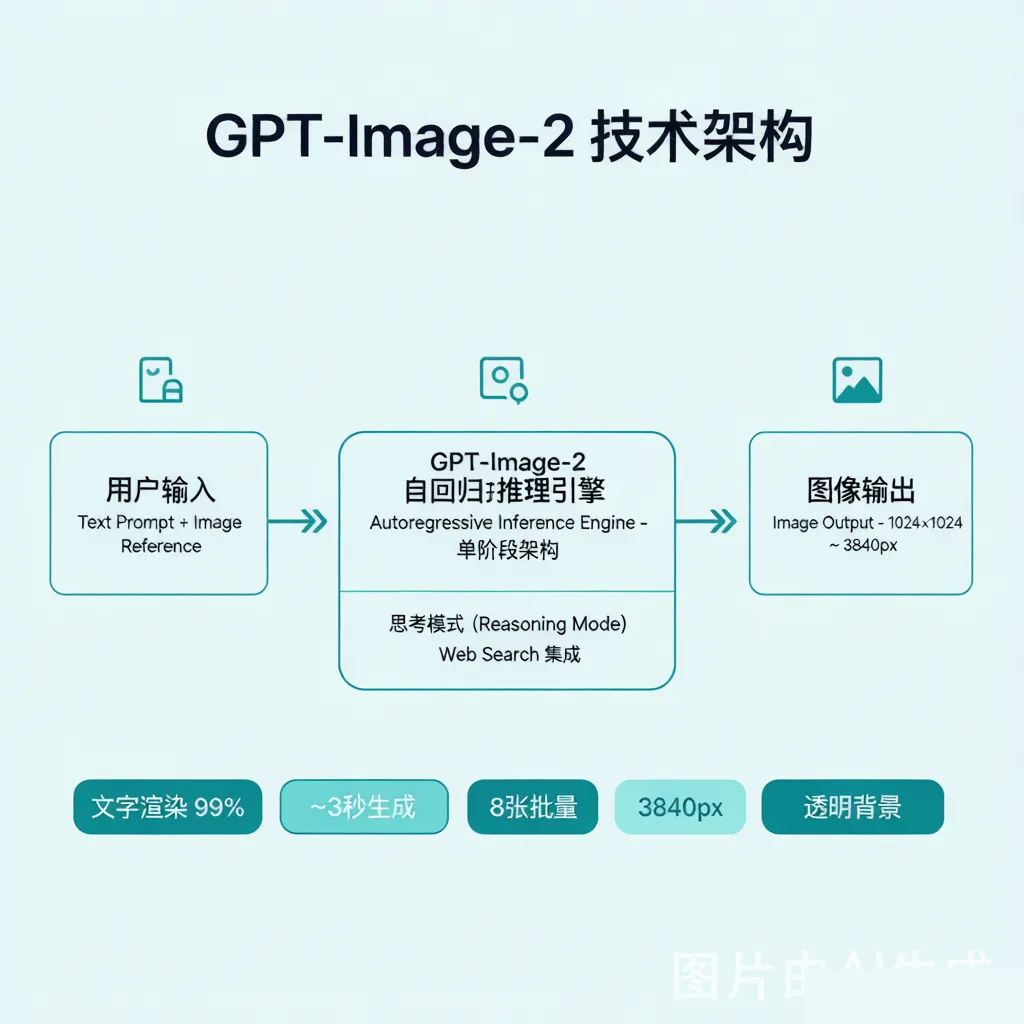
GPT-Image-2 最大的技术突破不是参数量,而是 架构范式的转换:被广泛认为采用了自回归架构(Autoregressive Model),而非扩散模型。OpenAI 研究科学家 Boyuan Chen 表示,架构"从头重建"。
核心架构要点:
- 架构类型:自回归模型(非扩散)
- 推理阶段:单阶段(vs GPT Image 1.5 的两阶段)
- 推理能力:集成(类 o-series)
- 与 GPT-5 关系:独立模型,GPT-5.x 可作为工具调用
- 第三方组合:OpenRouter 出现
gpt-5.4-image-2组合模型(非 OpenAI 官方)
重要判断:图像生成的"推理时代"开启后,scaling law 与 LLM 高度重叠——更大的模型、更多的计算、更好的推理能力
📊 与竞品对比
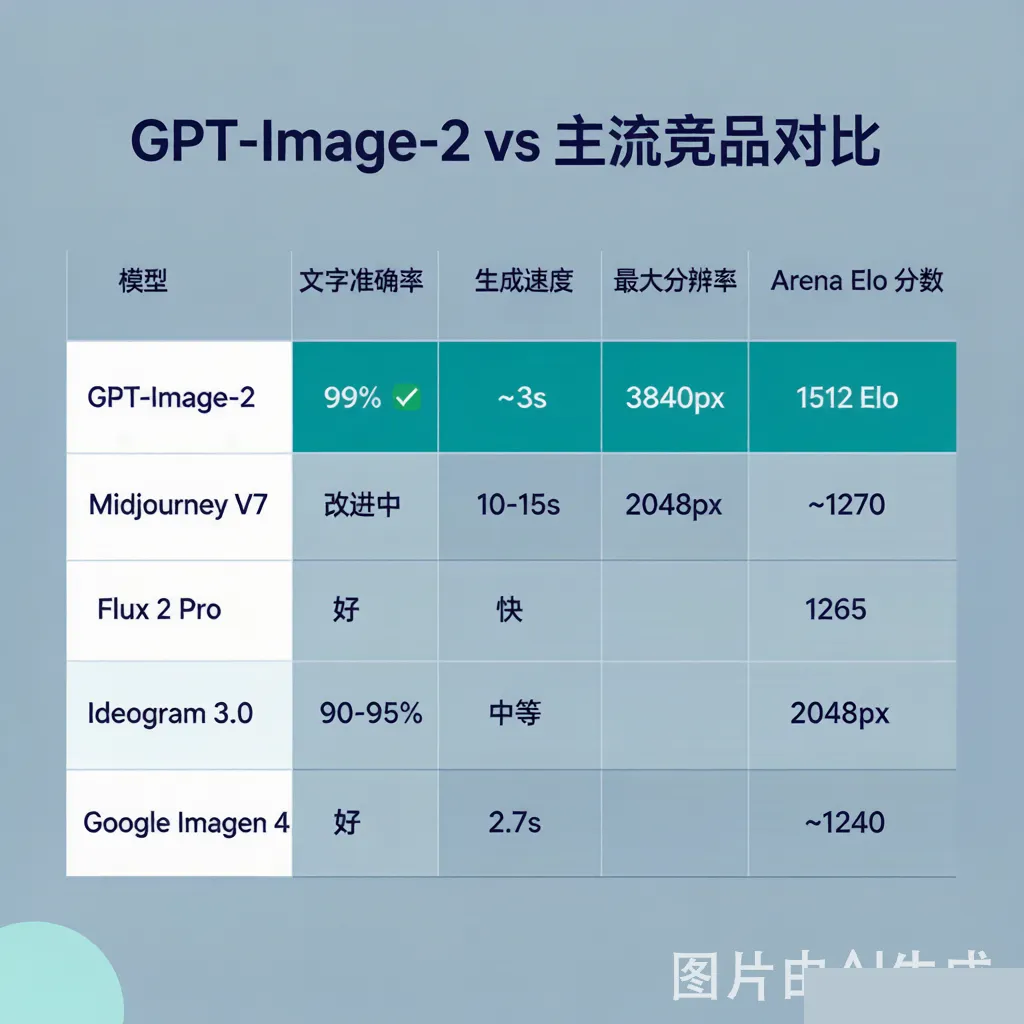
LM Arena 文生图排行榜显示,GPT-Image-2 以 1512 Elo 分位居第一,与第二名差距达 242 分。
| 维度 | GPT-Image-2 | Midjourney V7 | Flux 2 Pro | Ideogram 3.0 | Google Imagen 4 |
|---|---|---|---|---|---|
| 文字准确率 | ~99% | 改进中 | 好 | 90-95% | 好 |
| 速度 | ~3s | 10-15s | 快 | 中等 | 2.7s |
| 最大分辨率 | 3840px | 2048px | 2048px | 2048px | 2048px |
| 成本/张 | $0.006-0.211 | ~$0.01-0.04 | $0.055 | ~$0.04 | $0.02-0.06 |
| Elo 分数 | 1512 | ~1270 | 1265 | ~1250 | ~1240 |
242 分 Elo 差距是压倒性的,但竞争格局未必终结——Midjourney 在美学风格控制、Flux 在真实感摄影风格上仍有受众
💰 API 定价
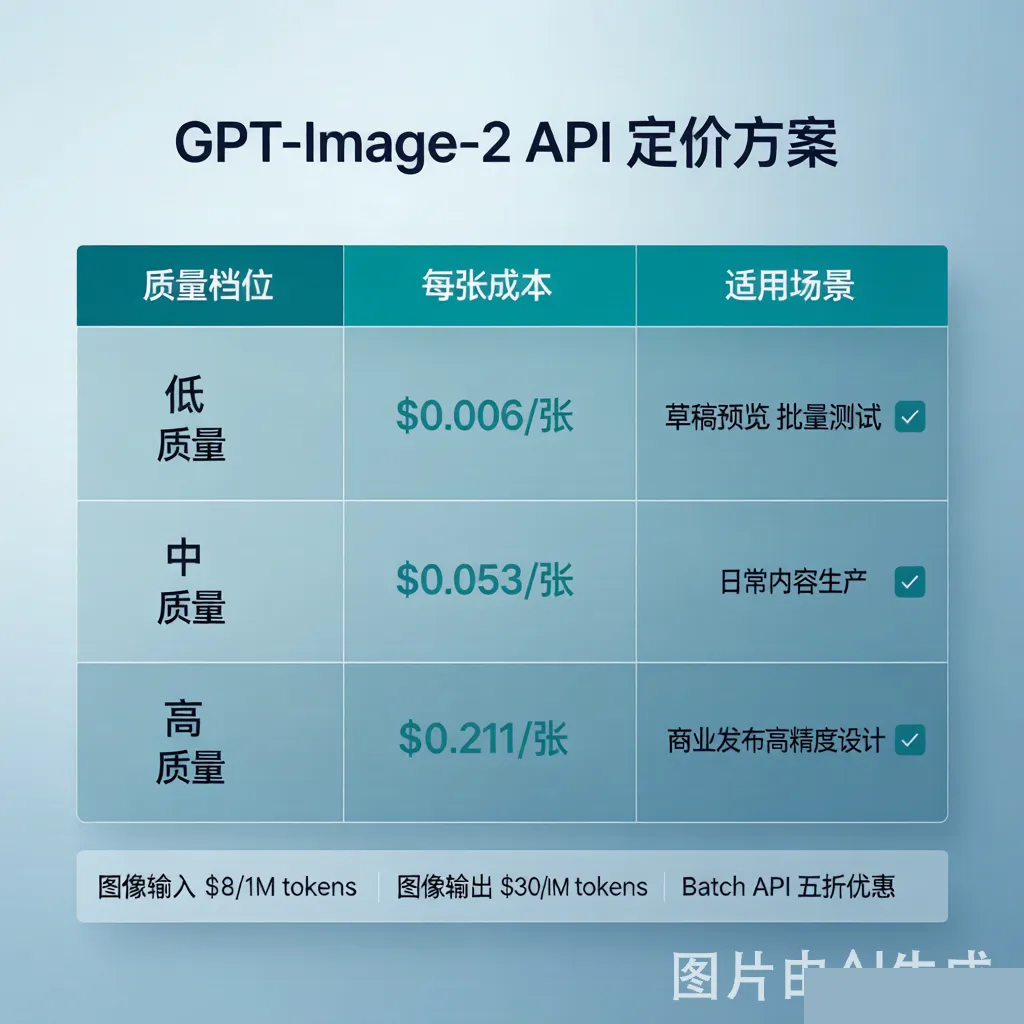
GPT-Image-2 对 API 开发者开放,采用质量分级定价。需要通过 Organization Verification(组织验证)才能调用。
质量档位对比:
| 质量档位 | 每张成本 | 适用场景 |
|---|---|---|
| Low | $0.006 | 草稿、预览、批量测试 |
| Medium | $0.053 | 日常内容生产 |
| High | $0.211 | 商业发布、高精度设计 |
Token 定价(按 token 计费场景):
- 图像输入:$8 / 1M tokens
- 图像输出:$30 / 1M tokens
- 文本输入:$5 / 1M tokens
- 文本输出:$10 / 1M tokens
Batch API 享五折优惠(图像输出 $15/M tokens),适合批量生成场景。
💡 新用户提醒:Organization Verification 是硬性要求,个人账号需先完成组织认证才能调用 API
💡 适用场景
场景 1:AI 摄影风格人像
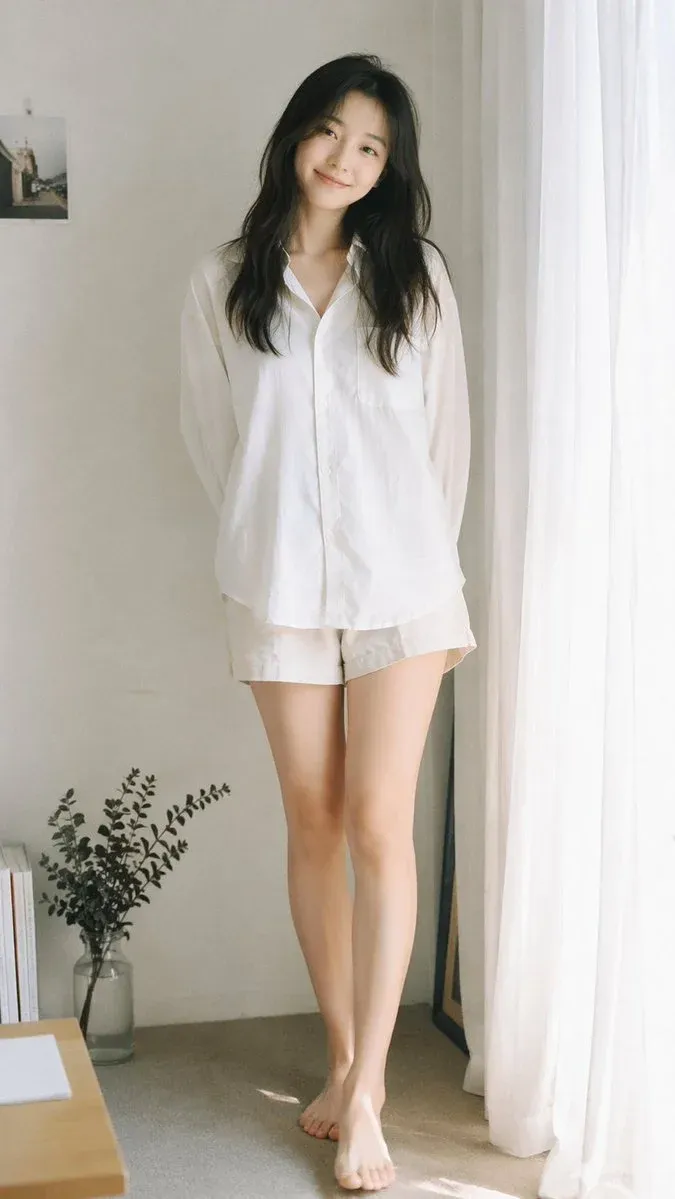
功能说明:单 prompt 即可生成 35mm 胶片质感的真实人像摄影,支持东方女性、自然光线、过度曝光等多种参数控制。
输入要求:英文/中文 prompt 描述场景、服装、光线、构图
输出效果:写实级人像,色彩过渡自然,无 AI 痕迹
适用场景:摄影作品集、社交媒体头像、博客配图
场景 2:多格角色一致性
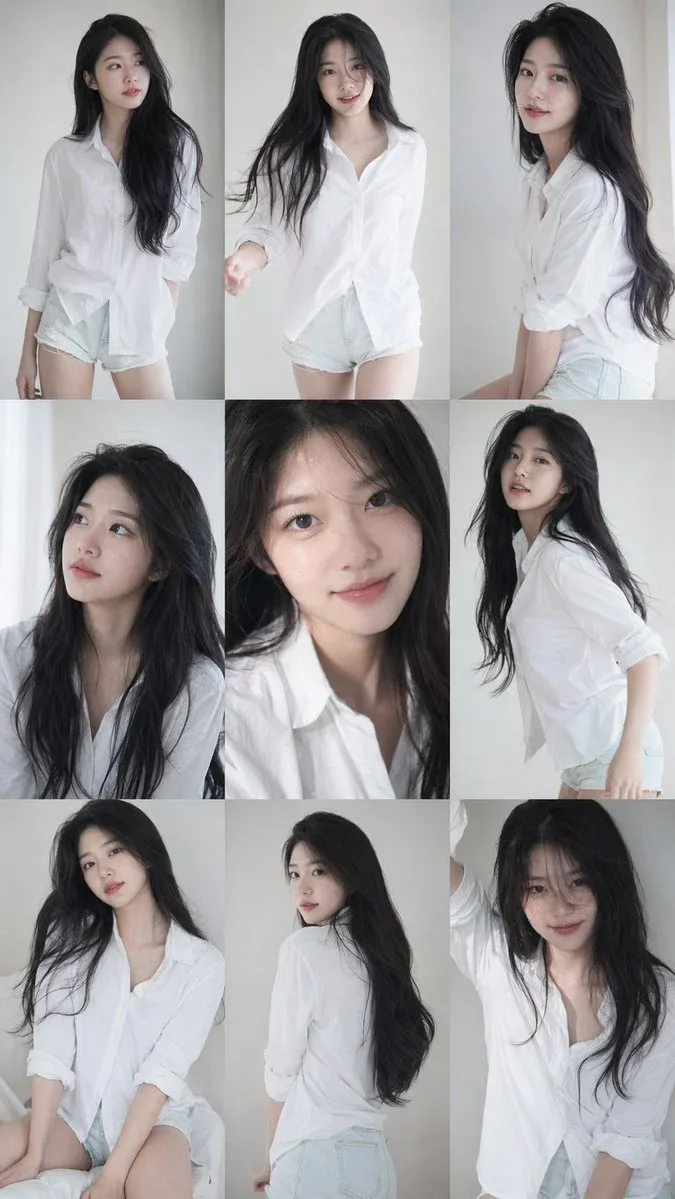
功能说明:单 prompt 生成 3×3 九宫格,9 张图中同一角色的面部特征、肤色、发型高度一致——这是 AI 角色创作的核心痛点。
输入要求:prompt 包含"9:16 vertical 3×3 grid"格式,明确指定风格
输出效果:角色一致性达到商业摄影级别,可直接用于写真集、社交媒体内容
适用场景:虚拟偶像写真、IP 形象一致性测试、电商产品多角度展示
场景 3:漫画与叙事
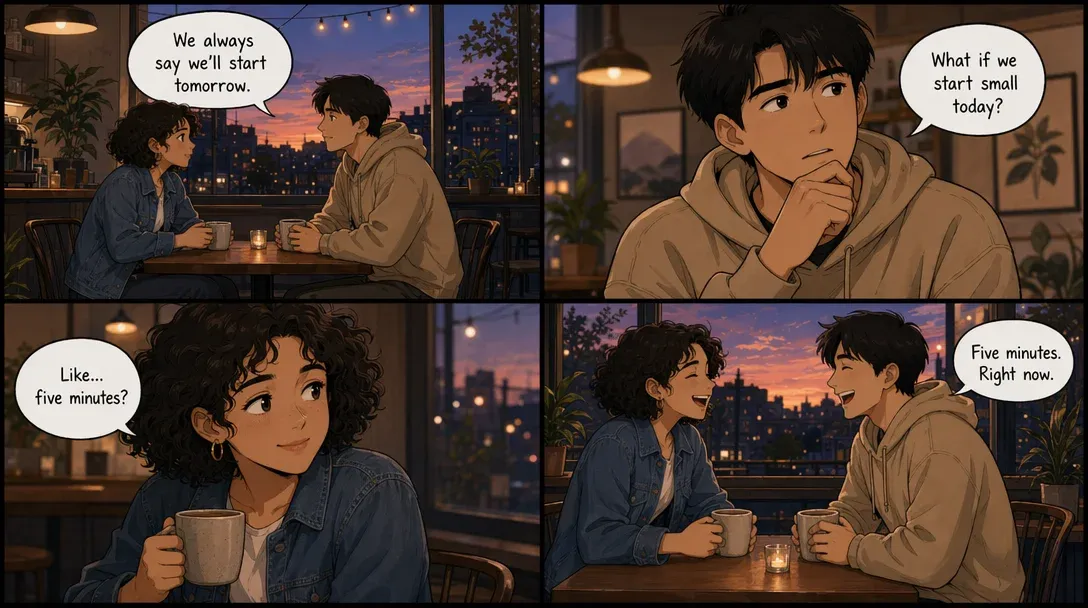
功能说明:生成 4 格漫画,包含可读的对话气泡文字——文字渲染能力是核心。角色在 4 格中保持一致,对话气泡清晰可读。
输入要求:详细描述每个分镜的画面 + 对话内容
输出效果:完整漫画分镜,文字 99% 准确,可直接用于故事板或独立漫画
适用场景:漫画创作、故事板、营销内容、社交媒体贴文
场景 4:UI 设计 mockup
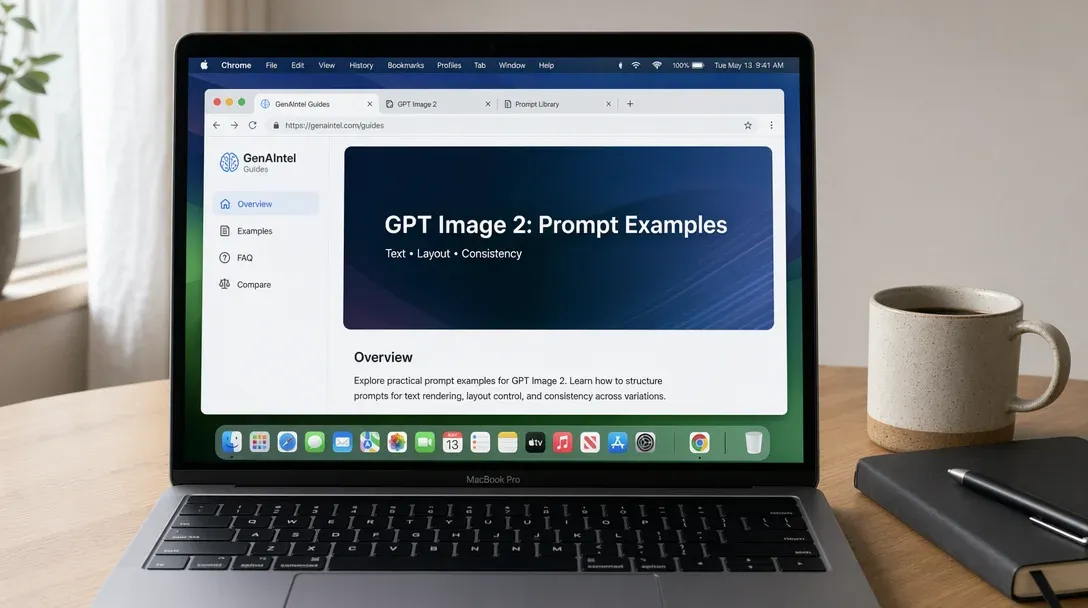
功能说明:生成写实级 MacBook 屏幕截图,UI 元素、地址栏、标签页、界面 chrome 像素级精确,几乎与真实截图无异。
输入要求:详细描述 UI 元素、配色、布局
输出效果:写实级 UI mockup,可用于产品发布、博客文章、设计稿
适用场景:产品发布视觉、技术博客配图、设计稿参考
场景 5:SaaS 落地页
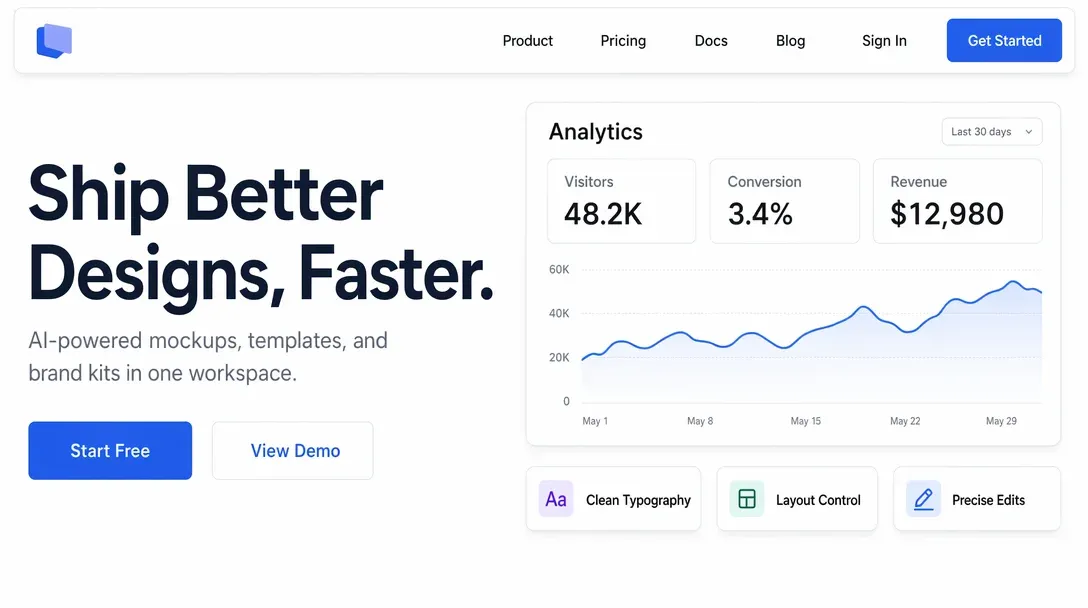
功能说明:单 prompt 生成完整 SaaS 产品落地页 mockup——包含导航、Hero 区块、特性卡片、CTA 按钮,设计语言一致。
输入要求:明确指定产品名、Hero 文案、特性列表、CTA 文本
输出效果:可直接用于产品介绍页面的视觉稿
适用场景:初创公司产品介绍、Y Combinator 申请材料、产品发布推文
场景 6:多场景文字渲染
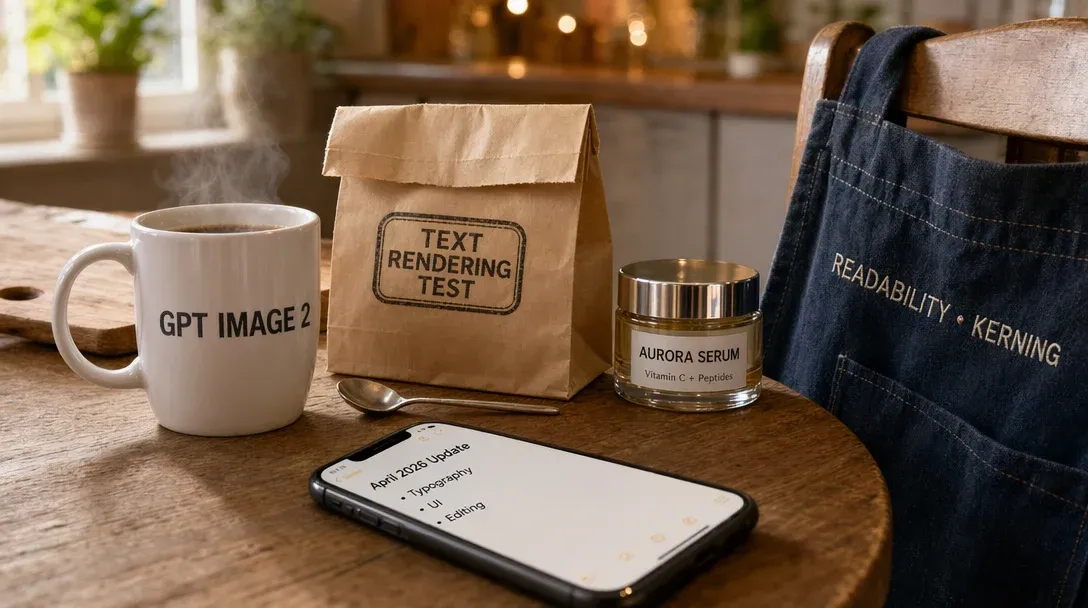
功能说明:在霓虹灯牌、产品包装、手写标签、雕刻文字等多种表面上生成精准文字——99% 准确率是商业设计的关键。
输入要求:指定文字内容 + 表面材质 + 字体风格
输出效果:所有文字在不同表面上都清晰可读,无乱码、无错字
适用场景:海报设计、品牌 VI、产品包装、标志设计
用户群体总结
- ✅ 商业设计师:99% 文字准确率让 AI 成为可信赖的生产工具
- ✅ 内容创作者:海报、PPT、博客配图全流程提效
- ✅ 产品经理:UI mockup、产品落地页快速原型
- ✅ 开发者:API + Python SDK,3 秒生成 1 张图
- ❌ 不适合:需要 100% 物理精度的场景(液体、烟雾动态)
🎯 三种使用方式
方式 1:ChatGPT(最简单)
Plus / Pro / Business / Team / Enterprise 用户直接在 ChatGPT 中描述图片即可,模型自动选择 GPT-Image-2。开启"思考模式"可获得更高质量。
入口:chat.openai.com → 直接描述你想要的图片
方式 2:API(开发者)
from openai import OpenAI

client = OpenAI()

result = client.images.generate(
    model="gpt-image-2",
    prompt="一只戴贝雷帽的猫在巴黎画埃菲尔铁塔",
    size="1024x1024",
    quality="high"
)
前提:需完成 Organization Verification(组织认证)
端点:POST api.openai.com/v1/images/generations
方式 3:Responses API(多轮编辑)
通过 Responses API 的 image_generation 内置工具,支持 previous_response_id 实现多轮迭代编辑。GPT-5 及更新模型可直接调用。
适合"生成→修改→再修改"的工作流
⚠️ 重要提示:API 返回 base64 编码(不是 URL),需自行解码保存;DALL-E 2/3 将于 5 月 12 日关停,现有项目需提前迁移到 gpt-image-2
🛡️ 安全与版权
GPT-Image-2 的安全体系比前代更复杂,但版权问题仍是悬案。
三层安全过滤:
- 上游拒绝:在 LLM 阶段即拒绝违规 prompt
- 输入检测:图像输入的内容安全审查
- 输出检测:生成结果的后置内容过滤
技术措施与合规:
- C2PA 元数据:所有生成图像嵌入 Coalition for Content Provenance and Authenticity 标准元数据
- 不可见水印:通过水印可追溯 AI 生成来源
- moderation 参数:API 支持
auto/low两档过滤强度 - 思考模式越狱率:仅 6.7%(通用越狱率的显著改进)
已知问题:
- 复杂物理建模(液体、烟雾动态)仍有明显问题
- 复杂 prompt 在思考模式下最长等待约 2 分钟
- 多轮迭代编辑中存在质量递减现象
- 51+ 起版权诉讼悬而未决
🎯 总结
GPT-Image-2 是 OpenAI 在 2026 年最重要的产品发布之一。它不是 DALL-E 4,而是一次架构范式的转换——从扩散模型转向自回归推理,图像生成也进入了"推理时代"。
99% 文字准确率是商业关键。对于海报、PPT、UI mockup 等商业设计场景,之前 AI 图像生成的最大障碍不是画质,而是文字错误。这一障碍的消除意味着商业设计师第一次可以把 AI 作为可信赖的生产工具,而非"只能做灵感参考"的玩具。
推荐指数: ⭐⭐⭐⭐⭐(满分 5 星)
适合人群:商业设计师、内容创作者、产品经理、独立开发者
立即体验:OpenAI ChatGPT | OpenAI API 文档
开源协议:商业 API(需要 Organization Verification)
数据截至 2026 年 6 月,最新信息请以 OpenAI 官方文档为准。