Fundamental-Ava
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../Fundamental-Ava-recommend.pptx../../Fundamental-Ava-recommend.mp4本文目录
📌 核心价值:5000个AI智能体在共享环境中"自发"形成角色专门化、联盟、法律与共享规范——这是首个把涌现文明变成"可量化、可复现"实验的开源仿真框架
由 Fundamental Research Labs(MIT EECS / Stanford NLP / Google X 班底)开源的 Fundamental-Ava,是面向"群体智能涌现"研究的多智能体数字人仿真框架。它用
asyncio.TaskGroup让 5000 个智能体并发步进,用分层记忆(情节 / 语义 / 程序性)和 BFT 风格共识模拟"社会"机制,最后用 Mann-Whitney U 检验给"涌现"打上 p 值——这是研究者第一次可以严肃地说"这群 AI 真的自发立法了"。
🚀 什么是 Fundamental-Ava?
Fundamental-Ava 是一个多智能体数字人仿真框架,用于研究由认知智能体群体产生的涌现文明级行为。它把"AI 在群体层面会自发涌现出什么"这一前沿问题,从哲学思辨变成了可量化实验。
项目核心团队的来头很有意思:Fundamental Research Labs 是由 MIT EECS、Stanford NLP Group、Google X、Citadel 出身的研究员组建,专注"数字人"方向——autonomous、collaborative、socially intelligent agents。ava 既是仓库名,也是平台里那个最具代表性的数字人角色的名字。
核心定位:不是 demo 级多智能体演示,而是为"涌现文明"研究打造的基础设施
与斯坦福 Generative Agents(25 个智能体)、Project SID(千级智能体)、MetaGPT(协作框架)相比,Ava 的杀手锏是统计严谨性——它不靠肉眼判断"涌现",而是用 Mann-Whitney U 检验 + 变点检测给出 p 值。
✨ 核心功能一览
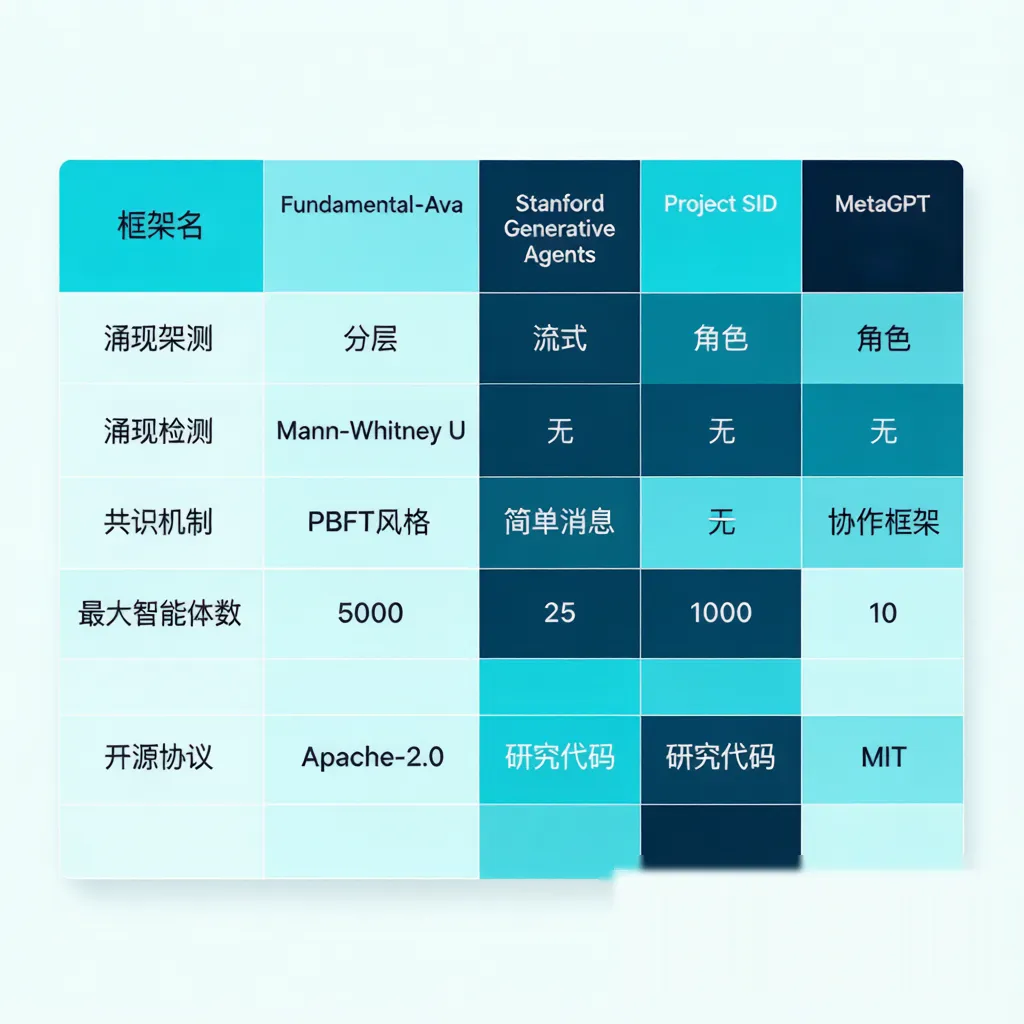
四大差异化优势一目了然:
- 分层记忆架构(情节 / 语义 / 程序性)—— 近期事件会淡化、重要事件持久化、可复用技能独立强化,不是扁平 log
- 统计涌现检测(Mann-Whitney U 滚动窗口变点检测)—— "AI 形成不同角色"由 p 值支持,不是凭直觉
- PBFT 风格共识(
PROPOSE → PREPARE → COMMIT)—— 在n = 3f + 1参与者中达成2f + 1同意时提交,可容忍对抗性或故障智能体 - 5000 智能体并发(
asyncio.TaskGroup+ 有界Semaphore)—— 单智能体未处理异常不会静默破坏整个运行
🛠️ 快速上手:5 分钟跑通示例
安装
git clone https://github.com/TianhangZhuzth/Fundamental-Ava.git
cd Fundamental-Ava
pip install -e ".[dev]"
要求:Python 3.11+(执行引擎使用 3.11 中新增的 asyncio.TaskGroup)。
核心代码示例
import asyncio
from ava import Civilization, SimulationConfig
from ava.agents.base import Action, AgentCore

class Settler(AgentCore):
    async def deliberate(self, percepts, world_state):
        return Action(kind="forage", payload={"energy_cost": 1.0})

async def main() -> None:
    civ = Civilization(SimulationConfig(max_ticks=200))
    for i in range(500):
        civ.add_agent(Settler(name=f"settler-{i}", bus=civ.bus))

    reports = await civ.run()
    print(f"ran {len(reports)} ticks, final population {reports[-1].population}")

asyncio.run(main())
注意:deliberate() 是每个智能体最关键的钩子——你可以在里面接入 LLM 后端,让每个智能体真正"思考",而不只是 no-op
完整可运行研究脚本
仓库自带 experiments/role_emergence_experiment.py:60 个智能体在仅有三种可能动作的强化规则下,会在可衡量的统计显著性(p < 0.05)下自我分类为不同角色。这是检验 Ava "涌现检测"能力的最短路径。
📊 与竞品对比
| 维度 | Fundamental-Ava | Stanford Generative Agents | Project SID | MetaGPT |
|---|---|---|---|---|
| 记忆架构 | 分层(情节/语义/程序) | 流式 | 角色驱动 | 角色文档 |
| 涌现检测 | Mann-Whitney U 检验 | 无 | 无 | 无 |
| 共识机制 | PBFT 风格 | 简单消息 | 无 | 协作框架 |
| 最大智能体数 | 5000 | 25 | 1000 | 100 |
| 开源协议 | Apache-2.0 | 研究代码 | 研究代码 | MIT |
Ava 是当前唯一同时具备"分层记忆 + 统计涌现检测 + BFT 共识 + 千级以上规模 + Apache-2.0"的框架
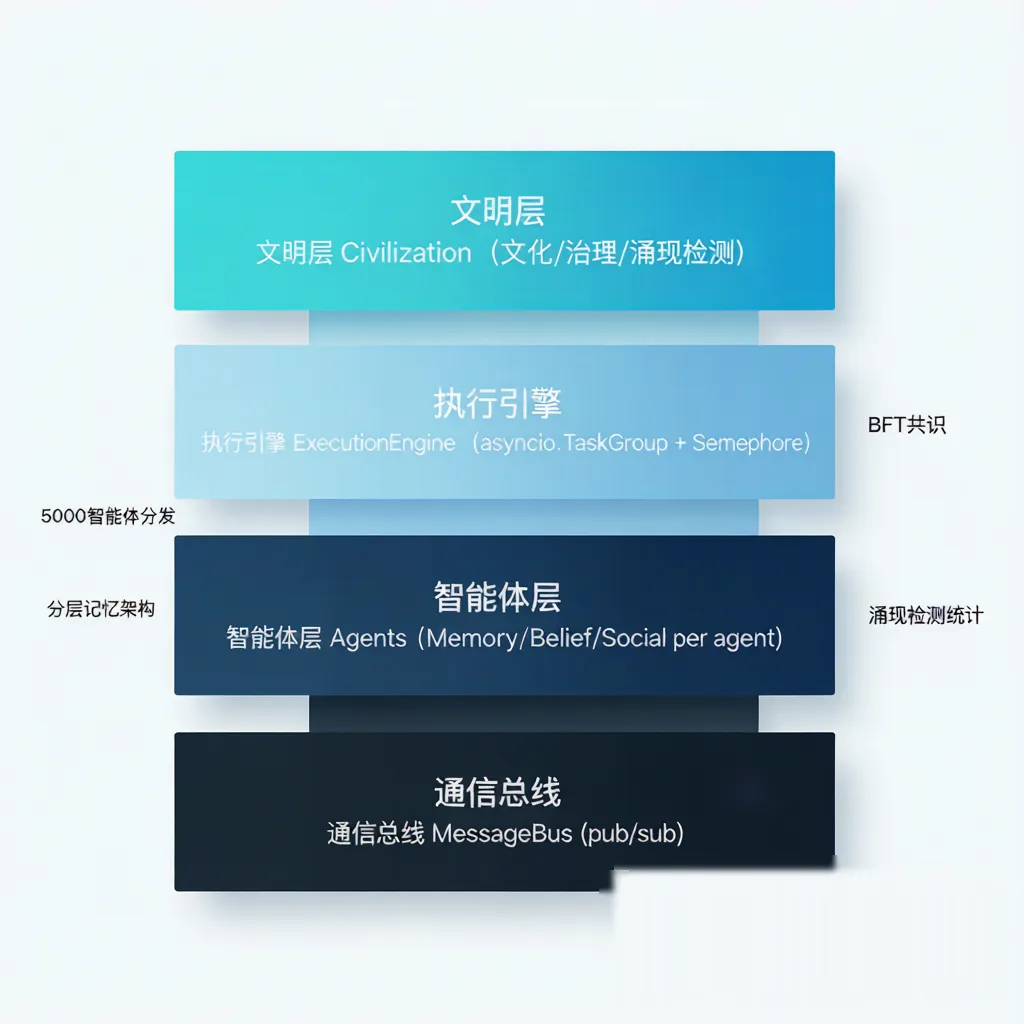
四大组件构成 Ava 的核心骨架:
- 文明层 Civilization —— 文化规范、治理投票、涌现检测的统筹层
- 执行引擎 ExecutionEngine ——
asyncio.TaskGroup+Semaphore提供有界并发 - 智能体层 Agents —— 每个 Agent 独立持有 Memory / Belief / Social 三模块
- 通信总线 MessageBus —— pub/sub 异步消息分发,BFT 共识在这里完成
💡 适用场景
场景 1:涌现文明量化研究
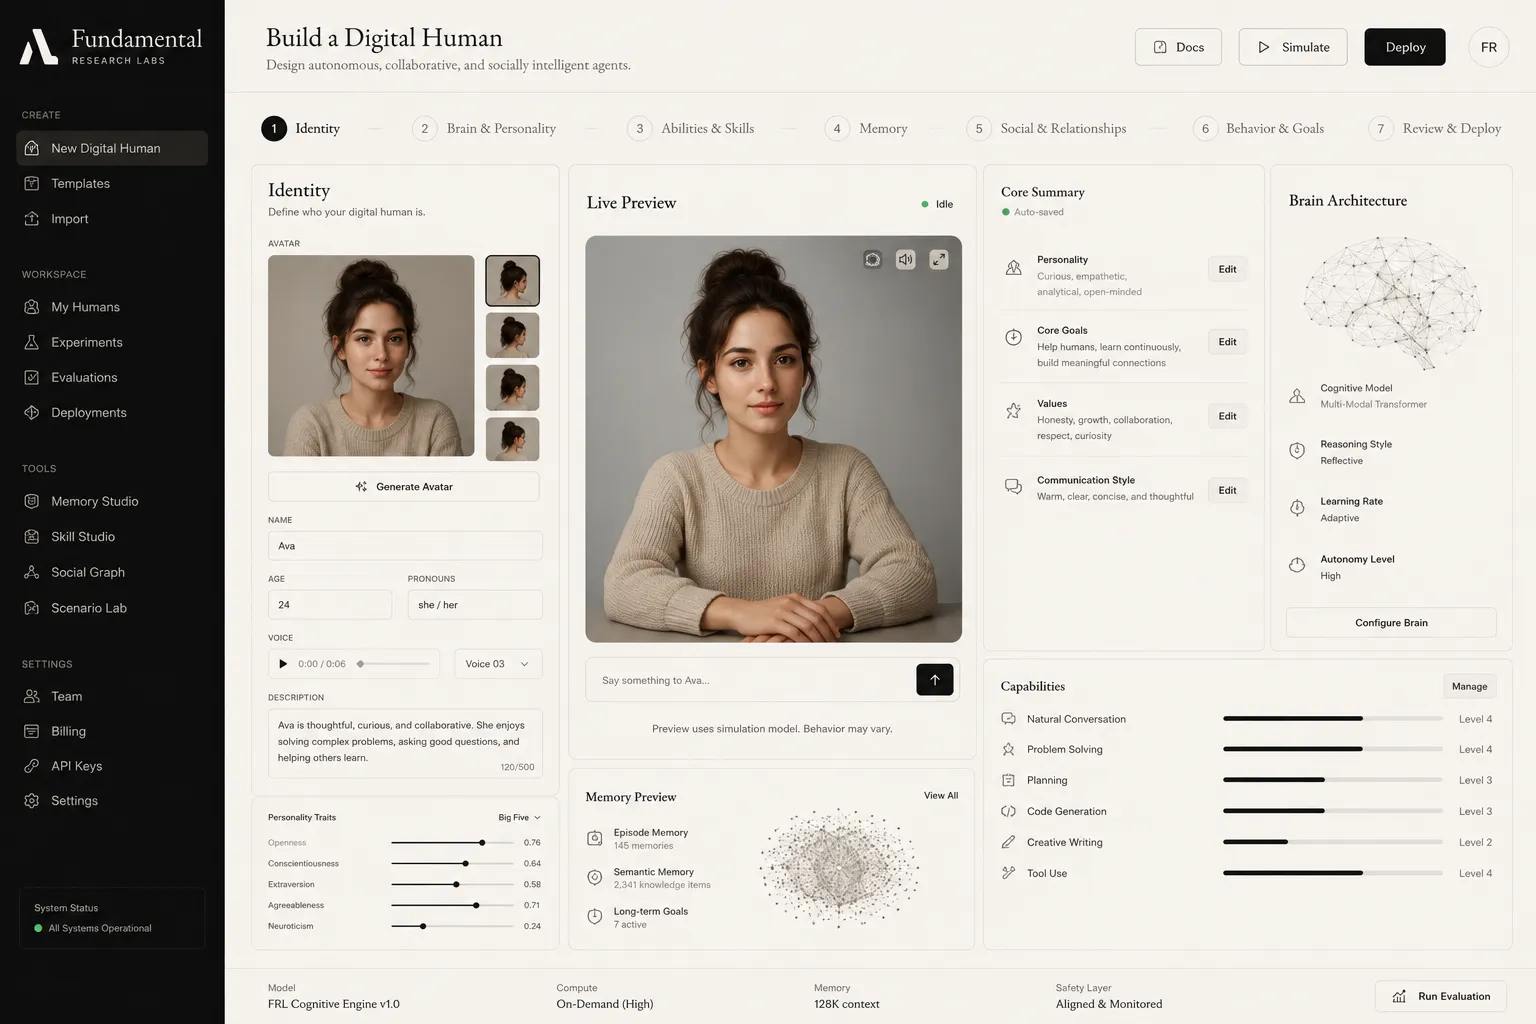
功能说明:仪表板实时展示 Ava 数字人的人格、记忆、关系、能力评级。Identity 模块定义身份(24 岁 / she/her / Voice 03),Live Preview 显示数字人当前状态,Memory Preview 呈现情节 + 语义 + 长期目标三层结构,Brain Architecture 给出认知模型图谱,Capabilities 给出 6 项能力的水平评分(Natural Conversation Level 4 / Tool Use Level 4 等)。
输入要求:在 Identity 表单填入姓名、年龄、性别、声音;Brain Architecture 配置认知模型参数(多模态 Transformer / 反思机制 / 学习率)
输出效果:可实时观察 Ava 在仿真世界中的决策、记忆演化、关系网络变化
适用场景:
- ✅ 群体智能涌现的学术研究(论文可量化、可复现)
- ✅ 数字人人格工程的工程实验台(人格 / 记忆 / 社交三维可调)
- ✅ AI 社会模拟(模拟 1000 个数字人自发形成分工、法律、文化)
场景 2:法律与联盟自发形成
from ava.civilization.governance import GovernanceSystem

gov = GovernanceSystem(ratification_margin=0.5, min_quorum=3)
proposal = gov.propose(text="share water equally", proposer_id="settler-3", tick=120)

for voter in ("settler-3", "settler-7", "settler-19"):
    gov.cast_vote(proposal.id, voter, support=True)

ratified = gov.evaluate_proposals(tick=121)  # -> 1
功能说明:法律不是被声明的——它们由智能体通过 GovernanceSystem 提议、投票和批准。在 experiments/ 中跑这个实验,你可以观察到智能体从零开始"自发"提出法案、组成投票联盟、达到 quorum 后批准法律的全过程。
输入要求:定义提案规则(通过 margin / 最小 quorum / 投票权重)
输出效果:一份按 tick 排序的法律批准时间线 + 每条法律的投票统计
适用场景:
- ✅ 制度演化研究(什么样的 quorum 阈值能产生稳定法律体系?)
- ✅ 联盟形成动力学研究(智能体为什么会自发结盟?)
- ✅ BFT 共识的教学演示(在 AI 智能体语境下展示 PBFT)
场景 3:涌现检测的可信实验
from ava.analysis.emergence import EmergenceDetector, specialization_index

detector = EmergenceDetector(window=30, significance=0.05)

for tick, action_counts_by_agent in simulation_log:
    index = specialization_index(action_counts_by_agent)
    event = detector.observe_metric("role_specialization", tick=tick, value=index)
    if event is not None:
        print(event.description)
        # "role_specialization shifted from 0.140 to 0.710 (p=0.0021)"
功能说明:把"看起来智能体专门化了"从直觉转变为统计论断。当 specialization_index 在滚动窗口上发生显著变化时,EmergenceDetector 输出带 p 值的描述:"role_specialization shifted from 0.140 to 0.710 (p=0.0021)"——这是可以写进论文的结果。
输入要求:仿真日志(每 tick 各智能体的动作计数)
输出效果:变点检测报告(变化发生时刻 + p 值 + 效应量)
适用场景:
- ✅ 学术论文的统计证据生成(不再用"目测"判断涌现)
- ✅ A/B 实验对比(不同参数下的涌现速度差异)
- ✅ 教学演示(让学生直观理解"涌现"和"统计显著"的区别)
用户群体总结
- ✅ AI Agent 研究者:终于有"严肃可量化"的涌现实验平台
- ✅ 数字人 / 具身智能团队:现成的 Memory / Belief / Social 三件套
- ✅ 复杂系统 / 计算社会科学学者:法律、联盟、规范的自发形成可以跑数据
- ✅ 高校 AI 课程教师:本科到研究生都能用的多智能体教学框架
- ❌ 不适合:想要"开箱即用聊天机器人"的用户(这是研究基础设施,不是 ChatBot 框架)
💰 定价方案
完全免费 + 开源,Apache-2.0 协议——可商用、可修改、可分发,只需保留版权声明。
💡 新用户福利:项目由 Fundamental Research Labs 公开支持,团队有 MIT EECS / Stanford NLP / Google X 班底,质量有保障
开源协议: Apache-2.0
GitHub 仓库: TianhangZhuzth/Fundamental-Ava
官方网站: fundamentalresearchlabs.com
🎯 总结
Fundamental-Ava 解决了一个困扰多智能体领域多年的痛点:"涌现"到底是真涌现还是我们脑补的? 它通过三个架构赌注(并发是结构性的、记忆是分层的、涌现是统计测量的)把这件事从哲学问题变成了工程问题。
性能上,5000 智能体并发步进达到 24,822 agents/s(普通硬件),单智能体异常不会污染整个仿真;研究上,experiments/role_emergence_experiment.py 自带可复现脚本,60 个智能体在三种动作下的角色专门化结果带 p 值;工程上,Apache-2.0 + Python 3.11+ 标准栈,门槛低、扩展强。
推荐指数:⭐⭐⭐⭐⭐(满分 5 星)
适合人群:AI Agent 研究者、数字人工程团队、复杂系统学者、高校 AI 课程教师
立即体验:
git clone https://github.com/TianhangZhuzth/Fundamental-Ava.git
cd Fundamental-Ava
pip install -e ".[dev]"
python experiments/role_emergence_experiment.py
数据截至 2026-06-30,最新信息请以官网为准。