zer0factor
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../zer0factor-recommend.pptx../../zer0factor-recommend.mp4本文目录
📌 核心价值:把"研报→因子代码→评估报告"做成一条 Codex Skill 流水线,A股 T+1 口径一气呵成。
zer0factor 是一套面向 A 股本地数据的 AI 因子研究工作台:研报 PDF 灌进去,AI 直接吐出可运行的因子代码与 IC/分组收益/组合绩效评估。它用 FactorSpec 把"什么是因子"标准化,再以 zer0share 本地 Parquet 数据底座为支点,把"研报→预处理→评估→报告"封装成可复现的工程流水线。
🚀 什么是 zer0factor?
zer0factor(zer0quant/zer0factor)是一个 MIT 协议的 AI 辅助因子研究工程,把因子定义、计算、预处理、评估与归档做成一条 CLI 流水线。它的目标不是再做一个 Alphalens 替代品,而是把"研究员读研报→手写因子→跑数据→看 IC"这条慢路径压缩成"Codex/Claude Code Skill 读研报→生成候选因子→人工审核→批量评估→落盘归档"的工程化闭环。
仓库核心定位是 "研报→因子代码→评估报告" 的工作台(research workbench),与配套的 zer0quant/zer0share 一起构成"本地 A 股数据底座 + 因子研究台"的组合拳。


核心定位:FactorSpec + zer0share + Alphalens 三件套 + 研报转因子 Skill,是目前最贴合 A 股 T+1 制度的开源因子研究台。
✨ 核心功能一览
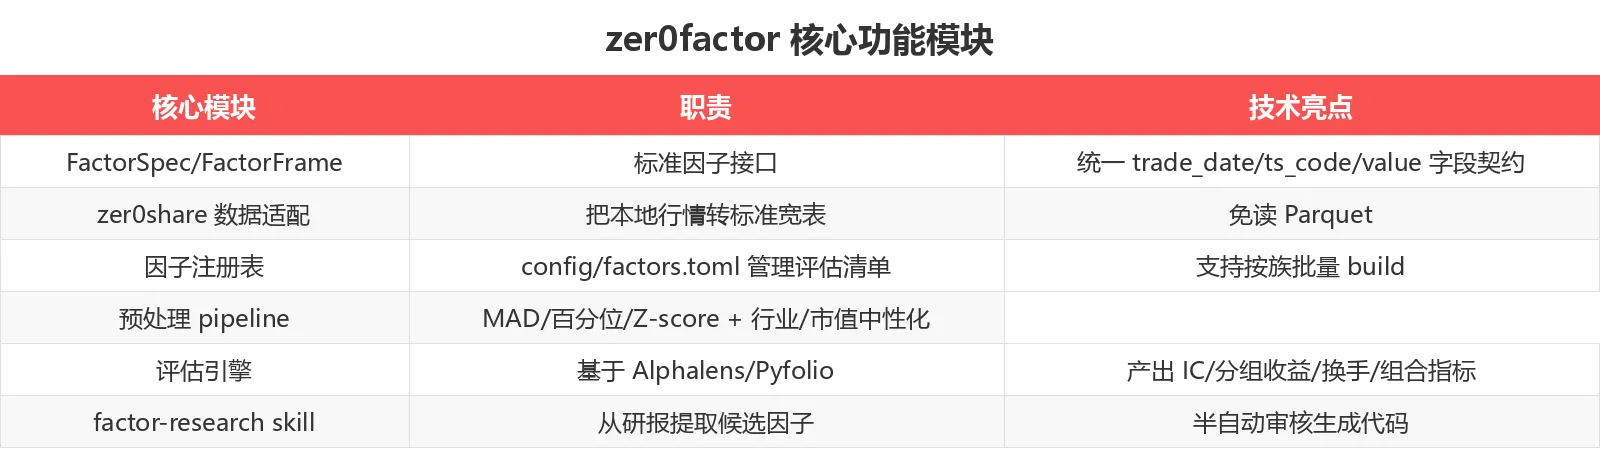
| 模块 | 职责 | 关键设计 |
|---|---|---|
| FactorSpec/FactorFrame | 因子接口契约 | 统一 trade_date / ts_code / value 三列,Python compute() 函数签名固定 |
| zer0share provider | 数据接入 | 本地 Parquet 分区 + DuckDB 注册表,避免每跑一次都读 Tushare |
| factor registry | 因子清单 | config/factors.toml 集中管理候选因子、标签、默认评估参数 |
| preprocess pipeline | 截面预处理 | MAD/百分位法去极值 → 行业/市值中性化 → Z-score/Rank 标准化 |
| eval engine | 因子评估 | 基于 Alphalens / Pyfolio 输出 IC、分组收益、换手、组合绩效 |
| factor-research skill | 研报→因子 | Codex/Claude Code 可触发的 6 阶段半自动工作流 |
🛠️ 快速上手:5 分钟跑通一个因子
1. 安装与配置
# 前置依赖:Python 3.11+ / uv / zer0share 已同步好的本地 A 股数据
git clone https://github.com/zer0quant/zer0factor.git
cd zer0factor
uv sync

# 配置文件
cp config/settings.example.toml config/settings.toml
# 改 settings.toml 里的 [zer0share] data_dir 指向你的本地 Parquet 仓库
2. 最小可用流程(以内置市值因子为例)
# 查看本地因子库当前状态
uv run python main.py --config config/settings.toml status

# 计算内置市值因子并写入 Parquet
uv run python main.py compute-market-cap

# 单因子评估 + 摘要查看
uv run python main.py evaluate-factor log_total_market_cap
uv run python main.py show-summary
评估产物会落在 data/evaluations/<run_id>/,每份包含 Markdown 报告 + summary.json + 中间数据。
3. 写一个自定义因子
import pandas as pd
from zer0factor.core import Factor, FactorFrame, FactorSpec, to_factor_output

class Ret20_0(Factor):
    spec = FactorSpec(
        name="ret20_0",
        inputs=["close"],
        min_window=20,
        frequency="1d",
        adjust="hfq",
    )

    def compute(self, data: FactorFrame) -> pd.DataFrame:
        value = data.close / data.close.shift(20) - 1
        return to_factor_output(value, self.spec.name)
注意:因子代码只允许访问 FactorFrame 字段,禁止直接读文件/查 DuckDB,保证"换数据源只改 provider、不改 compute"的工程契约。
📊 与主流 AI 量化框架对比
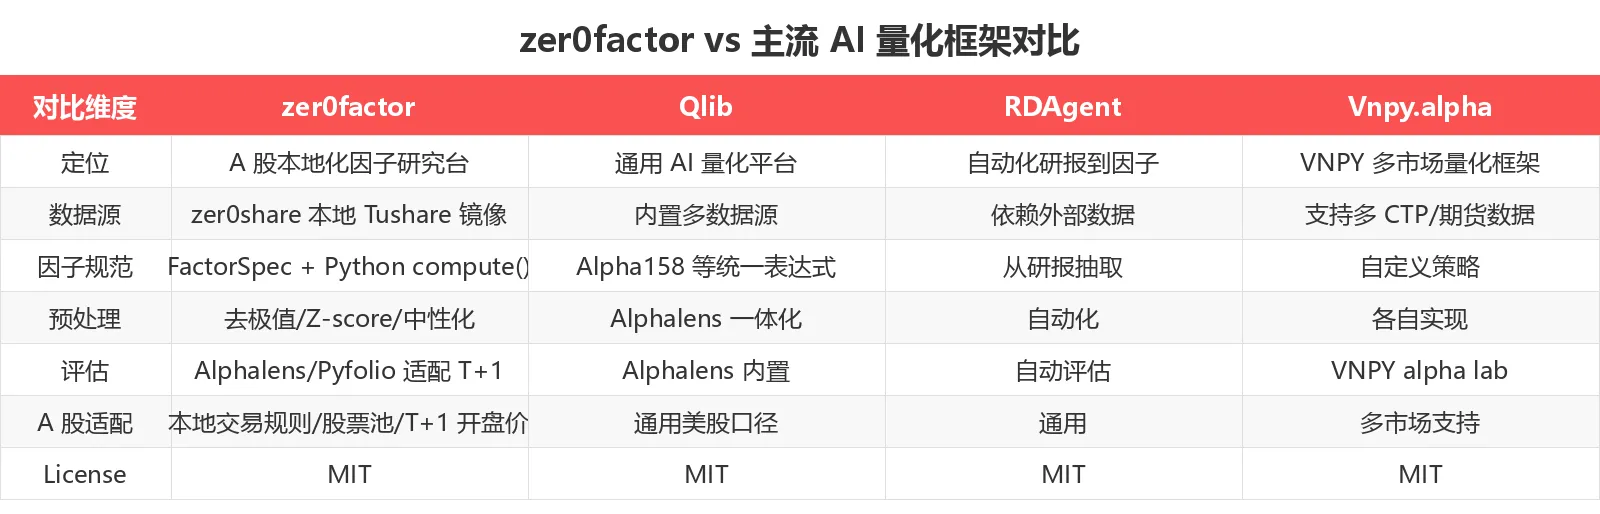
对比要点:
- A 股 T+1 口径:zer0factor 用 T+1 开盘价作 forward return 默认值,Qlib / RDAgent 仍是 close-to-close 美股口径。
- 数据本地化:依赖配套 zer0share(Tushare Pro → Parquet → DuckDB),无需持续调用云端 API。
- 研报自动化:
factor-researchSkill 把"读 PDF → 提因子 → 写代码"做成 Codex/Claude Code 可触发的子流程,这是 Qlib / VNPY 都没有的能力。 - 轻量级:纯 Python + uv 部署,无 C++ 绑定,零容器门槛。
💡 适用场景
场景 1:研报转因子工作流
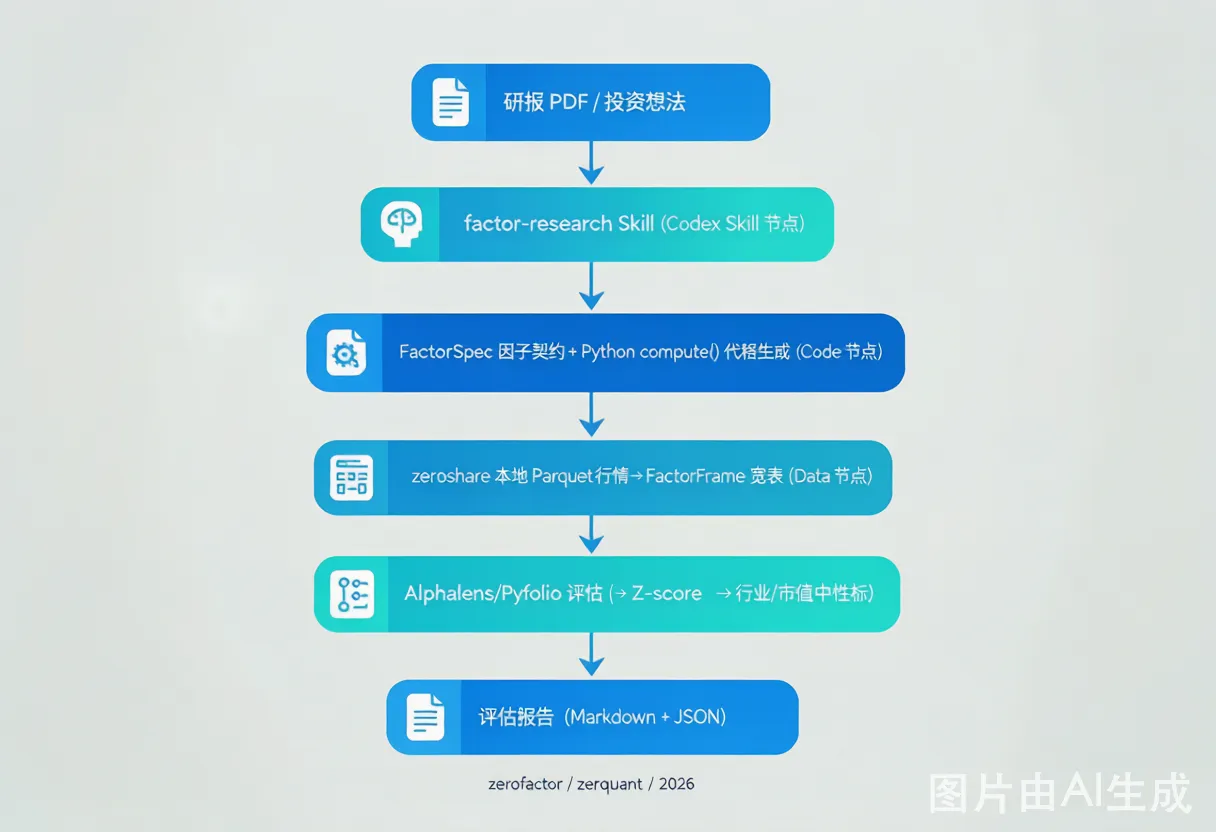
功能说明:从研报 PDF 灌入,AI 自动提取候选因子、生成可运行代码、批跑评估、产出可复现的工程产物。
输入要求:一份研报 PDF + 一段自然语言需求;zer0share 数据已同步至本地。
输出效果:workspaces/<run_id>/ 下生成 factors.json、code/、results/,附 Markdown 评估报告。
适用场景:卖方研报量化复现、买方策略池扩张、跨团队因子沉淀。
场景 2:分层模块化技术架构
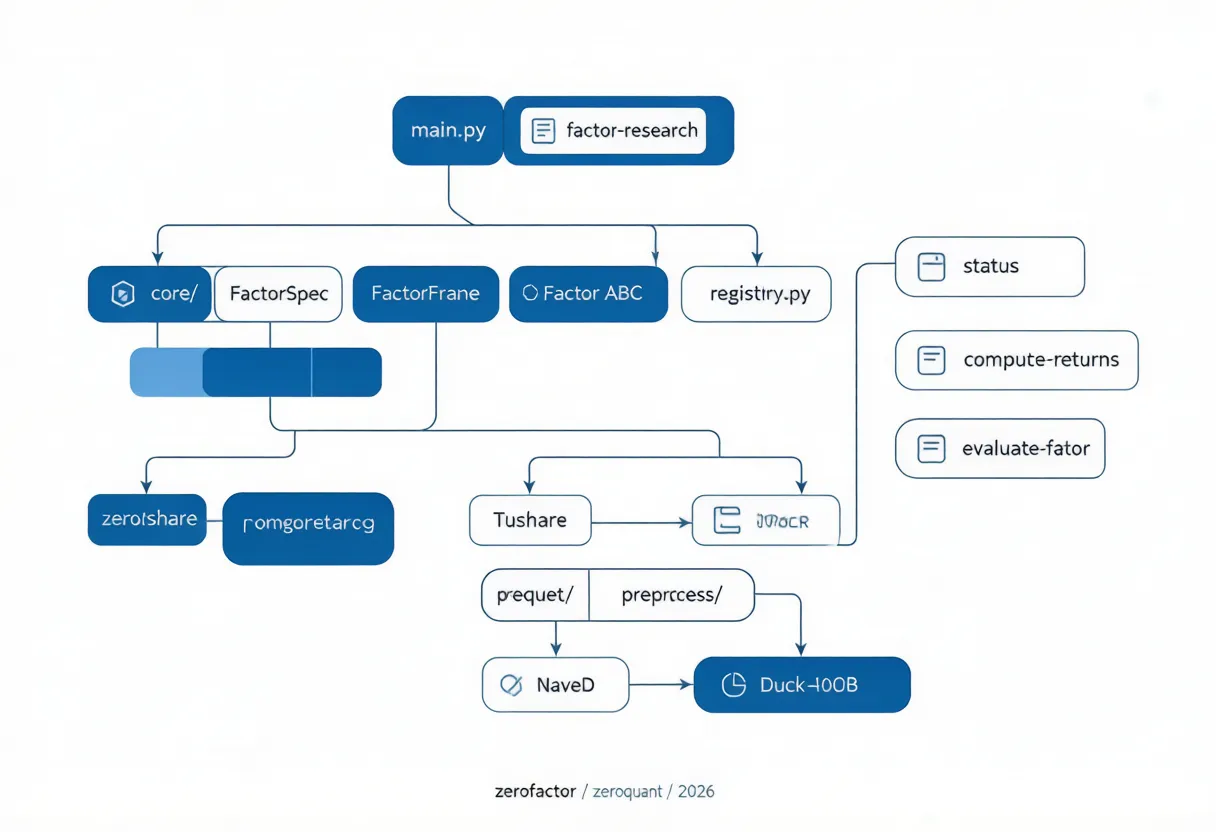
功能说明:把 CLI 入口、core/ 抽象、factors/ 内置因子、preprocess/ 预处理、eval/ 评估、storage/ 落盘拆成横切分层,zer0share 通过 provider 接口横向接入。
输入要求:理解 FactorSpec 契约后即可二次开发。
输出效果:新因子只需继承 Factor 写 compute(),注册到 factors.toml 即可批量评估。
适用场景:团队内部因子库共建、量化框架教学、跨项目复用因子模块。
场景 3:A 股因子计算数据流
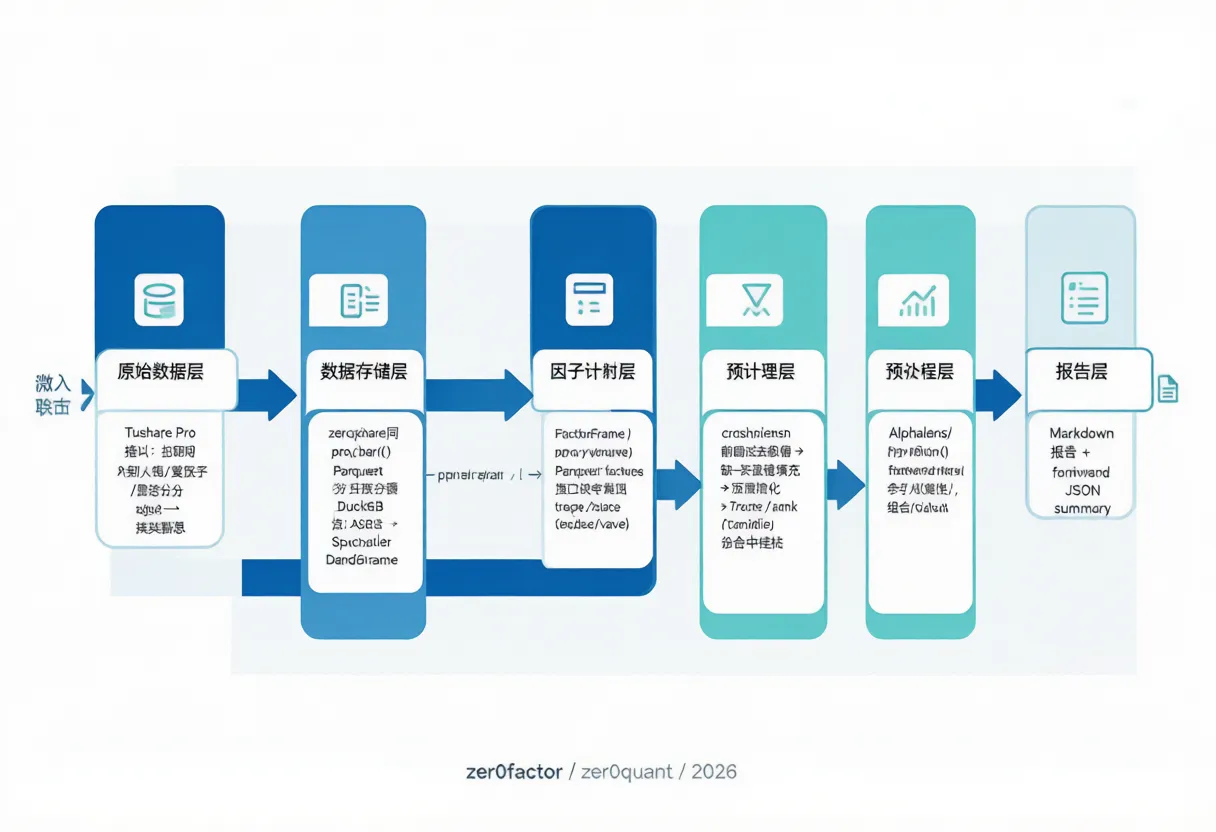
功能说明:从 Tushare Pro 拉取到评估报告输出全链路展示,每一步都标注数据格式(Parquet / DuckDB / DataFrame / IC Series)。
输入要求:Tushare Pro Token + 评估起止日期。
输出效果:本地因子库 + 评估报告,无云端依赖。
适用场景:合规要求本地化的机构、自托管量化爱好者、零 API 成本试跑。
场景 4:因子评估仪表盘
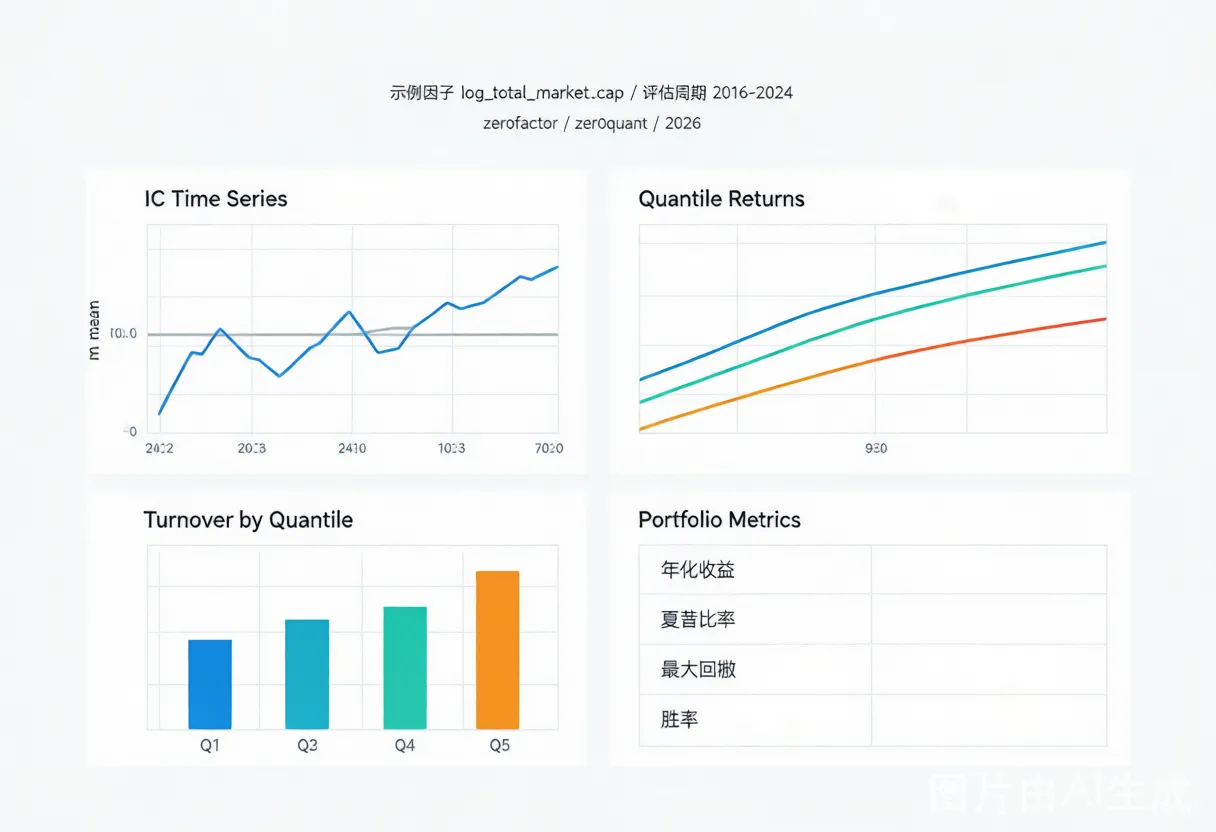
功能说明:以 log_total_market_cap 为示例,展示 IC 时序、分位数组合累计收益、换手率、组合绩效 4 宫格 dashboard。
输入要求:至少一个已完成 evaluate 的因子。
输出效果:data/evaluations/<run_id>/ 下的 PNG + summary.json。
适用场景:单因子诊断、批量评估报告、因子入库前的最后一道门禁。
场景 5:研报转因子 Skill 工作流
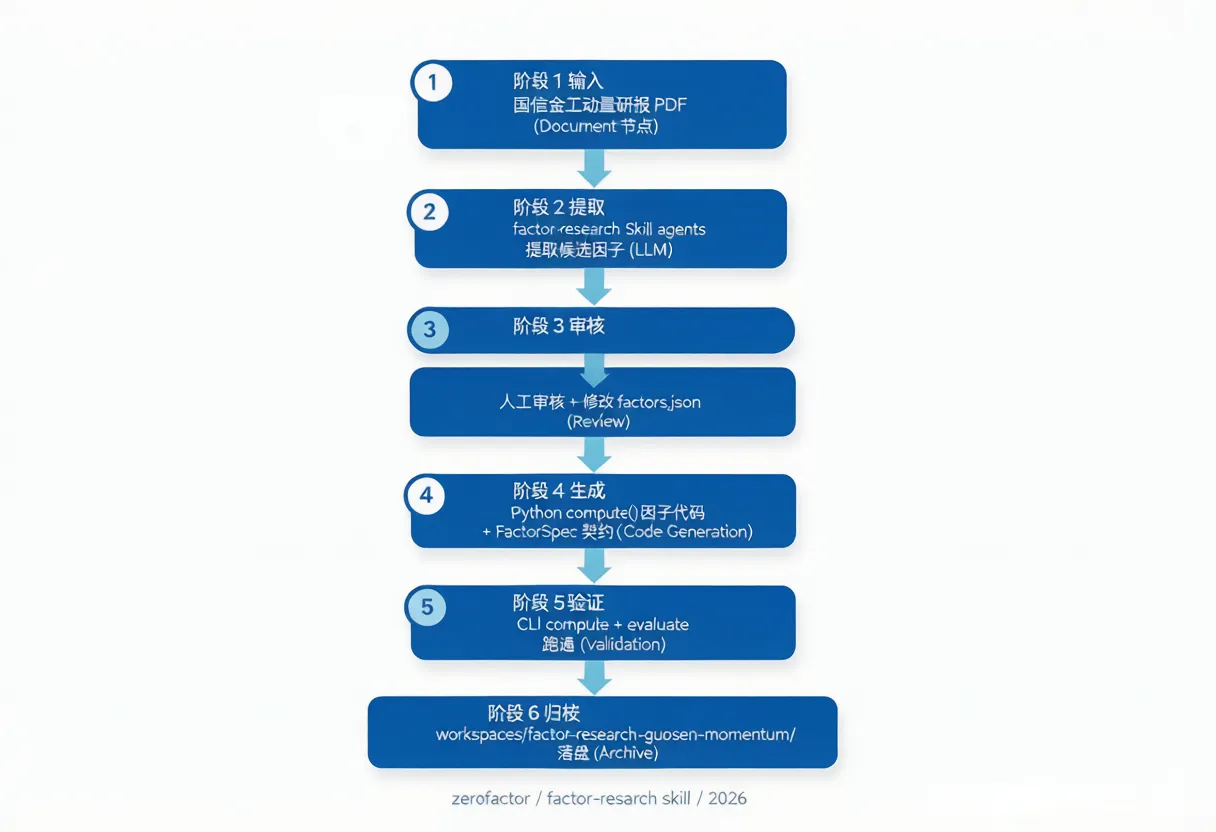
功能说明:6 阶段半自动工作流:研报输入 → agents 提取候选 → 人工审核 → Python compute() 生成 → CLI 验证 → 归档落盘。
输入要求:Codex / Claude Code 客户端 + docs/skills/factor-research/SKILL.md 已加载。
输出效果:workspaces/factor-research-guosen-momentum/ 完整复现国信金工动量因子。
适用场景:研报量化复现标准化、AI 辅助因子研究流程沉淀、团队 SOP 输出。
用户群体总结
- ✅ 个人量化研究员:本地化、可复现、零 API 成本
- ✅ AI 量化教学团队:研报→因子标准化 SOP、FactorSpec 契约简洁
- ✅ 小型买方/卖方研究组:与 Qlib / VNPY 互补,按需接入
- ✅ 数据合规要求本地化的机构:Parquet + DuckDB 全部本机部署
- ❌ 不适合:生产级实盘下单(仅研究台,无 broker connector)
💰 定价方案
- 完全免费 + MIT 协议,可商用、可二次开发、可本地部署
- 数据源 Tushare Pro 需自备 Token(基础行情积分≥2000)
- 推荐 LLM 配置:Codex GPT-5.x / Claude 4.5+ / DeepSeek-V3 / Ollama 本地开源模型均可
- 无任何云服务依赖,无云端 API 调用费
开源协议: MIT
💡 新用户福利:内置 log_total_market_cap 等 6 个标准因子 + 1 套国信金工动量研报转因子完整示例,零代码起步 5 分钟跑通评估流水线。
🎯 总结
zer0factor 把"AI 辅助因子研究"从口号变成工程交付:FactorSpec 契约、zer0share 数据底座、Alphalens 适配 T+1、factor-research Skill 全都配齐。它不试图替代 Qlib / VNPY 这种大而全平台,而是专注"研报转因子 + 本地可复现评估"这一段最脏的活。
推荐指数:⭐⭐⭐⭐⭐(满分 5 星,A 股本地化 AI 因子研究必备工作台)
适合人群:A 股量化研究员 / AI 量化教学团队 / 自托管量化爱好者 / 数据本地化合规机构
立即体验:
- GitHub 仓库:zer0quant/zer0factor
- 配套数据底座:zer0quant/zer0share
- 开发笔记:知乎《我用 Codex,把"投资研报到股票因子"的流程做成了一个 Skill》
数据截至 2026-07-27,最新信息请以 GitHub 为准。