🔥 TokenSpeed:光速级 LLM 推理引擎,性能对标 TensorRT-LLM
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../tokenspeed-recommend.pptx../../tokenspeed-recommend.mp4本文目录
🔥 TokenSpeed:光速级 LLM 推理引擎,性能对标 TensorRT-LLM
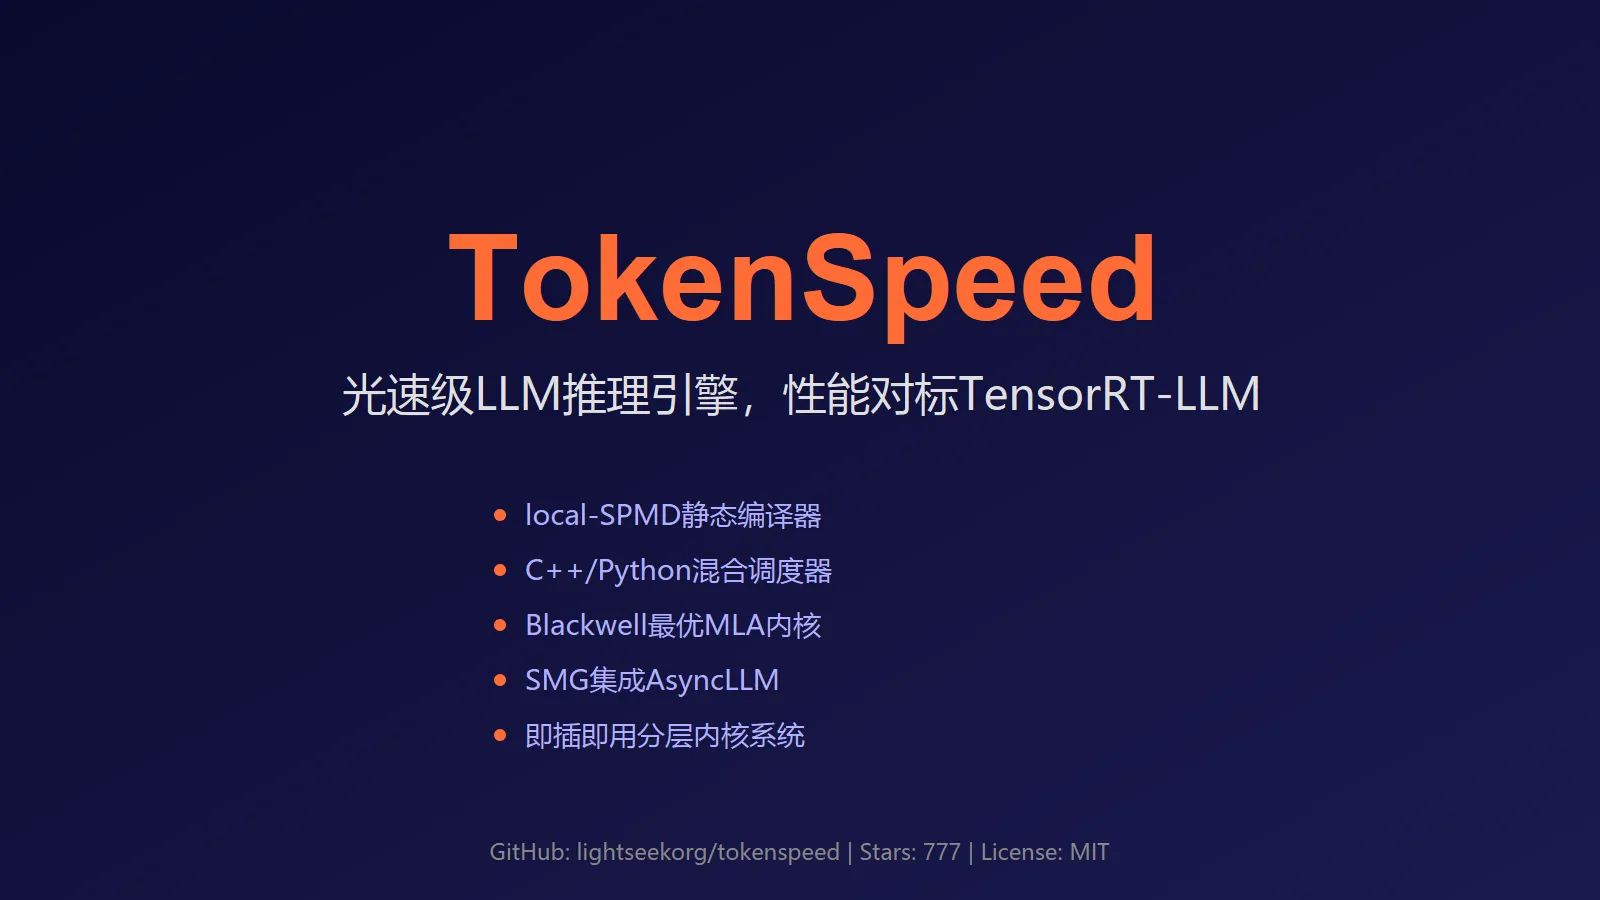
专为 AI Agent 工作负载设计的推理引擎,兼具 TensorRT-LLM 的极致性能与 vLLM 的易用性,Blackwell 架构上最快的 MLA 实现之一。
🚀 什么是 TokenSpeed?
TokenSpeed 是一个由 LightSeek 组织开发的光速级 LLM 推理引擎,于 2026 年 5 月初发布,短短几天已获得 777 Stars。它的核心定位非常明确:成为生产环境中 AI Agent 工作负载的最高性能推理引擎。
在当前的 LLM 推理领域,存在着一个明显的痛点:
- TensorRT-LLM 性能极强,但使用门槛高,配置复杂
- vLLM 易用性好,但在高并发 Agent 场景下性能不够极致
TokenSpeed 的出现正是为了解决这个问题——它用 local-SPMD 静态编译器 + C++/Python 混合调度器 + 可插拔内核系统,实现了性能与易用性的完美平衡。


核心定位:专为主动式 AI Agent 设计的高性能推理引擎,不是通用聊天工具的推理后端
✨ 核心功能一览
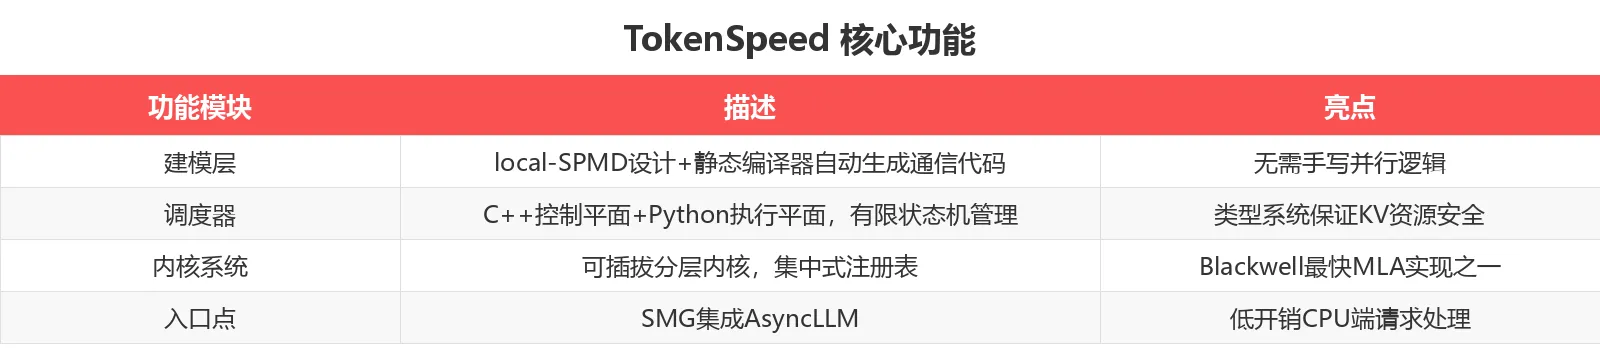
1. local-SPMD 建模层
传统推理引擎需要用户手动编写并行逻辑(张量并行、流水线并行等),而 TokenSpeed 的建模层采用 local-SPMD 设计,配备静态编译器,可以从模块边界的放置注释自动生成集合通信代码。
这意味着什么? 用户无需手写复杂的并行逻辑,编译器会自动处理。
2. C++/Python 混合调度器
调度器采用双平面架构:
- C++ 控制平面:处理请求生命周期、KV 缓存所有权管理
- Python 执行平面:灵活的执行业务逻辑
更关键的是,请求生命周期、KV 缓存所有权和重叠时序被编码为有限状态机,KV 资源的安全重用由编译时类型系统强制执行。这在系统层面避免了内存泄漏和资源竞争问题
3. 可插拔分层内核系统
TokenSpeed 提供了一套分层内核系统,具有:
- 可移植的公共 API:不同硬件平台统一接口
- 集中式注册表:内核实现即插即用
- Blackwell 最优 MLA:在 Blackwell 架构上提供最快的多头潜在注意力(MLA)实现之一
4. SMG 集成 AsyncLLM 入口点
入口点集成了 SMG 的 AsyncLLM,用于低开销的 CPU 端请求处理,特别适合高并发的 Agent 场景。
🛠️ 快速上手:5 分钟跑通示例
环境准备
TokenSpeed 需要 NVIDIA GPU 和 Docker 环境。推荐使用 Blackwell(B200)或 Hopper(H100)架构的 GPU 以获得最佳性能。
步骤 1:启动 Runner 容器
# 拉取官方 Runner 镜像
docker pull lightseekorg/tokenspeed-runner:latest

# 启动容器(需要足够的共享内存和 GPU 资源)
docker run -itd \
  --shm-size 32g \
  --gpus all \
  -v /raid/cache:/home/runner/.cache \
  --ipc=host \
  --network=host \
  --pid=host \
  --privileged \
  --name tokenspeed \
  lightseekorg/tokenspeed-runner:latest \
  /bin/bash
步骤 2:在容器内安装
# 进入容器
docker exec -it tokenspeed bash

# 克隆代码
git clone https://github.com/lightseekorg/tokenspeed.git
cd tokenspeed

# 安装 Python 运行时
export PIP_BREAK_SYSTEM_PACKAGES=1
pip install -e "./python" --no-build-isolation

# 安装 kernel 包(会自动安装 CUDA kernel 依赖)
pip install -e tokenspeed-kernel/python/ --no-build-isolation

# 安装 scheduler 包
pip install -e tokenspeed-scheduler/
步骤 3:启动服务器
快速测试(GPT-OSS-20B):
tokenspeed serve openai/gpt-oss-20b \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 1
生产环境(Kimi K2.5,4 卡并行):
tokenspeed serve nvidia/Kimi-K2.5-NVFP4 \
  --served-model-name kimi-k2.5 \
  --host 0.0.0.0 \
  --port 8000 \
  --trust-remote-code \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --quantization nvfp4 \
  --tensor-parallel-size 4 \
  --enable-expert-parallel \
  --chunked-prefill-size 8192 \
  --max-num-seqs 256 \
  --attention-backend trtllm_mla \
  --moe-backend flashinfer_trtllm \
  --reasoning-parser kimi_k2 \
  --tool-call-parser kimi_k2
注意:Blackwell 架构(B200)用户可获得最优性能,项目在 B200 上提供了目前最快的 MLA 实现之一
步骤 4:API 调用测试
TokenSpeed 提供 OpenAI 兼容的 API 接口:
from openai import OpenAI

# 连接到本地 TokenSpeed 服务
client = OpenAI(
    api_key="EMPTY",  # 本地部署无需真实密钥
    base_url="http://localhost:8000/v1"
)

# 调用聊天接口
response = client.chat.completions.create(
    model="kimi-k2.5",
    messages=[
        {"role": "user", "content": "请用 Python 写一个快速排序算法"}
    ],
    max_tokens=256,
)

print(response.choices[0].message.content)
📊 与竞品对比
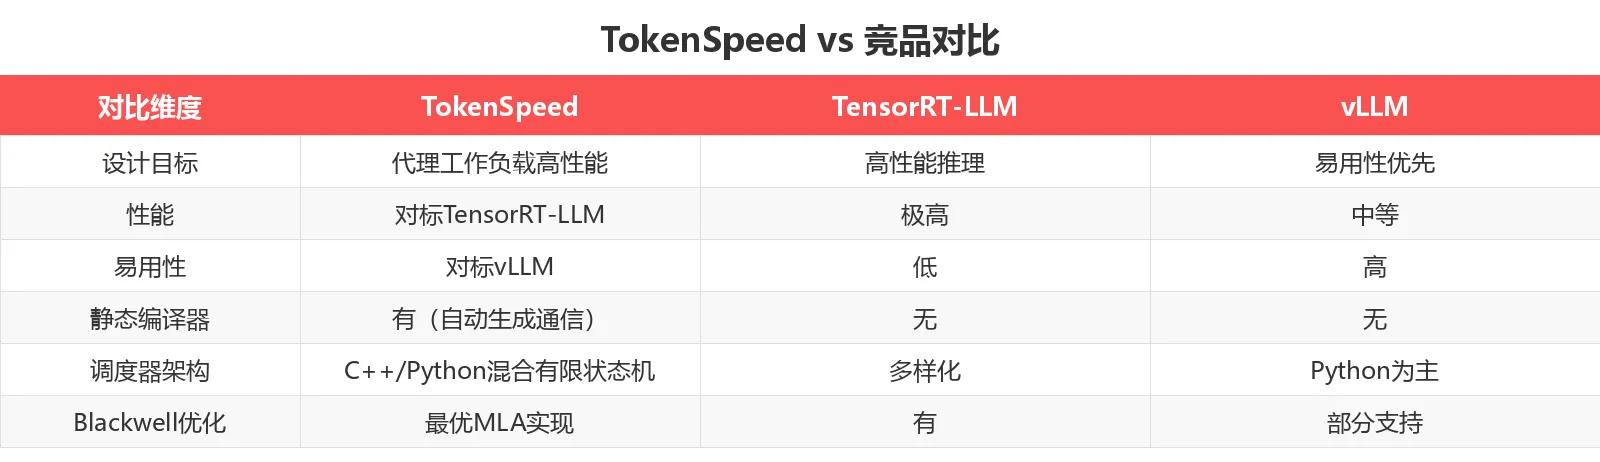
TokenSpeed vs TensorRT-LLM
| 对比维度 | TokenSpeed | TensorRT-LLM |
|---|---|---|
| 性能 | 对标 TensorRT-LLM | 极高 |
| 易用性 | 对标 vLLM | 低,配置复杂 |
| 静态编译器 | ✅ 自动生成通信代码 | ❌ 需手动配置 |
| 调度器 | C++/Python 混合状态机 | 多样化,但复杂 |
| Blackwell 优化 | ✅ 最优 MLA 实现 | ✅ 有 |
| 适用场景 | Agent 工作负载 | 通用高性能推理 |
TokenSpeed vs vLLM
| 对比维度 | TokenSpeed | vLLM |
|---|---|---|
| 性能 | 对标 TensorRT-LLM | 中等 |
| 易用性 | 对标 vLLM | 高 |
| Agent 优化 | ✅ 专为 Agent 设计 | ⚠️ 通用场景 |
| KV 缓存管理 | 编译时类型系统保证 | 运行时管理 |
| 内核系统 | 可插拔分层架构 | 相对固定 |
核心优势:TokenSpeed 在 Agent 工作负载上提供了目前最均衡的性能/易用性比
💡 适用场景
场景 1:高并发 AI Agent 系统
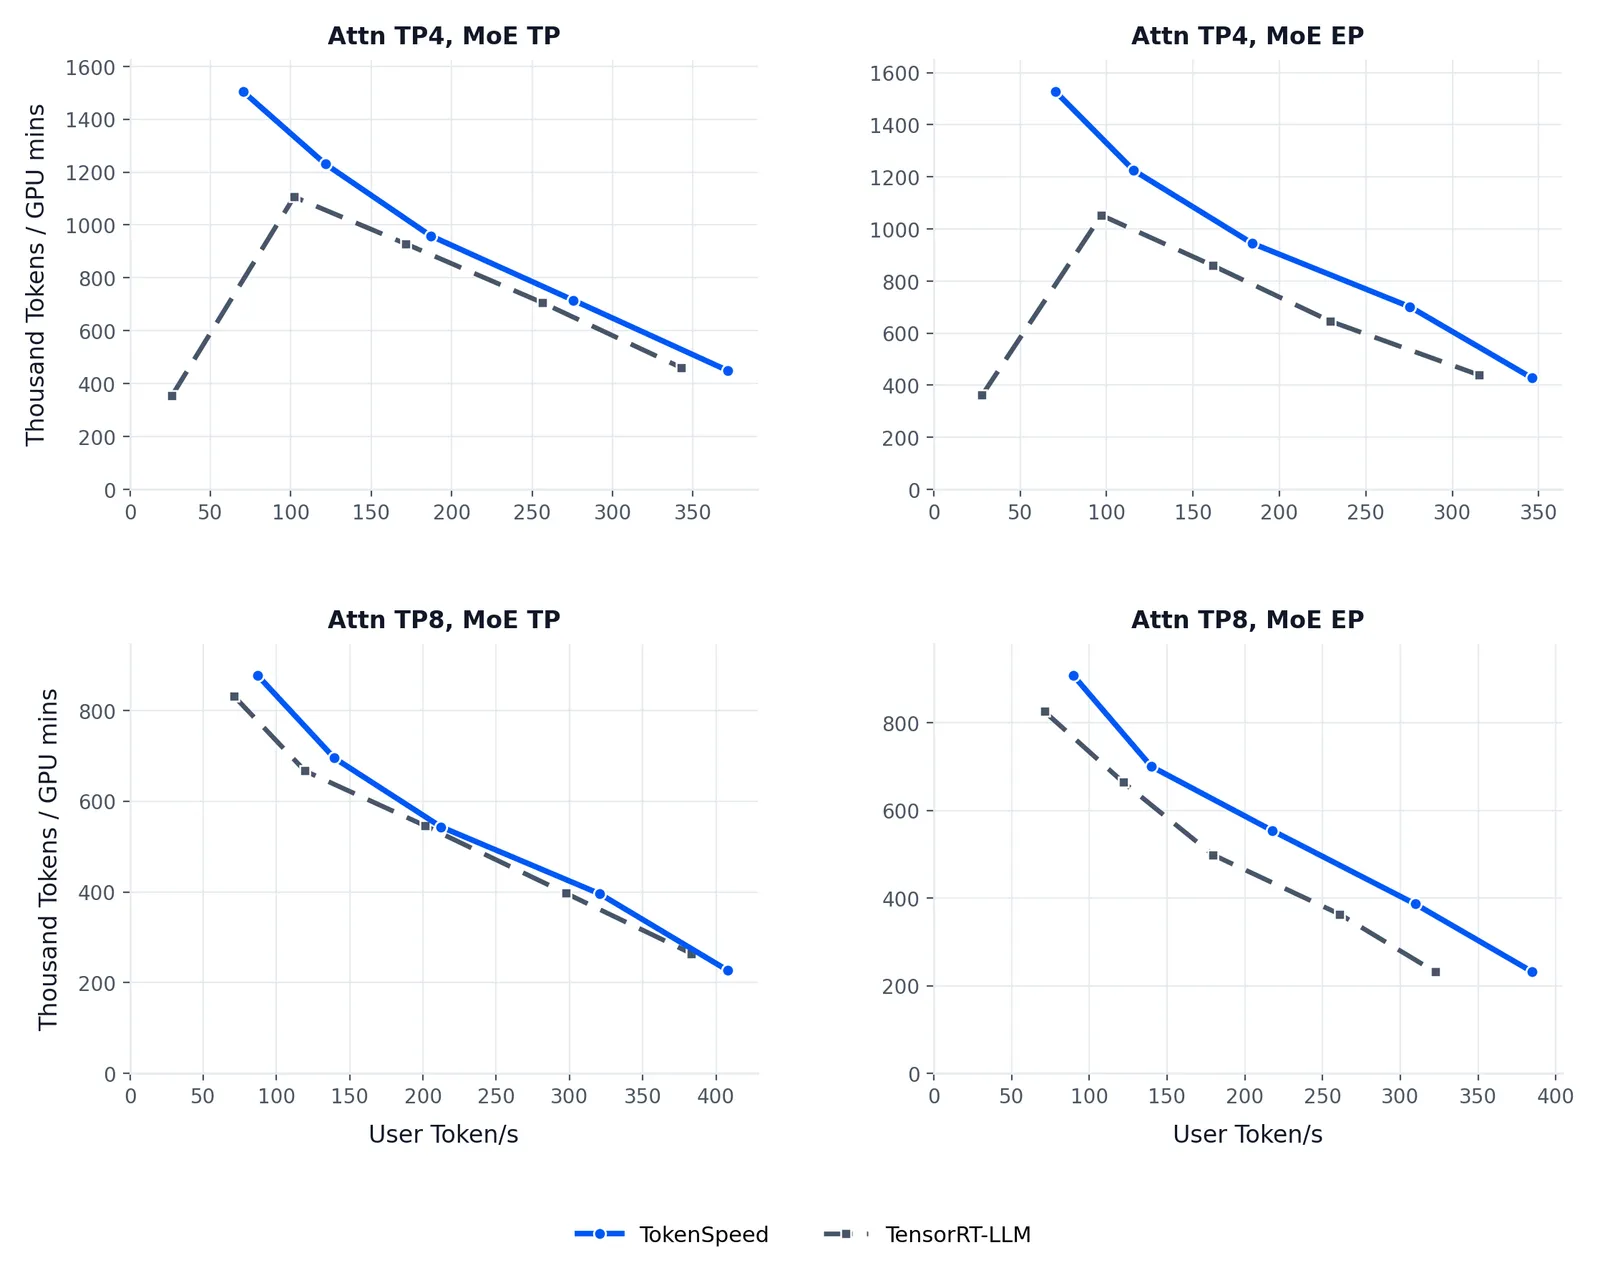
功能说明:TokenSpeed 在 Agent 工作负载(多轮对话、工具调用、推理链)上表现出色,性能曲线优于 TensorRT-LLM。
输入要求:配置好的 NVIDIA GPU(推荐 B200/H100)、Docker 环境、模型检查点
输出效果:高吞吐量的 Agent 推理服务,支持 256 个并发序列
适用场景:
- ✅ 多 Agent 协作系统(如 AutoGen、MetaGPT 后端)
- ✅ 需要大量工具调用的 Agent 应用
- ✅ 长上下文推理任务(支持 262K tokens)
场景 2:生产环境模型服务
功能说明:TokenSpeed 提供 OpenAI 兼容的 API,可以无缝替换现有基于 vLLM 或 TensorRT-LLM 的服务。
输入要求:HuggingFace 格式的模型检查点(支持 NVFP4 量化)
输出效果:稳定的 HTTP 服务,支持动态批处理、KV 缓存复用
适用场景:
- ✅ 企业级 LLM 服务部署
- ✅ 需要兼顾性能和易用性的生产环境
- ✅ 从 vLLM 迁移到更高性能的后端
场景 3:Blackwell 架构性能优化
功能说明:TokenSpeed 在 Blackwell(B200)架构上提供了最优的 MLA(多头潜在注意力)实现,充分利用新架构特性。
输入要求:B200 GPU、安装 CUDA 12.x 及以上
输出效果:相比 Hopper 架构,推理速度提升显著
适用场景:
- ✅ 已采购 Blackwell 硬件的企业/团队
- ✅ 需要极致推理性能的场景
- ✅ 运行 Kimi K2.5、DeepSeek V4 等最新大模型
用户群体总结
- ✅ AI Agent 开发者:需要高性能推理后端支持复杂 Agent 工作负载
- ✅ MLOps 工程师:在生产环境中部署 LLM 服务,兼顾性能和易用性
- ✅ 企业技术团队:已有 Blackwell/Hopper 硬件,需要最大化利用率
- ✅ 模型服务提供商:高并发场景下需要稳定、高性能的推理引擎
- ❌ 不适合:个人学习者(需要高端 GPU)、非 Agent 场景(vLLM 更简单)
💰 定价方案
TokenSpeed 采用 MIT 开源协议,完全免费使用,包括商业用途。
开源协议: MIT
当前状态:Preview Release(预览版),用于复现 Kimi K2.5 在 B200 上的结果。
正在开发的功能:
- 🔄 模型覆盖:Qwen 3.6、DeepSeek V4、MiniMax M2.7
- 🔄 运行时特性:PD(推测解码)、EPLB、KV store、Mamba cache、VLM
- 🔄 平台优化:Hopper 优化、MI350 优化
💡 免费使用:MIT 协议允许商业用途,无需支付任何授权费用
硬件成本:需要自购 NVIDIA GPU(推荐 B200/H100),无额外软件授权费。
🎯 总结
TokenSpeed 是一个定位非常明确的 LLM 推理引擎:它不追求通用场景,而是专注于 AI Agent 工作负载 这个细分领域,并在这个领域做到了性能与易用性的最佳平衡。
推荐指数: ⭐⭐⭐⭐(4/5 星,预览版功能还在完善中)
适合人群: Agent 开发者、MLOps 工程师、有 Blackwell/Hopper 硬件的企业团队
立即体验: TokenSpeed GitHub
官方文档: https://lightseek.org/tokenspeed/
博客介绍: LightSeek TokenSpeed 技术解析
数据截至 2026-05-09,最新信息请以官网为准。