PandasAI
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../pandas-ai-recommend.pptx../../pandas-ai-recommend.mp4本文目录
📌 核心价值:让 pandas DataFrame 直接听懂自然语言提问,自动输出答案、SQL 与可视化图表。
PandasAI 是围绕 DataFrame 实现的"自然语言到 Python/SQL"的对话式分析框架,覆盖 CSV、Parquet、PostgreSQL/MySQL/BigQuery/Snowflake/Databricks 等多数据源,提供 SkillKit、Docker Sandbox 与企业版隔离执行能力。
⚠️ 本文仅作技术交流,不构成投资建议。 股市有风险,投资需谨慎。涉及金融数据时,请以官方行情源与披露文件为准。
🚀 什么是 PandasAI?
PandasAI 是一款将生成式大模型嵌入 pandas 工作流的开源 Python 库,把传统 df.head() + 临时 SQL 的数据探索,转化为"用中文/英文直接提问 → 返回结构化答案、可视化图表、可执行 SQL"的多模态分析工具。
- GitHub:https://github.com/Sinaptik-AI/pandas-ai ⭐ 23,661 / 🍴 2,336(截至 2026-07-23)
- 协议:MIT(核心包),
pandasai/ee企业版另有协议 - 现状:在 v3 架构下提供
pai命名空间、LiteLLM适配层与 Docker 安全沙箱
核心定位:把"写临时脚本"换成"问一句就有结果",同时保留 pandas 的所有链式 API 与数据兼容。
✨ 核心能力一览
| 能力维度 | PandasAI 提供 | 实现细节 |
|---|---|---|
| 自然语言提问 | df.chat("按地区统计平均收入") |
LLM 生成 Python/SQL,回传给 pandas |
| 数据可视化 | df.chat("画直方图...") 自动保存为 PNG |
matplotlib/plotly 自适配 |
| 数据清洗 | pai.chat("补全缺失值") |
调用缺失值填充、特征生成函数 |
| 多数据源连接 | CSV / Parquet / Excel / PostgreSQL / MySQL / BigQuery / Snowflake / Databricks | SQLAlchemy + DB-API 适配 |
| 多 DataFrame 联表 | pai.chat("谁工资最高", df1, df2) |
自动生成关联 SQL/Python |
| LLM 适配层 | pandasai-litellm / pandasai-openai |
LiteLLM 兼容 OpenAI、Anthropic、Google、DeepSeek 等 100+ 模型 |
| Docker Sandbox | pandasai-docker 隔离执行 |
防止 LLM 生成的代码破坏宿主 |
| SkillKit / 自定义技能 | 注入业务函数作为原子能力 | 复用项目内部 RAG、特征计算等模块 |
🛠️ 快速上手:5 分钟跑通示例
安装
PandasAI 依赖 Python 3.8+ ≤ 3.11,与 LiteLLM 配套安装:
pip install pandasai
pip install pandasai-litellm
如果要开启隔离沙箱或多数据源,可按需安装:
pip install "pandasai-docker"
最简示例
import pandasai as pai
from pandasai_litellm.litellm import LiteLLM

llm = LiteLLM(model="gpt-4.1-mini", api_key="YOUR_OPENAI_API_KEY")
pai.config.set({"llm": llm})

df = pai.read_csv("data/companies.csv")
print(df.chat("What is the average revenue by region?"))
返回结构化答案,例如:
The total sales for the top 3 countries by sales is 16500.
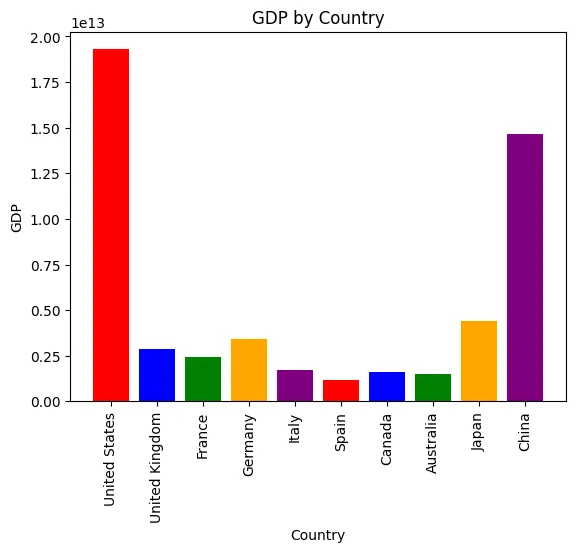
自动出图
df.chat(
    "Plot the histogram of countries showing for each one the gdp. "
    "Use different colors for each bar"
)
PandasAI 会自动调用 matplotlib 生成图像,并按需保存到本地磁盘。
多表联查
employees_df = pai.DataFrame(employees_data)
salaries_df = pai.DataFrame(salaries_data)

pai.chat("Who gets paid the most?", employees_df, salaries_df)
模型会自动基于 EmployeeID 字段做 join,并返回 Olivia gets paid the most.
注意:当 LLM 生成代码需要触达敏感系统调用或大文件 IO 时,必须启用 DockerSandbox,否则会以明文 Python 执行宿主进程。
from pandasai_docker import DockerSandbox

sandbox = DockerSandbox()
sandbox.start()
pai.chat("...", df, sandbox=sandbox)
sandbox.stop()
🔌 LLM 与数据源生态
LiteLLM 适配层
pandasai-litellm 是 v3 推荐路线,LiteLLM 内建 OpenAI、Anthropic Claude、Google Gemini、DeepSeek、Qwen、Moonshot、智谱等 100+ 模型,只要模型服务商提供 OpenAI 兼容 endpoint,就能一行接入。
数据源矩阵
| 类型 | 支持 | 安装包 |
|---|---|---|
| 本地文件 | CSV / Parquet / Excel / JSON | pandasai |
| 关系数据库 | PostgreSQL / MySQL / SQL Server / SQLite | pandasai[sql] |
| 云数仓 | BigQuery / Snowflake / Databricks / Redshift | pandasai[bigquery] 等 |
| 数据湖 | Delta Lake / Iceberg | 社区适配器 |
🏗️ 技术架构要点
- 意图解析 → 代码生成:LLM 根据表结构、字段类型、用户问题生成 Python 或 SQL。
- 沙箱执行:默认使用本地子进程;启用
DockerSandbox后切换为容器执行。 - 结果回填:将代码输出转换为结构化答案、可视化 PNG 或可下载文件。
- 多轮记忆:同一
Agent实例在会话内保留上下文,允许增量追问。 - 可扩展 SkillKit:业务方可以把内部 RAG / 因子计算函数注入为
Skill,让 LLM 直接调用。
核心定位:PandasAI 把 LLM 当成"代码生成器",把 pandas 当成"执行引擎",二者通过 SkillKit 解耦。
📊 与同类工具对比
| 维度 | PandasAI | LangChain DataFrame Agent | 大模型原生 Notebook | 传统 SQL 报表 |
|---|---|---|---|---|
| 入口 API | df.chat() 一行 |
自定义 Agent + Tools | 插件式 Notebook | 手写 SQL + Dashboard |
| 多数据源 | CSV/SQL/数仓 | 取决于 Tool 实现 | 取决于插件 | 仅 SQL |
| 代码沙箱 | Docker 内置 | 需自行封装 | 由 Notebook 提供 | 不需要 |
| Skill 扩展 | SkillKit 一等公民 | Tool 接口 | 插件式 | 无 |
| 学习曲线 | 低(pandas 用户友好) | 中(需熟悉 Agent) | 中(依赖插件) | 低 |
| 可视化 | 自动 PNG + 自定义 | 自行后处理 | 自行后处理 | 自行后处理 |
| 生产化能力 | 中(社区版) / 高(EE) | 中 | 低 | 高 |
💡 适用场景
场景 1:业务人员的"自助式"数据问答
功能说明:运营、销售、产品经理无需写 SQL,直接问"上个月华东区 GMV 同比",由 PandasAI 生成答案与图表。
输入要求:结构化 CSV / 已配置数据库连接 + 一个 LLM Key。
输出效果:自然语言答案 + 可保存的 PNG 图表 + 可追溯的 Python/SQL 代码。
适用场景:销售复盘、运营周报、产品 A/B 数据解释。
场景 2:量化研究中的"因子探索助手"
功能说明:把因子计算函数注册为 Skill,让 LLM 自动调用 factor('momentum', 20)、factor('volatility', 60) 等函数生成研究脚本。
输入要求:注册业务函数、注入字段元信息(量纲、行业归属、停牌状态等)。
输出效果:可被回测框架消费的 DataFrame + 解释性文字。
适用场景:量化研究员快速验证因子逻辑、生成因子文档。
场景 3:教学场景的"对话式 DataFrame"
功能说明:把 PandasAI 接到 Jupyter 教学环境里,让学生用自然语言探索数据集,再对照自动生成的代码学习 pandas API。
输入要求:JupyterHub / Colab + 受控数据集。
输出效果:实时答案 + 生成的 pandas 代码片段。
适用场景:高校数据科学课程、企业内训 pandas 速成。
用户群体总结
- ✅ 数据分析师:减少样板代码,专注业务问题。
- ✅ 业务团队:低门槛自助分析。
- ✅ 量化研究:把研究思路写成 Skill,让 LLM 调度。
- ✅ 教学场景:用对话降低学习门槛。
- ❌ 不适合:需要亚秒级延迟的高频交易场景、对审计追溯要求严格的金融报表。
💰 定价与开源协议
- 核心库:MIT 协议,PyPI 直接
pip install pandasai。 - 企业版(
pandasai/ee):闭源模块,包含高级 Skill、私有化部署、SLA 与审计。 - 托管云:pandas-ai.com 提供 SaaS 托管版。
💡 新用户福利:MIT 协议下本地使用零成本,企业版可申请试用。
🎯 总结
PandasAI 把"自然语言 → pandas 操作"这条链路做到了开箱即用:
- 接口友好:
df.chat()一行接入,pandas 用户零学习成本。 - 生态完整:LiteLLM 覆盖 100+ LLM;数据源覆盖 CSV 到云数仓。
- 生产化能力:Docker Sandbox + SkillKit 让 LLM 生成代码"可观测、可审计"。
- 企业路径清晰:MIT 试用 → 企业版升级,无锁定风险。
推荐指数: ⭐⭐⭐⭐⭐(满分 5 星)
适合人群: 数据分析师、业务团队、量化研究员、数据科学教师。
立即体验: https://pandas-ai.com
GitHub 仓库: https://github.com/Sinaptik-AI/pandas-ai
数据截至 2026-07-23,最新信息请以 GitHub 与官网为准。