🔥 OpenSquilla:Token高效AI Agent,相同预算智能密度提升89%
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../opensquilla-recommend.pptx../../opensquilla-recommend.mp4本文目录
🔥 OpenSquilla:Token高效AI Agent,相同预算智能密度提升89%
一个Token高效的微内核AI代理,在性能几乎持平的前提下,将成本降低89%,让每一分钱都花在刀刃上。
🚀 什么是 OpenSquilla?
OpenSquilla 是一个Token高效的微内核 AI 代理系统,通过智能路由、持久化内存、安全沙箱和本地嵌入技术,实现"相同预算,更高智能密度"。


核心理念:大多数AI Agent都在"暴力堆Token",而OpenSquilla选择"精准投放Token"——只花该花的钱,只做该做的推理。
核心定位:用1/10的成本,获得同级别的智能表现
技术架构亮点:
- 统一入口:Web UI、CLI和聊天频道都通过共享的
TurnRunner运行 - 多模型支持:通过可插拔提供者层,支持 OpenRouter、OpenAI、Anthropic、Ollama、DeepSeek、Gemini、Qwen 等约20个LLM提供者
- 本地路由:SquillaRouter 在本地设备完成分类,提示词不会外泄
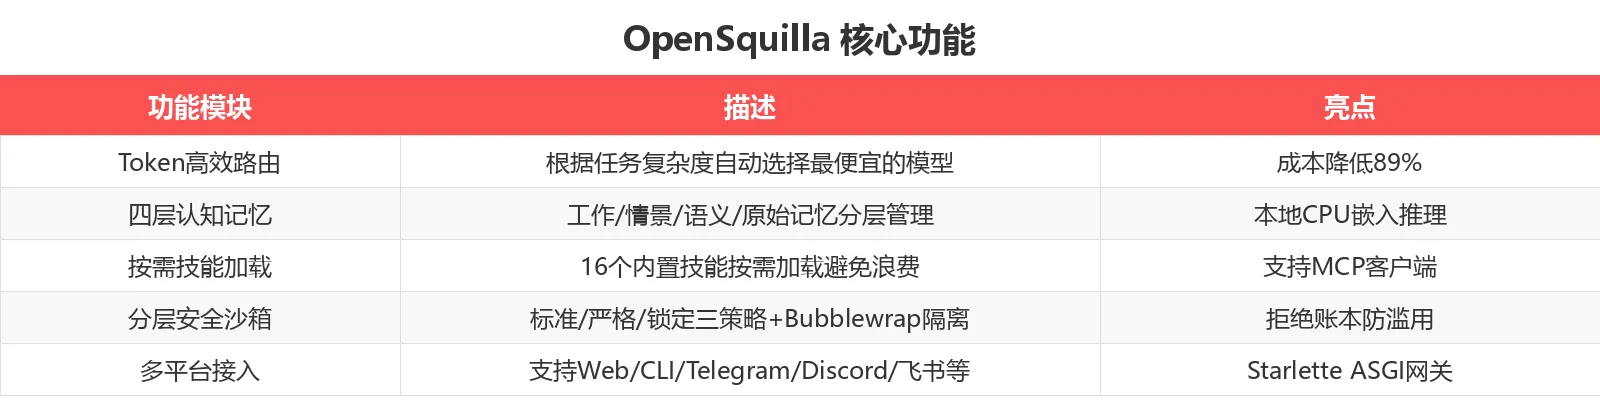
✨ 核心功能一览
🛠️ 快速上手:5分钟跑通示例
安装(开发者版本)
OpenSquilla 目前处于快速开发阶段,推荐从源码安装:
# 前提:安装 Git, Git LFS, uv (推荐)

# 1. 克隆仓库(包含 LFS 资产)
git clone https://github.com/OpenSquilla/opensquilla.git
cd opensquilla
git lfs pull

# 2. Linux/macOS 安装
bash install.sh

# 2. Windows 安装
powershell -ExecutionPolicy Bypass -File .\install.ps1

# 3. 配置 API Key(交互式向导)
opensquilla onboard

# 4. 启动网关
opensquilla gateway run

# 5. 访问 Web UI
# 打开 http://127.0.0.1:18790/control/
命令行快速体验
# 交互式对话
opensquilla chat

# 一次性任务执行
opensquilla agent -m "分析当前仓库的最新提交记录"

# 查看频道状态
opensquilla channels status feishu --json
注意:推荐使用 OpenRouter 作为模型提供者,可以灵活切换多种模型并控制成本
📊 与竞品对比
根据 PinchBench 1.2.1 基准测试(25个任务平均值),OpenSquilla 在性能几乎持平的情况下,成本大幅降低:
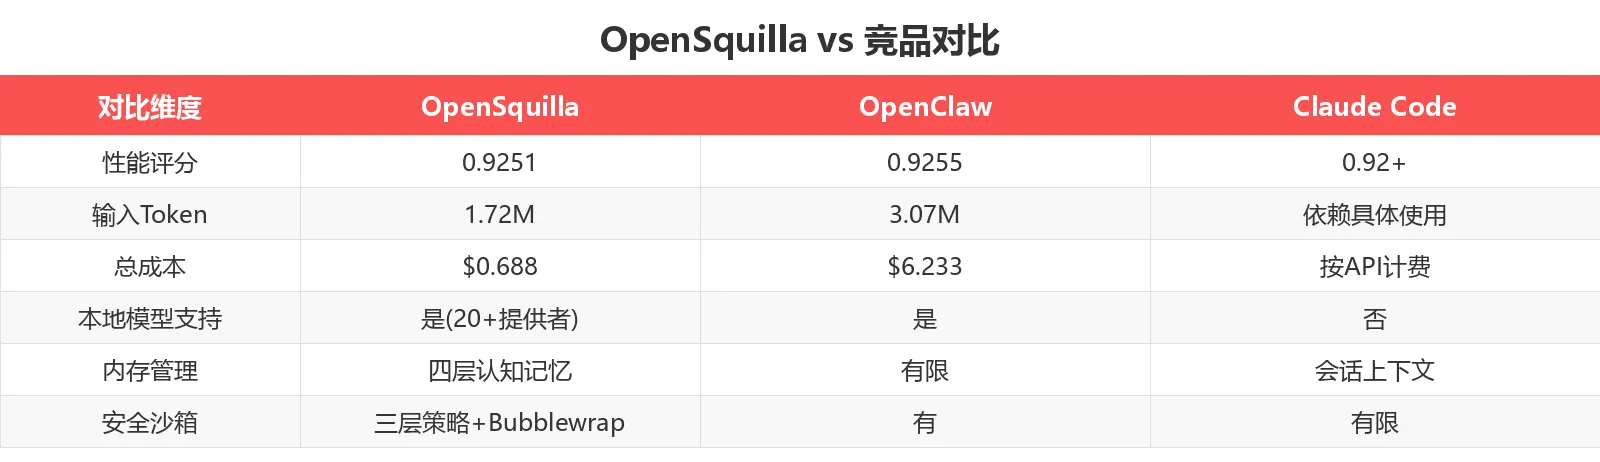
关键数据:输入Token减少44%,总成本降低89%($0.688 vs $6.233)
💡 适用场景
场景1:成本敏感的AI Agent部署
功能说明:企业或个人开发者需要在有限预算下部署AI Agent服务,OpenSquilla的Token高效路由可以大幅降低API成本。
输入要求:配置好API Key(支持OpenRouter、OpenAI、DeepSeek等多种提供者)
输出效果:相同的任务完成质量,但API成本降低80%-90%
适用场景:
- 个人开发者构建AI助手,控制月度API支出
- 中小企业部署客服Agent,降低运营成本
- 教育机构教学AI Agent原理,学生可低成本实践
场景2:多模型智能路由
功能说明:SquillaRouter 根据任务复杂度自动选择最合适的模型,简单任务用轻量模型,复杂任务才用重量级模型。
输入要求:配置多个模型提供者,系统会自动评估任务复杂度
输出效果:
- T0级别(简单):使用最快最便宜的模型(如GLM5.1、DS4 Flash)
- T1-T3级别(复杂):按需使用Opus4.7等高端模型
适用场景:
- 需要同时处理简单查询和复杂推理的混合场景
- 希望根据实际需求动态选择模型,避免"大材小用"
- 对响应速度有要求,简单问题快速返回
场景3:本地化部署与隐私保护
功能说明:四层认知记忆(工作/情景/语义/原始)运行在本地,嵌入推理使用本地CPU运行的ONNX模型,数据不出本地。
输入要求:安装时同步依赖,启用本地嵌入功能
输出效果:聊天记录、学习到的知识、任务经验都保存在本地SQLite数据库,支持Fts关键词搜索和语义召回
适用场景:
- 对数据隐私有严格要求的企业内部部署
- 需要长期记忆能力,但又不希望敏感数据上传云端
- 需要在离线或内网环境运行的AI Agent
场景4:多渠道统一接入
功能说明:基于Starlette的ASGI服务器,统一支持Web UI、CLI、Telegram、Discord、Slack、飞书、钉钉、企业微信、MS Teams、Matrix、QQ等多种渠道。
输入要求:配置对应渠道的Token或Webhook
输出效果:同一个Agent后端,可以同时服务多个前端渠道,消息统一处理
适用场景:
- 企业需要同时支持多个即时通讯工具的AI助手
- 开发者希望构建自己的AI助手平台,支持多渠道接入
- 团队协作场景,不同成员使用不同通讯工具
用户群体总结
- ✅ 个人开发者:成本降低89%,让个人项目也能用上顶级AI模型
- ✅ 中小企业:在有限预算下部署生产级AI Agent服务
- ✅ 隐私敏感用户:本地记忆+本地嵌入,数据不出本地
- ✅ 多平台运营者:一套后端支持所有主流通讯渠道
- ❌ 不适合:需要开箱即用、不想折腾配置的用户(项目还在早期,需要一定技术门槛)
💰 定价方案
开源协议: Apache-2.0
OpenSquilla 本身是开源免费的,成本主要来自底层LLM API调用:
| 使用场景 | 推荐配置 | 预估成本(对比OpenClaw) |
|---|---|---|
| 个人实验 | GLM5.1 + DS4 Flash | $0.5-2/月(降低89%) |
| 中小规模 | 混合路由(T0-T2) | $5-20/月(降低80%) |
| 企业级 | 全模型路由(T0-T3) | $20-100/月(降低70%) |
💡 核心优势:相同预算下,智能密度提升89%,相当于免费获得一个量级的性能提升
🎯 总结
OpenSquilla 不是另一个"套壳"AI Agent,而是一个从底层重新思考Token效率的开源项目。在PinchBench基准测试中,它以仅$0.688的成本达到了0.9251的评分,而对比组OpenClaw花费$6.233才达到0.9255。
选择OpenSquilla的三个理由:
- 真省钱:Token高效路由让成本降低89%,不牺牲性能
- 真开源:Apache-2.0协议,可商用,可修改
- 真灵活:支持20+模型提供者,本地/云端随意切换
推荐指数: ⭐⭐⭐⭐⭐(满分5星)
适合人群: 对成本敏感的个人开发者、中小企业、隐私保护需求者、多平台运营者
立即体验: OpenSquilla 官网
GitHub 仓库: OpenSquilla/opensquilla
数据截至 2026-05-11,最新信息请以官网为准。