视频AI能边看边答了!复旦开源MOSS-VL实测
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../moss-vl-recommend.pptx../../moss-vl-recommend.mp4本文目录
视频AI能边看边答了!复旦开源MOSS-VL实测
过去让大模型看视频,套路永远是「先看完、再回答」。复旦大学 OpenMOSS 团队开源的 MOSS-VL 打破了这个前提:模型一边接收视频流、一边就能开口,你随时打断提问它随时接上,没重要的事情它会主动闭嘴。
🚀 什么是 MOSS-VL?
MOSS-VL 是复旦大学 OpenMOSS 团队开源的一套视频理解模型家族,三个模型全部是 11B 参数、开放权重。它和市面上一大堆「视频大模型」最根本的区别,在于处理范式:
传统视频模型是离线批处理——你先把整段视频喂进去,等它处理完,再拿答案。这中间可能有几十秒甚至几分钟的空白。MOSS-VL-Realtime 走的是另一条路:在持续到来的视频流上并行做多模态感知和文本生成,帧还在源源不断进来,答案已经流式吐出来了。
核心定位:把视频理解从「看完再答」变成「边看边答」,而且支持随时打断、主动沉默、动态纠正。
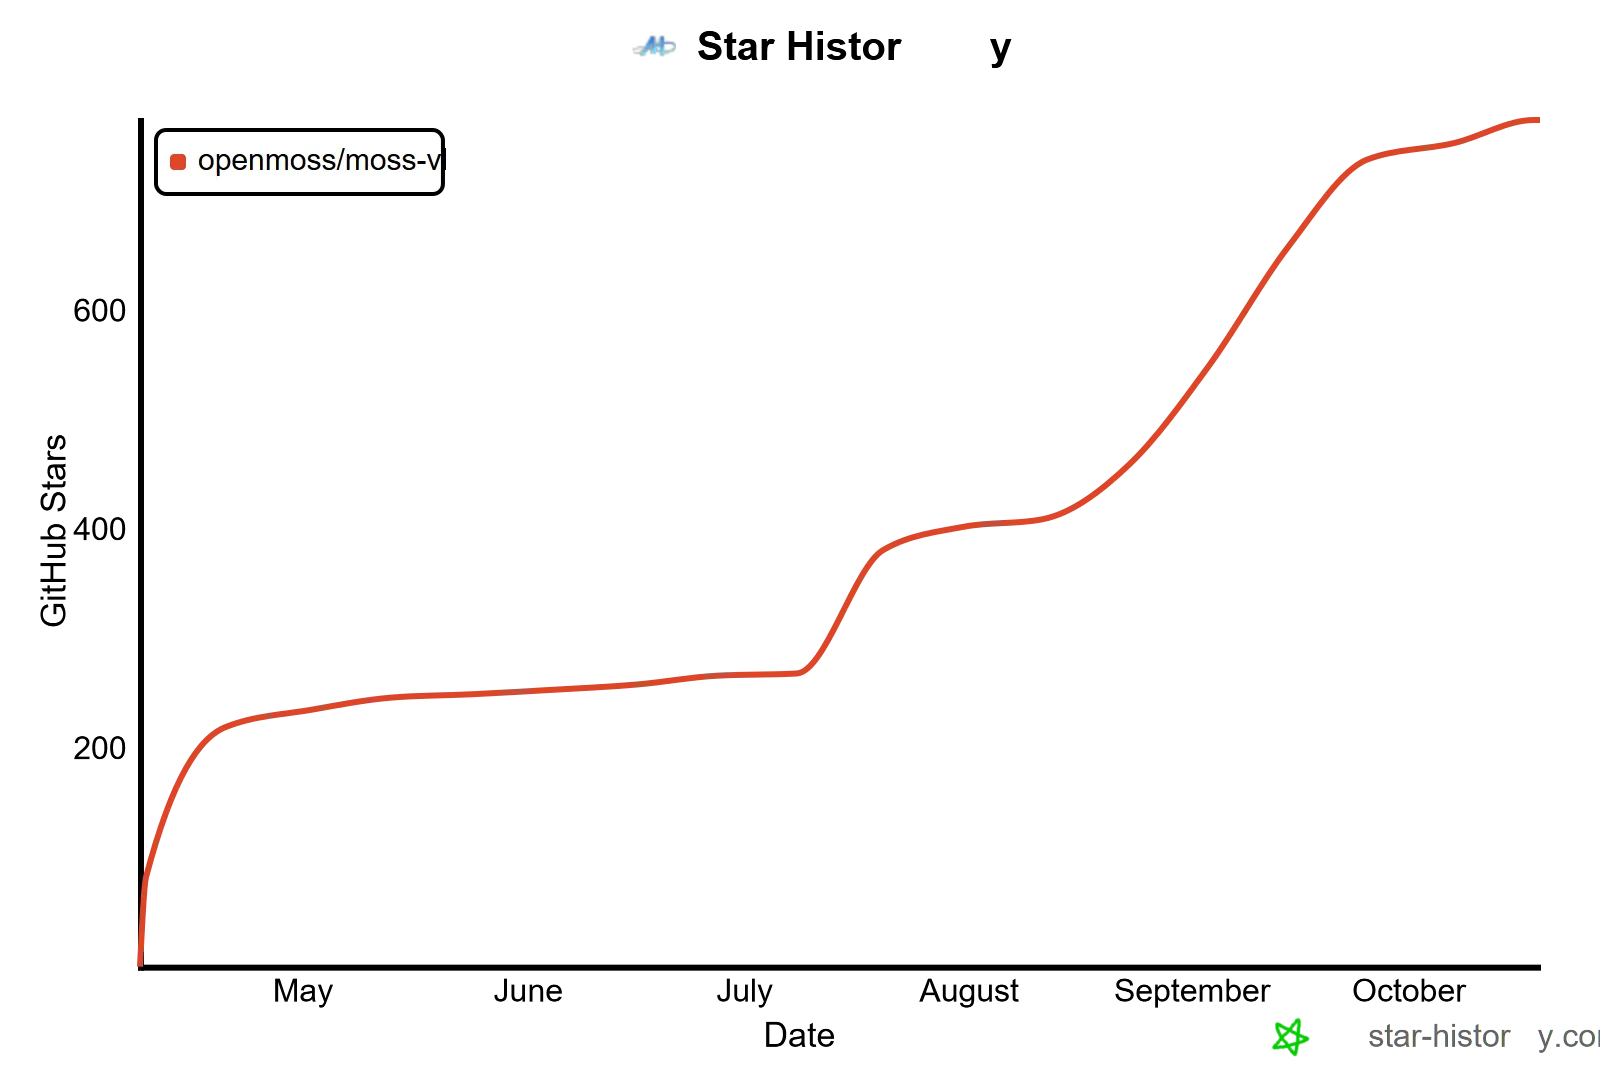
它不是实验室里的 PPT 概念。截至 2026 年 10 月,仓库已有 774 颗星,并且在 OmniMMI 的 Proactive Alerting、StreamingBench 的 Proactive Output、ProactiveVideoQA 三项主动性评测上都拿到了开源领先成绩——所谓「主动性」,指的是模型自己判断什么时候该说话、什么时候该闭嘴的能力。
✨ 核心功能一览
MOSS-VL 不是单个模型,而是三个分工明确的 11B 模型,同一个交叉注意力架构、同一套重构数据训练出来:
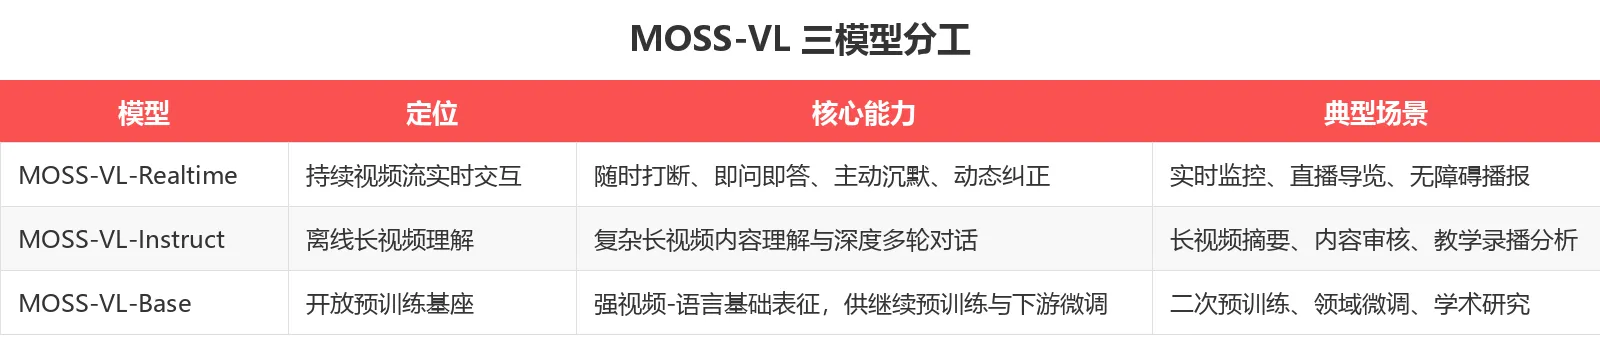
三个模型覆盖了从「实时交互」到「离线深挖」再到「二次开发」的完整链路。普通用户用 Realtime 或 Instruct,想自己训模型的团队用 Base。
🧠 三大核心能力,解决三个真问题
能力一:随时应答
用户可以在视频流的任意时间戳提问,模型基于当前已经接收到的画面立刻回应,不需要等视频结束。流式交互延迟做到了开源 SOTA 水平。这意味着直播、监控、实时导览这类场景第一次真正可用。
能力二:主动沉默
这一条最容易被忽略,但实际很重要。上下文信息不足、或者当前画面里没有关键事件发生时,模型能自己判断并保持沉默,继续观察,而不是硬凑一个答案出来。传统模型被逼问就一定会答,答错也不知道。MOSS-VL-Realtime 把「不回答」也当成一种合法输出。
能力三:动态纠正
随着新画面帧持续流入,模型能立刻捕捉到状态变化并修正此前已经说出口的结论。比如画面里一个人先把杯子放到桌上,后来又把杯子挪到了窗台,模型会主动更新认知,而不是抱着第一眼的判断不放手。
🏗️ 架构上做对了什么
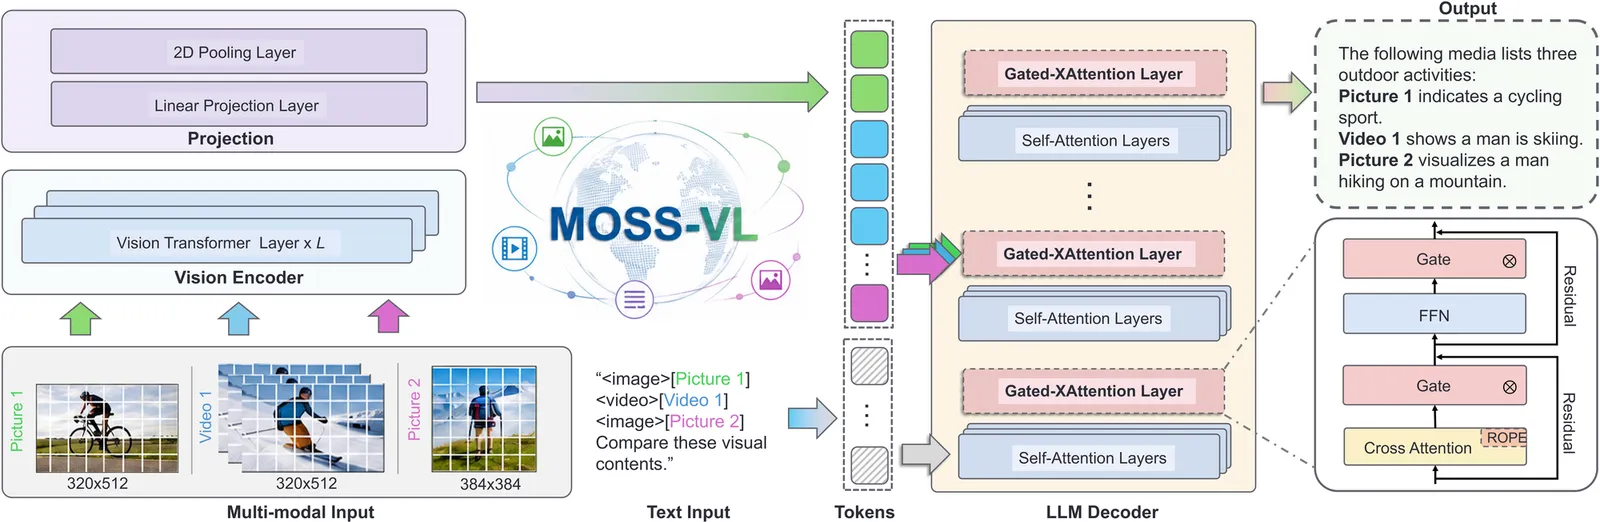
上图是官方仓库里的架构图。三个关键设计决定了上面的能力:
交叉注意力架构:把视觉编码和语言推理解耦,这是降低动态视频流响应延迟的核心。同时它原生支持图像、视频、文本的交错输入——也就是图片、视频片段、文字可以在同一次对话里混着来。
绝对时间戳:每一个采样帧都通过专门的特殊 token 锚定到精确的时间标记上。模型因此能推理节奏、时长和运动动态,并且原生适配可变帧率——视频是 1 fps 还是 30 fps,不用改代码。
XRoPE(交叉注意力旋转位置编码):把文本 token 和视频 patch 映射到统一的 (t, h, w) 三维坐标空间,实现整个视频范围内的 patch 级、瞬间级定位。你问「第 37 秒那个人做了什么」,它真的能定位到那一瞬。
注意:MOSS-VL 对时间戳是「理解」而非「猜测」,这是它敢做实时交互的底层原因。
🛠️ 快速上手:三步跑起来
第一步:环境配置
conda create -n moss_vl python=3.12 pip -y
conda activate moss_vl
pip install -i https://pypi.org/simple --no-build-isolation -r requirements.txt
第二步:离线推理(最简单,先验证能跑通)
如果你只是想处理一个视频文件,用 offline_batch_generate 最快:
import torch
from transformers import AutoModelForCausalLM, AutoProcessor

checkpoint = "OpenMOSS-Team/MOSS-VL-Realtime"

processor = AutoProcessor.from_pretrained(checkpoint, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    checkpoint, trust_remote_code=True, device_map="auto", torch_dtype=torch.bfloat16
)

queries = [{
    "messages": [{"role": "user", "content": [
        {"type": "image", "image": "path/to/example.jpg"},
        {"type": "text", "text": "描述这张图片。"}
    ]}],
    "generate_kwargs": {"max_new_tokens": 256, "do_sample": False},
}]

with torch.no_grad():
    result = model.offline_batch_generate(processor, queries)

print([item["text"] for item in result["results"]])
第三步:实时推理(MOSS-VL 的真正主场)
实时推理会增量接收带时间戳的视频帧,所以模型能在持续感知的同时作答、随时接收新问题。本地调试最快的做法是让它回放一个本地视频文件:
CUDA_VISIBLE_DEVICES=0 python inference/realtime/run_online_inference.py \
  --checkpoint OpenMOSS-Team/MOSS-VL-Realtime \
  --source video \
  --video path/to/example.mp4 \
  --sample-fps 1 \
  --playback-speed 1 \
  --max-frames 256
重要提醒:调试实时推理时务必保持 --playback-speed 1,让视频帧按原始时间轴到达。改了这个参数,时序推理的结果就不准了。
运行时提供三种集成层级,从轻到重:
model.create_realtime_session(...):直接控制视频帧、动态问题和增量输出model.online_generate(...):用于基于队列的推理工作线程--serve:启动 FastAPI WebSocket 服务,接收外部 JPEG/PNG 帧,或者回放服务端本地视频
除了视频文件,还支持流式 JSONL 样例、摄像头、屏幕采集和合成视频源。也就是说接一个摄像头就能直接做实时视觉对话。
📊 与竞品对比
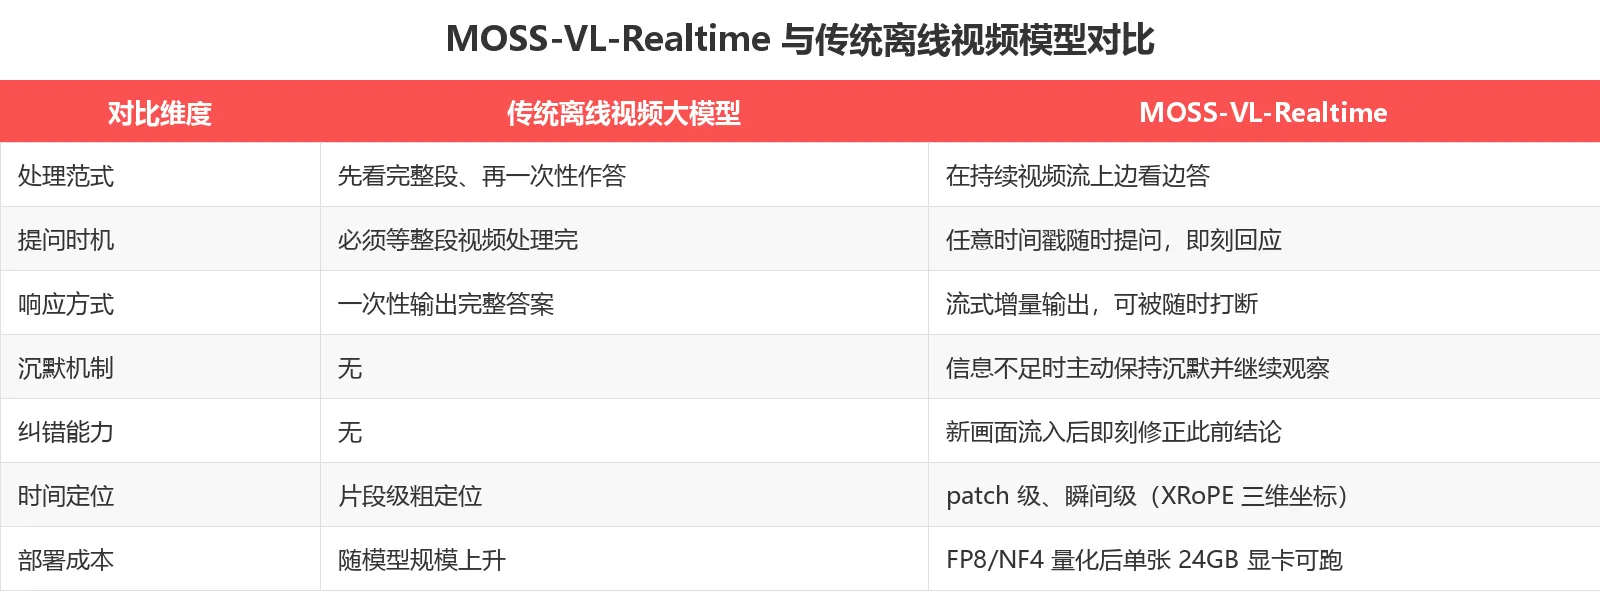
需要说明的是,这张对比表针对的是处理范式,不是参数规模或绝对精度。MOSS-VL 的价值不在于它在每一个离线榜单上都是第一,而在于它把「实时交互」这件事从概念做成了能跑的开源权重。
📈 实测表现
流式交互评测
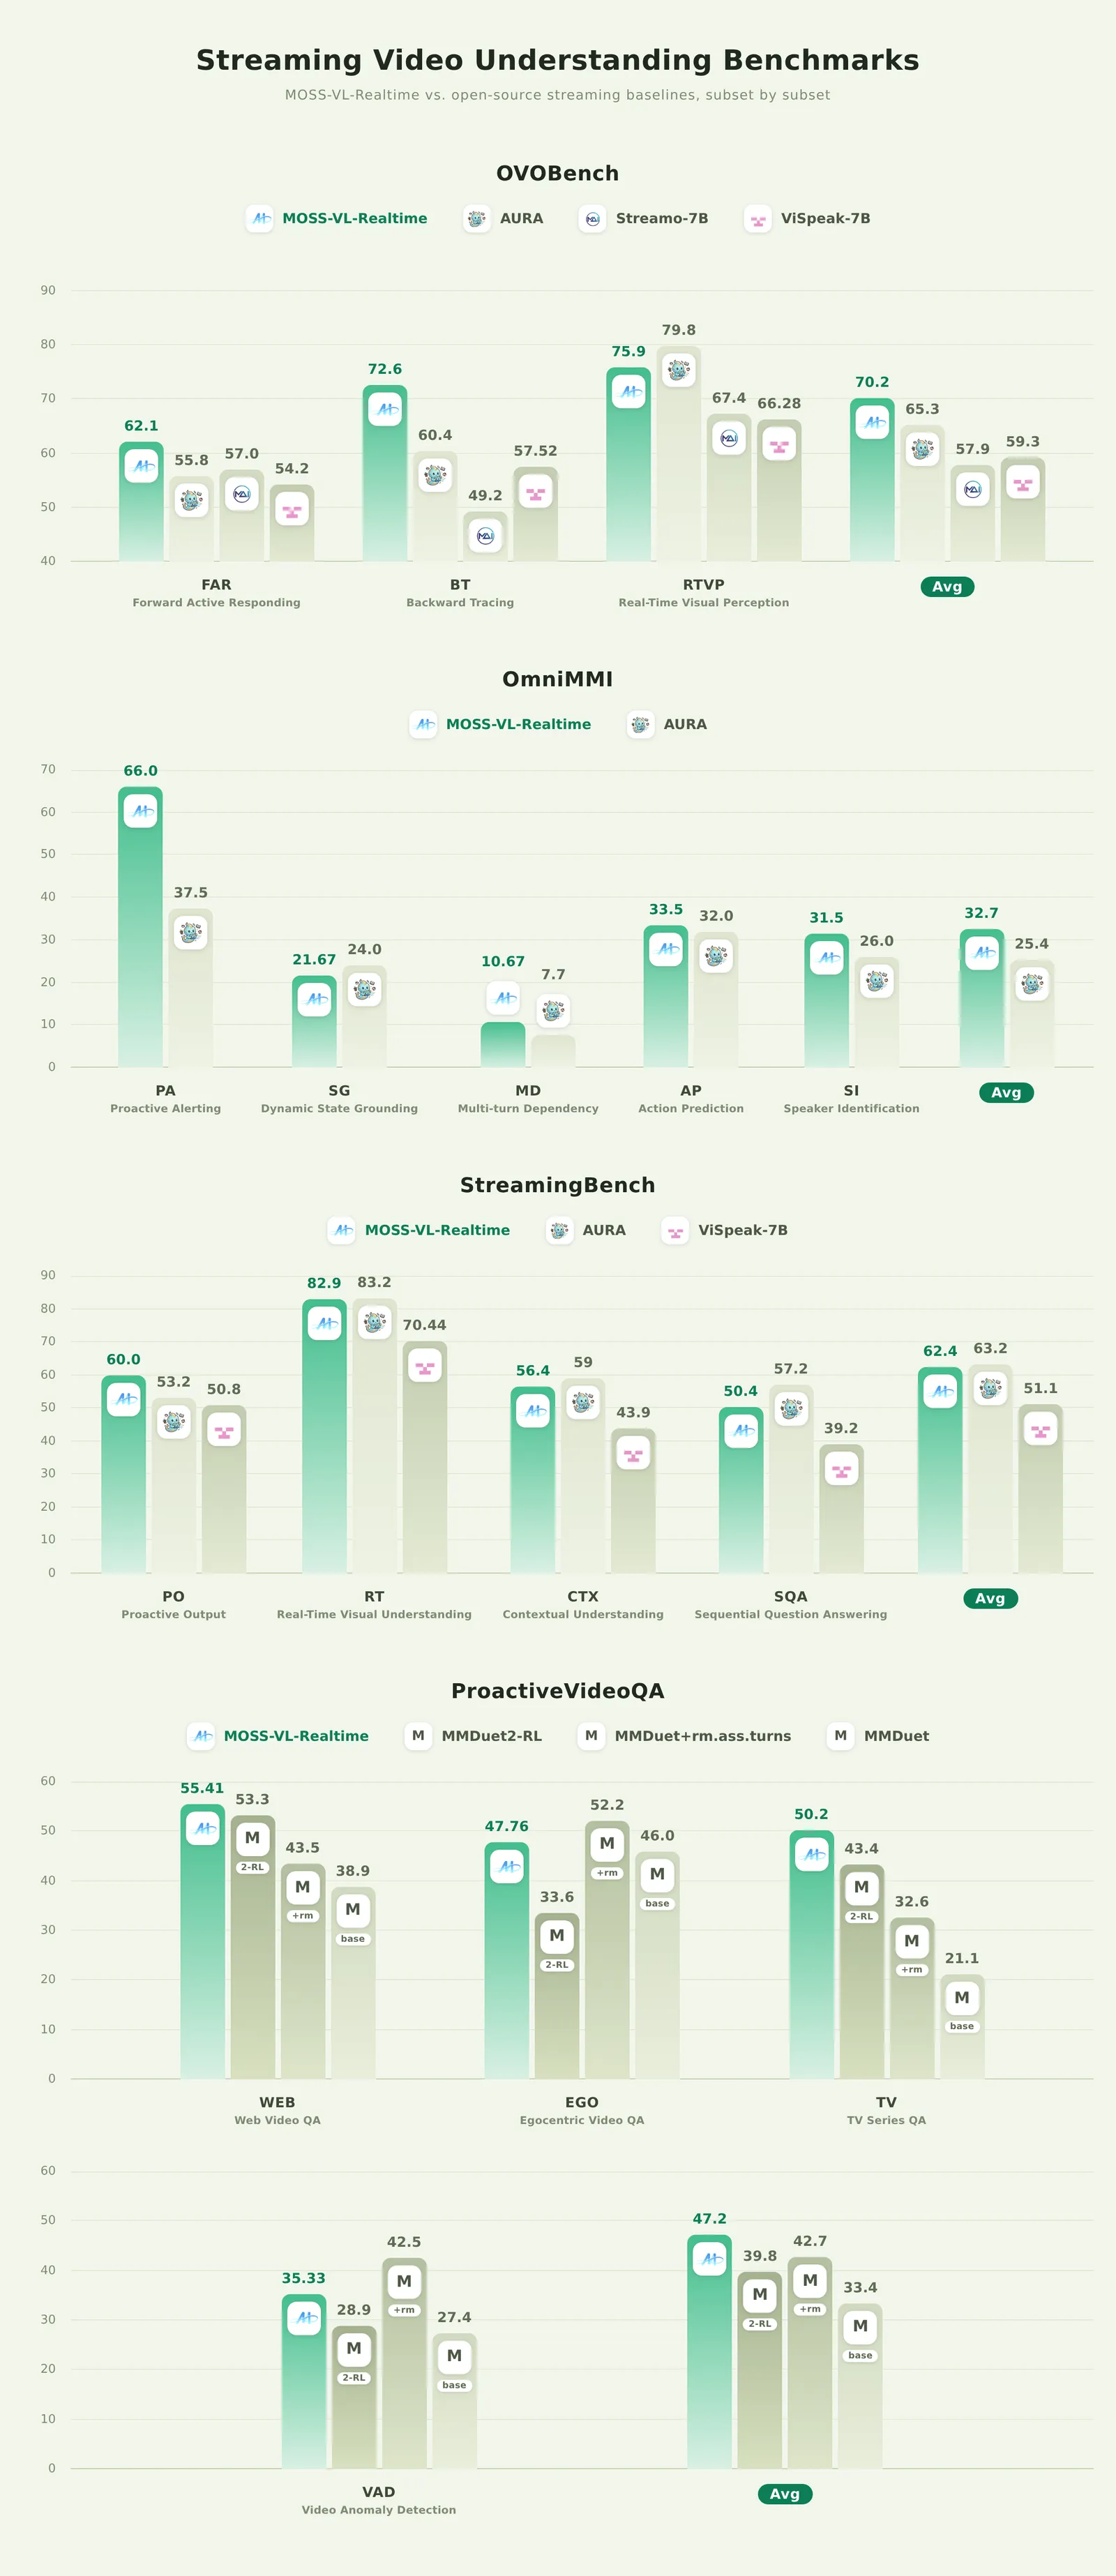
在流式视频理解基准上,MOSS-VL-Realtime 的交互能力提升明显,其中「主动开口」这一项尤其突出——它在 OmniMMI 的 Proactive Alerting、StreamingBench 的 Proactive Output、ProactiveVideoQA 三项主动性评测上都拿到了领先成绩。
离线基础评测
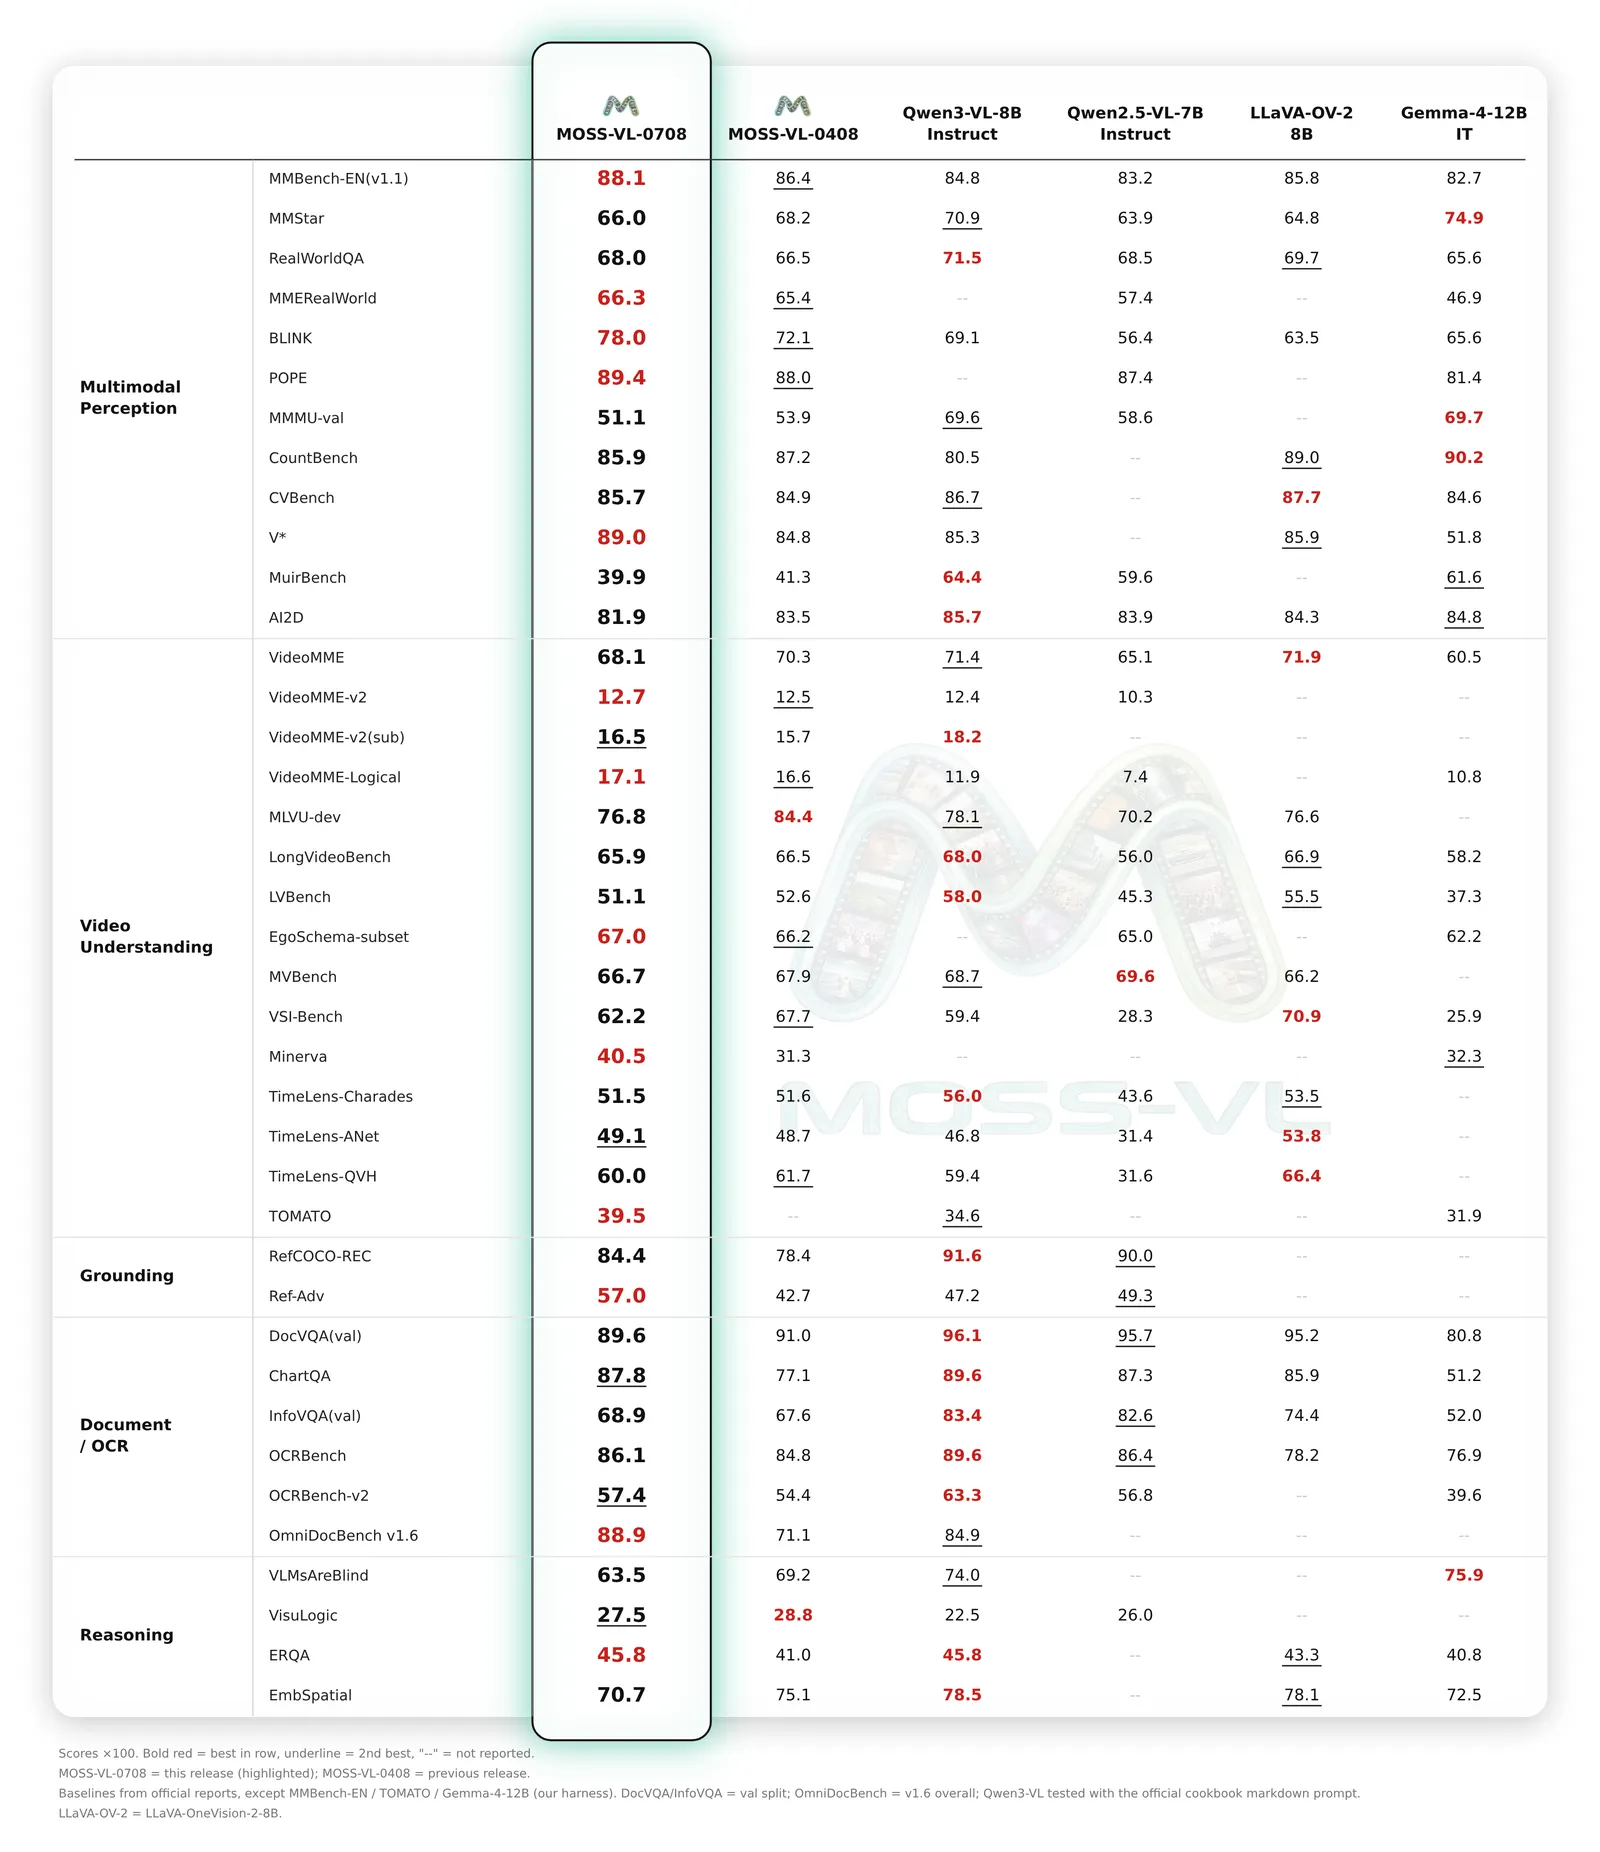
团队对数据体系做了系统性重构,所以模型在实时能力之外,离线基础能力也没有被牺牲——各项离线评估保持了很高的稳定性。这一点很关键:很多实时模型是靠砍掉基础能力换速度的。
此外在 Papers with Code 的榜单上,MOSS-VL 相关工作拿到了 POPE 第 2 名和 TOMATO 第 3 名的成绩。
社区热度
💡 适用场景
场景一:实时监控与异常预警
功能说明:接上摄像头视频流,让模型持续观察画面,发现异常时主动开口,正常时保持沉默。
输入要求:实时视频帧流(支持摄像头、屏幕采集、WebSocket 推流)。
输出效果:流式的自然语言描述与预警,可被随时打断追问细节。
适用场景:工厂产线巡检、仓库安防、门店客流异常检测。
场景二:直播与视频导览助手
功能说明:观众在直播过程中随时提问,模型基于当前已经播到的画面作答,不用等直播结束。
输入要求:直播视频流 + 用户的实时文字或语音提问。
输出效果:即问即答的流式回复。
适用场景:电商直播答疑、线上看展讲解、体育赛事实时解说辅助。
场景三:长视频内容深挖
功能说明:用 MOSS-VL-Instruct 处理教学录播、会议录像、长纪录片,做深度多轮对话。
输入要求:完整的长视频文件。
输出效果:结构化的内容摘要、关键时间点定位、多轮追问解答。
适用场景:教学录播知识点抽取、会议纪要自动生成、影视素材检索。
场景四:无障碍与语音交互
功能说明:仓库内置了完整的实时交互 Demo,集成 ASR 与 TTS,支持用语音提问、结合画面回答、再把答案播报出来。
输入要求:麦克风语音输入 + 摄像头或视频流。
输出效果:语音问答闭环。
适用场景:视障人士环境描述、免手操作的工业现场辅助。
用户群体总结
- ✅ 做实时视频应用的团队:这是少数能直接拿到实时交互开源权重的选择
- ✅ 需要二次开发的算法团队:MOSS-VL-Base 提供预训练基座,支持继续预训练
- ✅ 算力有限的个人开发者:FP8/NF4 量化后单张 24GB 显卡就能跑
- ❌ 不适合:只做单张图片分类、不需要时序理解的任务,用轻量 VLM 更划算
💰 定价方案
完全开源,免费使用。
MOSS-VL 三个模型全部开放权重,采用 Apache-2.0 协议,可商用。模型权重同时发布在 Hugging Face 和 ModelScope,国内下载无障碍。
开源协议: Apache-2.0
💡 成本亮点:官方提供了 Intruct-0708 与 Realtime 的 FP8 和 NF4 两种量化版本,单张 24GB NVIDIA 显卡即可高效推理,不需要 A100 集群。
生态适配也做得比较到位——已经接入了 LLaMA-Factory、ms-swift,以及 SGLang / SGLang-Omni 推理后端。你想用哪套微调或部署工具链,基本都有现成路径。
🎯 总结
MOSS-VL 最有价值的地方不是「又一个开源视频模型」,而是它换了一个提问方式:视频理解能不能不等看完? 复旦 OpenMOSS 团队用 11B 的开放权重给出了肯定答案,并且把随时打断、主动沉默、动态纠正这三个真正难的能力一起做进去了。
配套的 SGLang-Omni 实时后端、FP8/NF4 量化、完整的语音交互 Demo 和一套轻量微调框架,让它从「能跑通」到「能部署」之间的距离比多数开源项目短得多。
推荐指数: ⭐⭐⭐⭐⭐(满分5星)
适合人群: 做实时视频应用、需要视频-语言基座做二次开发、以及关注多模态前沿的开发者。
GitHub 仓库: OpenMOSS/MOSS-VL
在线体验: MOSS-VL Demo
技术报告: arXiv:2608.15045
数据截至 2026-10-19,最新信息请以官方仓库为准。