🔥 【今日推荐 ml-intern】:HuggingFace 开源"AI 打工人",自动读论文训模型,今日狂揽 3000 Stars!
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../ml-intern-recommend.pptx../../ml-intern-recommend.mp4本文目录
🔥 【今日推荐 ml-intern】:HuggingFace 开源"AI 打工人",自动读论文训模型,今日狂揽 3000 Stars!
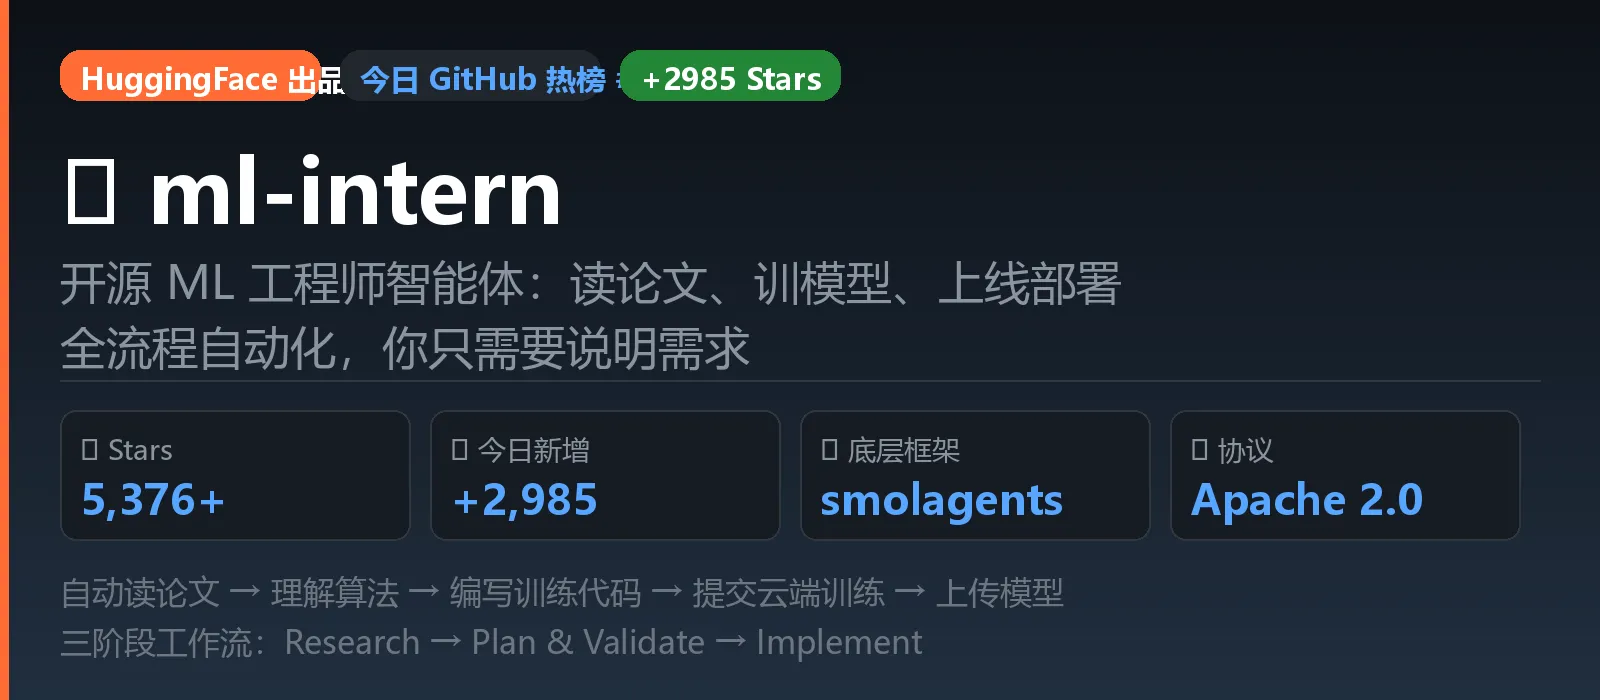
HuggingFace 刚刚开源了一个"AI ML 工程师":它能自己读 ArXiv 论文、理解算法、写训练代码、提交 GPU 云训练,然后把训好的模型上传到 Hub。你只需要说一句需求,剩下的它全包了。


🚀 什么是 ml-intern?
ml-intern 是 Hugging Face 于 2026 年 4 月推出的开源 ML 工程智能体(AI Agent)。它基于 HuggingFace 自家的 smolagents 框架构建,定位是一个能够端到端完成 ML 开发任务的"自动化工程师"。
从项目名字就能看出团队的幽默感——这是一个永不抱怨、不需要休息、不要工资的"ML 实习生"。但它的能力绝非实习水平:它可以独立研读最新研究论文,把论文里的算法转化为真实可运行的 Python 代码,在 A100 GPU 上跑完训练,最后把模型自动发布到 Hugging Face Hub。
核心能力:Instructions in,Trained model out——说清楚要干什么,拿走训好的模型就行。
上线 4 天,已在 GitHub 获得超过 5,376 Stars,今日单日新增 +2,985 Stars,直接登上 GitHub 全站热榜第 2 名。
✨ 核心功能一览
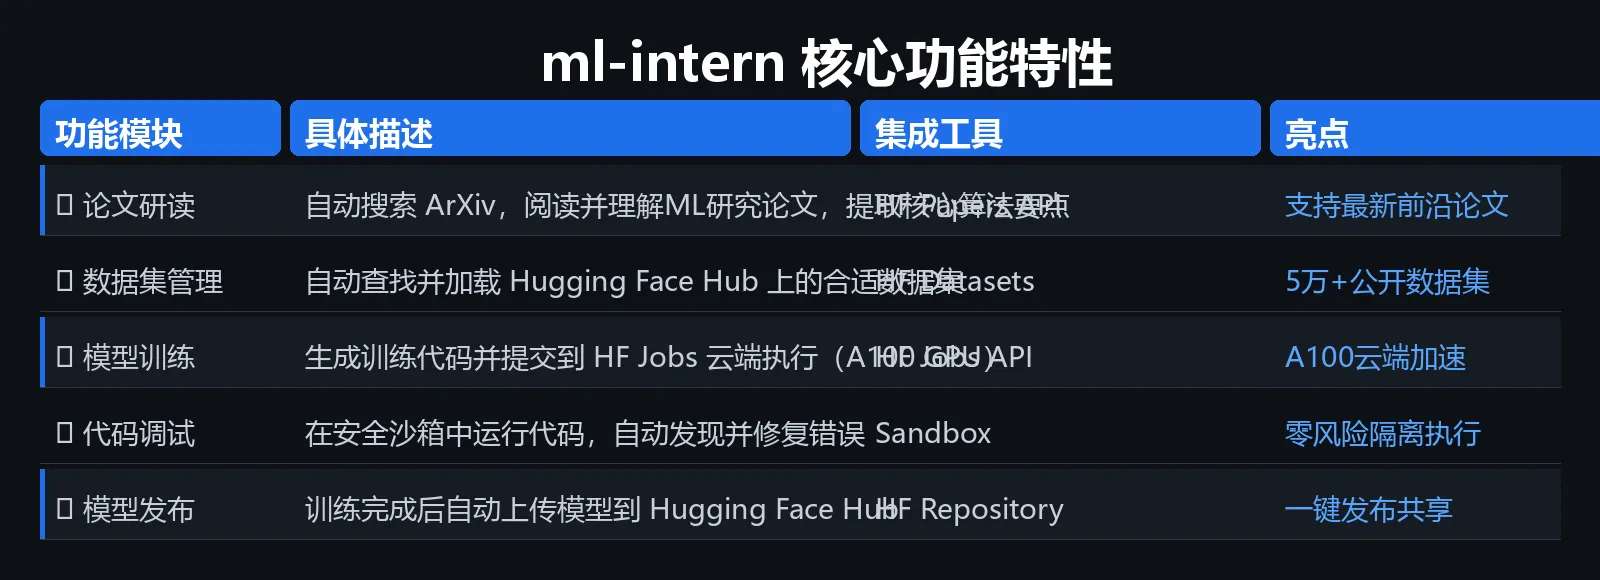
ml-intern 的五大核心模块:
- 📖 论文研读:调用 HF Papers API,自动搜索 ArXiv 上的最新论文,提取核心算法要点
- 🗃️ 数据集管理:自动在 HF Hub 上查找并加载合适的训练数据集(5万+ 可用数据集)
- 🚀 模型训练:生成 Python 训练脚本,直接提交到 HF Jobs 在 A100 GPU 上跑训练
- 🐛 代码调试:在安全沙箱环境中运行代码,自动发现错误并修复,零风险
- 📤 模型发布:训练完成后自动上传模型到 HF Hub,一键发布供全球共享
🛠️ 快速上手:5 分钟跑通示例
安装
# 克隆仓库
git clone https://github.com/huggingface/ml-intern.git
cd ml-intern

# 安装依赖(推荐 uv)
pip install uv
uv sync

# 登录 Hugging Face(需要 HF Token)
huggingface-cli login
命令行使用
# 交互模式:和 ml-intern 对话
uv run python -m agent.main

# 无头模式:单次任务执行
uv run python -m agent.main --prompt "训练一个情感分类模型"
示例对话
用户: 帮我训练一个英文情感分析模型,用 BERT-base 微调,数据集用 SST-2

ml-intern: 好的,我来查一下相关论文和数据集...
  [🔍 搜索 HF Papers] 找到 BERT 情感分类相关论文 3 篇
  [📦 加载数据集] stanford-nlp/sst2 已找到,67,349 训练样本
  [💻 生成代码] 创建训练脚本 train_sentiment.py...
  [🚀 提交训练] 已提交到 HF Jobs (gpu-a100),预计 15 分钟完成
  [📤 上传模型] 训练完成!模型已上传至 your-username/bert-sst2-finetuned
注意:使用 HF Jobs 云端训练需要 Hugging Face Pro 账号(月费 $9),也可以配置本地 GPU 免费使用。
Web 界面启动
# 同时启动前端和后端
uv run python -m agent.web
# 访问 http://localhost:3000
🏗️ 技术架构深度解析
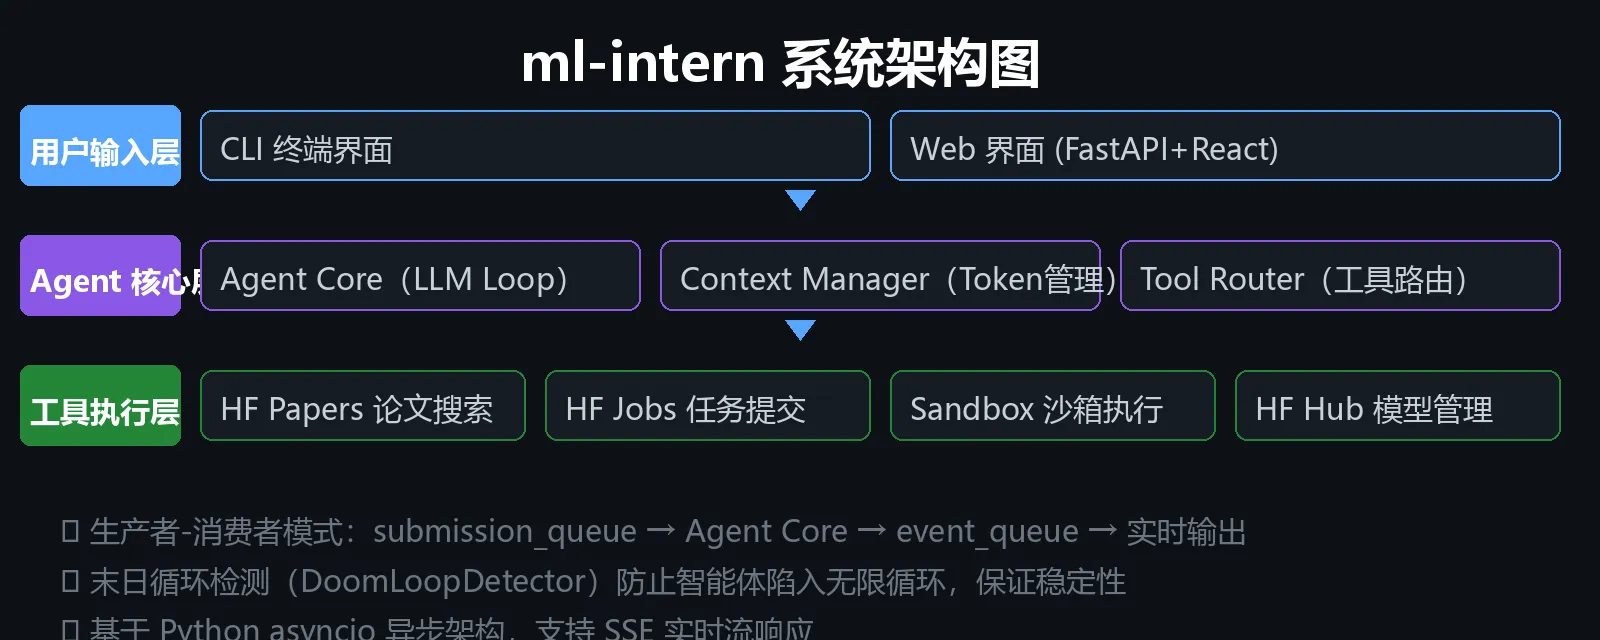
ml-intern 采用生产者-消费者异步架构,核心组件如下:
| 组件 | 职责 |
|---|---|
| submission_loop | 任务调度中心,接收用户输入并放入队列 |
| Agent Core | 编排 LLM 循环,管理任务状态,检测"末日循环" |
| Context Manager | 智能管理对话历史,处理 token 限制,压缩长对话 |
| Tool Router | 将 LLM 工具调用路由到外部 API、MCP 服务器或沙箱 |
DoomLoopDetector(末日循环检测器) 是一个亮眼的设计:如果智能体被某个问题卡住反复尝试相同方案,系统会自动识别并中断,防止无限循环消耗算力。
🌟 三阶段工作流
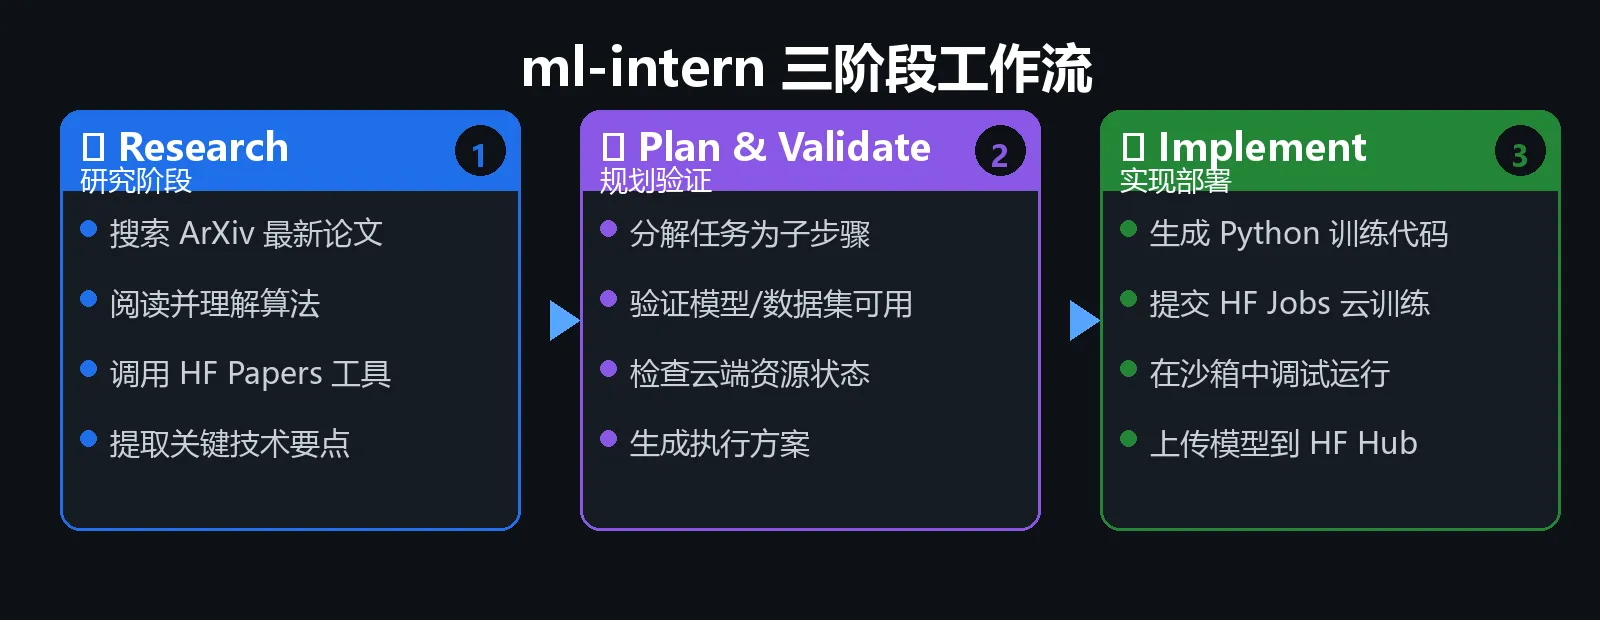
ml-intern 将每个任务分解为严格的三个阶段:
① Research(研究):使用专用子智能体探索文档和代码示例,搜索最新 ArXiv 论文,提取核心技术要点。
② Plan & Validate(规划验证):将任务拆解为可执行步骤,验证所需模型、数据集和算力资源是否可用,生成详细执行方案。
③ Implement(实现部署):在云端或沙箱环境中执行 Python 脚本,处理训练失败和报错,最终上传完成的模型。
💡 适用场景
快速复现论文结果
功能说明:从一篇 ArXiv 论文出发,ml-intern 可以自动阅读论文,理解模型架构和训练策略,生成完整的复现代码并运行。对于需要追踪最新研究进展的 ML 研究员,这意味着每天可以验证多篇论文的核心结论。
输入要求:ArXiv 论文链接或标题即可。
输出效果:完整训练代码 + 运行日志 + 上传到 HF Hub 的训练结果。
适用场景:学术研究快速验证、实验室论文复现、竞赛 Baseline 构建。
自动化 LLM 后训练
功能说明:ml-intern 特别针对 LLM Post-Training 场景做了优化,支持 SFT(有监督微调)、DPO(直接偏好优化)等主流训练方式。只需描述想要的模型行为,它会自动准备数据、选择合适的训练方法和超参数。
输入要求:描述目标行为(如"让模型回答更简洁")或提供偏好数据。
输出效果:微调后的 LLM 模型,可直接在 HF Hub 共享使用。
适用场景:企业内部 LLM 定制、模型能力增强、垂直领域模型构建。
数据集构建与验证
功能说明:在训练开始前,ml-intern 会自动在 HF Hub 的 5 万+ 公开数据集中寻找最合适的训练数据,并进行数据质量评估。它也可以帮助发现和修复数据集中的问题。
输入要求:任务描述(如"图片分类,识别猫狗")。
输出效果:推荐数据集列表 + 质量报告 + 加载代码。
适用场景:新项目快速选型、数据集审计、自动化数据管道构建。
用户群体总结
- ✅ ML 研究员:快速复现论文,每天验证多个实验方向
- ✅ AI 工程师:自动化重复性训练任务,专注更高价值的架构设计
- ✅ 独立开发者:低成本构建自定义 AI 模型,无需深厚 ML 背景
- ✅ 学生/初学者:通过观察 ml-intern 的操作过程学习 ML 工程实践
- ❌ 不适合:需要极高定制化控制、生产级稳定性要求(当前仍是早期项目)
📊 与竞品对比
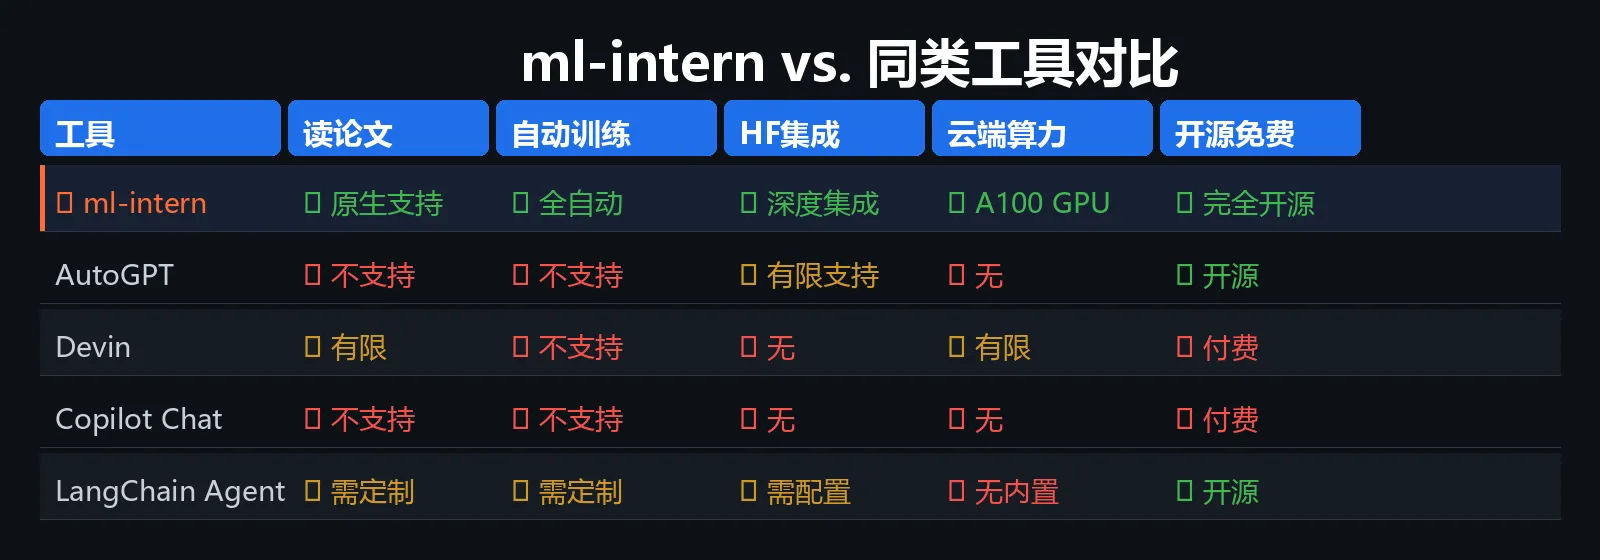
ml-intern 最大的差异化优势是与 HuggingFace 生态的深度集成:论文搜索、数据集加载、云端 GPU 训练、模型发布全部原生支持,而其他同类工具通常需要大量配置才能实现类似功能。
💰 定价与开源协议
| 使用方式 | 费用 |
|---|---|
| 本地 GPU 运行 | 完全免费 |
| HF Jobs CPU 训练 | 按量计费(极低成本) |
| HF Jobs A100 GPU | 需要 HF Pro($9/月)或按次付费 |
| Web 界面 | 免费(自部署) |
开源协议:Apache 2.0
💡 现在就是最好的入场时机:项目处于早期阶段,社区活跃,Star 增速极快,现在参与贡献意义重大。
🎯 总结
ml-intern 代表了 Hugging Face 在 AI Agent 领域的重要布局——不是一个辅助工具,而是一个真正能独立工作的 ML 工程师。它将"读论文→写代码→跑训练→发布模型"的全流程压缩到一句话的指令内。
对于需要快速迭代的 ML 研究员和工程师,它能显著降低重复性工作的时间成本。对于初学者,它更是一个绝佳的学习助手,通过观察它的操作可以直观理解 ML 工程的完整流程。
推荐指数: ⭐⭐⭐⭐⭐(满分5星)
适合人群:ML 研究员、AI 工程师、独立开发者、ML 入门学习者
立即体验:HuggingFace Spaces 在线 Demo
GitHub 仓库:huggingface/ml-intern
数据截至 2026 年 4 月 25 日,最新信息请以官网为准。