mini-AGI
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../mini-agi-recommend.pptx../../mini-agi-recommend.mp4本文目录
📌 核心价值:不是又一个能跑的模型,而是一个「不会停训、也不会忘」的模型——一张 8GB 显存的笔记本显卡就能从零把它训出来。
你手上的大模型,都是别人训完冻好的。微调只是在外围打补丁,压一批专业数据进去,它转头就把通用能力忘掉。mini-AGI 想解决的正是这件事:让模型像人一样,一条数据流读下去,边读边学,学新的不丢旧的,而硬件只需要一台游戏本。
🚀 什么是 mini-AGI?
mini-AGI 是开发者 Alexey Borsky(GitHub ID volotat)开源的字节级持续学习语言模型。9 月 19 日发布,MIT 协议,登上 Hacker News Show HN 拿到 248 分,目前 ⭐683。
它的定位一句话说清:模型自己长架构,从零开始训练,装在单张 8GB 显存 GPU 上,并且永远不会停止学习。


作者很诚实,README 第一句就写了「这是个玩具级模型,别指望它有前沿模型的能力」。但玩具级不等于没价值——它证明了一件事:持续学习(continual learning)不灾难性遗忘,在平民硬件上就能做到。
核心定位:参数量由硬盘决定,不由显存决定——5.4 亿参数的模型,常驻显卡的只有 1.09 亿。
✨ 三个硬约束,撑起了整个设计
传统 LLM 走的是「固定层堆栈」:token 进去,一层一层往下走。mini-AGI 不走这条路。它的全部设计由三个约束倒推出来:
- 必须塞进 8GB。不是靠量化——训练要梯度、要优化器状态,这部分大约是权重的三倍。所以权重放在硬盘上,只有「当前要用的那一小撮」在显卡里。
- 必须不忘。一个边学边覆盖自己的模型,比压根不学习更糟。
- 必须什么都能读。词表就是 256 个字节值,没有分词器,也就没有「这个文件类型不认识」这回事。
具体到前向过程:一个字节先过 2 个稠密前导块,然后进 1 个循环块,最多应用 24 次,每一次应用都从共享池里自选 top-8 专家。循环之间的隐状态从不解码,而是每次都由一个 adapter 和输入嵌入重新合并——这样循环不会越跑越偏离它正在读的文本。
三个不同块,每个字符最多 26 次块应用。
自适应深度是这里最巧的一点:一个「停机头」在每一行给每个字符打分,只要再加一行不会改变答案,这个字符就停。简单字符走一行,难的走十几行。实测每个字符在 4~14 行之间浮动,上限是 24。

左边每块瓷砖是一个专家,颜色代表专家身份;一行就是循环块的一次应用,行里 8 块瓷砖是这一行真正跑过的 8 个专家。琥珀色线是停机发生的位置,下面那些灰色行是模型「拒绝花掉」的计算量。
📊 读文件时和写文件时,是同一条代码路径

上面这段是模型在读(灰色是给它的,绿色全是它自己写的)。上一段是读,这段是写:给它 2500 字符的保留故事开头,剩下的全靠自己续。贪心解码,不采样,跑两次结果一模一样。
两件值得看的:写比读更费深度——同一主题下写平均 9.9 行/字符,读只要 8.0 行。以及虚线是工作集重新挑选的位置(每 64 字符一次),这段里一次都没换,因为提示词已经把该要的专家拉上卡了。
🛠️ 分页:把「模型大小」和「显存大小」解绑
每个专家就是硬盘上的一个文件,装着它的权重和它的 Adam 动量。硬盘之上还有两层:
| 层级 | 名字 | 是什么 |
|---|---|---|
| 硬盘 | — | 模型拥有的全部专家,上限是剩余磁盘空间 |
| 内存 | ram_cache |
最近被用到的专家,LRU 淘汰 |
| 显存 | resident |
工作集——一个字符真正可能路由到的那些 |
每读一个 chunk 之前,模型会被问「接下来这段文本想要谁」,答案就是新的工作集。需求打分打在上一个 chunk 实际路由时产生的隐状态上——嵌入本身没有上下文,光靠嵌入打分会让所有主题都抢同一批专家。
两条铁律:
1. Adam 动量跟着专家走。动量属于专家,不属于它恰好占着的那个显存槽位。留下来,等于把一个专家的惯性交给下一个顶替者——训练曲线看着一切正常,其实每个换进来的专家都继承了陌生人的历史。
2. 已经在卡上的专家,留在原槽位不动。需求是按分数排序回来的,顺序一直在变,但集合几乎不动。按身份匹配而不是按位置匹配,才能让实际加载次数等于「集合真正变化了多少」。
因为选择是基于上一个 chunk 做的,它看不到即将要预测的文本。让工作集不被噪声推着来回换的是迟滞机制:候选专家必须超出常驻专家一个 margin 才能顶掉它,新来的专家有 dwell_chars 时长的保护期。
💡 最关键的那个数字:主干学习率 0.1 倍
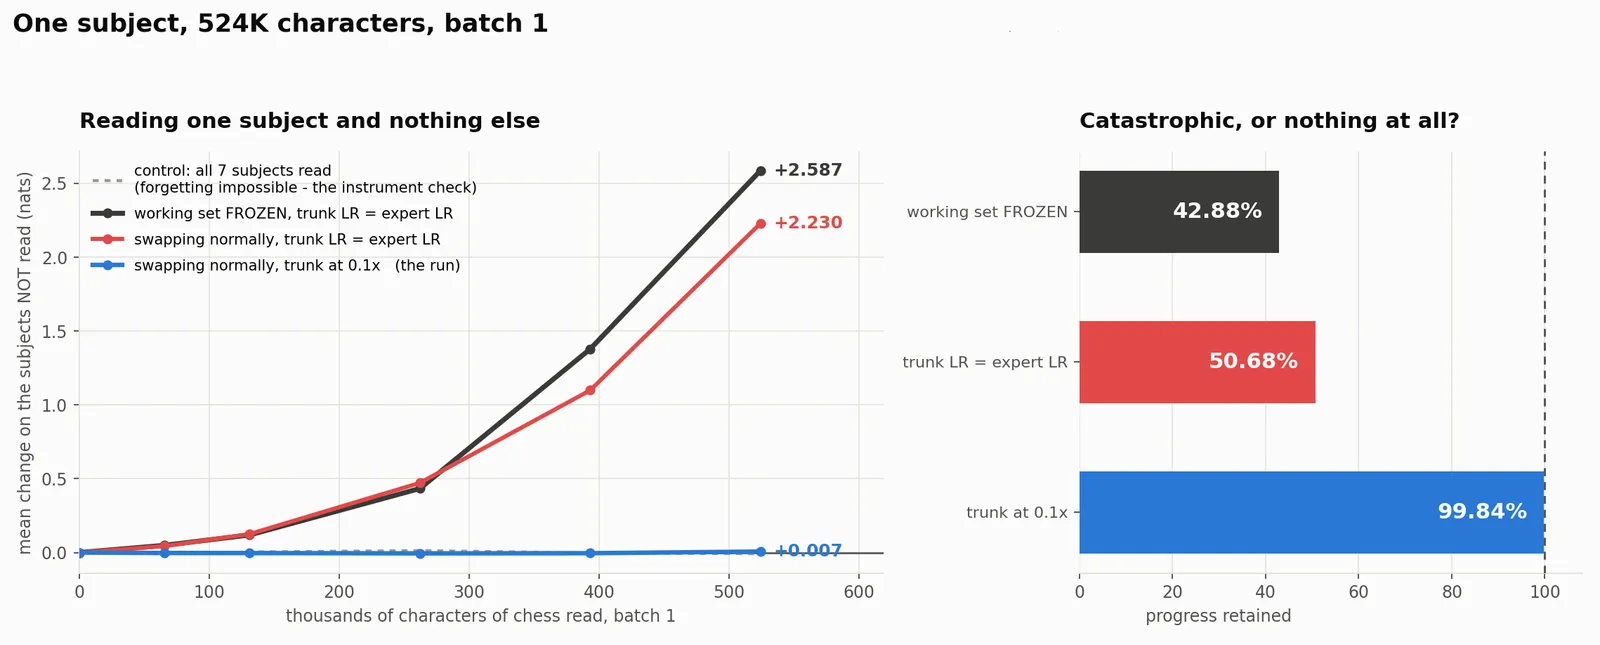
单条数据流、一次一个主题地训练,是灾难性遗忘的标准配方。让专家们按自己的学习率读 50 万字符国际象棋,其余七个科目会从 1.12 掉到 3.73 nats——基本废了。
解法是一个超参数:把主干(trunk)的学习率设成专家学习率的 0.1 倍。
主干是嵌入层、注意力、路由器、停机头——每个字符都必须经过的部分,它承担了 97.6% 的平方梯度范数。让它慢下来,遗忘从 +2.2300 直接压到 +0.0067 nats,知识保留率 99.84%。
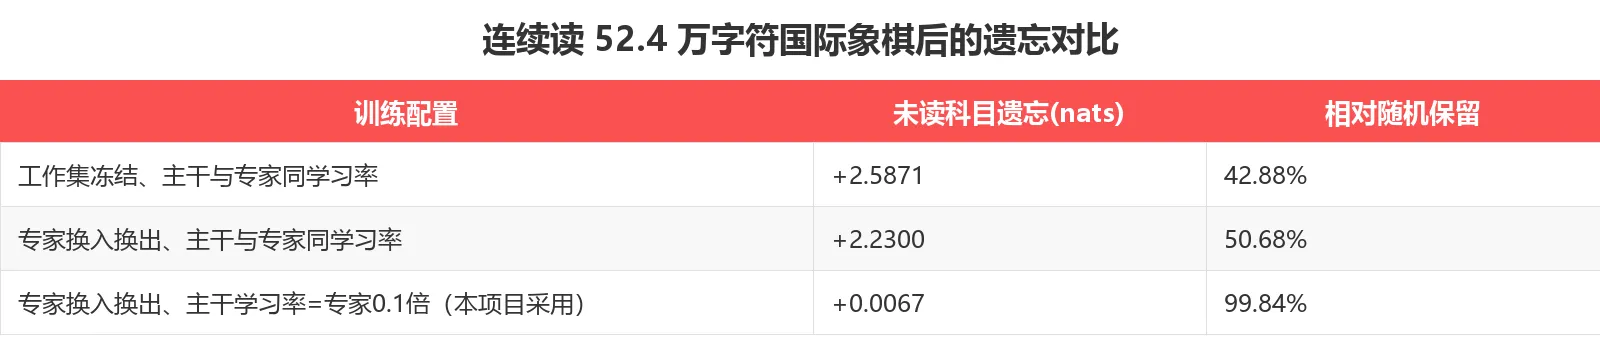
这张表是整个设计立论的那根柱子:模型读了 52.4 万字符的国际象棋、别的什么都不读,纵轴是它没读的那七个科目发生了什么。零 = 什么都没忘。前两行爬到 +2.2 和 +2.6,意思是模型把大部分旧知识丢了;第三行——主干学习率十分之一——全程贴着地板。
而且项目还顺手纠正了两个自己早前的说法:
- 专家池本身不是防遗忘的原因。把工作集冻住(等于把「池」最核心的性质拿掉),代价只有 0.3571 nats,占全部效应的 13.8%。那条实验线里 136 个专家有 93 个完全没收到梯度,模型照样崩。保住大部分权重并不足够。
- 损伤是「位移」,不是「毁灭」。故意把模型搞坏,然后什么东西都重新读一遍:四分之三的能力在 13.1 万字符内就回来了,而当初学会这些科目花了约 5000 万字符。需要重学的东西不可能快 380 倍回来。「灾难性」描述的是曲线谷底看起来什么样,不是权重到底怎么了。
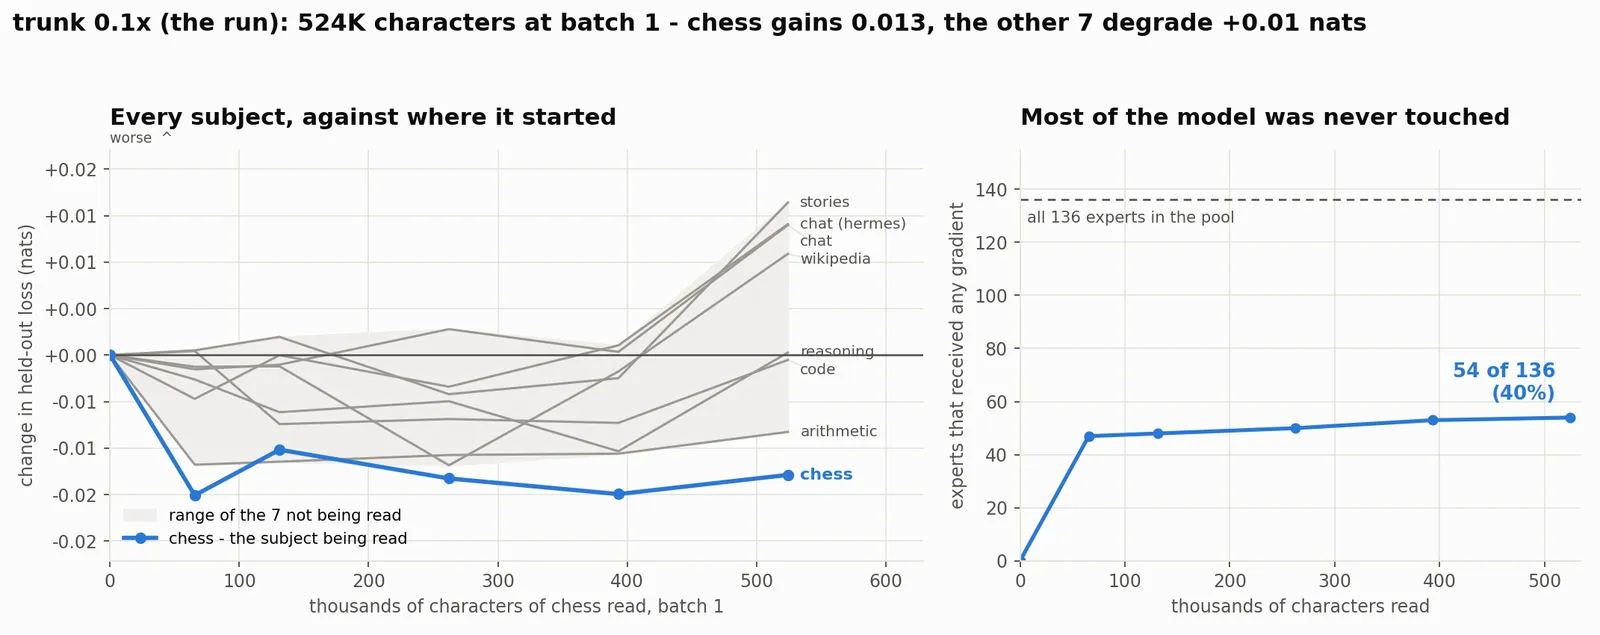
右图是为什么能做到:整轮探测里 136 个专家只有 54 个收到过梯度——60% 的模型在结构上完全没被碰到,因为路由压根没选它。这就是专家池的本职工作:把一次更新限制在文本真正寻址到的那部分模型里。
📈 现在到底在什么水平
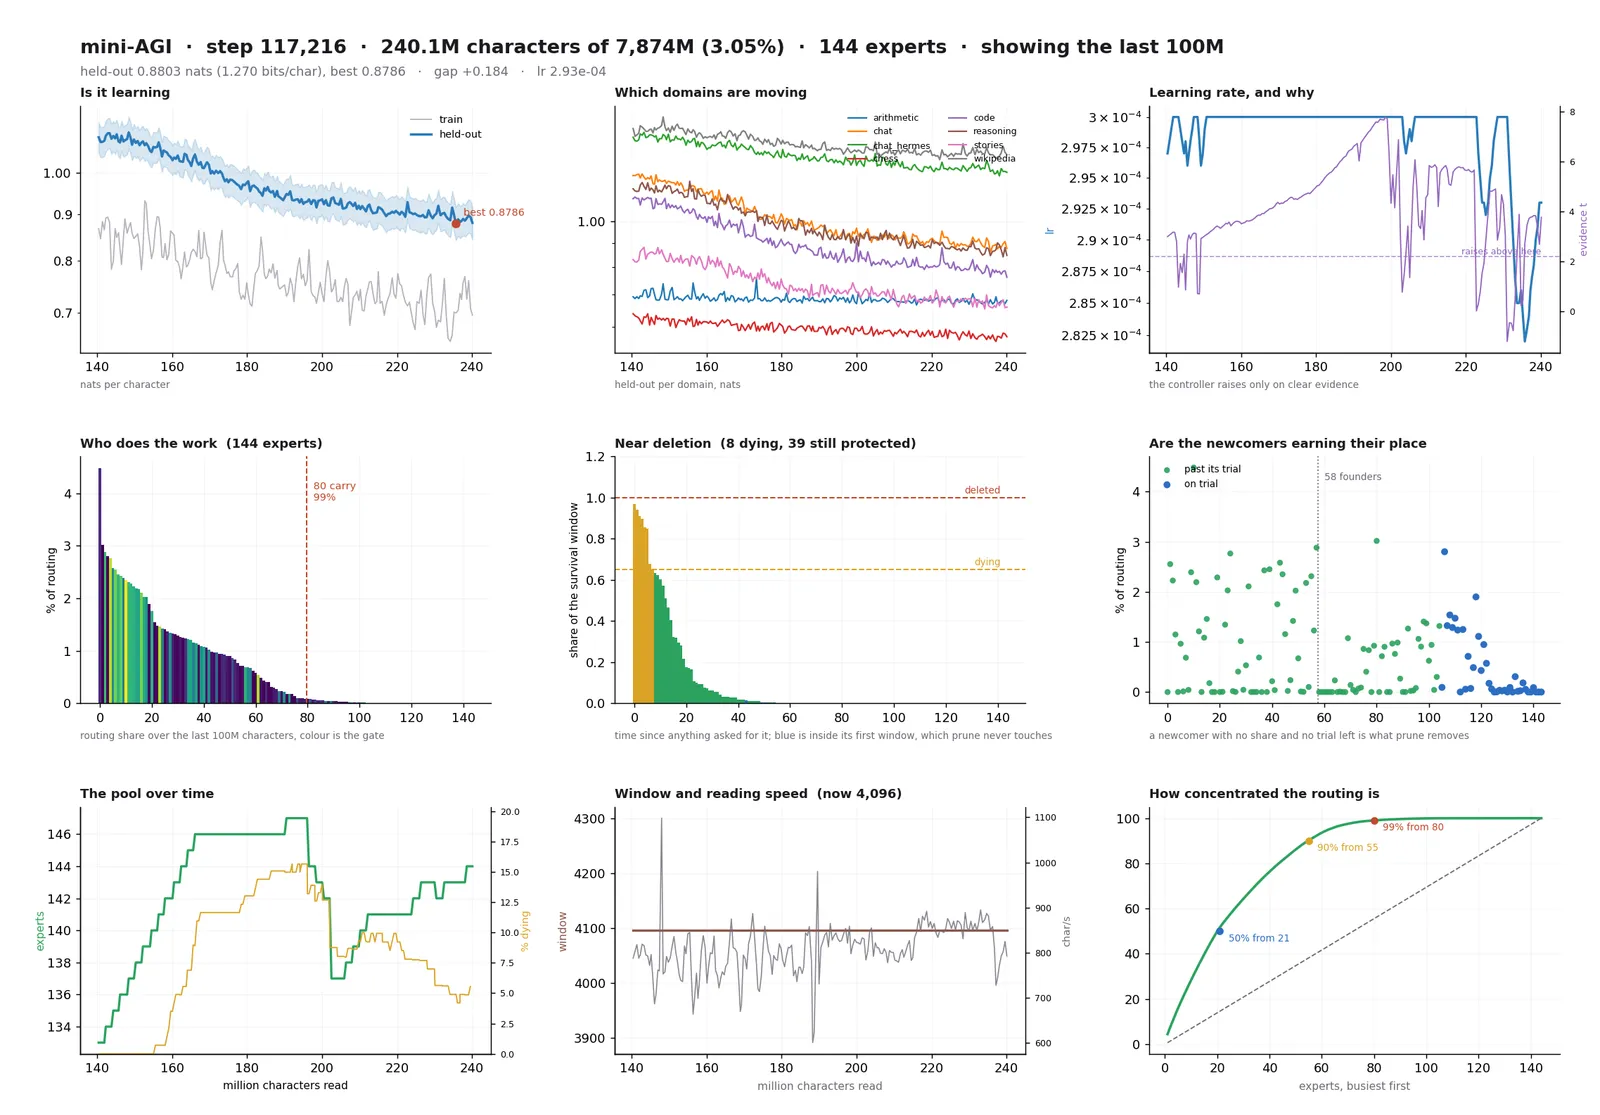
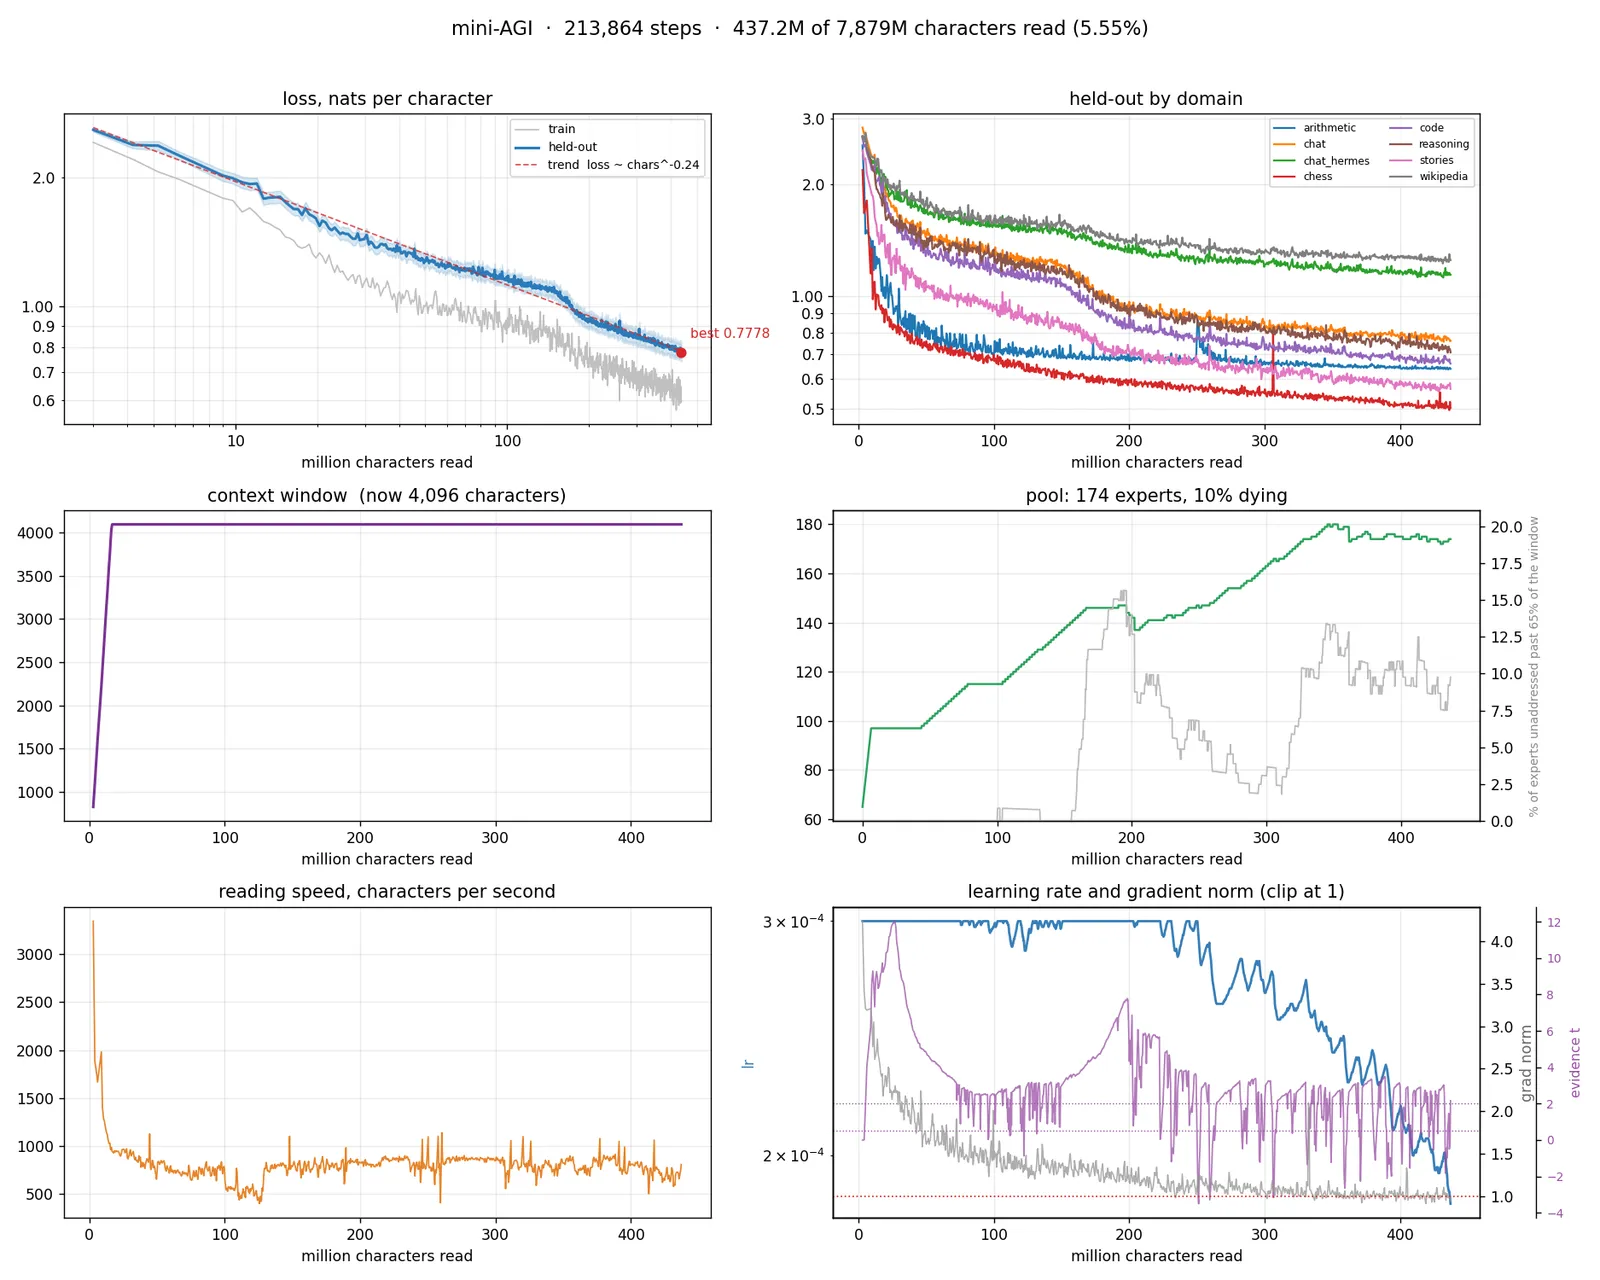
跑了 213,864 步、读了 4.372 亿字符(占 78.79 亿语料库的 5.55%),池里 174 个专家,读取速度约 804 字符/秒。
| 指标 | 数值 |
|---|---|
| 全部 8 科目 held-out loss | 0.7778 ± 0.0343 nats/char(1.1222 bits/byte) |
| 训练 loss | 0.5964 nats/char |
| 困惑度 | 2.18 |
| 参考机 | RTX 3070 Laptop,8GB 显存 |
| 当前参数量 | 5.401 亿(主干 827 万 + 路由器 17 万 + 专家 5.316 亿) |
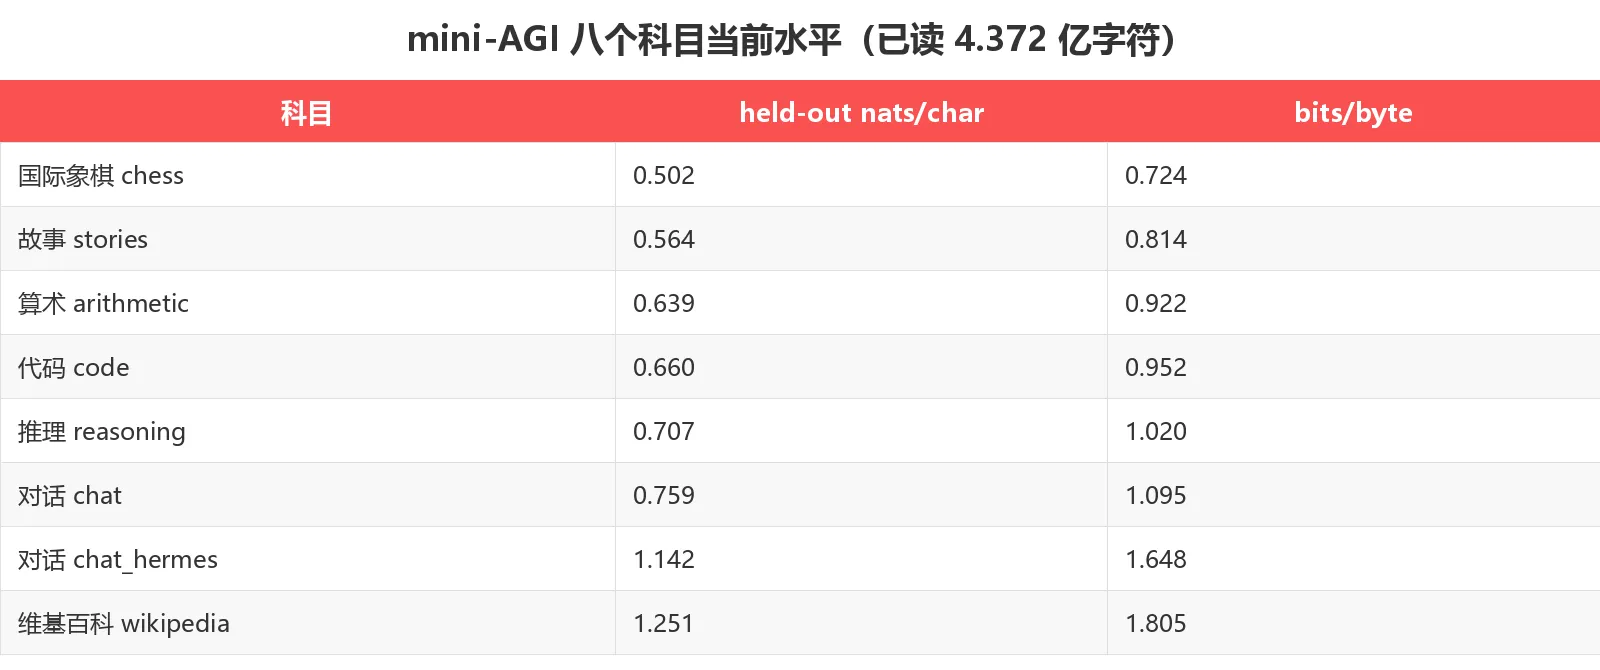
要提醒一句:作者明确说,同一配置跑两次会差约 0.014(CUDA 上专家分发不确定),低于 0.03 的差异应看作仪器噪声,不是结果。
缩放定律还在生效
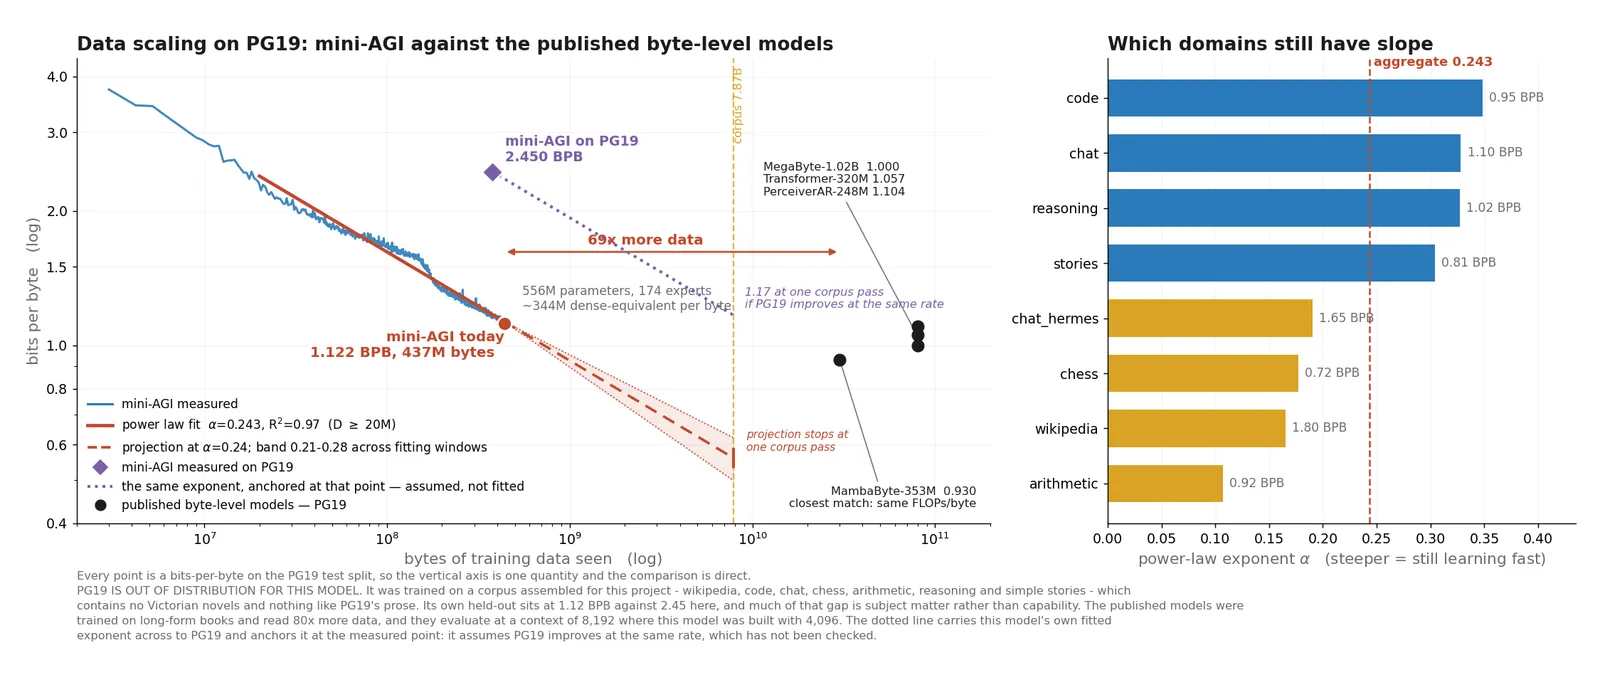
每个点都是 PG19 测试集上的 bits-per-byte。模型在整个测试集(100 本书、4128 万字节)上拿到 2.450 BPB,上下文 4096——比它自己混合语料的 1.16 高不少,但 PG19 对它来说是分布外:它从没读过维多利亚小说,这差距里相当一部分是题材而不是能力。
红线的拟合幂律是 L ∝ D^-0.243,R² 0.97,夹在 Kaplan 的 0.095 和 Chinchilla 的 0.28 之间,并且已经在一个数量级以上的数据跨度里保持住了。照这条趋势直读:
| 目标 held-out | 需要字节数 | 按 804 字符/秒折算 |
|---|---|---|
| 1.10 BPB | 4.7 亿 | 约 1 天 |
| 1.00 BPB | 7.0 亿 | 约 4 天 |
| 0.93 BPB | 9.5 亿 | 约 7 天 |
| 0.80 BPB | 17.6 亿 | 约 19 天 |
这些是「一台笔记本显卡上几天到几周」的量级,不是「几年」。
🛠️ 快速上手:最短路径是让它读你自己的文件
安装
git clone https://github.com/volotat/mini-AGI.git
cd mini-AGI

pip install torch numpy pyyaml matplotlib   # 模型和它的图(只有这行是训练必需的)
pip install flask                            # serve.py 本地网页
pip install chess zstandard datasets         # 构建语料
硬件要求:至少 8GB 显存的 CUDA 显卡,Python 3.10+。参考机是 RTX 3070 Laptop 8GB。PyTorch 要匹配你的 CUDA 版本,参考环境是 torch 2.6.0+cu124 + numpy 1.24.4。
最短路径:读你自己的文件
python3 train.py read ~/notes                       # 干读,什么也不保存
python3 train.py read ~/src ~/docs --passes 3 --save
指向文件或目录就行,没有任何要预处理的东西:词表就是 256 个字节值,你的文件本来就是用这个唯一词表写的。目录会被遍历,二进制靠采样内容判断跳过(不信任扩展名),每个文件从头读到尾——因为文档是有顺序的。
注意:不加 --save 什么都不写盘,读了也是白读。默认学习率 5e-5,低于正式训练——读文件应该是调整模型,不是覆盖模型。它还会前后各打一次保留集分数,明明白白告诉你这次读取有没有让别的科目退步。
完整训练流程
python3 -m corpora all --limit 5000    # 先来一小片试试
python3 -m corpora all                 # 八个科目,几个 GB

python3 train.py read data/train --save --weights-dir weights \
    --held-out data/val --sample-every 10

python3 serve.py --port 8080           # 打开 http://127.0.0.1:8080
权重目录就是模型
没有 .pt 文件要管,weights/ 这个目录本身就是模型:
weights/
  manifest.json    有什么、什么形状、从哪来
  core.npz         嵌入、注意力、归一化、adapter、停机头
  routers.npz      门控、段路由器,每个专家每个调用点一行
  optim.npz        主干和路由器的 Adam 动量
  experts/         每个专家一个文件:w1、w3、w2 和它自己的动量
    e00000.npz ...
目录里存的是模型达到过的最好状态,不是最近一次的状态。写入是原子的(先写 .tmp 再改名),中断的保存不会留下半截权重。
一个反直觉的工程发现值得记一下:判断专家死活的依据是「多久没人点它」,不是它的门控值。门控在这里不只是没信息,它是反预测的——最小的门控属于最忙的专家(那种被反复选中、但每个字符贡献很少的「下水道」专家),而门控很高、几十万个 segment 没人要的专家反而是真的死了。
📊 与两条常见路线对比
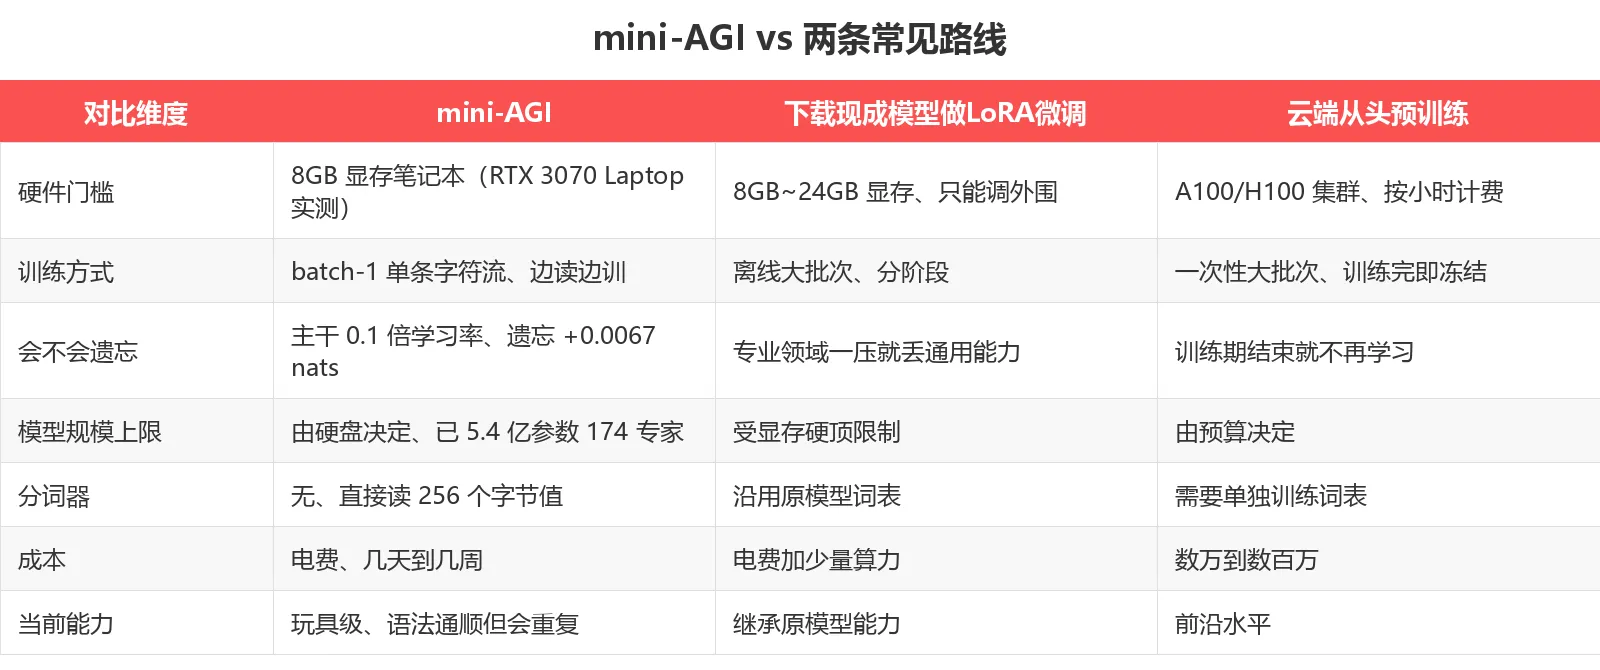
一句话总结:mini-AGI 不是在跟 GPT 比能力,它是在换一个游戏——「模型归你、持续在学、不会被关掉」。
💡 谁该用它
场景 1:想让模型真正吃透自己的私域资料
功能说明:train.py read 把你的笔记、代码、文档按原顺序读进去,读完立刻打分告诉你有没有拖累别的科目。
输入要求:任意文件或目录,不需要清洗、不需要分词。
输出效果:模型权重直接吸收这批内容,并且读前读后的保留集分数公开可查。
适用场景:个人知识库、企业内部文档、代码仓库理解。
场景 2:低成本做持续学习研究
功能说明:把 A100 集群上的持续学习实验,搬到一张 8GB 笔记本显卡上。主干 0.1 倍学习率这个结论,repo 里是带对照实验和 380 倍恢复速度反证的。 输入要求:PyTorch + 一张 8GB 卡。 输出效果:可复现的遗忘曲线、专家激活统计、缩放律拟合。 适用场景:高校实验室、个人研究者、想验证自己持续学习想法的人。
场景 3:研究 MoE 与自适应深度的活体样本
功能说明:专家池会自己长大(五个「刹车」全部同意才加)、自己剪枝(按没人要的时长判断),新专家靠重组现有专家的隐单元生成——克隆不够新、随机的又没东西可算。
输入要求:跑起来就行,行为是涌现的。
输出效果:shape.gif / generate.gif 是从活体模型里直接录的路由轨迹。
适用场景:MoE 路由可视化教学、自适应计算分配研究。
用户群体总结
- ✅ 个人玩家 / 学生:有张 8GB 游戏本显卡,想真正从零训一个属于自己的模型
- ✅ 持续学习研究者:要一个能跑的最小可复现实现,改一个 config 就能做对照实验
- ✅ 隐私敏感场景:全本地、无 API、权重就是硬盘上的文件,谁也拿不走
- ❌ 不适合:想要一个能干活的前沿模型的人——作者自己说了这是玩具级,会重复、会胡说,权重都还没发布
🔚 最后
这个项目的意义不在能力,在门槛。
它把「持续学习不灾难性遗忘」从论文里的公式和 A100 集群,拉到了一张 8GB 的笔记本显卡上。主干学习率 0.1 倍这个改动,让知识保留率从 50.68% 跳到 99.84%——差的是一个配置文件里的一个数字。
模型真正归你所有:在你的硬件上训、用你的数据训、每一次对话都在继续学,而且没有人能把它收走或者关掉。
项目地址:https://github.com/volotat/mini-AGI (MIT,⭐683)
⚠️ 权重尚未发布,当前这一轮还在读语料库的第一遍,作者读完后会放出权重。想立刻上手可以自己从零跑,或者接着现成的继续训。