AI 不再用完即忘:华为诺亚 MindMemOS 把 Agent 记忆从外挂变成系统层
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../mindmemos-recommend.pptx../../mindmemos-recommend.mp4本文目录
AI 不再用完即忘:华为诺亚 MindMemOS 把 Agent 记忆从外挂变成系统层
你有没有过这种体验:让 Claude Code 帮忙调了一晚上的依赖脚本,第二天重新开一个 session,它像失忆了一样,完全忘了昨晚踩过的坑;用 OpenHands 跑了一周的工作流,换个 Agent,之前的偏好和工具经验又得从头喂一遍。
问题从来不是 Agent 笨,而是它的记忆是"贴"在某个具体 Agent 身上的——换个皮就没了。
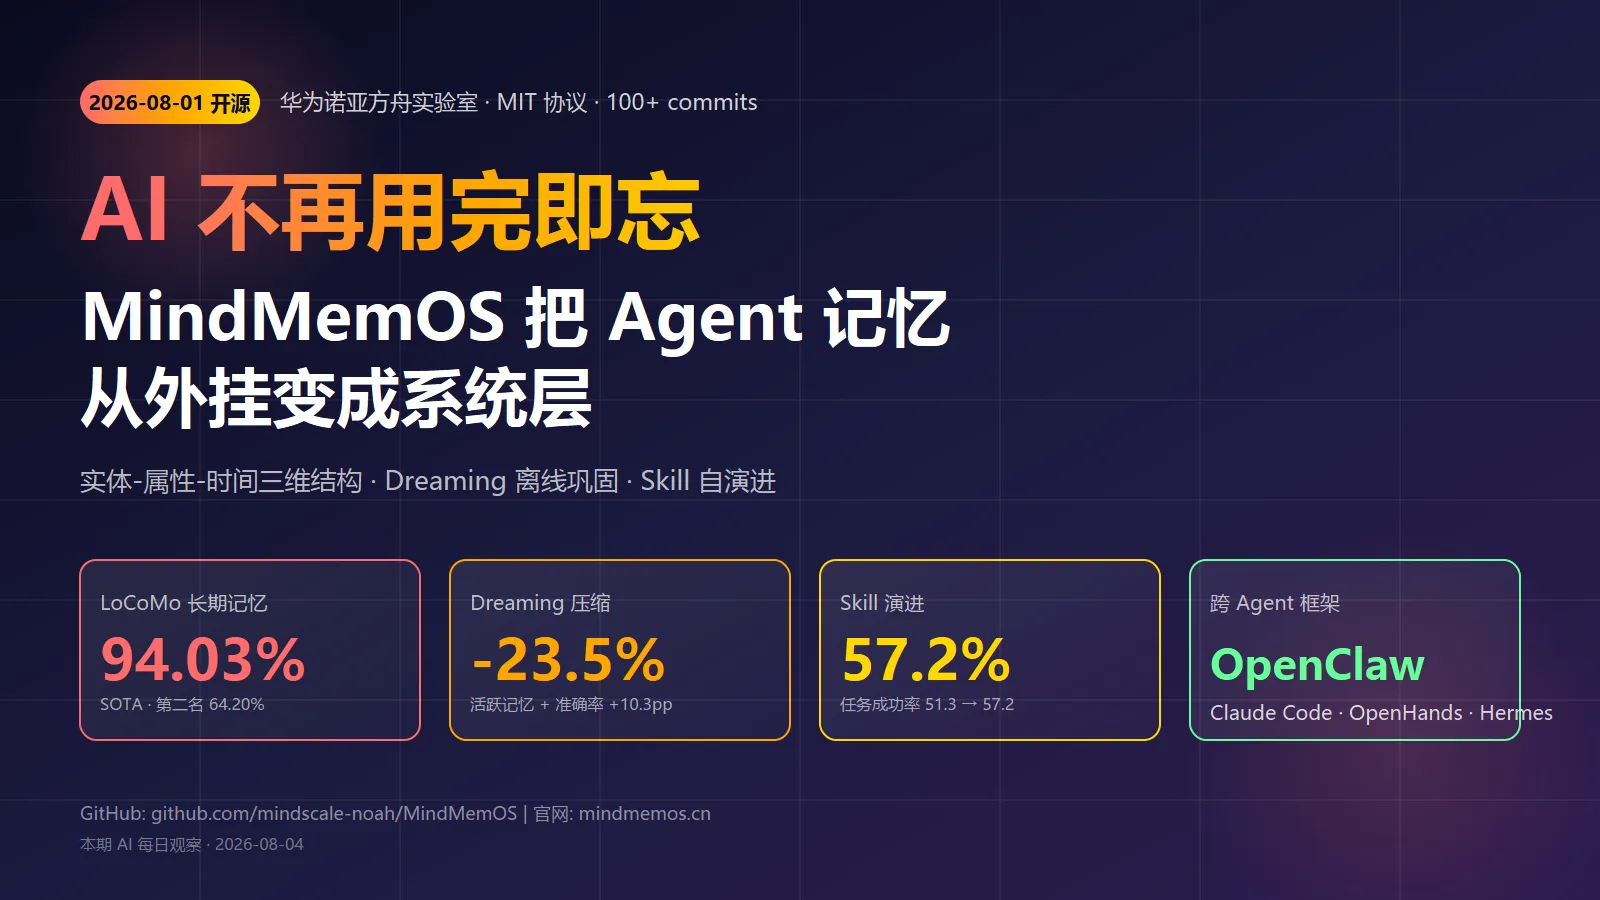
8 月 1 日,华为诺亚方舟实验室正式开源了一个叫 MindMemOS(Memory Operating System)的项目,MIT 协议,GitHub 100+ commits,直接把记忆从 Agent 内部抽出来,做成了"独立、可迁移、自演进"的系统级资产。配套论文与榜单数据显示,它在 LoCoMo 长期记忆基准上把分数顶到了 94.03%——一个对标 SOTA 的数字。
这可能是今年 Agent 基础设施赛道,最值得开发者上手的开源项目之一。
一、Agent 记忆为什么这么难?
我们以为 Agent 记忆是个"加缓存"的问题:把对话存到数据库,下次再取出来。
但实际跑过的工程师都知道,至少有四件事同时卡着:
- 跨框架迁移难:Claude Code、OpenHands、OpenClaw 各自一套记忆实现,换个 Agent 等于换一台电脑,连不上。
- 事实演进丢上下文:用户半年前说"我以前喜欢用 VS Code",现在改用 Cursor,很多系统分不清这是同一个人改了偏好,还是两个人,直接覆盖或并存。
- 检索质量靠运气:传统做法是文本片段 + 向量相似度,碰到"半年前那个项目用的是哪个版本"这种问题,几乎抓瞎。
- Skill 不能沉淀:解决某类问题的成功策略,跑完就丢,下次同类问题又得从零试错。
MindMemOS 的核心想法:把"记忆"做成一套操作系统,而不是某个 Agent 的私有模块。
二、MindMemOS 到底是什么?
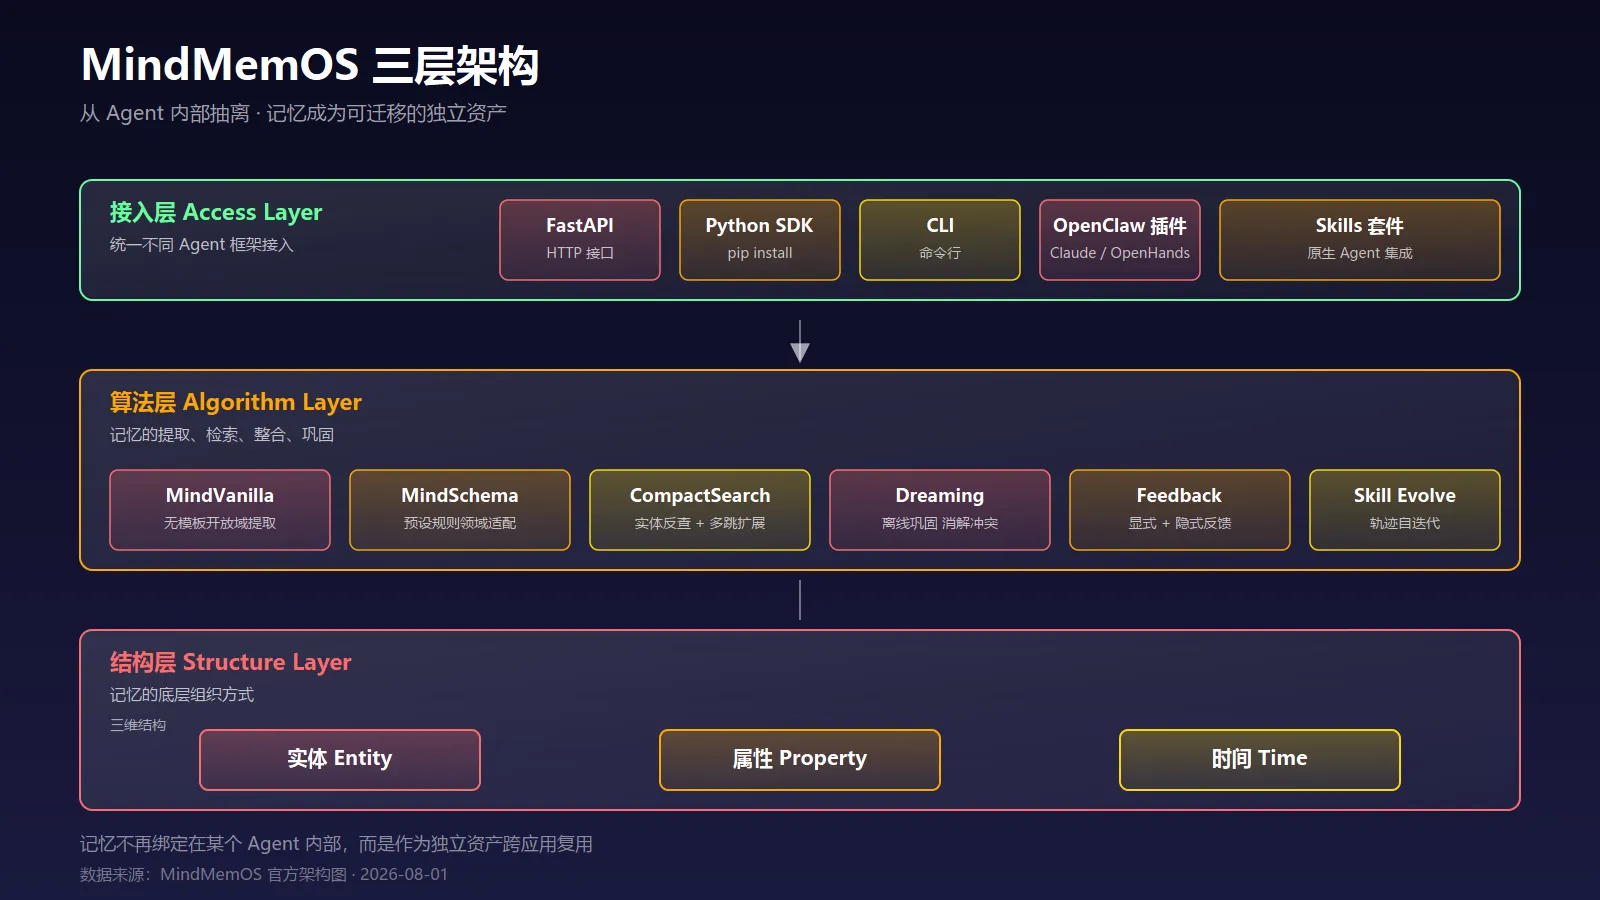
MindMemOS 把整套记忆系统在架构上拆成三层:
MindMemOS 把整套记忆系统在架构上拆成三层:
| 层 | 职责 | 关键模块 |
|---|---|---|
| 接入层 | 统一不同 Agent 的接入方式 | FastAPI / Python SDK / CLI / OpenClaw 插件 |
| 算法层 | 记忆的提取、检索、整合、巩固 | MindVanilla / MindSchema / CompactSearch / Dreaming / Feedback / Skill Evolution |
| 结构层 | 记忆的底层组织方式 | 实体-属性-时间 三维图结构 |
这套架构真正解决的不是"能记住",而是"记得能带走"。
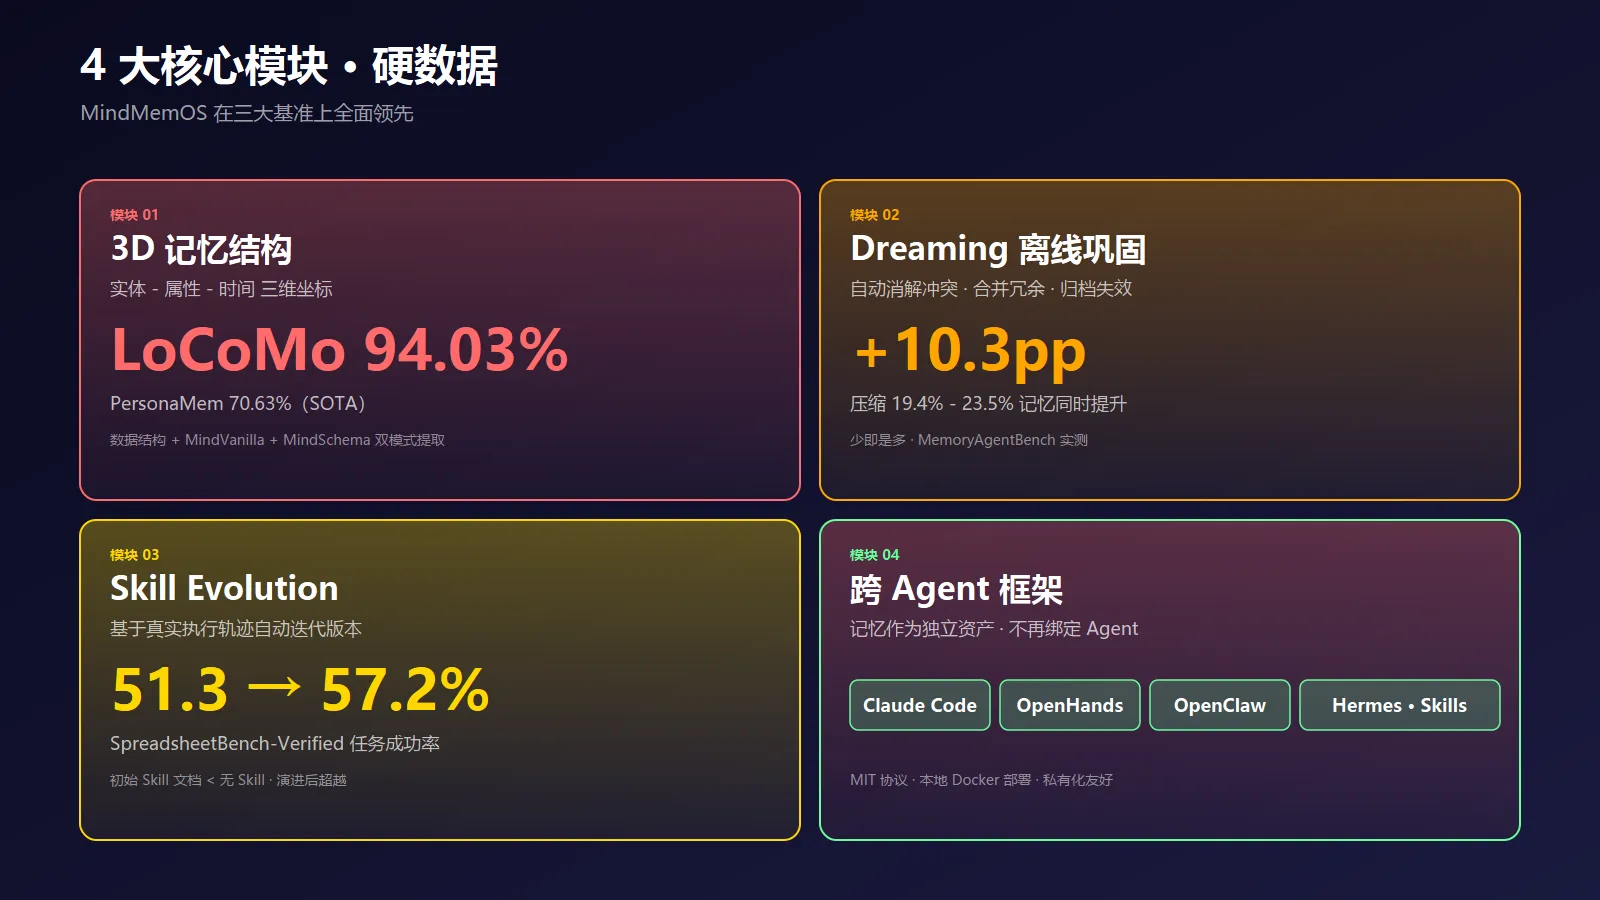
接入层已经支持 OpenClaw、Hermes、Claude Code、OpenHands 等主流 Agent 框架——你的记忆一旦写进去,可以被多个 Agent 复用,不再绑定某一家。
三、和旧方案到底差在哪?
我们拿最常被对比的 4 套方案横向看一遍:
| 维度 | MindMemOS | Mem0 | MemU | Zep | EverOS |
|---|---|---|---|---|---|
| 记忆结构 | 实体-属性-时间三维图,追踪演变 | 文本片段/向量块,扁平 | 树状记忆图 | 时序事件图 | 长期对话记忆 |
| 记忆提取 | MindVanilla + MindSchema 双模式 | 固定模板 | LLM 抽取 | LLM 抽取 | LLM 抽取 |
| 离线整理 | Dreaming 自动消解冲突 | 无 | 无 | 弱 | 弱 |
| 反馈闭环 | 显式 + 隐式反馈,作用于提取/检索 | 仅显式反馈 | 无 | 无 | 无 |
| Skill 演进 | 基于真实轨迹自动演化版本 | 无 | 无 | 无 | 无 |
| 跨 Agent 迁移 | 解耦架构,多框架共享 | 绑定 Mem0 平台 | 弱 | 弱 | 弱 |
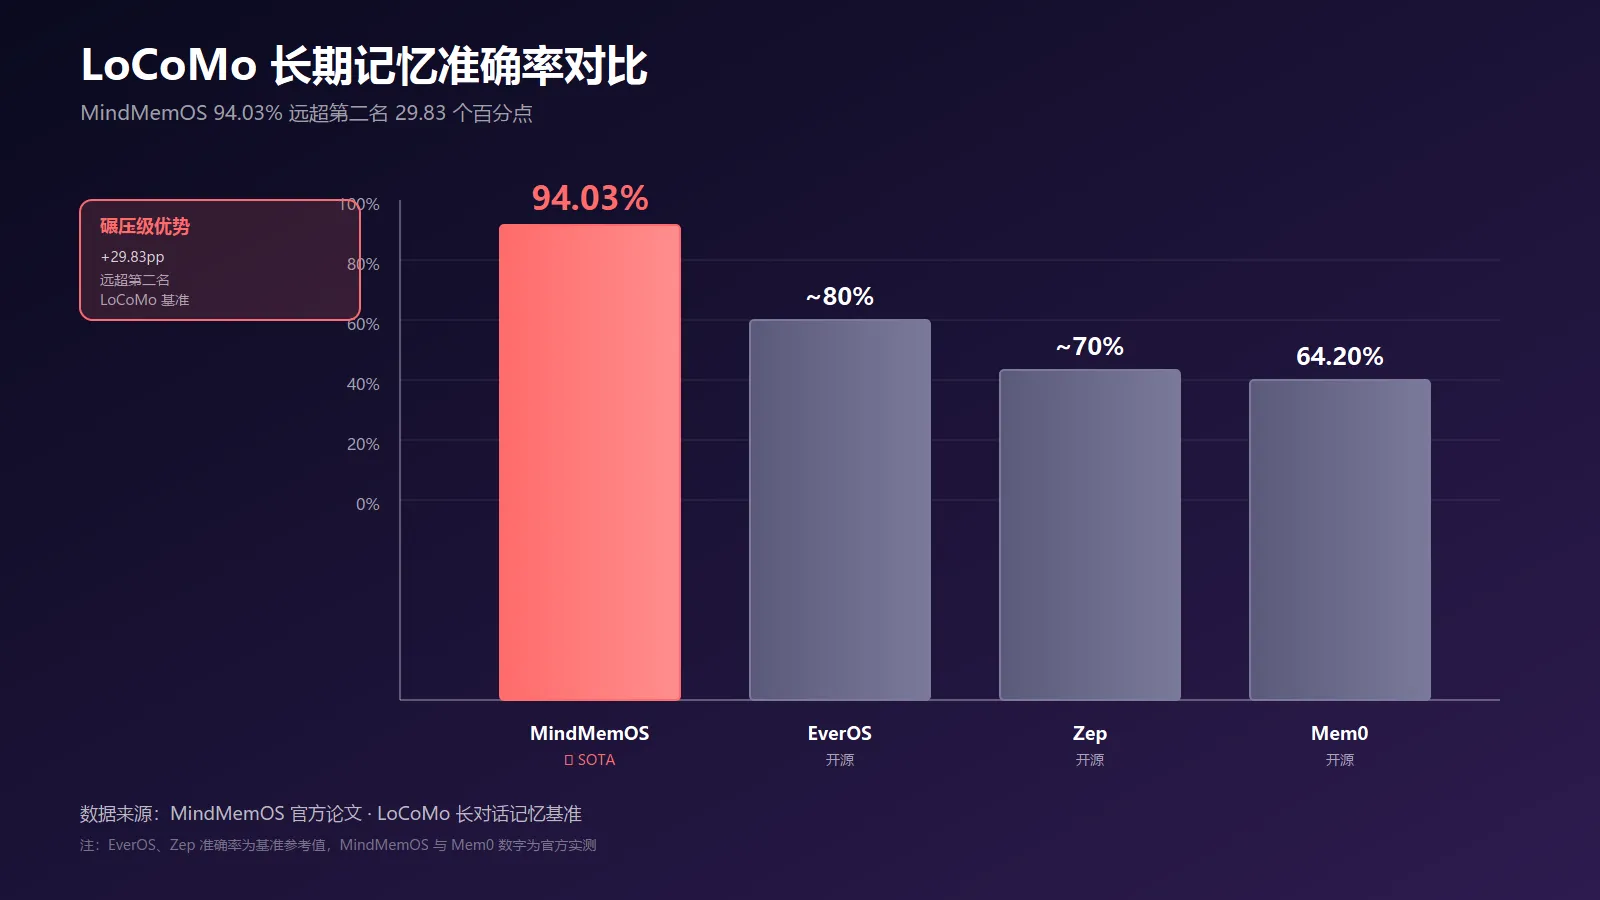
| LoCoMo 准确率 | 94.03% (SOTA) | 64.20% | - | - | 较高 |
| 开源协议 | MIT | MIT | Apache 2.0 | Apache 2.0 | 部分开源 |
一句话总结:传统方案在比"怎么记",MindMemOS 在解决"记完之后怎么办"。
四、四大核心模块拆解
4.1 实体-属性-时间:把记忆从文本升级到时空
传统方案把记忆保存成一段段文本或向量块。MindMemOS 用一个三维结构描述开放世界的信息流:
- 实体(Entity):人、项目、文件、工具、组织等持续存在的对象
- 属性(Property):对象的事实、偏好、状态、高阶特征
- 时间(Time):属性在什么时间成立,又在何时变化
每条记忆都落到这个三维坐标系里的唯一位置,同时保留实体之间的语义关联和属性的演变轨迹。
效果:用户半年前说"我以前喜欢 X"、现在说"我现在用 Y"——在传统系统里是两条互不相关的文本;在 MindMemOS 里是同一实体、同一属性时间轴上的两个事件点。
4.2 Dreaming:让记忆离线"做梦"
记忆越多越要整理,否则检索质量会被噪声拖垮。MindMemOS 提供一个叫 Dreaming 的离线巩固机制:
- 自动识别重复、冲突、演化关系
- 合并冗余条目
- 归档失效版本
- 补充高阶模式
数据效果:在 MemoryAgentBench 的 FactConsolidation 测试中,Dreaming 在压缩 19.4%-23.5% 活跃记忆的同时,把问答准确率最高提升 10.3 个百分点。
少即是多。 这件事在工程上极难——大多数系统压缩记忆后检索质量都掉。
4.3 Feedback:让用户的纠偏信号回流到系统
很多 Agent 跑偏了,用户说"不对,我说的不是这个意思",系统改了当条记忆,下次同样的坑还是踩。
MindMemOS 的 Feedback 机制分两层:
- 显式反馈:用户明确"这条记错了 / 应该升级"
- 隐式反馈:从用户的后续行为里推断信号(重写、跳过、采纳/拒绝)
反馈不仅修改单条记忆,还会反向作用于提取规则和检索策略——系统层面一起调整。
4.4 Skill Evolution:让经验沉淀为规则
最有意思的模块。基于真实执行轨迹,MindMemOS 会自动:
- 抽取成功策略与失败模式
- 生成 Skill 修改计划
- 在"源任务克隆体"上回放验证
- 只保留能改善或至少维持结果的补丁
- 迭代版本号
数据效果:在 SpreadsheetBench-Verified 上,未优化的初始 Skill 反而低于无 Skill 基线(51.3%),而 MindEvolve-Sup 跑出来的版本把任务成功率提升到 57.2% ± 2.4%。
换句话说:随便写的 Skill 文档可能还不如不写;MindMemOS 的演进机制让 Skill 真正"踩过坑、活下来"。
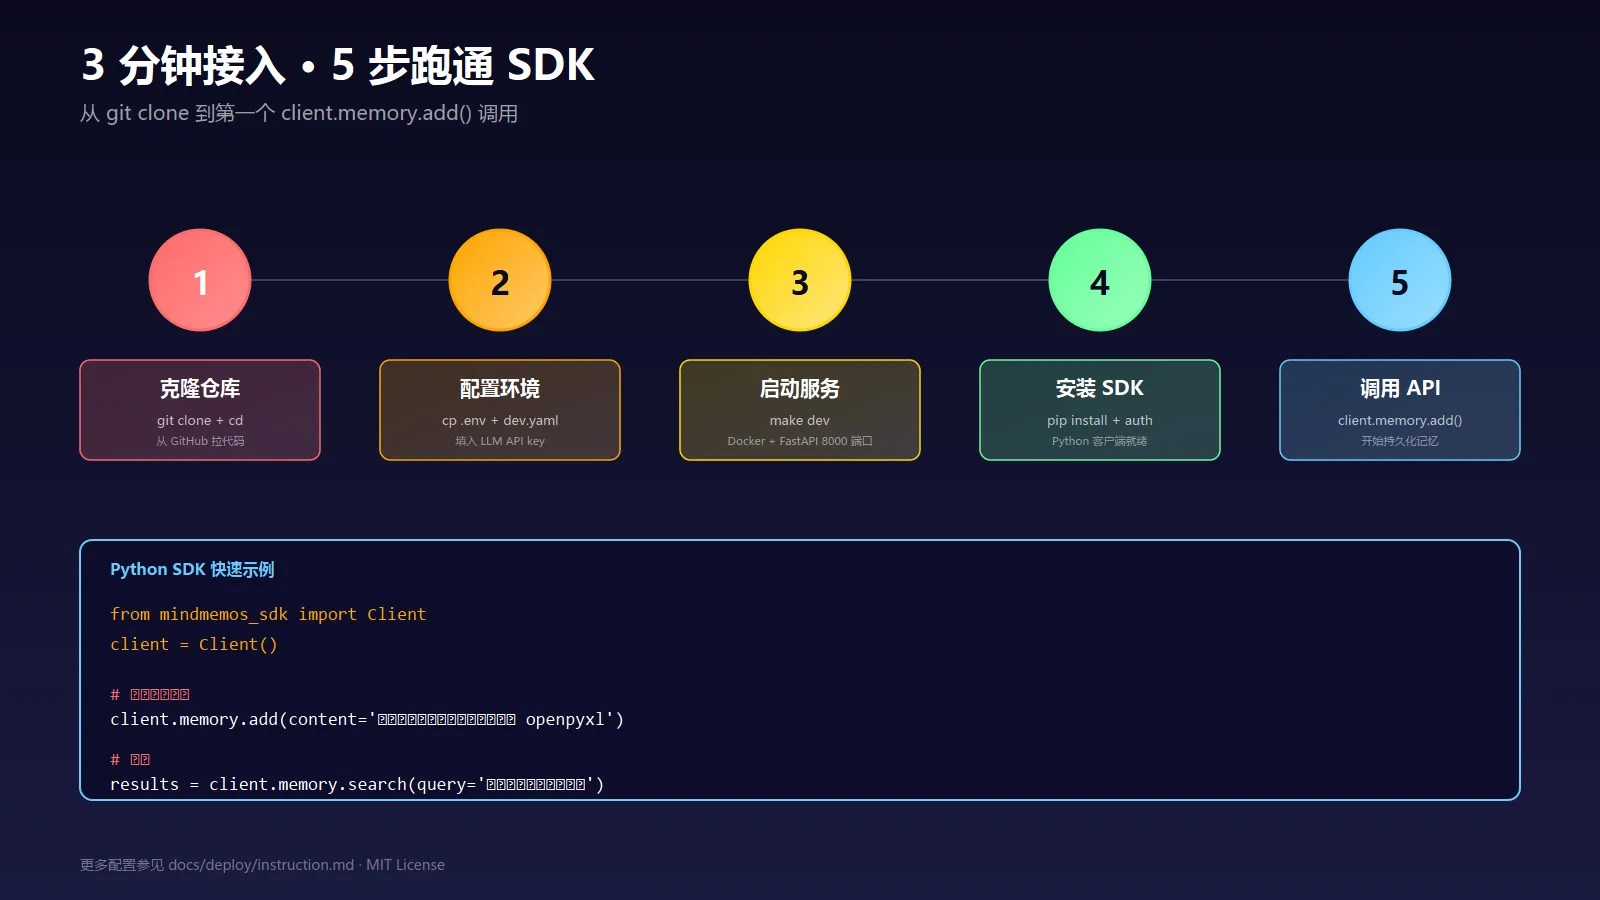
五、3 分钟接入:5 步跑通 SDK
# 1. 克隆仓库
git clone https://github.com/mindscale-noah/MindMemOS.git
cd MindMemOS

# 2. 准备配置
cp .env.example .env
cp config/mindmemos/dev.example.yaml config/mindmemos/dev.yaml
# 编辑 dev.yaml:填入 chat_model_router / embed_model_router 的 API key

# 3. 启动服务(Docker + FastAPI,默认 8000 端口)
make dev

# 4. 安装 SDK
pip install mindmemos-sdk
mindmemos auth  # 配置 base_url / api_key / user_id

# 5. 在你的 Agent 里调用
python -c "
from mindmemos_sdk import Client
client = Client()

# 写入一条记忆
client.memory.add(content='用户偏好:在表格处理中倾向用 openpyxl 而不是 pandas')

# 检索
results = client.memory.search(query='项目里表格用什么库?')
print(results)
"
接入层已经做好 FastAPI HTTP、Python SDK、CLI、OpenClaw 插件四种姿势,挑你最顺手的即可。
六、它最适合什么场景?
| 场景 | 为什么适合 |
|---|---|
| 个性化 AI 助手 | 跨会话保留用户偏好、项目背景、踩坑经验 |
| 多 Agent 协作平台 | 同一记忆库供不同 Agent 框架共享,避免重复养 Agent |
| 自动算法设计(LLM4AD) | 把搜索过程中"哪些方案已试过无效"系统化沉淀 |
| 复杂办公自动化 | 表格/文档处理这类重复性任务,Skill 持续优化执行策略 |
| 长期用户画像构建 | 追踪属性随时间的变化轨迹,支撑个性化推荐 |
反过来,下面这些场景暂时别硬上:
- 对延迟极端敏感(毫秒级)的实时对话系统——三层架构的检索开销需要权衡
- 数据强隔离的多租户场景——目前记忆库共享模型,单租户隔离需要二次开发
- 强监管行业(医疗/金融)的合规审计——Dreaming 的合并逻辑需要审计可见化扩展
七、几个工程上的注意事项
- 外部模型依赖:MindMemOS 的提取/检索/重排都依赖外部 LLM 和 embedding,需要准备好
chat_model_router、embed_model_router、rerank_model_router的 API key。 - Qdrant 维度匹配:
embed_model_router的 embedding 维度必须和 Qdrant 配置一致,否则检索会静默失败。 - Feedback 不要乱开:隐式反馈推断需要谨慎,初次部署建议只开显式反馈,避免错误信号污染记忆。
- Skill 版本管理:Skill Evolution 会自动迭代版本,建议在生产环境同时保留最新 3 个版本以便回滚。
- Dreaming 调度:Dreaming 离线任务比较吃算力,建议放在业务低峰期(如凌晨)跑。
八、重点回顾
- MindMemOS 把记忆从 Agent 内部抽出来,做成可跨框架迁移的独立资产——这是它和 Mem0/Zep 的根本区别。
- 三维"实体-属性-时间"结构解决了"用户偏好演进丢失"这个长期痛点。
- Dreaming 离线巩固做到"少即是多"——压缩 19.4%-23.5% 记忆同时准确率 +10.3 个百分点。
- Skill Evolution 让 Skill 真正"踩过坑、活下来"——初始 Skill 文档 < 无 Skill 基线,演进后才到 57.2%。
- LoCoMo 94.03% 是当前 SOTA,远超 Mem0(64.20%)等同代方案。
- MIT 协议 + 本地 Docker 部署,私有化友好;缺点是外部模型依赖要自己接。
九、延伸阅读
- GitHub 仓库:github.com/mindscale-noah/MindMemOS
- 项目官网:mindmemos.cn
- 部署指南:docs/deploy/instruction.md
- 相关论文:LoCoMo / PersonaMem / SpreadsheetBench-Verified 三大基准
- 同类对比:Mem0(Mem0 Platform)、Zep(Graphiti)、MemU(Memplatform)、EverOS
一句话总结:Agent 时代真正稀缺的,不是更强的模型,而是一套能跨 Agent 流动的记忆操作系统。MindMemOS 是当前最接近这件事的开源答案。