LTX-2
本文目录
📌 核心价值:第一个真正开源的「音视频联合生成」基础模型——4K / 50fps / 最长 20 秒,画面和声音一次出齐
Lightricks(Facetune 母公司)把完整模型权重、训练代码、推理工具全开源,消费级 GPU 就能跑出 4K 影院级片段。
🚀 什么是 LTX-2?
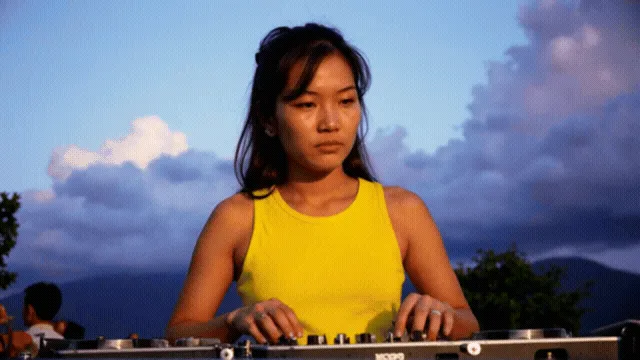
LTX-2 是以色列 AI 公司 Lightricks 在 2026 年 1 月正式开源的下一代音视频生成基础模型,托管在 Lightricks/LTX-Video(仓库同时保留 LTX-Video 老版本,最新主开发页已迁移到 Lightricks/LTX-2)。


它不是又一个「视频模型」,而是当前唯一一个同时满足三个条件的开源方案:
- 真正的 4K——不是把 1080p 后期上采样,DiT 架构原生输出 4K
- 真正的音视频联合——单次推理同步生成画面、对白、环境音、音乐,口型自动对齐
- 真正的开放权重——代码 Apache 2.0,训练数据和权重走 Getty + Shutterstock 授权链路,年收入低于 1000 万美元的公司可免费商用
核心定位:开源阵营里,目前只有 LTX-2 同时拿下 4K + 音视频同生 + 干净授权这三张牌。
整个模型 19B 参数(14B 视频 + 5B 音频),多 GPU 推理栈让生成成本比同类模型最高低 50%。Lightricks 官方发布的新闻稿里,CEO Zeev Farbman 把 LTX-2 定义为「Diffusion models 已经不再模拟生产,它们就是生产」。
✨ 核心功能一览
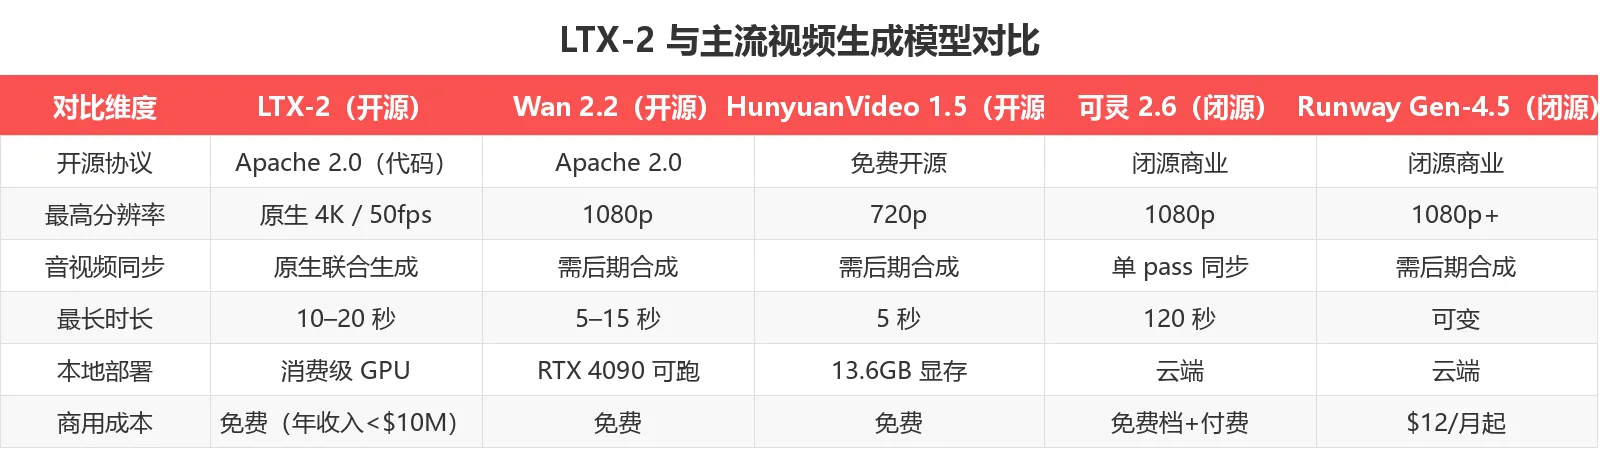
横评里能直接看出 LTX-2 的差异化打法:闭源阵营(可灵 2.6、Runway Gen-4.5、Veo 3.1)贵且不能本地跑;其他开源模型(Wan 2.2、HunyuanVideo 1.5)分辨率锁在 720p–1080p,音频还得后期单独合成。LTX-2 是开源赛道里唯一同时把 4K 和音视频同生打通的模型。
🛠️ 快速上手:5 分钟跑通示例
安装 / 部署
LTX-2 提供三种主流接入方式,覆盖从消费级本地到企业级 API 的全场景:
# 方式 1:ComfyUI(Day-0 原生支持,门槛最低)
git clone https://github.com/comfyanonymous/ComfyUI.git
cd ComfyUI
pip install -r requirements.txt
# 把 LTX-2 权重放到 models/checkpoints/ 后即可在 UI 里直接拖拽工作流

# 方式 2:Diffusers / Python(适合开发者集成)
pip install diffusers transformers accelerate
python -c "
from diffusers import LTX2Pipeline
pipe = LTX2Pipeline.from_pretrained('Lightricks/LTX-2', torch_dtype='bf16')
pipe.to('cuda')
video, audio = pipe(
    prompt='A golden retriever running on a beach at sunset, cinematic',
    negative_prompt='blurry, low quality, distorted',
    height=1080, width=1920, num_frames=121, fps=24
)
"
配置与运行
环境变量只需要 CUDA + NVFP8 量化就能上 24GB 显存的消费级显卡(推荐 RTX 4090 / 5090 32GB)。Lightricks 官方给的硬件对照表:
| 显存 | 可生成规格 |
|---|---|
| 24 GB (RTX 4090) | 720p,约 4 秒 |
| 32 GB (RTX 5090) | 1080p,约 8 秒 |
| 48 GB+ (A6000 / 多卡) | 原生 4K / 50fps,10–20 秒 |
注意:开启 audio=True 时,显存峰值会多占约 3–4 GB;如果 OOM,把 num_frames 从 121 降到 97。
💡 适用场景
场景 1:图生视频(Image-to-Video)
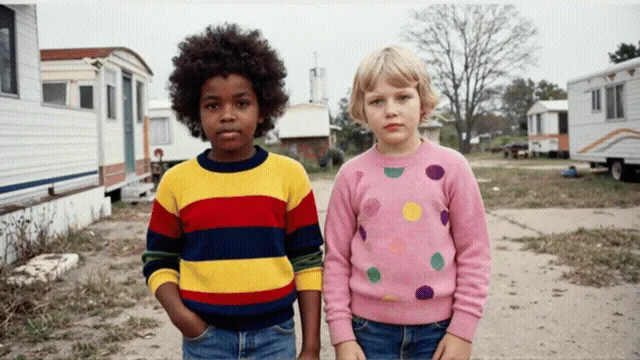
功能说明:给一张静帧参考图,LTX-2 自动补全运镜、动作和环境动态。首尾帧一致性问题在 DiT 架构下被天然压制,输出的片段没有「图一图二」的违和感。
输入要求:单张参考图 + 文本动作描述(建议英文 prompt)。
输出效果:4 秒左右、1080p 的连贯短视频,主体保持参考图的身份和构图。
适用场景:电商主图动效、产品概念演示、社交媒体素材。
场景 2:多关键帧可控生成(IC-LoRA)
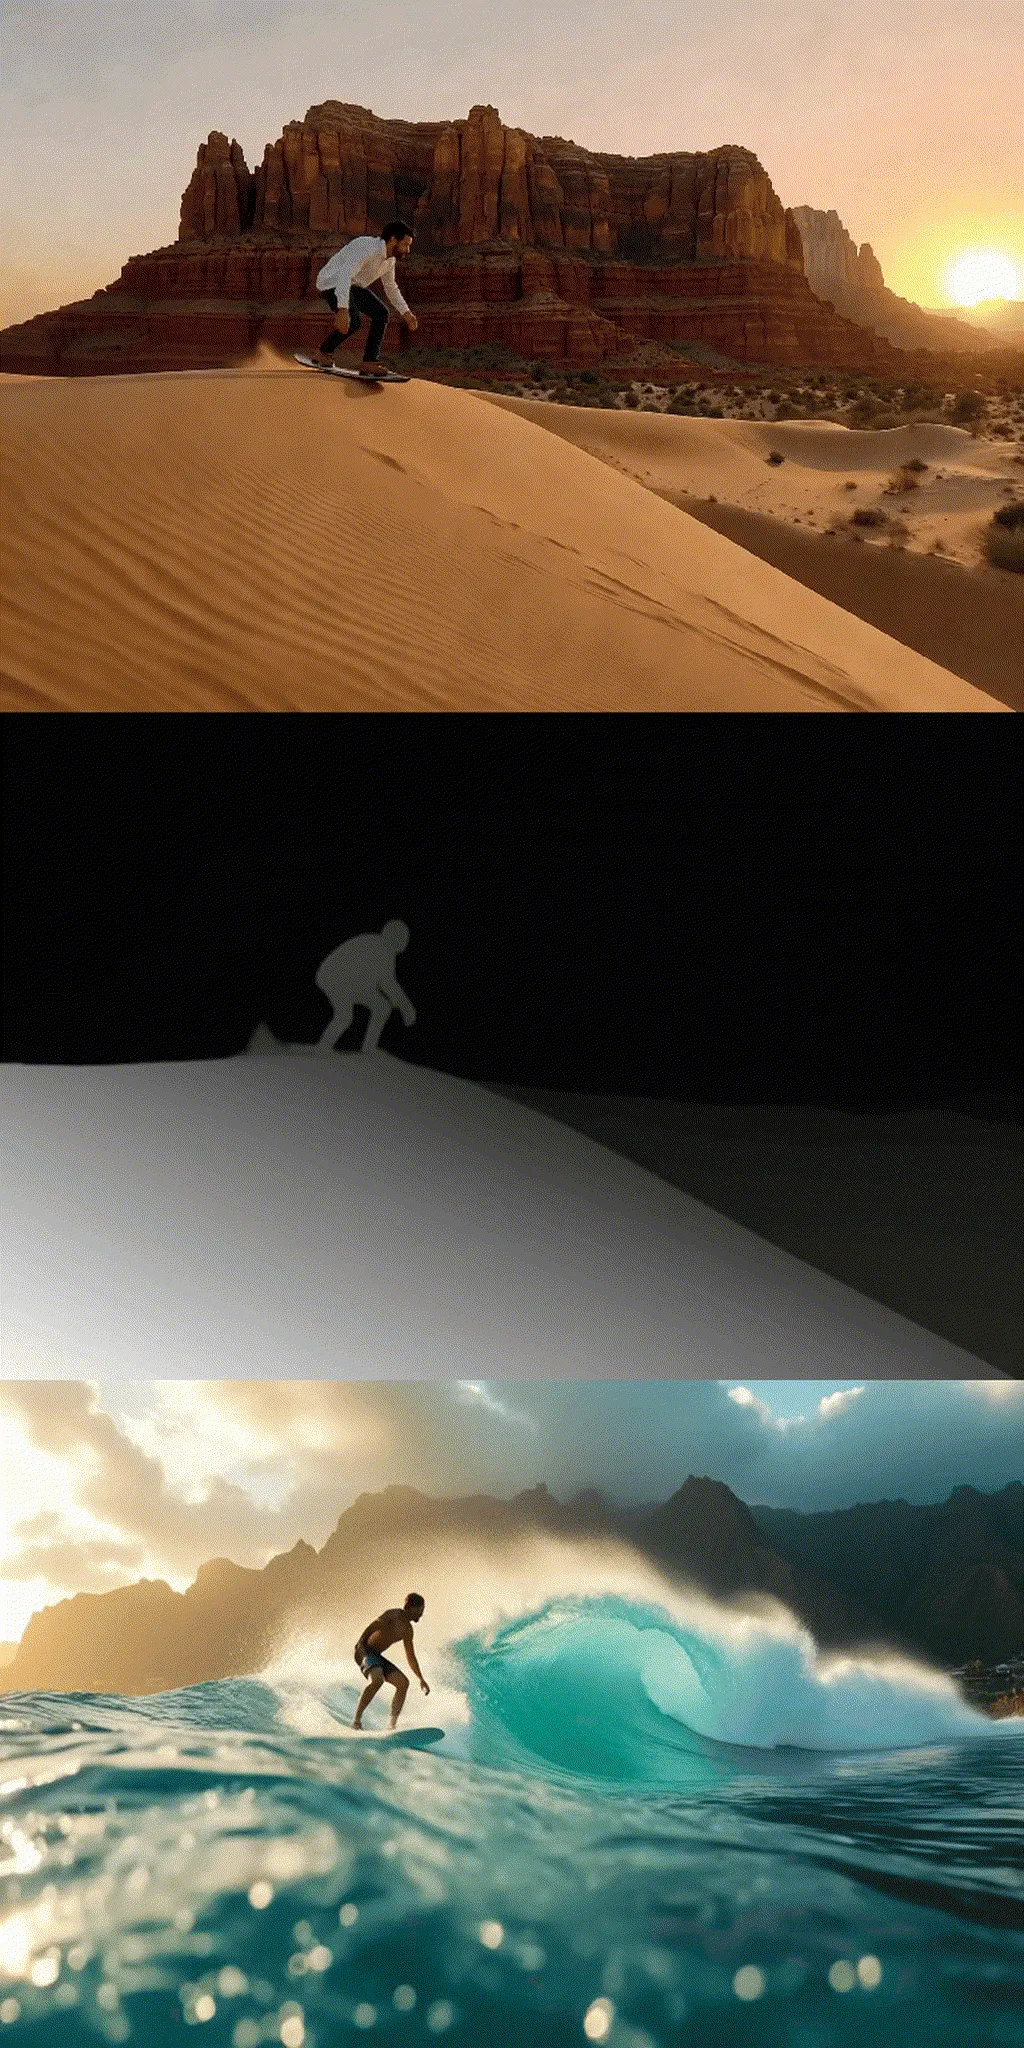
功能说明:通过多关键帧(multi-keyframe)+ IC-LoRA 控制,LTX-2 能严格遵循预设的相机轨迹和姿态变化。控制信号支持深度图、姿态骨架、Canny 边缘三种主流条件输入。
输入要求:起止关键帧 + 可选深度/姿态/Canny 控制图 + 文本风格描述。
输出效果:运镜可控、角色动作可锁定的 4–10 秒视频,适合需要精确分镜的创作流程。
适用场景:广告分镜、动画预演、需要多镜头一致性的短剧脚本。
场景 3:长片段 4K 输出
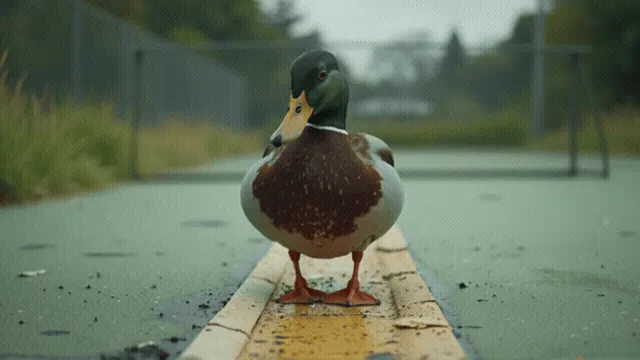
功能说明:LTX-2 在原生 4K 下能稳定输出 10 秒连续片段,部分场景可达 20 秒。这是开源模型第一次把 4K 时长拉到「可直接进剪辑软件」的水平。
输入要求:高显存(48GB+)或多 GPU 推理栈;prompt 尽量具体到镜头、景别、光线方向。
输出效果:3840×2160 / 50fps 的视频流,可直接对接 DaVinci Resolve、Premiere 等专业剪辑流程。
适用场景:品牌广告、TVC 短片、影视概念验证。
场景 4:人物对白与口型同步
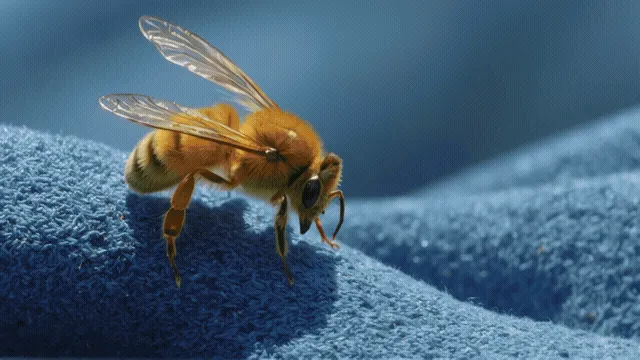
功能说明:联合音视频模块的杀手锏——人物说话时口型、表情、环境音会自动对齐,不需要单独跑 Wav2Lip、SyncLabs 这类后期工具。
输入要求:参考图 + 文本台词(英文效果最好,中文可通过 audio_prompt 描述语气)。
输出效果:带同步对白和环境音的 5–10 秒角色片段。
适用场景:数字人短视频、播客视觉化、客服机器人演示。
场景 5:深度图与姿态控制
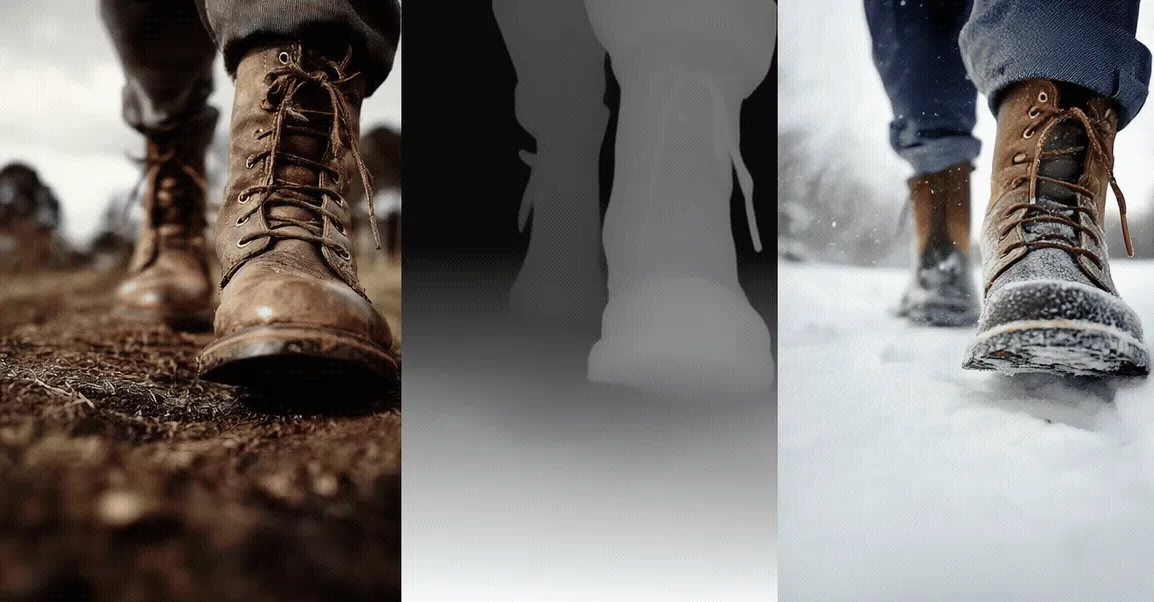
功能说明:通过 IC-LoRA 加载深度或姿态控制信号,LTX-2 能把单张参考图「活化成」指定相机轨迹下的连续视频。控制强度可通过 control_scale 参数调节。
输入要求:参考图 + 深度图(MiDaS / Depth Anything 预生成)+ 文本风格描述。
输出效果:相机运动精确可控的短视频,可与实拍素材无缝拼接。
适用场景:VFX 预演、电影分镜、AR/VR 素材生成。
用户群体总结
- ✅ 独立创作者 / 短视频团队:4K + 音视频同生,免去后期对齐工作流
- ✅ 广告与品牌方:Apache 2.0 + 授权训练数据,商用合规风险低
- ✅ 影视前期 / 概念设计:多关键帧 + 深度控制可快速验证镜头语言
- ✅ AI 开发者:Diffusers / ComfyUI / API 三种接入方式,灵活集成
- ❌ 不适合:纯 2K 以下快速批量出片的流水线(用 Wan 2.2 更省显存)
💰 定价与开源协议
LTX-2 采用双层授权:
| 用途 | 费用 |
|---|---|
| 学术研究 | 完全免费 |
| 商业使用(年收入 < $10M) | 完全免费 |
| 商业使用(年收入 ≥ $10M) | 需购买商业授权(与 Lightricks 签约) |
| API 调用(Fast / Pro / Ultra) | $0.04 / $0.08 / $0.16 每秒视频 |
| 自托管(Fal / Replicate / OpenArt) | 各平台定价,含免费额度 |
💡 新用户福利:年收入 1000 万美元以下的公司可零费用商用,对国内中小团队和独立创作者基本是「白嫖级」友好。
代码协议: Apache 2.0 模型权重: OpenRail-M 风格 + 商业分层授权
🎯 总结
LTX-2 把「开源视频模型」的天花板从 1080p 拉到了原生 4K,又把「音视频对齐」从后期工序变成了推理里的一行 audio=True。对于个人创作者和中小团队,这是 2026 年最值得本地部署的开源视频模型;对于企业级用户,它的 Apache 2.0 + 授权训练数据链路让商用合规风险显著低于同类开源方案。
如果你只想跑一次试试,推荐从 ComfyUI 工作流 起步;如果你是开发者,直接走 Diffusers 集成最快;如果需要 API,LTX 官网和 Fal / Replicate 都能拿到端点。
推荐指数: ⭐⭐⭐⭐⭐(满分 5 星,开源视频生成 2026 年的标杆)
适合人群: 短视频创作者 / 广告团队 / 影视前期 / AI 开发者 / 数字人方向研究者
立即体验: LTX-2 官网 | GitHub 仓库 | HuggingFace 权重
数据截至 2026-08-27,最新信息请以官网为准。