LocalRAG
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../local-rag-recommend.pptx../../local-rag-recommend.mp4本文目录
📌 核心价值:把文件、仓库、网页灌进本地 RAG 知识库,问答全程不出网
LocalRAG 是一个离线开源检索增强生成工具。它用本地 Ollama 大模型 + 本地向量索引,让企业文档、GitHub 仓库、网页都在你机器上完成"问答",聊天、嵌入、源文档全程不出网络。
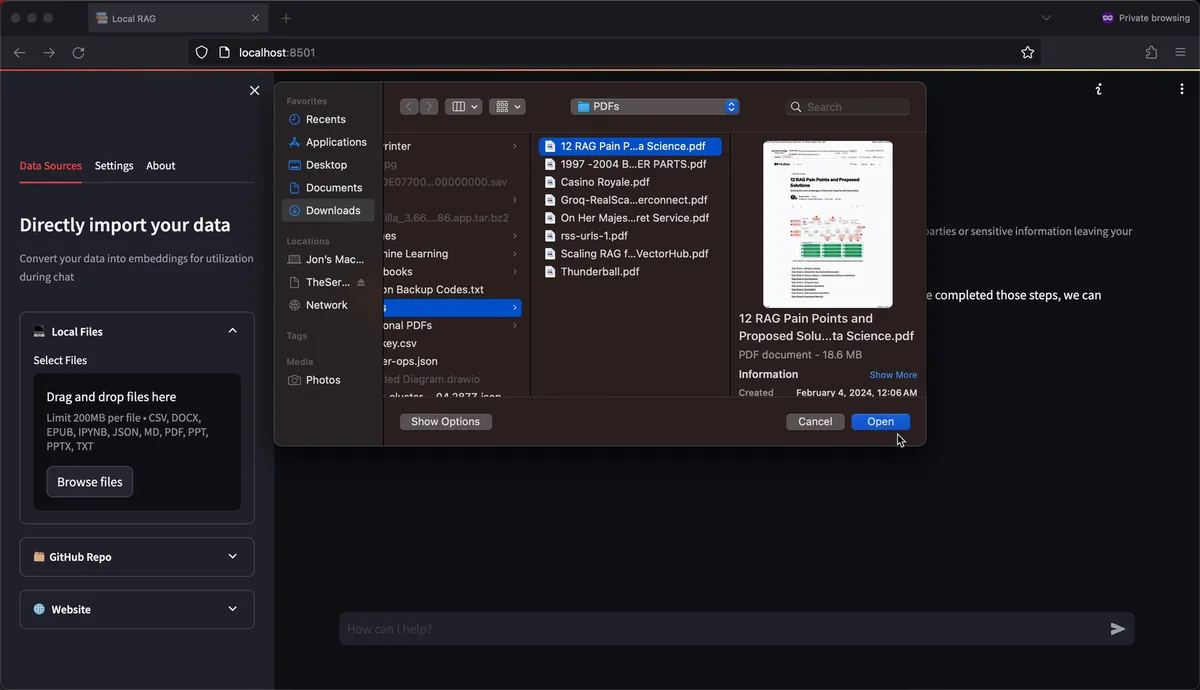
🚀 什么是 LocalRAG?
LocalRAG(GitHub:jonfairbanks/local-rag,761 星,GPL-3.0,2026-09-18 仍有提交)把"本地大模型 + RAG"做成了一个开箱即用的桌面应用。它的核心命题很明确:你不想把敏感文件丢到云端 API,但又想让大模型帮你查文档。LocalRAG 把聊天模型、嵌入模型、索引库、源文件全部留在本机或内网,用 LlamaIndex 做检索、用本地 Ollama 模型生成答案。
核心定位:离线、开源、全本地——数据主权在自己手里


✨ 核心功能一览
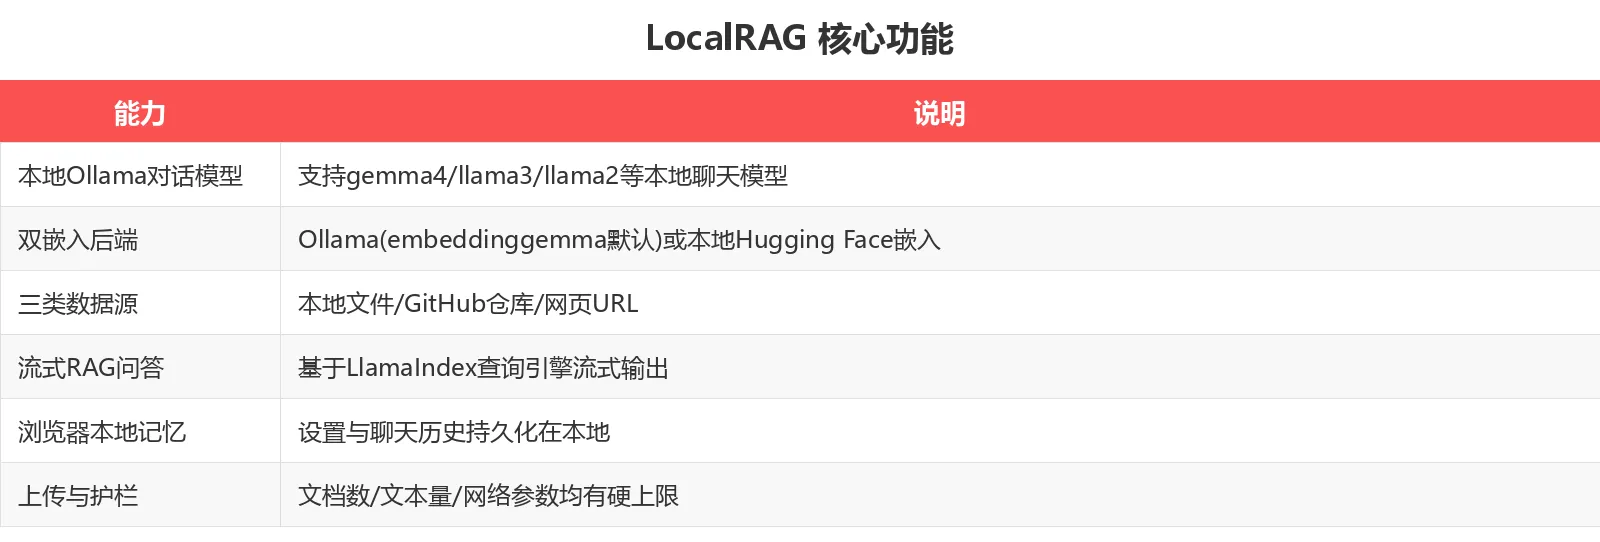
| 能力 | 说明 |
|---|---|
| 本地 Ollama 对话模型 | 支持 gemma4:latest、llama3:8b、llama2:7b 等本地聊天模型 |
| 双嵌入后端 | Ollama 嵌入(默认 embeddinggemma)或本地 Hugging Face 嵌入 |
| 三类数据源 | 本地文件、GitHub 仓库、网页 URL |
| 流式 RAG 问答 | 基于 LlamaIndex 查询引擎流式输出 |
| 浏览器本地记忆 | 设置与历史持久化在浏览器本地 |
| 上传/仓库/网页护栏 | 文档数、文本量、网络参数都有硬上限 |
🛠️ 快速上手:5 分钟跑通示例
安装 / 部署
前提:本机已起 Ollama(默认端口 11434),并拉一个聊天模型和一个嵌入模型。
# 1) 拉本地模型(聊天 + 嵌入)
ollama pull gemma4:latest
ollama pull embeddinggemma

# 2) 用 pip 安装(官方推荐 pipenv)
pip install -r requirements.txt
# 或 pipenv install

# 3) 启动 Web 应用(Streamlit)
streamlit run main.py
容器化部署则一行即可:
docker compose up -d
容器默认跑在 8501 端口,配 read-only 文件系统与 GPU 资源限制。
提示:官方文档建议 Linux 宿主。Windows 用户可用 WSL,但尚未经过官方测试。
核心代码示例
RAG 的"九步流水线"是整个项目的骨架,本地化运行就是不断循环"索引 → 检索 → 生成"。用 LlamaIndex 搭一个最小查询引擎,核心是四件事:选模型、配嵌入、加载文档、建查询引擎。
# 概念等价于 local-rag 的内部流水线
# 1. 初始化本地聊天模型
llm = OllamaChatModel(model="gemma4:latest")

# 2. 初始化嵌入后端(Ollama 或 HuggingFace)
embeddings = OllamaEmbeddings(model="embeddinggemma")

# 3. 加载文档:本地文件 / 仓库 / 网页
docs = load_documents(source="local_files_or_repo_or_url")

# 4. 分块 + 向量化 + 建查询引擎
query_engine = build_query_engine(
    docs,
    chunk_size=1000,
    chunk_overlap=200,
    top_k=5,
)

# 5. 问答(流式)
for token in query_engine.stream("这个仓库的核心模块有哪些?"):
    print(token, end="", flush=True)
🧠 RAG 九步流水线
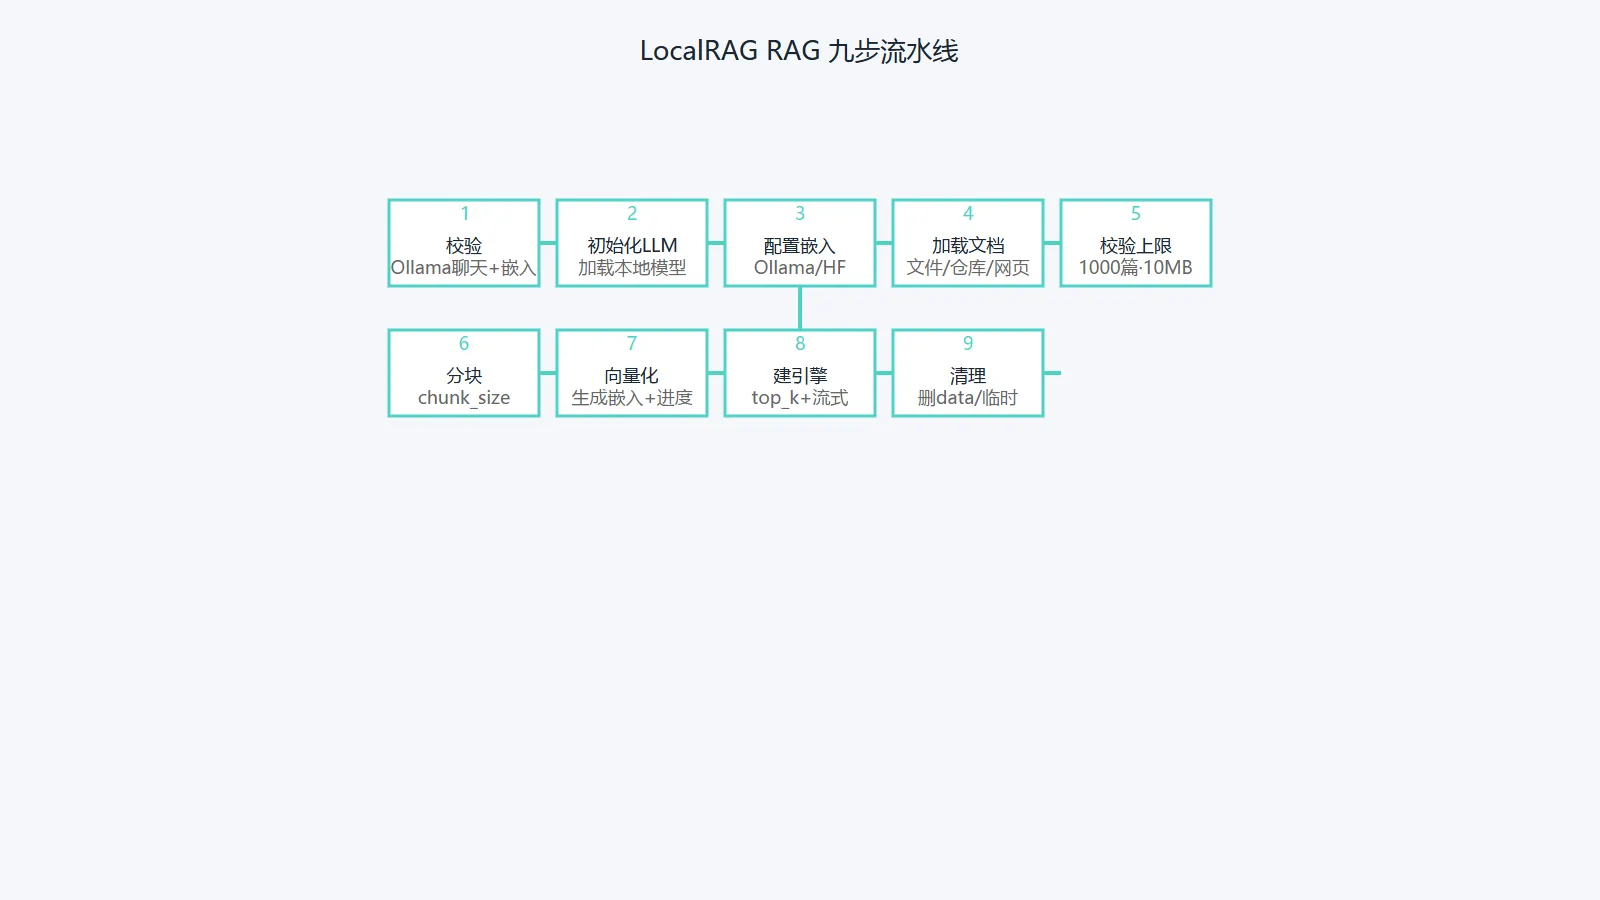
LocalRAG 每次只从一个数据源在内存中构建一套 LlamaIndex 查询引擎(本地文件 / 仓库克隆 / 网页抓取),流程是:
- 校验当前 Ollama 聊天模型与嵌入设置;
- 初始化所选 Ollama 聊天模型;
- 配置嵌入后端(Ollama 或本地 Hugging Face);
- 加载文档:文件与仓库用
SimpleDirectoryReader,网页走带护栏的抓取再转文本; - 校验摄入上限:最多 1000 篇文档、最多 10 MB 源文本;
- 分块:按
chunk_size与chunk_overlap切分; - 向量化:生成嵌入并实时显示索引进度;
- 建引擎:用
top_k与 response mode 创建流式查询引擎; - 清理:删掉
data/下的临时摄入文件。
Streamlit 会把"已完成"的阶段存在会话状态里,重跑可显示当前进度而不重复处理没变的东西。
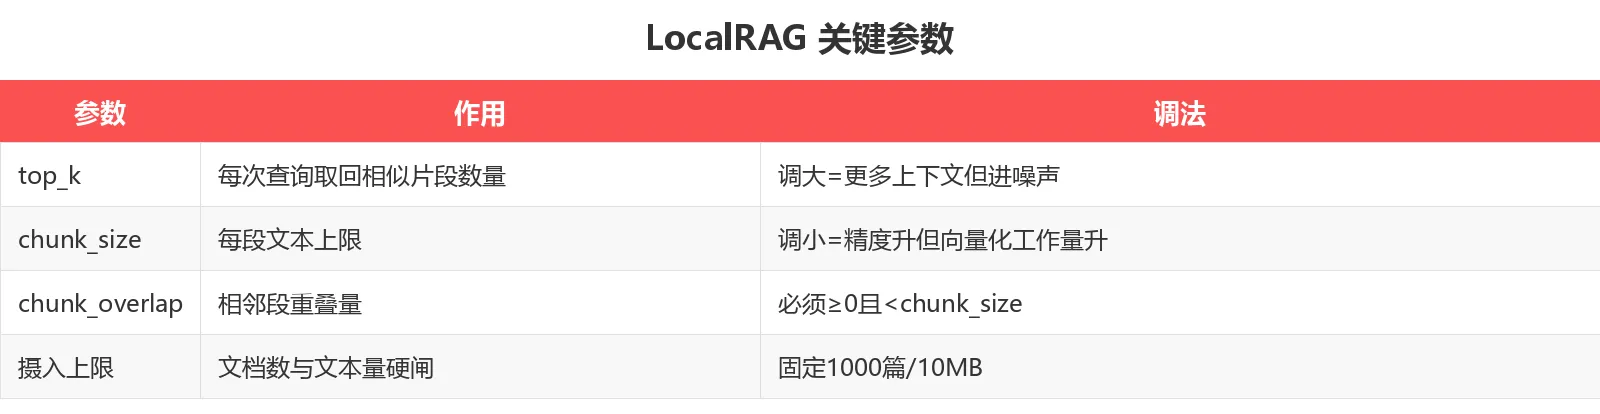
⚙️ 可调的关键参数
| 参数 | 作用 | 调大/调小 |
|---|---|---|
top_k |
每次查询取回相似片段数量 | 调大给更多上下文但可能进噪声 |
chunk_size |
每段文本上限 | 调小提高精度但增加向量化工作量 |
chunk_overlap |
相邻段重叠量 | 必须 ≥0 且 < chunk_size |
| 摄入上限 | 文档数、文本量硬闸 | 固定 1000 篇 / 10 MB |
参数说明:chat_mode 当前 UI 默认 compact,高级项里可关但不可改。
📊 与竞品/同类方案对比
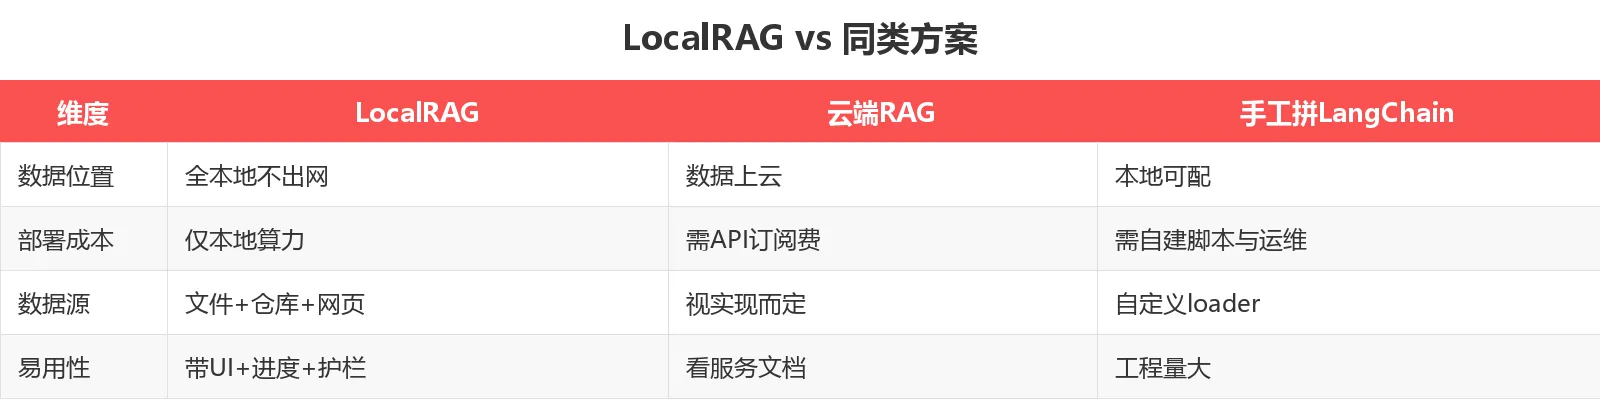
LocalRAG 的差异化不在"能连云 API",而在全本地 + 三类源 + 护栏:相比纯云端 RAG,它把模型与索引都拉回本机;相比手工拼 LangChain 教程,它自带 Streamlit UI、设置持久化与聊天导出。对"文件不能上云"的场景(合同、研报、内部 wiki、代码库),这正是它的定位。
💡 适用场景
场景一:本地文件问答
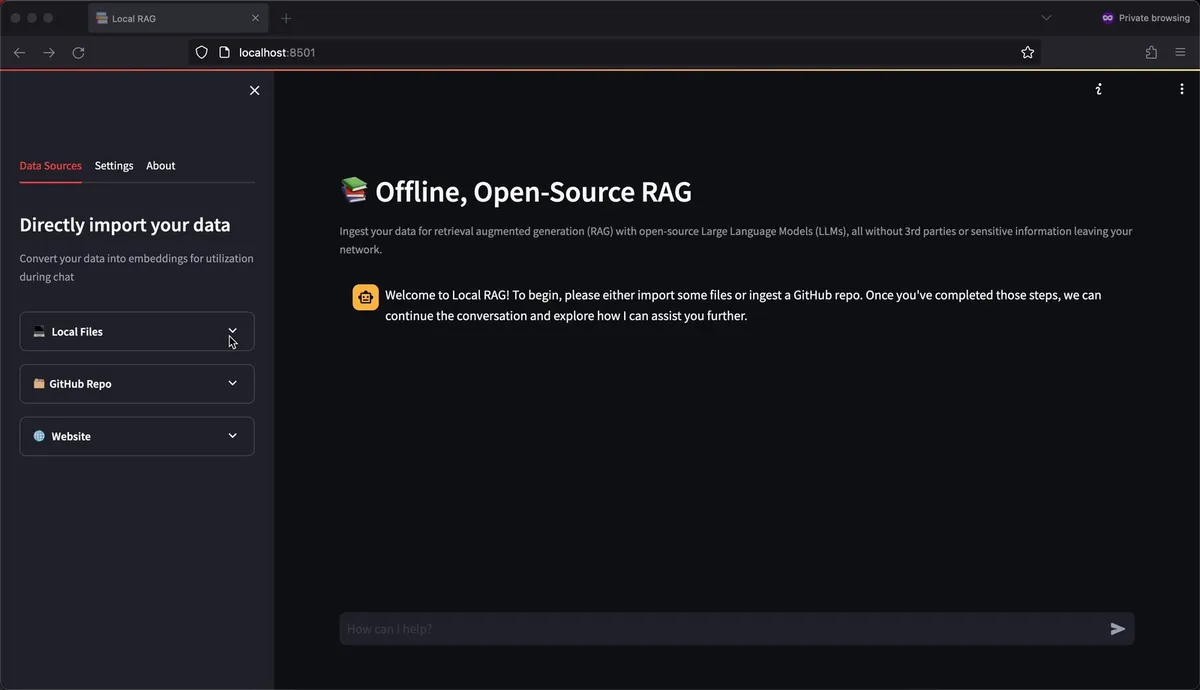
功能说明:把合同、报告、内部文档批量导入,建立本地索引。问答时只取回相关片段,答案附上下文来源。 输入要求:本地文件目录或上传文件;Ollama 已起并拉了聊天 + 嵌入模型。 输出效果:流式返回基于源文档的答案,可导出聊天历史。 适用场景:法务查合同条款、研究员查自有资料、财务查内部制度。
场景二:GitHub 仓库问答
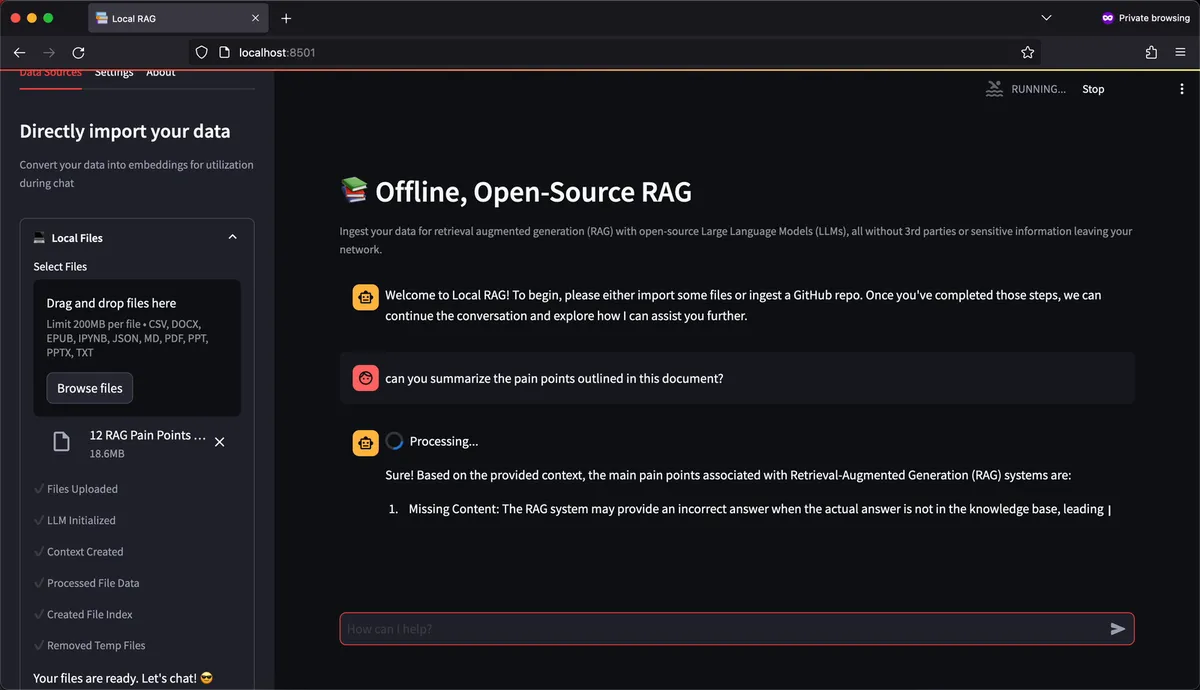
功能说明:直接给仓库地址,它克隆仓库、用 SimpleDirectoryReader 读代码与文档,建索引。
输入要求:可访问的仓库 URL;满足摄入上限。
输出效果:对代码库做"这段怎么实现""哪个模块管这个"式提问。
适用场景:接手陌生代码库、读开源项目、给团队做新人引导。
场景三:网页 + 文档混合知识库
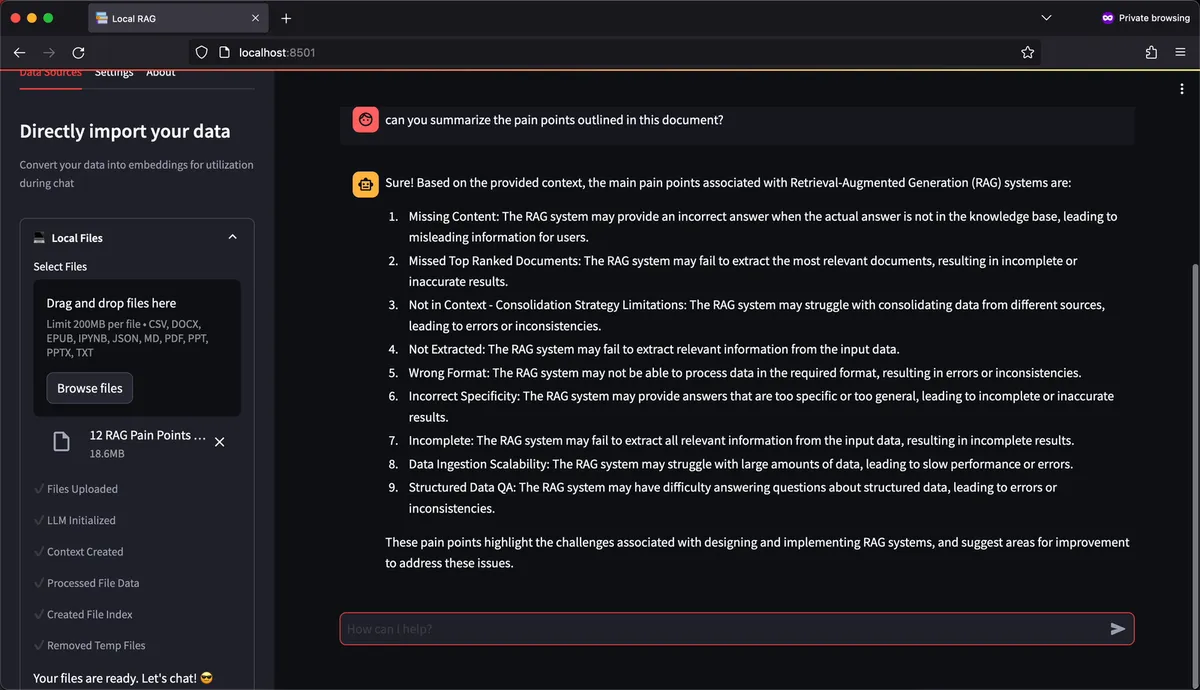
功能说明:对网页设请求大小、重定向、内容类型与网络护栏,转成文本后再入索引。 输入要求:公开 URL;遵守抓取护栏。 输出效果:混合本地文件与公开网页的跨源问答。 适用场景:竞品公开资料、技术文档 + 自有文档混合检索。
用户群体总结
- ✅ 数据敏感的行业:文件、代码、报告不能上云
- ✅ 本地模型玩家:已有 Ollama,想要一键 RAG 桌面端
- ✅ 代码库上手:快速理解陌生仓库
- ❌ 不适合:需要云端大模型实时能力、多人协同编辑、复杂多租户 SaaS 的场景
💰 定价方案
完全开源,GPL-3.0 协议。无订阅、无 API 费用——真正的成本是跑本地模型的算力(GPU/显存)。对"数据主权"有硬要求的团队,省下的第三方调用与存储费用是隐性回报。
开源协议: GPL-3.0
新用户福利:本地免费跑,Docker 一行起服务,端口 8501 即用。
🎯 总结
LocalRAG 把"本地大模型 + RAG"从一堆拼起来的脚本,收束成一个带 UI、带护栏、带进度展示的桌面工具。它不追求接满云 API,而是反向做减法:聊天、嵌入、索引、源文件全本地,答案有出处,数据不出网。对把文档、代码、网页变成"可问答的本地知识库"的人,这是一个零费用、可自托管的起点。
推荐指数: ⭐⭐⭐⭐(满分 5 星)
适合人群:数据敏感行业、本地模型玩家、需要理解陌生代码库的工程师。
GitHub 仓库: jonfairbanks/local-rag
本文仅作技术交流,不构成投资建议。股市有风险,投资需谨慎。 数据截至 2026-09-21,最新信息请以官网为准。