【今日推荐 LingBot-Map】:流式3D重建基础模型,20FPS实时将视频变3D世界!
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../lingbot-map-recommend.pptx../../lingbot-map-recommend.mp4本文目录
【今日推荐 LingBot-Map】:流式3D重建基础模型,20FPS实时将视频变3D世界!
前馈式3D重建基础模型,无需迭代优化,单次推理即可从流式数据中重建完整3D场景。5天斩获 2,700+ Stars,引爆计算机视觉圈。
🚀 什么是 LingBot-Map?
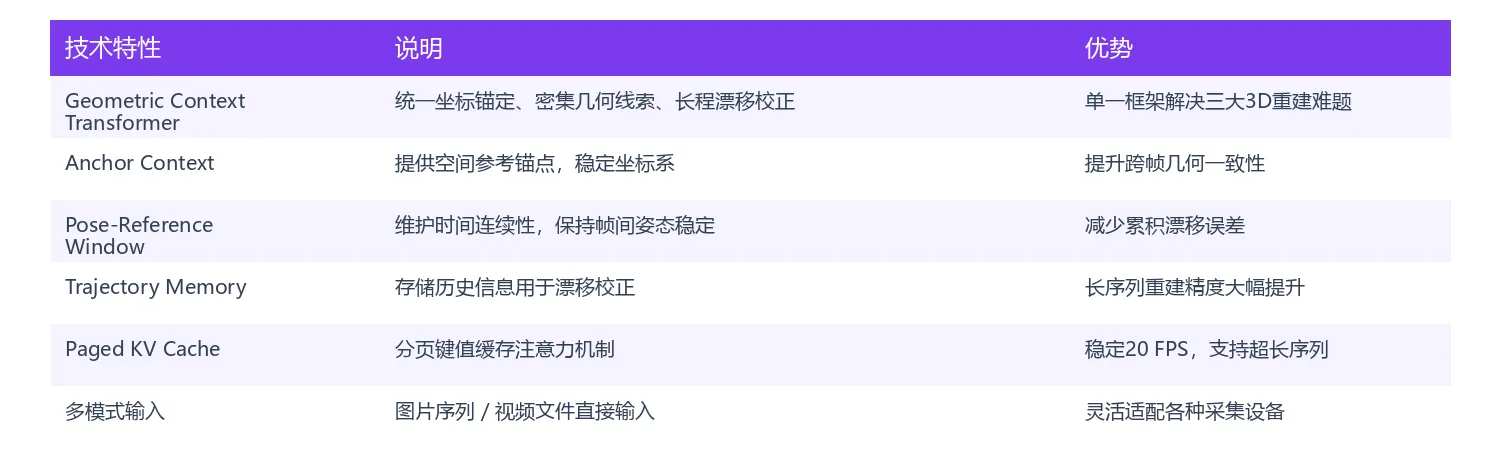
LingBot-Map 是一个由 Robbyant 团队开源的 3D 场景重建基础模型,它提出了 Geometric Context Transformer 架构,在单一前馈式框架中统一解决了 3D 重建的三大难题:坐标锚定、密集几何线索提取和长程漂移校正。
传统的 3D 重建方法(如 Gaussian Splatting、NeRF)需要反复迭代优化,耗时数分钟甚至数小时。而 LingBot-Map 采用前馈式架构,以约 20 FPS 的速度实时重建 3D 场景,支持超过 10,000 帧的超长序列。


核心定位:首个在速度和精度上同时超越迭代优化方法的前馈式 3D 重建基础模型
✨ 核心技术一览
🛠️ 快速上手:5 分钟跑通示例
安装
# 创建 Conda 环境
conda create -n lingbot-map python=3.10 -y
conda activate lingbot-map

# 安装 PyTorch(CUDA 12.8)
pip install torch==2.9.1 torchvision==0.24.1 --index-url https://download.pytorch.org/whl/cu128

# 安装 LingBot-Map
pip install -e .

# 安装 FlashInfer(推荐,提升流式推理效率)
pip install flashinfer-python -i https://flashinfer.ai/whl/cu128/torch2.9/
下载预训练模型
# 从 HuggingFace 下载模型
huggingface-cli download robbyant/lingbot-map --local-dir ./checkpoints/lingbot-map
核心代码示例
# 从图片序列重建3D场景
python demo.py --model_path ./checkpoints/lingbot-map/checkpoint.pt \
    --image_folder example/church --mask_sky

# 从视频文件重建3D场景
python demo.py --model_path ./checkpoints/lingbot-map/checkpoint.pt \
    --video_path video.mp4 --fps 10

# 长序列窗口推理(>3000帧)
python demo.py --model_path ./checkpoints/lingbot-map/checkpoint.pt \
    --video_path long_video.mp4 --fps 10 \
    --mode windowed --window_size 128
注意:推荐安装 FlashInfer 以获得最佳性能。如果未安装,可通过 --use_sdpa 参数使用 PyTorch 原生注意力作为后备方案。
低显存模式
# 将逐帧预测卸载到CPU
python demo.py --model_path ./checkpoints/lingbot-map/checkpoint.pt \
    --image_folder ./images/ --offload_to_cpu

# 减少双向缩放帧数(从8减到2)
python demo.py --model_path ./checkpoints/lingbot-map/checkpoint.pt \
    --image_folder ./images/ --num_scale_frames 2

# 更快推理(跳过3次优化迭代)
python demo.py --model_path ./checkpoints/lingbot-map/checkpoint.pt \
    --image_folder ./images/ --camera_num_iterations 1
💡 架构解析:Geometric Context Transformer
LingBot-Map 的核心创新在于提出了 Geometric Context Transformer,一个统一处理三大 3D 重建难题的 Transformer 架构:
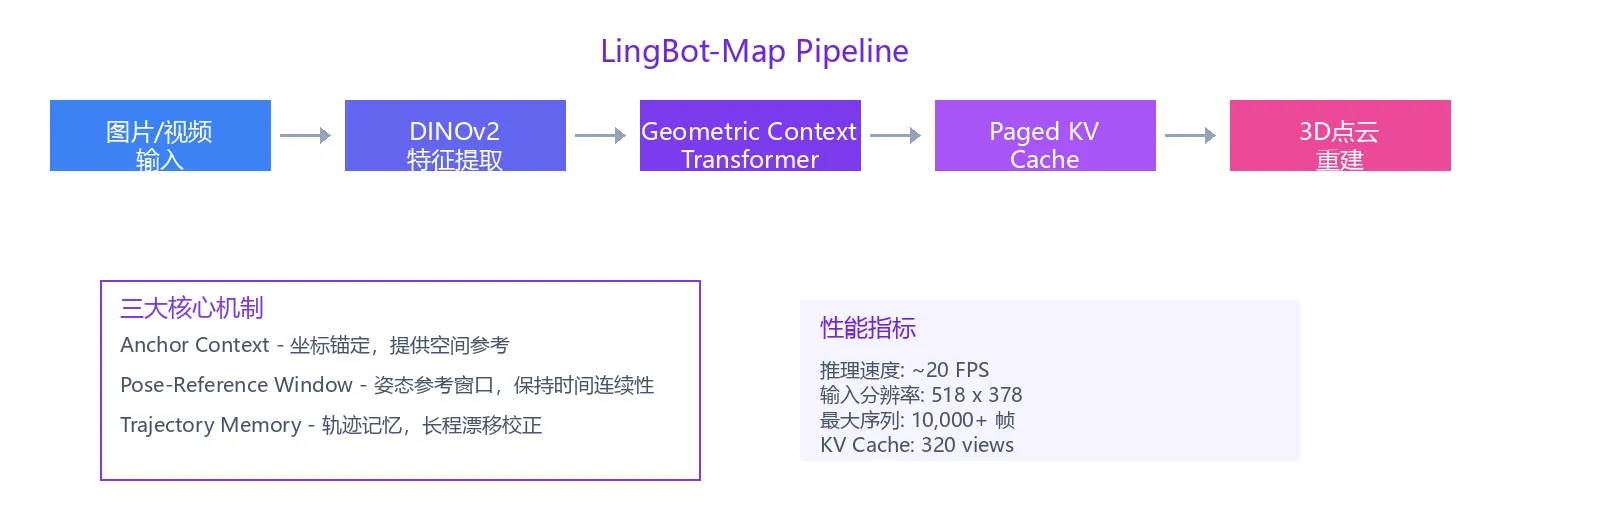
三大核心机制
1. Anchor Context(锚点上下文)
- 提供空间参考锚点,稳定 3D 坐标系
- 类似"地图上的固定地标",为每一帧提供可靠的空间定位
2. Pose-Reference Window(姿态参考窗口)
- 维护帧间时间连续性,保持相机姿态稳定
- 解决传统方法中相机位姿估计漂移的问题
3. Trajectory Memory(轨迹记忆)
- 存储历史轨迹信息,实现长程漂移校正
- 这是 LingBot-Map 能处理 10,000+ 帧超长序列的关键
为什么选择前馈式?
传统 3D 重建的迭代优化方法存在三大痛点:
| 痛点 | 迭代优化 | LingBot-Map |
|---|---|---|
| 速度 | 数分钟到数小时 | 20 FPS 实时 |
| 序列长度 | 数百帧 | 10,000+ 帧 |
| 泛化性 | 需要场景微调 | 基础模型直接推理 |
📊 与主流方法对比
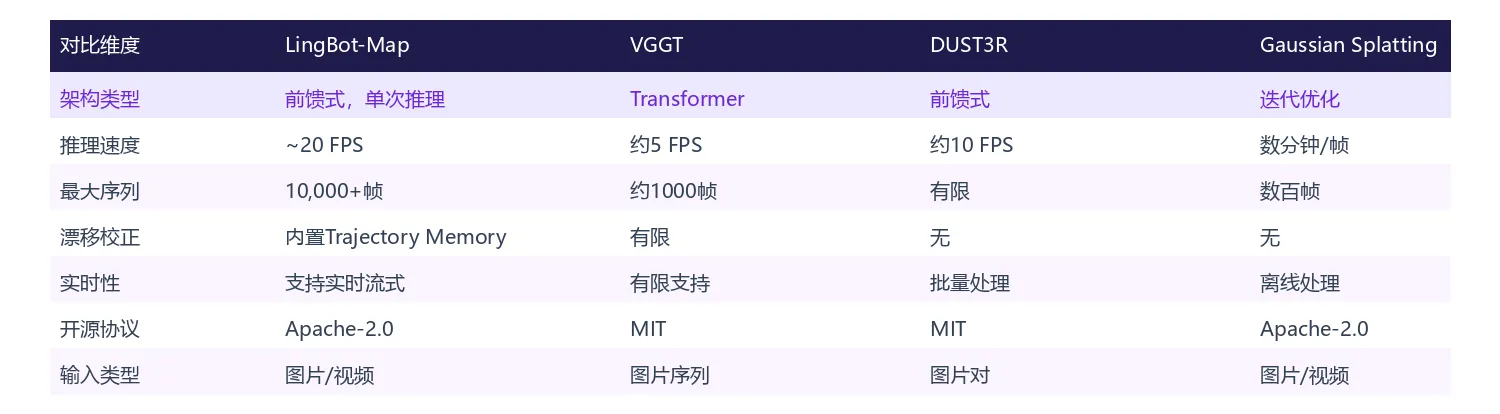
在多个基准测试中,LingBot-Map 同时超越了现有的流式重建方法和迭代优化方法,实现了速度和精度的双重突破。
💡 适用场景
场景1:实时 3D 场景重建
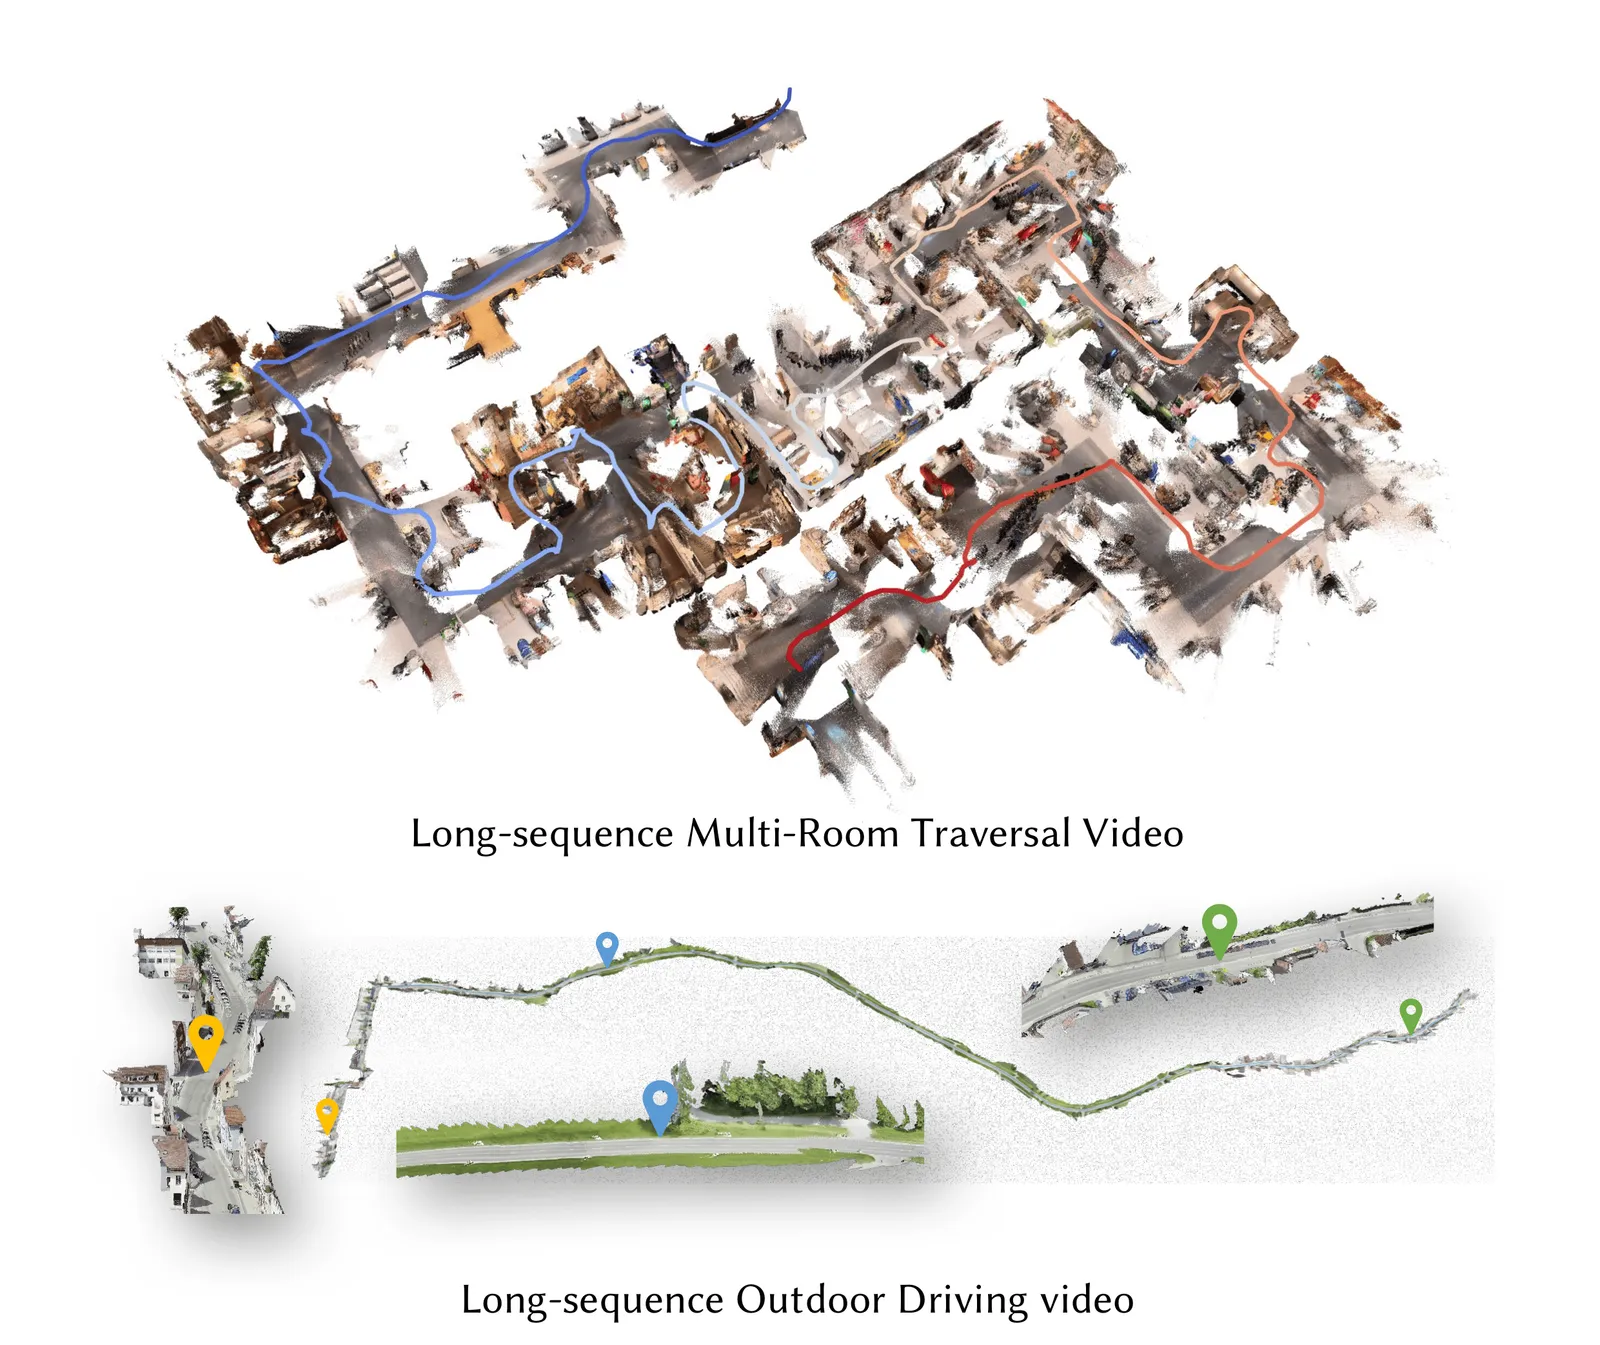
功能说明:从连续的视频流或图片序列中实时重建 3D 点云场景。支持户外建筑、室内空间、城市场景等多种环境类型。
输入要求:视频文件(MP4)或有序图片序列,支持 518x378 分辨率输入。
输出效果:高精度 3D 点云,可通过内置 Viser 可视化工具实时查看。
适用场景:AR/VR 内容制作、数字孪生、游戏场景重建。
场景2:自动驾驶与机器人导航
功能说明:将车载摄像头或机器人摄像头的实时视频流转化为 3D 场景地图,为路径规划和障碍物检测提供几何信息。
输入要求:实时视频流,10 FPS 采样。
输出效果:实时更新的 3D 环境地图,10,000+ 帧长程一致性保证。
适用场景:自动驾驶感知、机器人 SLAM、无人机测绘。
场景3:文化遗产与建筑数字化
功能说明:对古建筑、雕塑、文物进行 3D 数字化保存。通过手持设备环绕拍摄即可生成完整的 3D 模型。
输入要求:环绕拍摄的图片序列或视频,--mask_sky 参数过滤天空区域。
输出效果:高保真 3D 点云模型,可用于数字展览和学术研究。
适用场景:博物馆数字化、文物保护、建筑测量。
用户群体总结
- ✅ 计算机视觉研究者:3D 重建领域的 SOTA 基线模型
- ✅ AR/VR 开发者:实时 3D 场景重建,快速生成虚拟环境
- ✅ 机器人/自动驾驶工程师:实时环境感知与建图
- ✅ 数字孪生从业者:物理世界快速 3D 数字化
- ❌ 不适合:需要亚毫米级精度的工业测量场景(建议使用结构光/激光雷达方案)
💰 定价方案
完全免费开源,Apache-2.0 协议,可商用。
预训练模型(HuggingFace):
robbyant/lingbot-map:平衡版本,短/长序列均表现优异robbyant/lingbot-map-long:长序列优化版本robbyant/lingbot-map-stage1:Stage-1 检查点,可加载到 VGGT 模型中
硬件需求:
- 推荐 GPU 显存 12GB+
- 低显存模式支持 8GB GPU(--offload_to_cpu)
学术福利:基于 VGGT、DINOv2、FlashInfer 等优秀开源项目构建,论文已投稿 arXiv(arXiv:2604.14141)
🎯 总结
LingBot-Map 是 3D 重建领域的一次重要突破。它用前馈式架构取代了传统的迭代优化,在保持高精度的同时实现了 20 FPS 的实时重建速度。Geometric Context Transformer 统一了坐标锚定、几何线索和漂移校正三大难题,Trajectory Memory 机制更是让 10,000+ 帧的超长序列重建成为可能。
对于从事 3D 视觉、自动驾驶、AR/VR 的开发者来说,这是一个值得关注和尝试的 SOTA 工具。
推荐指数: 4.5/5(创新架构,实时性能卓越,开源可商用)
适合人群: 3D 视觉研究者、AR/VR 开发者、机器人工程师
GitHub 仓库: Robbyant/lingbot-map
论文: arXiv:2604.14141
数据截至 2026-04-20,最新信息请以官网为准。