一、为什么 A 股研究需要"工作流自动化"?
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../kakaaaa-quant-recommend.pptx../../kakaaaa-quant-recommend.mp4本文目录
- title: "A股研究工作流自动化|Kaka Quant轻量工作台实战" date: 2026-08-31 author: AI 量化带你飞 tags: [A 股研究, Tushare Pro, FastAPI, React, 工作流自动化, 事件研究] tool: kakaaaa-quant github: Conquerer-yinn/Kakaaaa-quant stars: 40 license: MIT
- 一、为什么 A 股研究需要"工作流自动化"?
- 二、它解决什么问题?
- 三、三层架构与数据流
- 四、核心能力拆解
- 4.1 情绪指标体系:可复用 + 口径就近
- 4.2 Excel 历史主表:写前自动备份 + 区域自维护
- 4.3 三类飞书卡片:可预览可刷新可推送
- 4.4 事件研究 V2:基准超额 + 样本质量表
- 4.5 FastAPI 服务层 + React 前端
- 4.6 质量保障:96 项自动化测试 + CI
- 五、快速开始(5 分钟上手)
- 5.1 安装
- 5.2 启动后端 + 前端
- 5.3 跑一个真实任务
- 5.4 Docker 一键启动
- 六、它和传统量化平台的区别
- 七、它适合谁?
- 八、路线图与未来
- 九、总结
title: "A股研究工作流自动化|Kaka Quant轻量工作台实战" date: 2026-08-31 author: AI 量化带你飞 tags: [A 股研究, Tushare Pro, FastAPI, React, 工作流自动化, 事件研究] tool: kakaaaa-quant github: Conquerer-yinn/Kakaaaa-quant stars: 40 license: MIT
风险提示:本文仅作技术交流与开源项目介绍,不构成任何投资建议。文中涉及的"事件研究"结果不含交易成本与执行摩擦,不能代表可复制表现。市场有风险,据此操作产生的一切后果自负。
一、为什么 A 股研究需要"工作流自动化"?
最近一两年,开源量化圈里出现了一个明显趋势:研究者最稀缺的不是策略,而是把"每天重复的研究动作"自动跑起来的能力。
传统量化平台——不管是 zipline、backtrader 还是 Qlib——它们的强项是"跑回测"。但 A 股研究者的真实一天是这样的:
- 收盘后手动复盘:当日强势信号、炸板观察、连板高度、创业板反馈、大回撤个股;
- 把当日数据增量写进 Excel 主表(区域、格式、备份一气呵成);
- 把"今日情绪"压成一张飞书卡片,推送到群;
- 周末把"创业板强势后 5 日事件研究"再跑一遍,看样本质量、更新结论。
每一步都很轻量,但串起来要 1~2 小时。如果哪天忘了哪个环节,复盘质量立刻断崖式下跌。
Kaka Quant(Conquerer-yinn/Kakaaaa-quant)就是为这个场景写的——一个面向 A 股研究工作流的轻量个人量化工作台,把"盘后复盘 → 情绪指标 → Excel 历史主表 → 飞书卡片 → 网页展示 → 策略验证"串成一条自动化闭环。
本文就带你从架构、模块、代码三个层面,把它完整拆开。
二、它解决什么问题?
多数量化框架为"跑策略"而生,Kaka Quant 为"做研究"而生。它不是重型量化平台,而是把一个 A 股研究者每天真实要做的事串成一条自动化闭环。
| 能力 | 说明 |
|---|---|
| 📊 市场情绪指标体系 | 价格限制 / 炸板 / 大回撤 / 连板高度 / 创业板专区 / 强势股次日反馈 / 位置度量 |
| 🗂 Excel 历史主表 | 增量补数、区间命名、滚动改名、写前自动备份、表格区域自动维护 |
| 📮 三类飞书卡片 | 盘后复盘 / 竞价观察 / 盘中节奏,一键预览、刷新、推送到群 |
| 🧬 策略事件研究 | 创业板强势后 1/3/5 日事件研究:基准超额表现、首板/连板与市场环境分组、样本质量表 |
| ⚡ FastAPI 服务层 | 任务注册表、后台任务、状态轮询与协作式取消 |
| 🖥 React 展示前端 | 历史数据图表联动、卡片管理、策略研究复盘页 |
| 🎯 策略研究主线 | 注册表驱动:研究 → 登记 → 试运行 → 启用 → Excel 复盘 |
| 🧪 工程化保障 | 96 项自动化测试 · Ruff · GitHub Actions · Docker Compose |
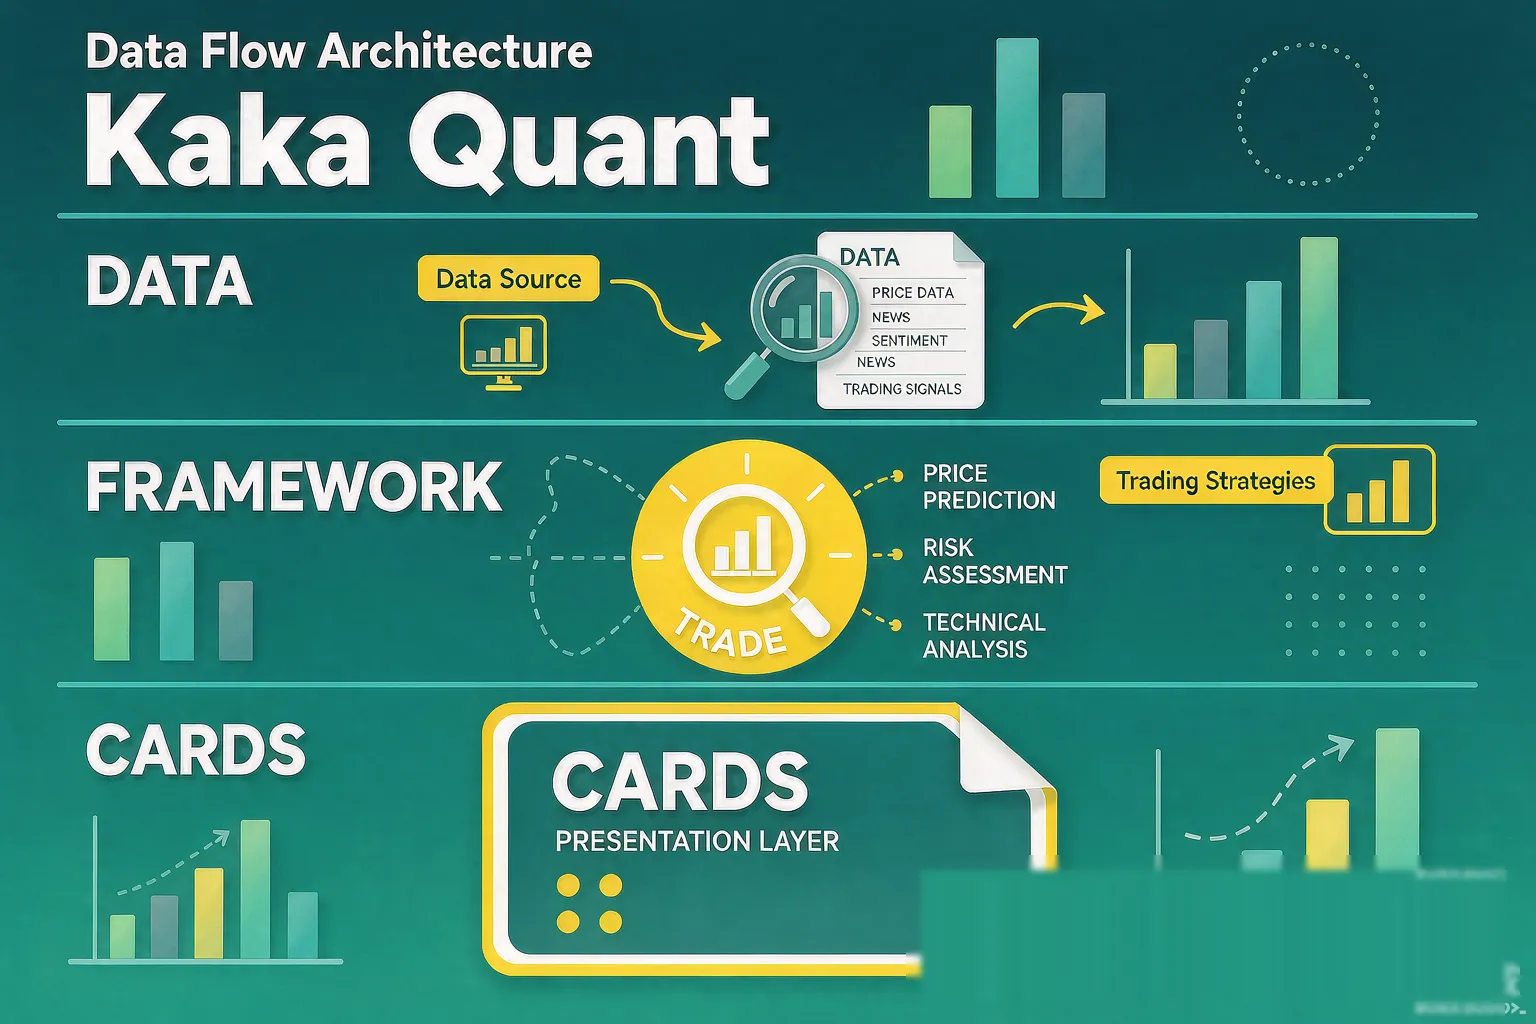
三、三层架构与数据流
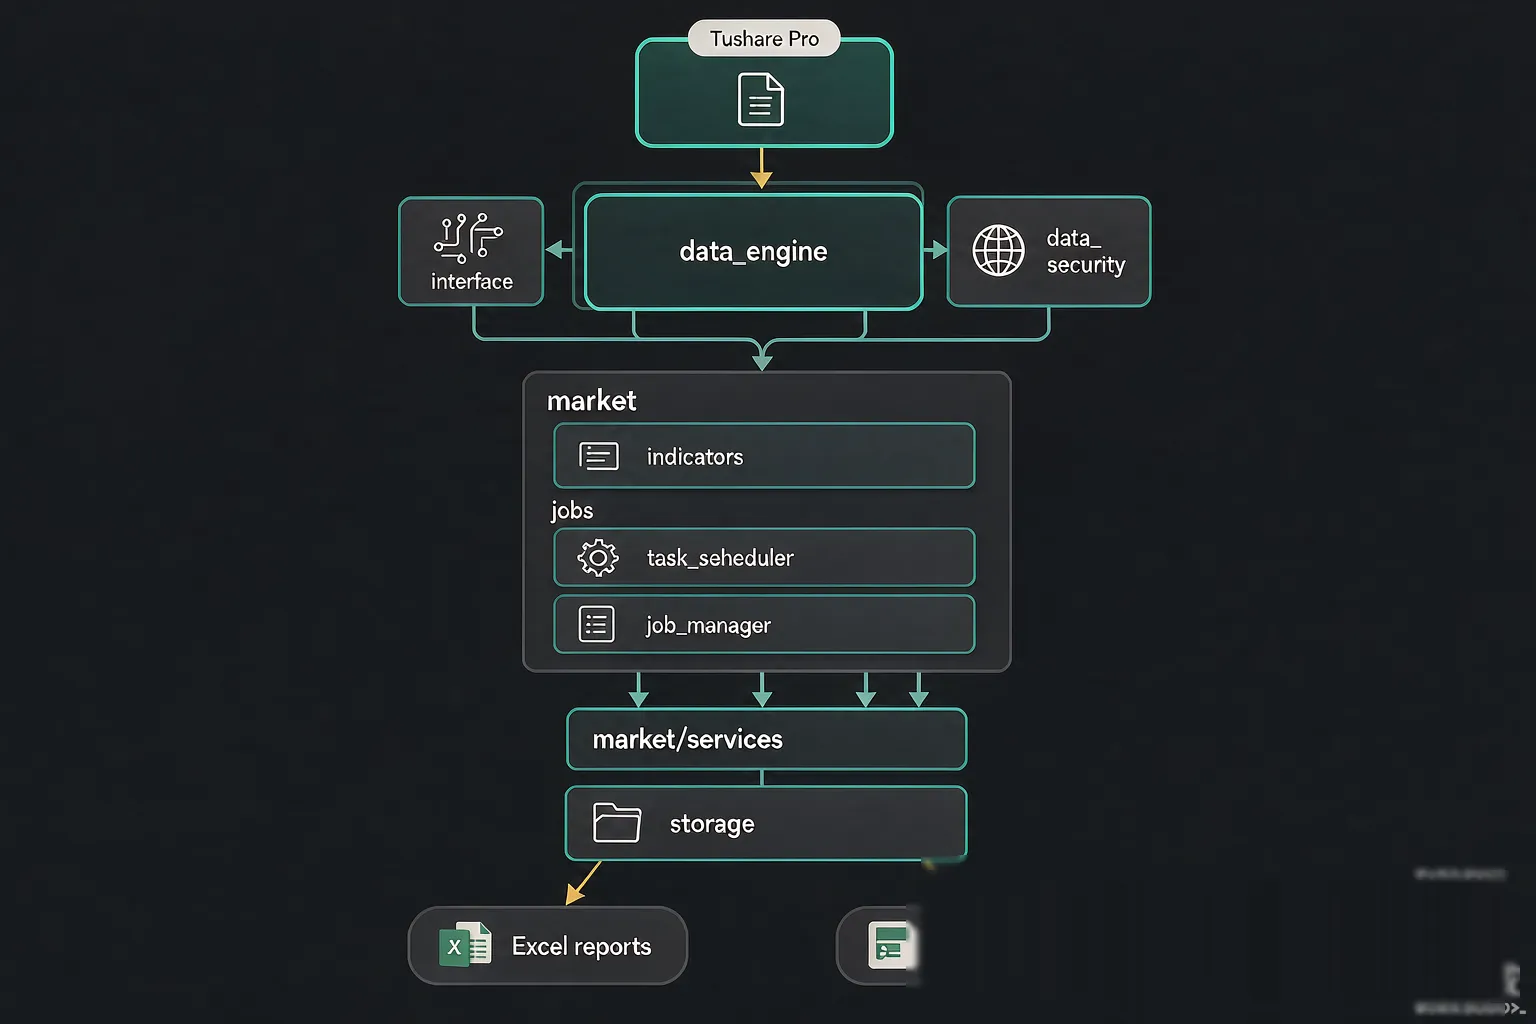
整个仓库走的是三层结构 + 单向依赖:
flowchart LR
    TS[("Tushare Pro")] --> ENG["data_engine<br/>取数封装 · 限流重试"]
    ENG --> IND["market/indicators<br/>情绪指标体系"]
    IND --> JOBS["market/jobs<br/>任务入口"]
    JOBS --> XLSX[("storage<br/>Excel 历史主表")]
    IND --> SNAP["market/services<br/>卡片快照"]
    SNAP --> CARD["push_views<br/>飞书卡片"]
    JOBS --> API["backend<br/>FastAPI 服务层"]
    XLSX --> API
    SNAP --> API
    API --> FE["frontend<br/>React 展示壳"]
    ENG --> STRAT["strategies<br/>事件研究 + 注册表驱动"]
    STRAT --> XLSX
要点有三:
- 数据入口唯一:所有原始行情都从
data_engine拉 Tushare Pro,再向下分发。这一层把"限流、重试、交易日历、字段对齐"全包了,下游不用再操心。 - 指标和卡片是兄弟:指标结果写 Excel(用于历史回看),同时建快照喂卡片(用于即时推送),两者都是指标的消费者,互不反向依赖。这避免了"卡片必须等 Excel 写完才能渲染"的串行阻塞。
- 策略是注册表驱动:
strategies/下每条研究都是一个独立脚本,由注册表统一调度,研究 → 登记 → 试运行 → 启用 → Excel 复盘五步闭环。新增研究不用改主代码。
目录结构(截选):
Kaka_Quant/
├── backend/            # FastAPI 轻量服务层:任务、读取、卡片、策略接口
├── common/             # 配置(全部走环境变量)与飞书通知器
├── data_engine/        # Tushare 封装:日历 / 行情 / 价格限制 / 竞价 / 实时
├── frontend/           # React + Vite 展示前端
├── market/
│   ├── indicators/     # 可复用情绪指标(口径文档就近维护)
│   ├── jobs/           # 可独立运行的任务入口
│   ├── services/       # 三类卡片快照构建
│   └── push_views/     # 飞书卡片视图
├── storage/            # Excel 主表 / 备份 / 表格区域维护
├── strategies/         # 事件研究 + 策略脚本 + 研究笔记 + 注册表
├── tests/              # 96 项 Python 自动化测试
└── docs/               # 架构 / 安全 / 运行手册 / 研究设计
四、核心能力拆解
4.1 情绪指标体系:可复用 + 口径就近
market/indicators/ 是整套系统的"指标库"。每个指标是纯函数(输入日期或行情 DataFrame,输出指标结果),代码旁边紧跟一份"口径文档"——这一招对个人项目尤为重要:跑出来的数字别人能直接 review,不用去翻聊天记录。
以"创业板强势后 1/3/5 日事件研究"为例,它的口径文档会写清楚:
- 样本范围:创业板(30/68 开头)+ 当日触达日间价格上限事件
- 排除规则:ST 股、上市未满 60 天
- 基准:399006.SZ(创业板指)
- 输出:原始价格变动 + 相对基准超额变动
- 分组:首板 / 连板 × 弱 / 中 / 强 市场环境
【说明:基准】所有相对变动都以「399006.SZ」为基准,避免用错指数失真
【说明:窗口】事件后第 1/3/5 个交易日,不含事件当日
【说明:样本质量】所有排除项都计数并写入"质量表",不静默丢掉
4.2 Excel 历史主表:写前自动备份 + 区域自维护
A 股研究者的 Excel 主表"格式一致性"非常关键——一旦公式断裂或表头错位,下游所有引用都会崩。storage/ 模块的处理方式值得借鉴:
- 写前自动备份:每次落盘前复制上一版本到
storage/backup/YYYYMMDD_HHMMSS/,文件名带时间戳; - 增量补数:按日期判定哪些行是新数据,只追加不覆盖,避免人工合并冲突;
- 表格区域自维护:用
openpyxl维护"已使用行/列"边界,新增数据后自动扩区,公式跨行引用不会失效; - 滚动改名:主表按"区间"自动归档(例如月度主表 →
market_sentiment_202608.xlsx)。
这套设计让 Excel 不再是脆弱的"个人云盘",而是可版本化、可回滚的研究档案。
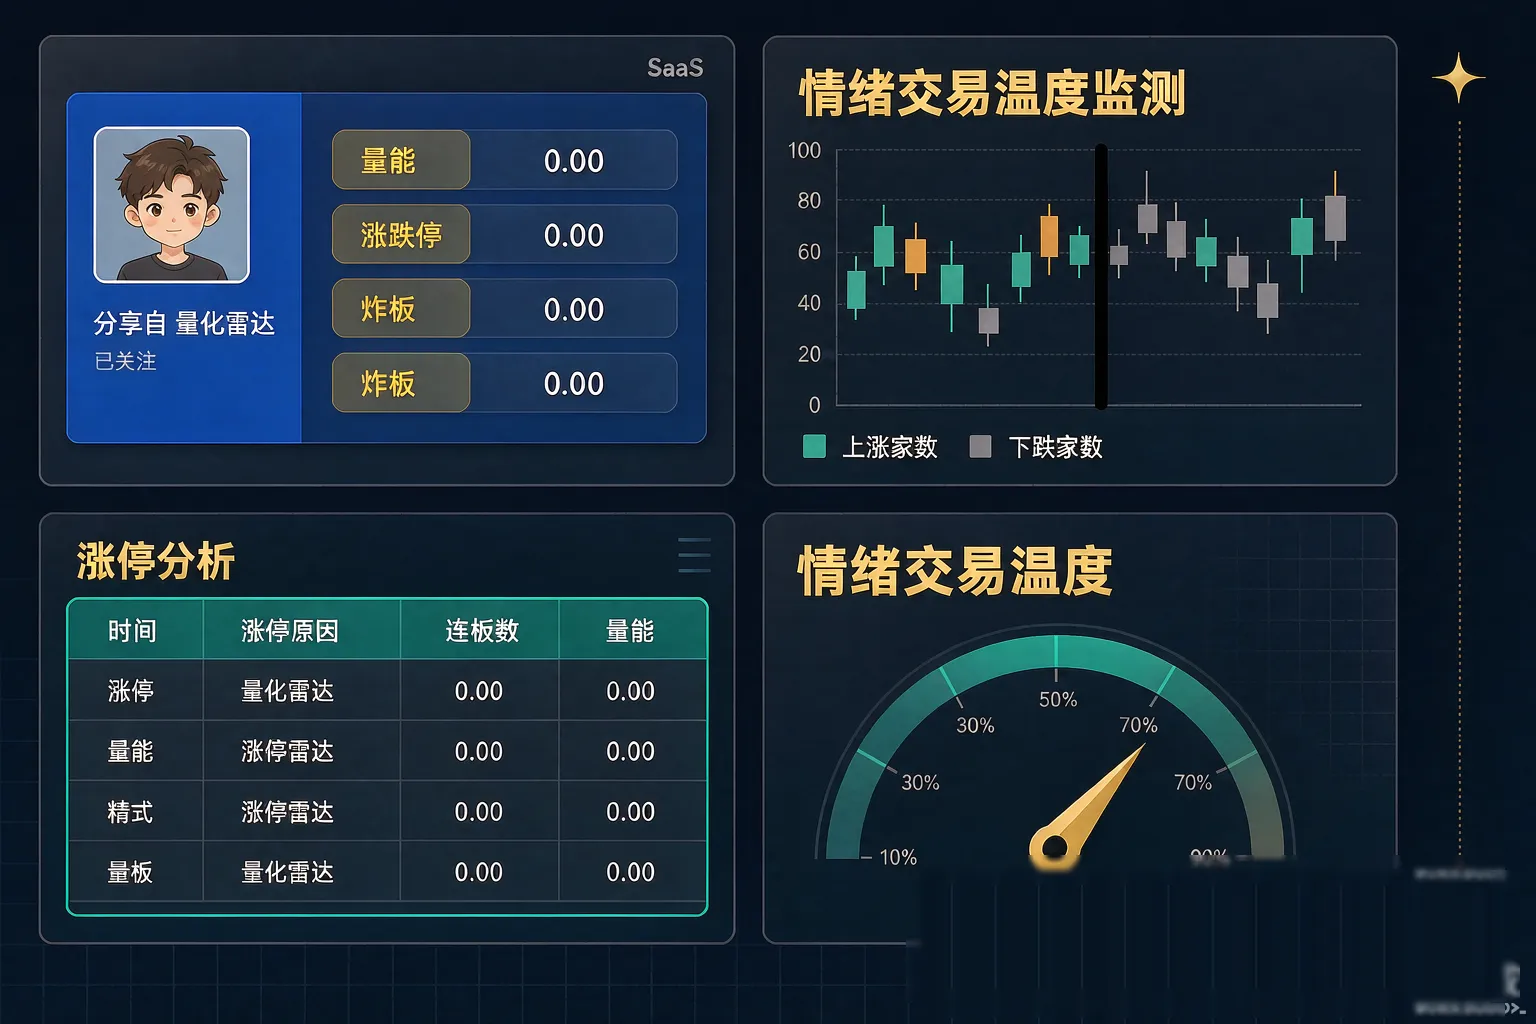
4.3 三类飞书卡片:可预览可刷新可推送
飞书自定义机器人的卡片消息可以承载非常丰富的内容。Kaka Quant 做了三类:
| 卡片 | 触发时点 | 内容 | 状态 |
|---|---|---|---|
| 盘后复盘 | 收盘后 | 量能、价格限制、炸板、连板高度、创业板反馈、规则化情绪结论与风险提示 | ✅ 稳定 |
| 竞价观察 | 9:25 后 | 指数开盘强弱、竞价成交额、竞价价格限制与前排个股 | ✅ 第一版 |
| 盘中节奏 | 盘中任意 | 实时指数、全天成交额外推、时段节奏;实时权限不足自动降级为日线 | 🧪 实验性 |
每张卡片都支持三种动作:预览(dry-run,不发群)/ 刷新(重新计算后发群)/ 发送(历史快照发群)。这意味着写新卡片时不用真的"把群炸一次"才能验证,可以先 dry-run 看排版,再正式发。
4.4 事件研究 V2:基准超额 + 样本质量表
第一条真实研究闭环是创业板强势后 5 日事件研究(V2),逻辑非常标准但细节严谨:
- 识别创业板触达日间价格上限事件,只统计未来 5 个交易日行情完整的样本,排除 ST 与上市未满 60 天个股
- 计算事件后第 1、3、5 日原始价格变动及相对
399006.SZ的超额变动 - 按首板/连板 × 弱 / 中 / 强 市场环境分组统计
- 样本质量表显式计数所有排除项(不是静默丢弃)
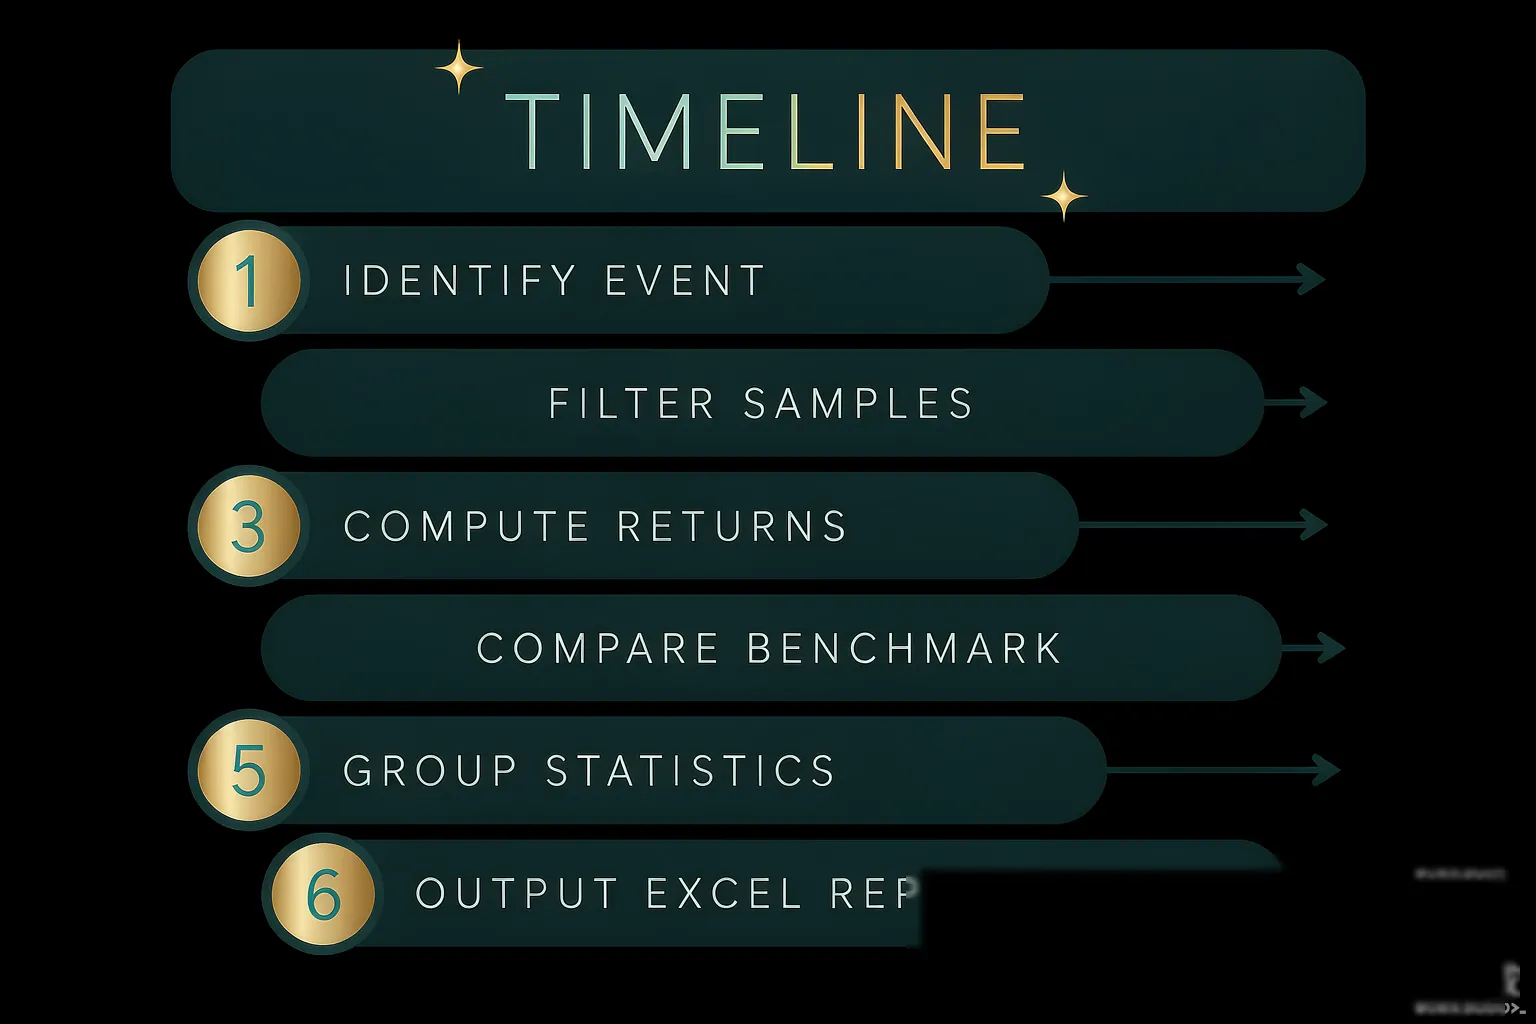
输出五 Sheet Excel(摘要 / 分组 / 质量 / 明细 / 运行信息),API 与 /strategies 页面直读。这种"显式排除"是科研级数据处理的态度,比"看上去不错"的批量回测可信度高一个量级。
4.5 FastAPI 服务层 + React 前端
后端用 FastAPI 搭一个轻量服务层:
- 任务注册表:所有
market/jobs/下的脚本自动注册为可调度的任务 - 后台任务:长任务异步执行,前端轮询状态
- 协作式取消:用户可在前端点"取消"安全中断任务
- OpenAPI 文档:访问
http://127.0.0.1:8000/docs看全部接口
前端用 React + Vite,做了三件事:
- 历史数据图表联动:选日期 → 自动刷新多个指标卡片
- 卡片管理:列出所有可用卡片 + 三按钮(预览/刷新/发送)
- 策略研究复盘页:直接读 Excel 五 Sheet,渲染成可交互表格
4.6 质量保障:96 项自动化测试 + CI
个人项目里愿意做 CI 的不多。Kaka Quant 把测试当一等公民:
- 96 项自动化测试(90 Python + 6 前端):覆盖指标口径、Excel 读写去重、事件研究口径、基准与分组统计、卡片结构、任务生命周期、API 集成、凭据安全扫描
- Ruff 语法闸门:每次 push 自动跑 lint
- GitHub Actions:CI 后端 + 前端双校验
- 凭据零明文:仓库零明文密钥,全部走环境变量
【说明:测试覆盖】指标函数纯函数化 + 集成测试双层保障
【说明:安全策略】自定义网关强制 HTTPS,凭据只走 env vars
五、快速开始(5 分钟上手)
5.1 安装
git clone https://github.com/Conquerer-yinn/Kakaaaa-quant.git && cd Kakaaaa-quant
pip install -r requirements.txt
cp .env.example .env        # 填入 TUSHARE_TOKEN 与 FEISHU_BOT_WEBHOOK
5.2 启动后端 + 前端
# 后端(http://127.0.0.1:8000/docs 查看全部接口)
uvicorn backend.main:app --reload

# 前端(另开终端,http://127.0.0.1:5173)
cd frontend && npm ci && npm run dev
5.3 跑一个真实任务
# 增量更新市场情绪历史主表
python market/jobs/run_market_sentiment.py

# 盘后飞书卡片先 dry-run 预览,再去掉参数真实推送
python market/jobs/push_post_close_card.py --dry-run

# 运行创业板事件研究(最近 120 天)
python strategies/run_chinext_limit_up_event_study.py
5.4 Docker 一键启动
docker compose up --build
# backend: http://127.0.0.1:8000   frontend: http://127.0.0.1:5173
六、它和传统量化平台的区别
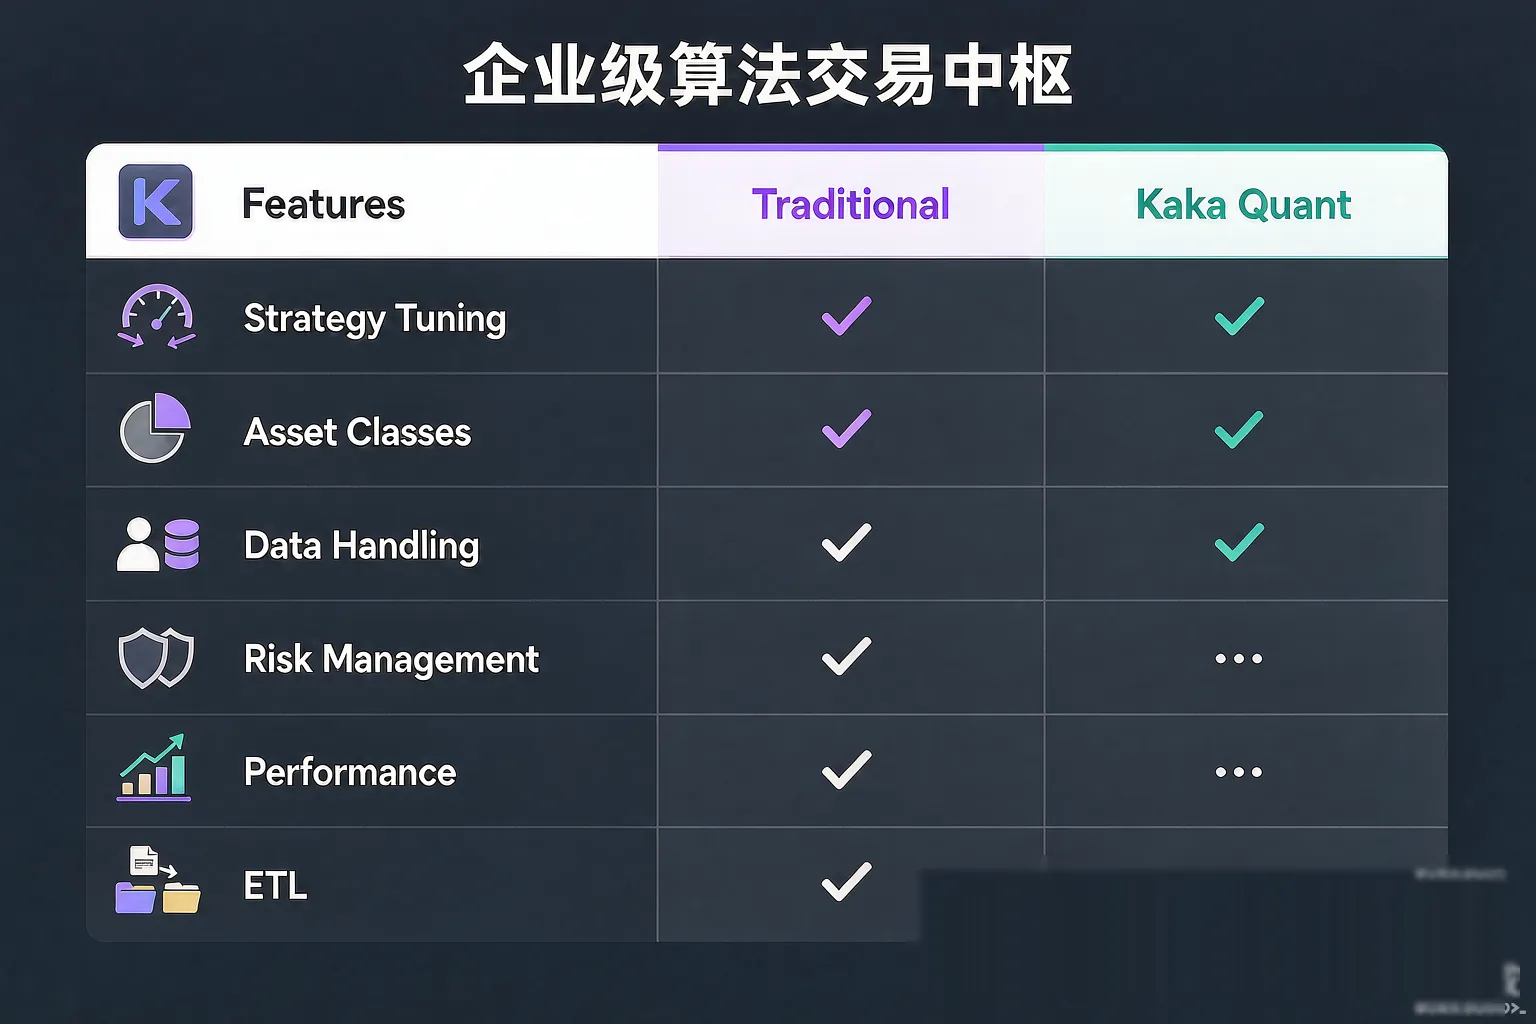
| 维度 | 传统量化平台(backtrader / zipline / Qlib) | Kaka Quant |
|---|---|---|
| 定位 | 跑回测 | 做研究 |
| 数据源 | 多源,配置复杂 | Tushare Pro 单源封装 |
| 输出 | 净值曲线、回撤指标 | Excel 主表 + 飞书卡片 + 网页展示 |
| 策略 | 事件驱动 / 向量化回测 | 注册表驱动的事件研究 |
| 部署 | 笔记本 / 服务器 | Docker Compose 一键 |
| 适用 | 写策略 + 验证 | 日复盘 + 事件研究 |
| 学习曲线 | 高(要懂框架) | 低(Python 脚本即可) |
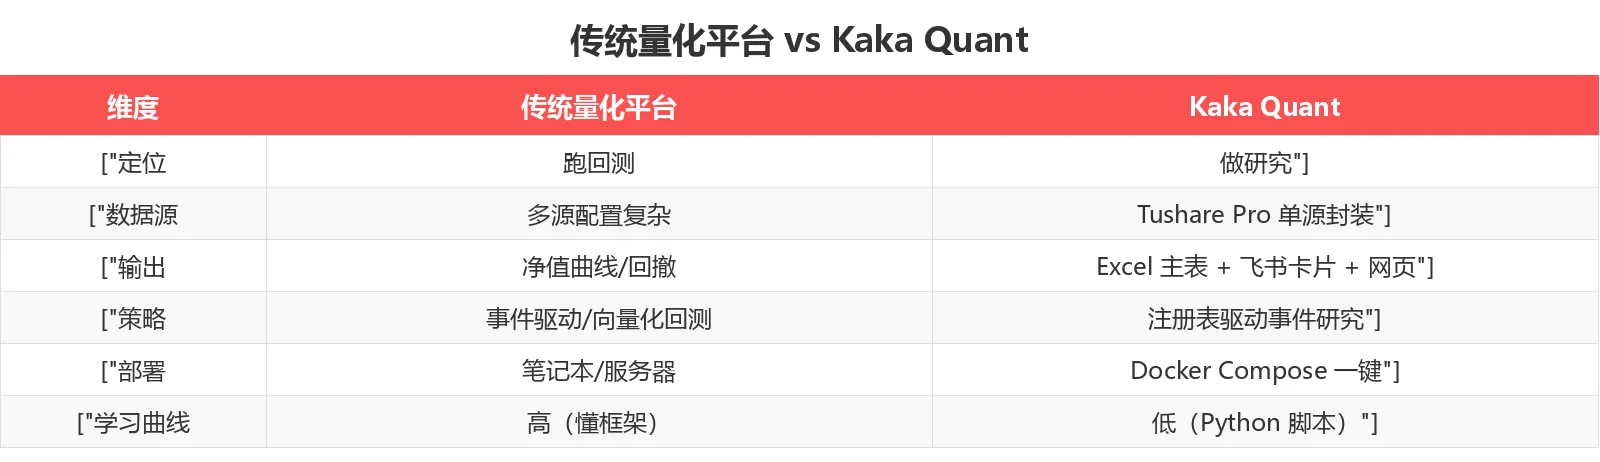
简而言之:传统平台是"怎么跑回测",Kaka Quant 是"怎么让研究每天都跑一遍"。
七、它适合谁?
✅ A 股个人研究者:每天 1~2 小时复盘时间宝贵的人,想把研究流程自动化 ✅ 飞书团队:已经用飞书做日常协作的团队,复盘卡片可以直接进群 ✅ 事件研究入门者:想做事件研究但不想重造轮子的人 ✅ 科研型量化爱好者:强调"样本质量表""基准超额"的严谨研究态度
如果你已经在用 Tushare Pro + 飞书机器人 + Excel 主表做日常研究,Kaka Quant 的设计值得直接抄作业——哪怕不用它的代码,也可以照搬它的"三层架构 + 单向依赖 + 注册表驱动策略"。
八、路线图与未来
作者在 README 里写得很清楚:
- ✅ v1.0.0 —— 情绪指标体系 · 历史主表 · 三类卡片 · 前后端闭环 · 策略主线 · 测试与 CI
- ✅ 首个事件研究闭环 —— 创业板强势后 1/3/5 日 · 基准超额 · 首板/连板与市场环境分组 · 样本质量表
- ☐ 更多旧指标迁移到
market/indicators/ - ☐ 事件研究扩展到更多板块与观察窗口
- ☐ 盘中卡片实时链路稳定性提升
- ☐ 评估数据库层与更通用的任务调度
这是一个真实使用驱动的个人项目,节奏以研究需求优先,作者明确欢迎 Issue 和 PR。
九、总结
Kaka Quant 给我的最大启发不是某个具体功能,而是它的"工作流一体化"思路:
- 不重造轮子:数据源用现成的 Tushare Pro、推送用现成的飞书机器人、存储用现成的 Excel——把所有精力放在"研究动作自动化"上。
- 三层架构 + 单向依赖:避免循环引用,让每个模块都能独立测试。
- 注册表驱动策略:新增研究只需加一个脚本 + 注册一次,不用改主代码。
- 显式排除 = 严谨态度:所有样本排除项都计数写入"质量表",不静默丢弃。
- 96 项自动化测试 + CI:个人项目也按企业级标准做质量保障。
如果你每天都在重复"复盘 + 写 Excel + 推卡片"这套动作,不妨花 5 分钟 clone 下来跑跑看。
本文仅作技术交流与开源项目介绍,不构成任何投资建议。文中涉及的"事件研究"结果不包含交易成本与执行摩擦,不代表可复制表现。市场有风险,据此操作产生的一切后果自负。
项目地址:https://github.com/Conquerer-yinn/Kakaaaa-quant
License:MIT
核心依赖:Python 3.12+ / Tushare Pro / FastAPI / React + Vite / openpyxl / Ruff / Docker Compose