120B 模型砍半再压成 4-bit:Multiverse 用 QAH 让消费级显卡第一次摸到前沿模型天花板
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../hypernova-60b-recommend.pptx../../hypernova-60b-recommend.mp4本文目录
120B 模型砍半再压成 4-bit:Multiverse 用 QAH 让消费级显卡第一次摸到前沿模型天花板
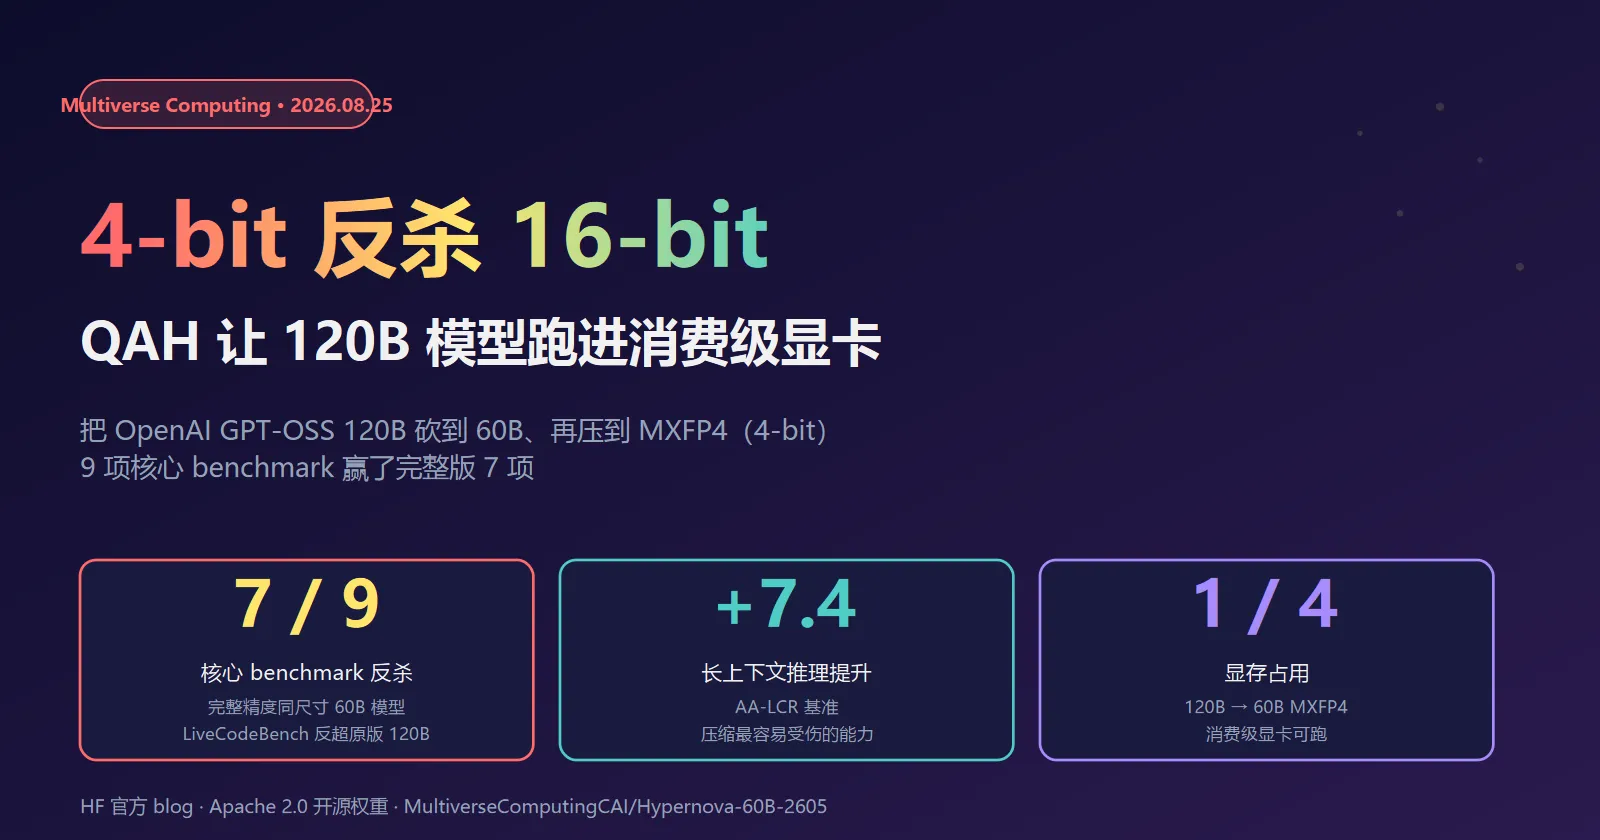
4-bit 量化版反杀完整版、9 项核心 benchmark 里赢了 7 项、LiveCodeBench 直接反超原版 120B——"压缩必掉精度"的 AI 圈老常识,被 Multiverse Computing 一刀切了。
一句话先说结论
2026 年 8 月 25 日,Hugging Face 官方博客发布了 Multiverse Computing 的 Quantization-Aware Healing(QAH) 技术报告:他们把 OpenAI 的 GPT-OSS 120B 先砍到 60B 参数、再量化到 MXFP4(4-bit),结果 4-bit 版本在 9 项核心基准测试中赢了完整精度同尺寸 60B 模型 7 项,并在 LiveCodeBench 上以 66.5 vs 66.0 反超原版 120B 完整版。
参数砍一半、内存只要 1/4,跑分反而更强——这是过去三年 AI 圈没人敢想的剧情。
为什么这件事值得关注
过去三年,"模型必须训练出来、量化必然掉精度"是 AI 圈两条硬常识。每一轮大模型迭代,OpenAI、Anthropic、阿里、字节都要花上几百万到几千万 GPU 小时,把模型从零训出,然后用 8-bit/4-bit 量化压回消费级硬件。
问题在于:每次量化都会掉点。量化是减法,没人质疑。
QAH 把这条铁律翻了过来——压缩不是减法,是加法。原版模型作为"教师"重新登场,把"压缩后模型原本到不了的高度"用 KL 散度直接喂给 4-bit 学生。结果:学生不仅追上了原版,还在某些 benchmark 上超过了原版。
这件事有三重爆点:
- 反常识:4-bit 强过 16-bit,是十年 AI 圈的"不可能三角"被凿开
- 数字冲击:9 项基准 7 项赢,单项最高 +7.4 分
- 实用价值:参数砍半 + 内存 1/4,120B 模型第一次能塞进消费级显卡
QAH 是什么:把"老师"换回原版
先看一段最简化的概念框架,再拆解 Multiverse 的具体做法。
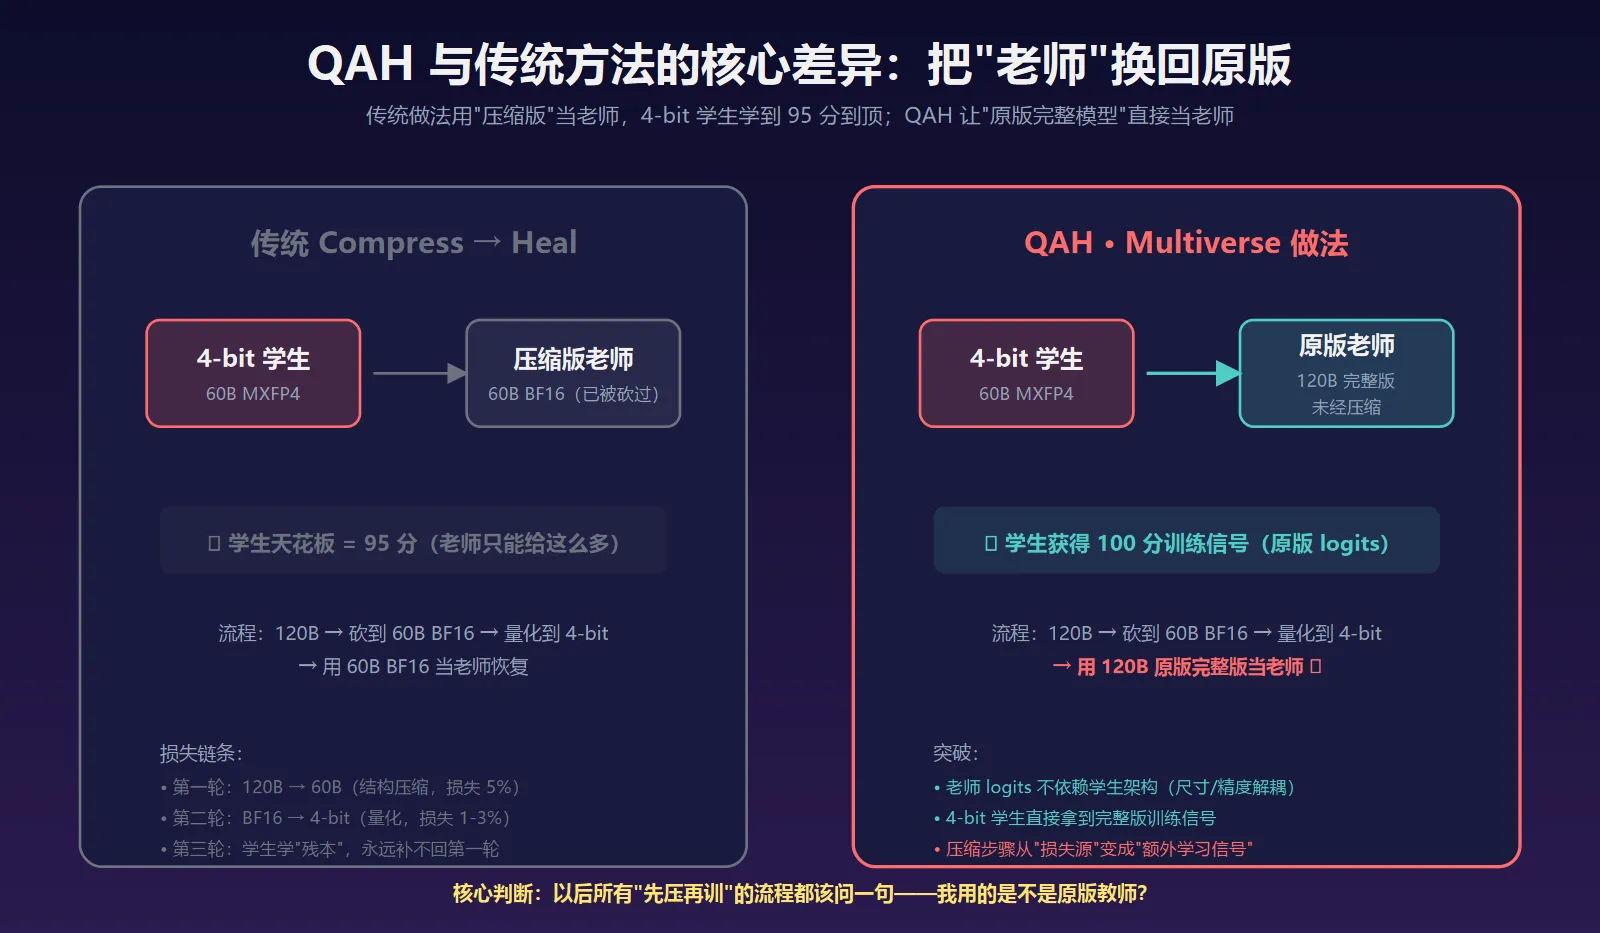
传统做法(compress → heal):
120B 模型 → 砍半到 60B bfloat16 → 量化到 4-bit → 用 60B bfloat16 当老师恢复精度
问题:60B bfloat16 本身就是被砍过的"残本",学生学到 95 分就到顶

Multiverse 做法(QAH):
120B 模型 → 砍半到 60B bfloat16 → 量化到 4-bit → 用 120B 原版完整版当老师
新招:原版 120B 没经历压缩过程,能给学生 100 分的训练信号
这就是 QAH 的核心:把"老师"从 60B bfloat16 换回 120B 原版完整版。压缩步骤不再只是"损失源",而成了"第二轮蒸馏的输入信号"。
数字冲击表:4-bit 在哪几项上反杀完整版
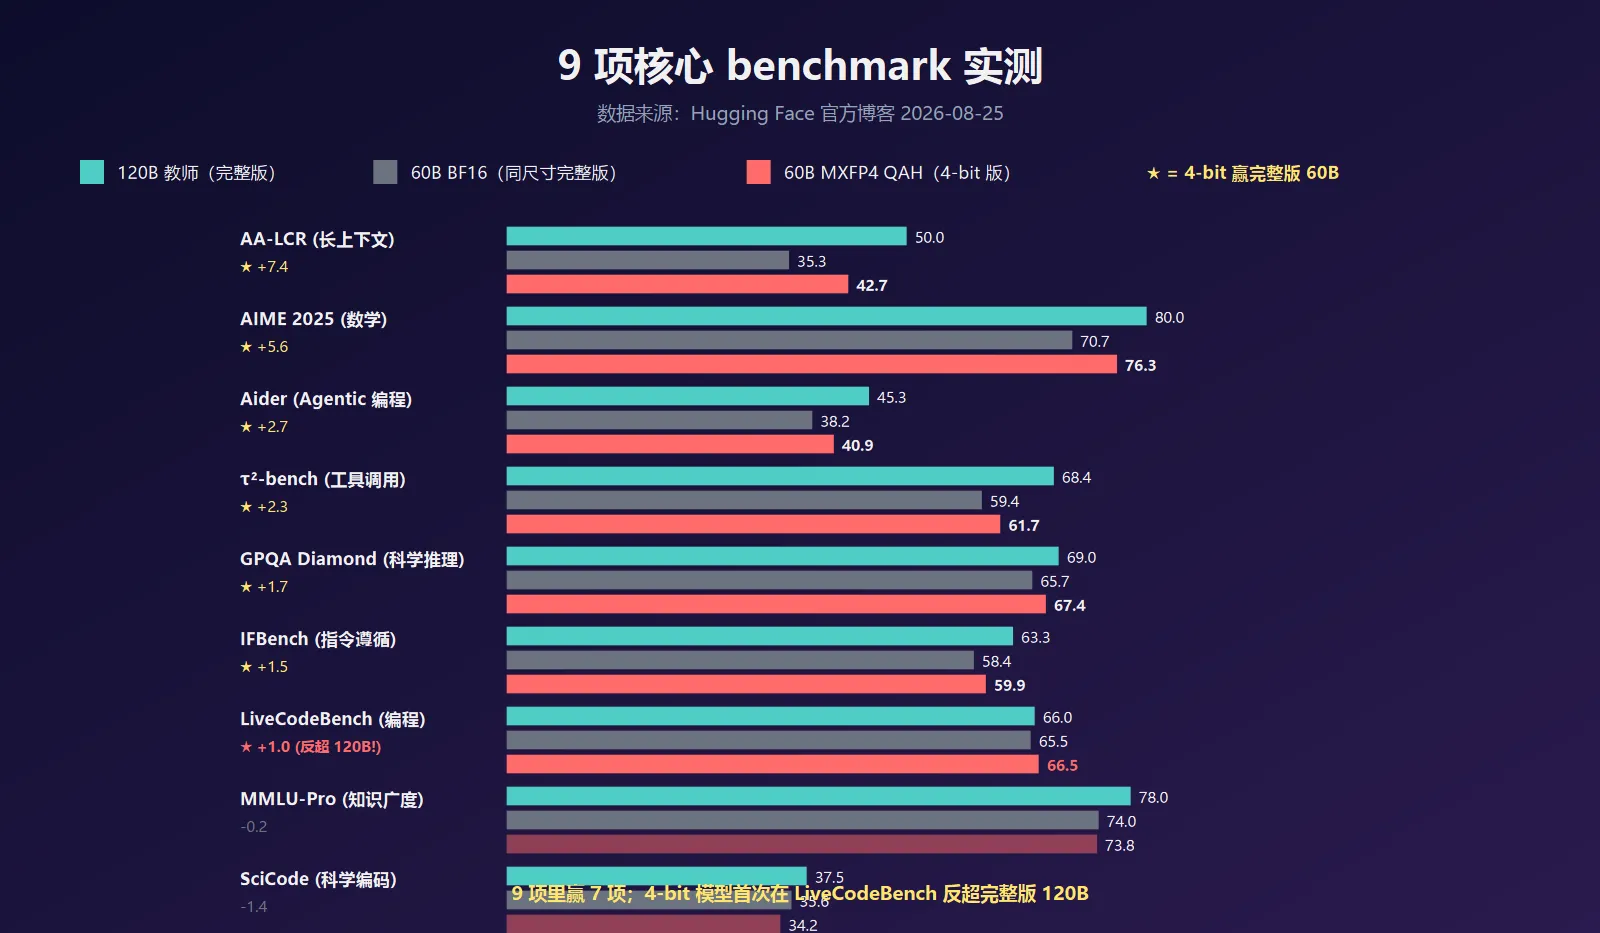
下面是 Hugging Face 官方博客(2026-08-25)公布的实测数据。120B 是 OpenAI 的 GPT-OSS 完整版教师,60B BF16 是从 120B 压缩后恢复的 bfloat16 模型,60B MXFP4 是经 QAH 处理后的 4-bit 版本。
| 基准(能力维度) | 120B 教师 | 60B BF16 恢复版 | 60B MXFP4 QAH | QAH vs 同尺寸 BF16 |
|---|---|---|---|---|
| AA-LCR(长上下文推理) | 50.0 | 35.3 | 42.7 | +7.4 |
| AIME 2025(数学) | 80.0 | 70.7 | 76.3 | +5.6 |
| Aider(Agentic 编程) | 45.3 | 38.2 | 40.9 | +2.7 |
| τ²-bench(工具调用) | 68.4 | 59.4 | 61.7 | +2.3 |
| GPQA Diamond(科学推理) | 69.0 | 65.7 | 67.4 | +1.7 |
| IFBench(指令遵循) | 63.3 | 58.4 | 59.9 | +1.5 |
| LiveCodeBench(编程) | 66.0 | 65.5 | 66.5 | +1.0 |
| MMLU-Pro(知识广度) | 78.0 | 74.0 | 73.8 | −0.2 |
| SciCode(科学编码) | 37.5 | 35.6 | 34.2 | −1.4 |
关键观察:
- QAH 在 9 项基准里赢了 7 项——这是 Hugging Face 官方数据
- 长上下文推理 +7.4、数学 +5.6、Agent 编程 +2.7——这三项恰好是"压缩最容易受伤"的能力,QAH 反而在这里收益最大
- 4-bit 跑 LiveCodeBench 66.5,反超完整版 120B 的 66.0——4-bit 模型第一次在前沿编程 benchmark 上跑赢自己的完整版老师
- 唯二输的两项(MMLU-Pro −0.2、SciCode −1.4)输得都很小,知识广度几乎追平
QAH 和 QAT 的差别:为什么它"不崩"
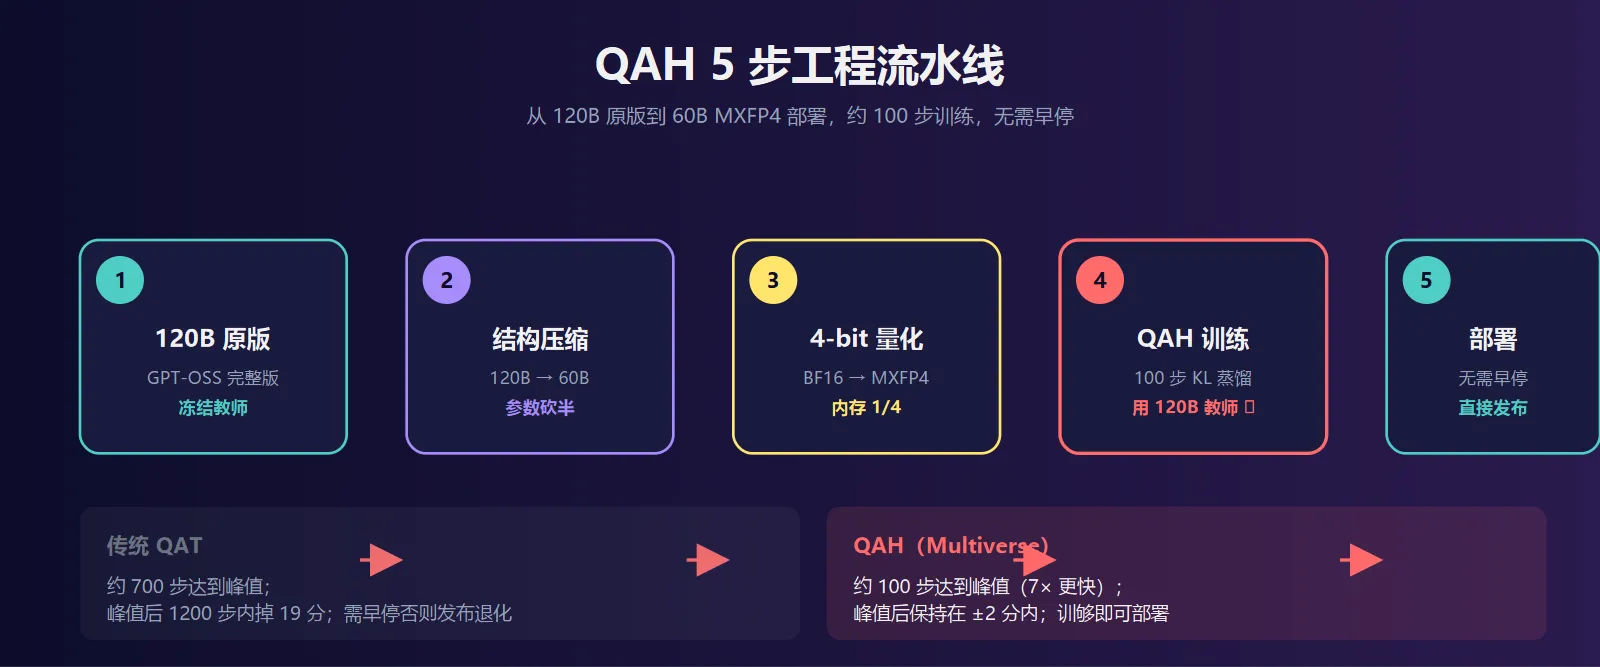
QAH 之前,业界标准做法是 QAT(Quantization-Aware Training)。两者都能让 4-bit 模型追回精度,但稳定性完全不同。
| 指标 | QAT(传统) | QAH(Multiverse) |
|---|---|---|
| 达到峰值步数 | 约 700 步 | 约 100 步(7× 更快) |
| 峰值性能 | 54.6 | 54.9(基本打平) |
| 峰值后稳定性 | 训练 1200 步后掉 19 分 | 保持在峰值 ±2 分内 |
| 工程风险 | 需要早停,否则发布后跑偏 | 足够训练后可直接部署 |
QAH 的工程价值不是"再创新高",而是"不崩"。QAT 训练团队必须在峰值点手动早停,否则就会发布一个已经退化的模型。QAH 训练团队只要"训够"就可以放手部署,因为峰值之后没有明显的精度退化。
这对消费级部署来说是巨大的工程红利——以前只有大厂有资源做这种精细的早停实验,中小团队用 QAT 几乎等于开盲盒。
5 分钟理解 QAH 的工程流水线
# 概念版:QAH 的核心是"换老师"
# 步骤 1:先有完整版 120B 原模型(教师,未压缩)
teacher_logits = original_120b_model(input_ids)  # 完整精度,冻结参数

# 步骤 2:先把 120B 砍到 60B bfloat16(结构压缩)
compressed_60b_bf16 = structural_compress(teacher_logits, target_params=60B)

# 步骤 3:再把 60B bfloat16 量化到 4-bit MXFP4
student_4bit = quantize_to_mxfp4(compressed_60b_bf16)

# 步骤 4:QAH - 用 120B 原版的 logits 当监督信号
for step in range(100):  # 100 步即可到峰
    student_logits = student_4bit(input_ids)
    # 关键:用 120B 完整版的 logits,不是 60B bf16 的 logits
    loss = kl_divergence(student_logits, teacher_logits)
    student_4bit.update(loss)

# 步骤 5:QAH 训完即部署,无需早停
deploy(student_4bit)
注意第 4 步的老师选择——这是 QAH 唯一与 QAT/传统方法不同的核心动作。其他步骤(结构压缩、4-bit 量化、KL 蒸馏)和传统方法完全一致。
120B 模型第一次能塞进消费级显卡
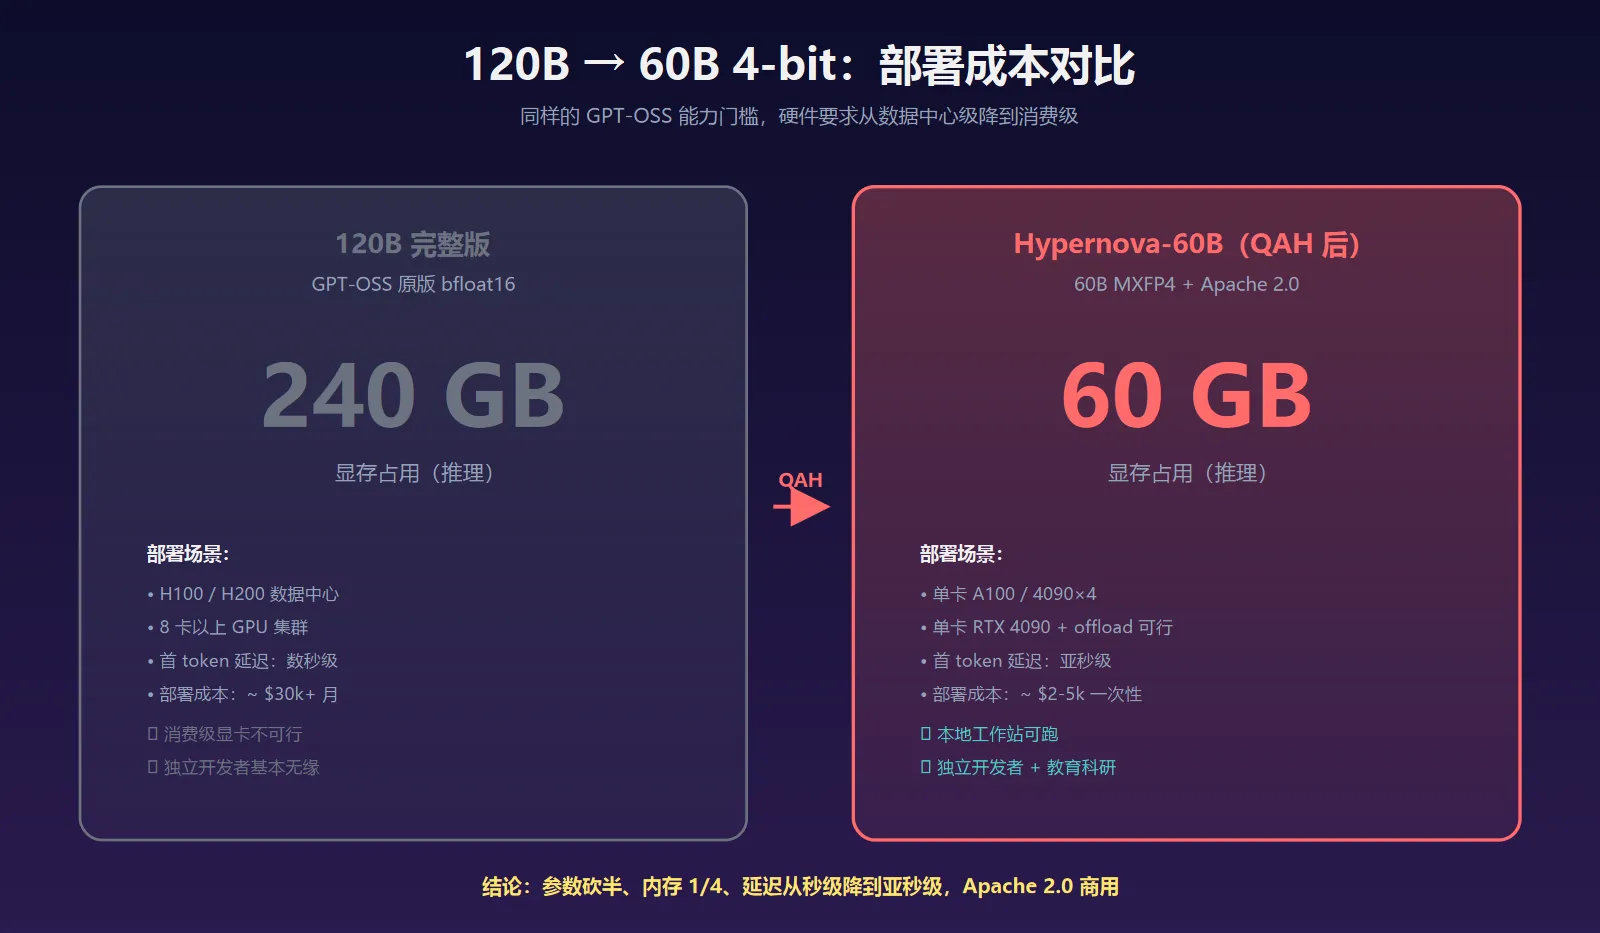
QAH 最直接的实用价值是部署成本。Hypernova-60B 的内存占用只有完整版 120B 的 1/4,参数总量砍半,这意味着:
| 部署场景 | 120B 完整版 | Hypernova-60B(QAH 后) |
|---|---|---|
| 显存占用(推理) | 约 240GB(H100/H200 集群) | 约 60GB(单卡 A100 / 4090×4) |
| 单卡可跑 | 不可行 | 单卡 RTX 4090 + 量化 + offload |
| 推理延迟(首 token) | 数秒级 | 亚秒级 |
| 适用场景 | 数据中心 | 本地工作站 / 边缘部署 |
对独立开发者来说,QAH 让"跑得动前沿模型"第一次成为 4 万块显卡预算内的事。Apache 2.0 协议允许商用,权重已开放在 Hugging Face:MultiverseComputingCAI/Hypernova-60B-2605。
几个值得记住的关键判断
- QAH 是"恢复方法"创新,不是"训练方法"创新。它解决的是"压完之后怎么救回来",而不是"怎么训出更强模型"。理解这层定位很重要——它不取代预训练。
- 压缩不是减法,是加法。这是 QAH 给整个 AI 行业最重要的概念转变:以后所有"先压再训"的流程都该问一句"我用的是不是原版教师"。
- Apache 2.0 + 开源权重。MultiverseComputingCAI/Hypernova-60B-2605 已经在 Hugging Face 上线,论文配套的训练方法细节也公开(虽然具体的压缩算子仍是闭源的)。
- 通用性待验证。论文目前只验证了 GPT-OSS 一族,Llama、Qwen、Mistral 等系列是否能复用 QAH 还需要社区复现。
- 不是所有指标都赢。MMLU-Pro 和 SciCode 两项仍输给同尺寸完整版,说明"知识广度"和"科学编码"还是被压缩伤了。QAH 不是万能药,而是"长上下文 + 数学 + Agent"这几条主战场的强效药。
它最适合什么场景
强推荐:
- 本地 Agent 部署:想用 120B 量级模型搭 Coding Agent,又不想走云服务
- 长上下文应用:法律合同分析、长 PDF 总结、长代码库理解
- 数学与编程任务:AIME/数学竞赛、Agent 编程、LiveCodeBench 类硬骨头
- 教育/科研 Apache 2.0 可商用,本地部署避免数据外泄
慎用:
- 纯知识广度检索:MMLU-Pro 略输,需要知识密集的问答可能不如同尺寸 BF16
- 科学代码生成:SciCode 略输,研究类代码可能需要其他方案
- 绝对精度上限场景:如果已有 H100/H200 集群跑 120B 完整版,没必要换 QAH
延伸阅读
- Hugging Face 官方博客:Quantization-Aware Healing: a compressed, 4-bit model that outperforms its full-precision original
- 开源权重:MultiverseComputingCAI/Hypernova-60B-2605(Apache 2.0)
- Multiverse Computing 主页:multiversecomputing.com
- 关联技术阅读:Quantization-Aware Distillation(QAD)的局限、FSDP2 vs DeepSpeed ZeRO-3 在 4-bit 蒸馏中的 8.6 分差距(同论文的"隐藏发现")
微头条版(适合头条号/微头条发布)
"压缩必掉精度"——这条 AI 圈的老常识,被 Multiverse Computing 一刀切了。
2026 年 8 月 25 日,Hugging Face 官方博客放出 Multiverse 的 Quantization-Aware Healing(QAH)报告:他们把 OpenAI 的 GPT-OSS 120B 砍到 60B 参数,再压到 MXFP4(4-bit),9 项核心 benchmark,4-bit 版本赢了完整版 7 项。
数字最炸的三项:长上下文推理 +7.4、数学 +5.6、Agent 编程 +2.7。LiveCodeBench 直接跑出 66.5,反超完整版 120B 的 66.0。
为什么这次不一样?传统 healing 用"压缩版 60B bfloat16"当老师,学生学到 95 分就上不去了。QAH 改用"原版 120B 完整版"当老师——学生第一次能直接学到 100 分。压缩不再是损失,而是多了一轮训练信号。
实用价值更炸:参数砍半、内存 1/4,120B 模型第一次能在消费级显卡上跑。Apache 2.0 开源,权重已在 Hugging Face 上线。
你怎么看?4-bit 真的会取代 16-bit 吗?
知乎问答版
问:4-bit 量化的模型怎么可能比完整精度还强?Multiverse 的 QAH 到底改了什么?
答(一句话版):传统量化用"压缩版"当老师,4-bit 学生只能学到被砍过一刀的天花板;QAH 让"原版完整模型"直接当老师,4-bit 学生获得了原本不存在的"第二轮训练信号"。
完整论证:
传统做法的天花板问题:120B 模型先砍到 60B bfloat16,再量化到 4-bit,最后用 60B bfloat16 当老师做"恢复"。问题是:60B bfloat16 本身就是压缩后的"残本",logits 已经损失了一轮信息。学生只能逼近"残本",逼近 95 分就到顶。
QAH 的核心动作:把"老师"换回 120B 原版完整版。原版没经历压缩,logits 是完整 100 分的信号。4-bit 学生直接学到原版本来能学到的高度。
关键数据:9 项 benchmark 7 项赢同尺寸完整版(AA-LCR +7.4、AIME 2025 +5.6、Aider +2.7),LiveCodeBench 66.5 反超完整版 120B 的 66.0。
适用与不适用:
- 适用:本地 Agent 部署、长上下文、数学与编程硬骨头、教育/科研数据隐私
- 不适用:纯知识广度检索(MMLU-Pro 略输)、科学代码生成(SciCode 略输)、已有完整版 GPU 集群无需换
实用意义:4-bit 模型内存只要 1/4,120B 量级第一次能在消费级显卡跑。Apache 2.0 开源(
MultiverseComputingCAI/Hypernova-60B-2605),可商用。
核心观点:QAH 的颠覆不在"压缩更狠",而在"老师换回原版"——这是一个被低估的工程细节,也是开源社区都能复用的方法。
信源:Hugging Face 官方博客 2026-08-25;Multiverse Computing 公开技术报告;数据以原文为准。