Headroom
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../headroom-recommend.pptx../../headroom-recommend.mp4本文目录
📌 核心价值:让 Claude Code、Codex、Cursor 这些 AI 编程 Agent 的 token 消耗直降 60-95%,且本地运行、可逆检索、支持跨 Agent 共享记忆
一个 50K Star 的 Apache 2.0 开源项目,用 6 种压缩算法 + 本地代理 + MCP 服务器,给所有主流 AI Agent 套上一道"上下文压缩层"。
🚀 什么是 Headroom?
Headroom 是一个 AI Agent 上下文压缩层(Context Compression Layer),由 headroomlabs-ai 开源(Apache-2.0),GitHub 已获 50,103 Star / 3,514 Fork,主语言 Python,配套 Rust 核心 + TypeScript SDK。
它的核心使命很直接:在所有内容到达 LLM 之前进行智能压缩,减少 60-95% 的 token 消耗,同时不破坏答案质量。
支持 4 种部署形态:
- 📦 Library —
compress(messages)嵌入 Python / TypeScript 应用 - 🌐 Proxy —
headroom proxy --port 8787,零代码改动接入任何 LLM 客户端 - 🔌 Agent Wrap —
headroom wrap claude|codex|cursor|aider|copilot|opencode一行命令包装主流 Agent - 🛠️ MCP Server —
headroom_compress/headroom_retrieve/headroom_stats工具暴露给 MCP 客户端



核心定位:让每个调用 LLM 的 token 都花在刀刃上,本地压缩、可逆检索、多 Agent 共享,是 Claude Code / Codex 重度用户的省钱必备。
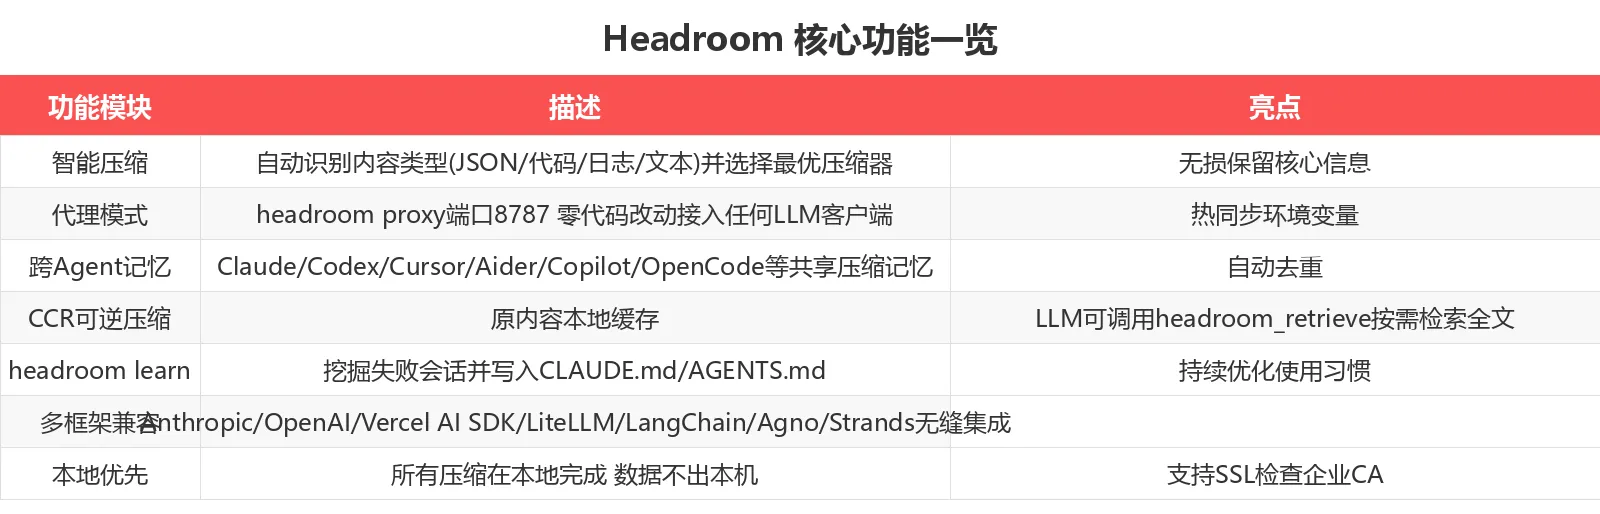
✨ 核心功能一览
🛠️ 快速上手:60 秒跑通示例
安装 / 部署
# Python 一键全装(含 ML、代码、MCP、图像压缩等所有可选依赖)
pip install "headroom-ai[all]"

# Node / TypeScript
npm install headroom-ai

# Docker
docker pull ghcr.io/headroomlabs-ai/headroom:latest
需要 Python 3.10+,可选 extras:[proxy] [mcp] [ml] [code] [memory] [relevance] [image] [agno] [langchain] [evals] [pytorch-mps]。
三种模式 60 秒接入
# 模式 1:包装 Claude Code(自动启动 proxy + 注入配置)
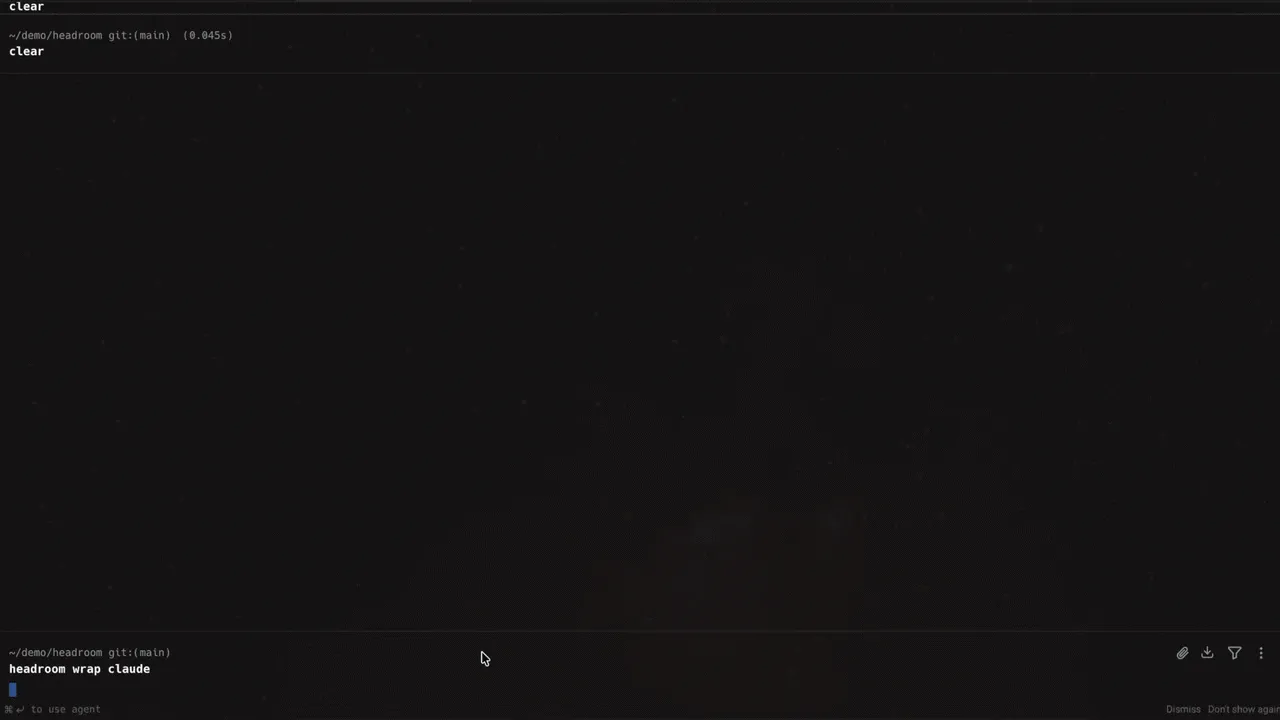
headroom wrap claude

# 模式 2:启动独立 proxy,零代码改动接入任何 OpenAI 兼容客户端
headroom proxy --port 8787

# 模式 3:作为 Python 库内联使用
python -c "from headroom import compress; print(compress([{'role':'user','content':'10144 token的日志...'}]))"
核心代码示例(库模式 + Python)
from headroom import compress
from headroom.providers.anthropic import AnthropicWithHeadroom

# 1. 库模式:直接压缩 messages
messages = [
    {"role": "system", "content": "You are a helpful coding assistant."},
    {"role": "user", "content": huge_tool_output},   # 10144 token 的工具输出
]
compressed = compress(messages, model="claude-sonnet-4")
# 压缩后仅 1260 token,节省 87%

# 2. Anthropic SDK 包装(透明压缩,无侵入)
client = AnthropicWithHeadroom()
response = client.messages.create(
    model="claude-sonnet-4",
    max_tokens=1024,
    messages=messages,
)

# 3. Vercel AI SDK 中间件模式
from headroom.integrations.vercel import headroomMiddleware
model = wrapLanguageModel({
    model: anthropic("claude-sonnet-4"),
    middleware: headroomMiddleware(),
})
注意:所有压缩都在本地完成(runs locally — your data stays here),原内容通过 CCR(Content-Coded Retrieval)缓存,LLM 可随时调用 headroom_retrieve 工具拉回全文,兼顾省 token 与不失真。
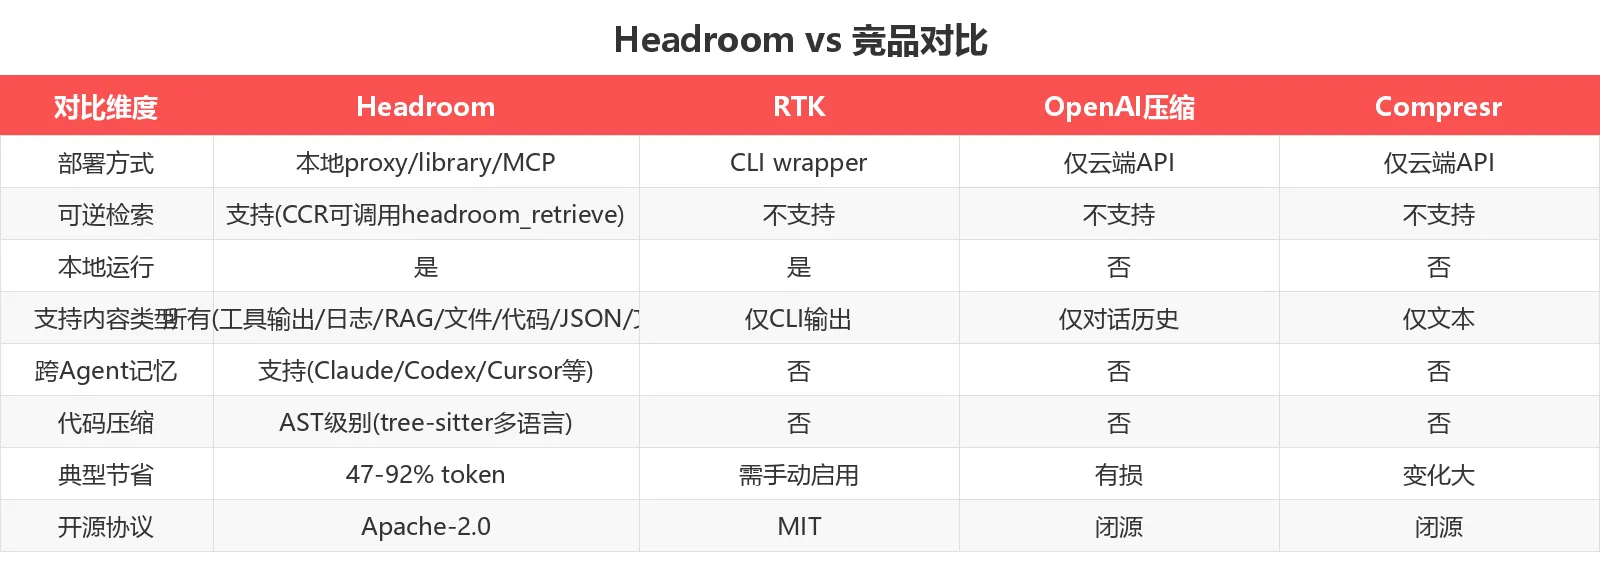
📊 与竞品对比
💡 适用场景
场景 1:Claude Code / Codex / Cursor 重度编程用户
功能说明:Headroom 自动识别工具输出、日志、代码 diff 等高 token 内容,路由到最优压缩器(JSON → SmartCrusher;AST 代码 → tree-sitter CodeCompressor;纯文本 → Kompress-base HuggingFace 模型),压缩比 47-92%。
输入要求:调用 Claude Code / Codex / Cursor / Aider / Copilot CLI / OpenCode 任一 Agent。
输出效果:单次工具调用的 token 消耗直降 90% 级别,月费账单砍半。
适用场景:每天跑 Claude Code 写代码 3 小时以上的开发者;用 Codex 做长任务自动化的团队;Cursor Pro / Business 订阅用户想再降一档费用。
场景 2:跨 Agent 共享记忆 + 失败学习
功能说明:headroom learn 插件会挖掘 Claude / Codex / Gemini 等 Agent 的失败会话,自动生成修正规则并写入 CLAUDE.md / AGENTS.md / GEMINI.md,下次同类型任务直接避开雷区。共享记忆 store 自动去重,跨 Agent 复用上下文。
输入要求:积累一定量历史 Agent 会话。
输出效果:新会话自动加载历史经验,无需手动 prompt 提示约束。
适用场景:多 Agent 协作团队;长期维护复杂代码库;希望把"个人习惯"沉淀为"团队规范"的工程团队。
场景 3:实时节省效果仪表盘
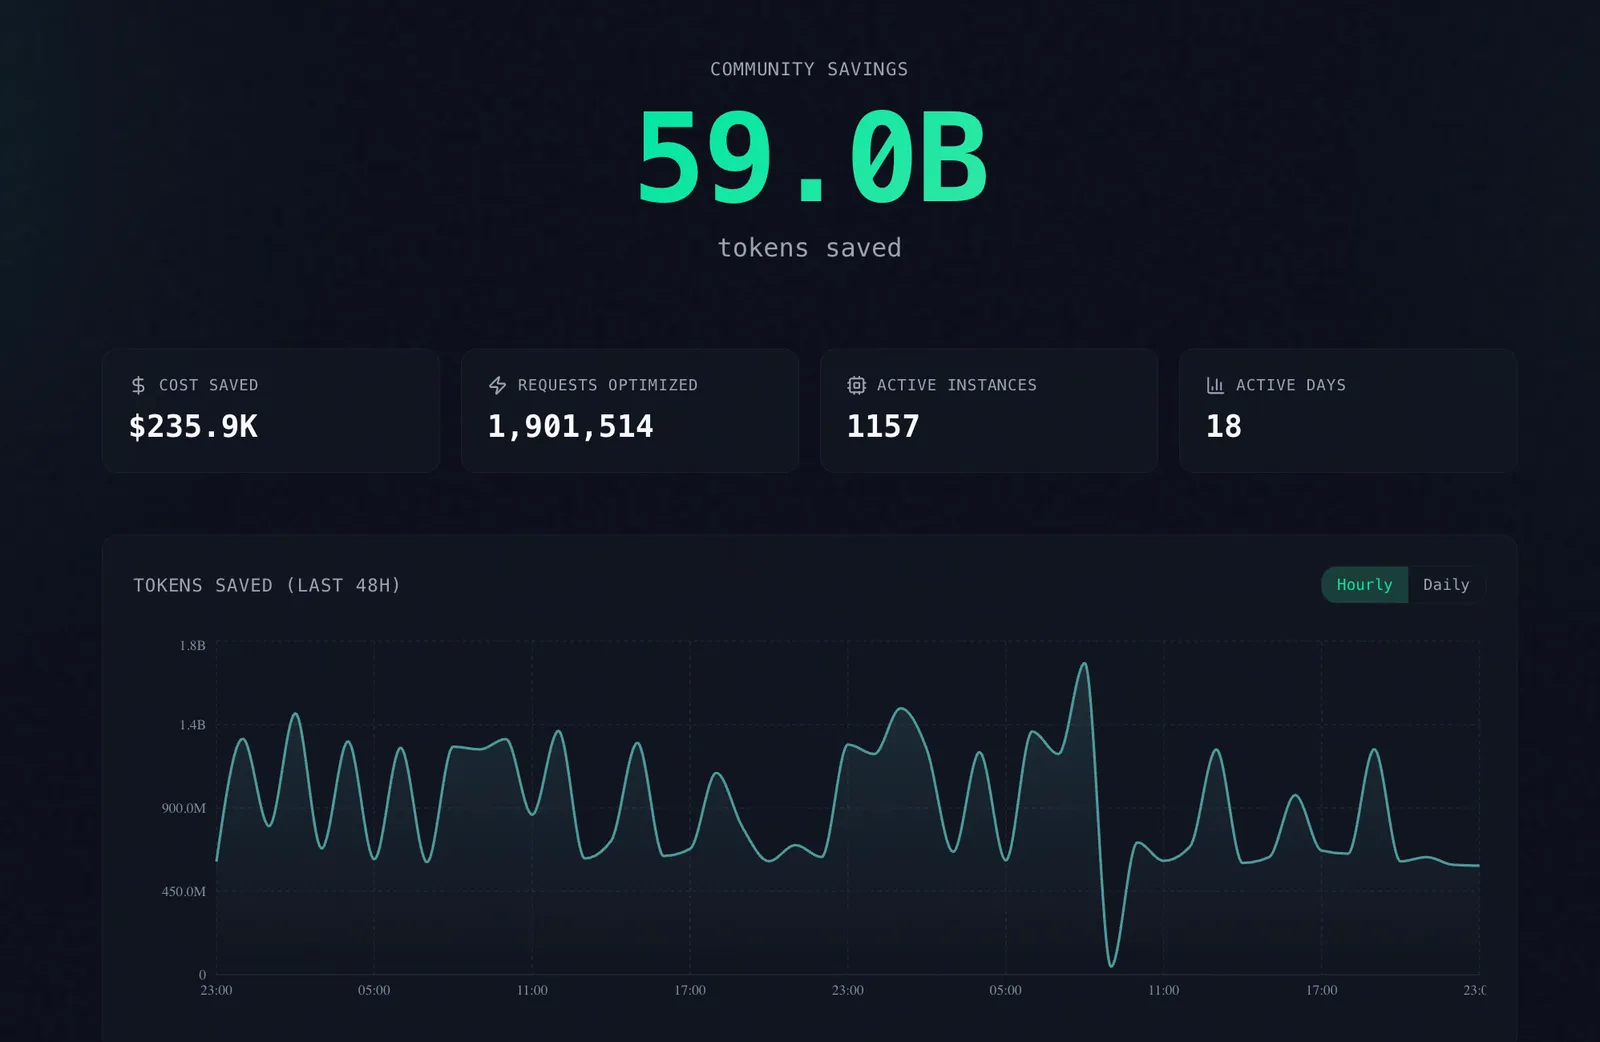
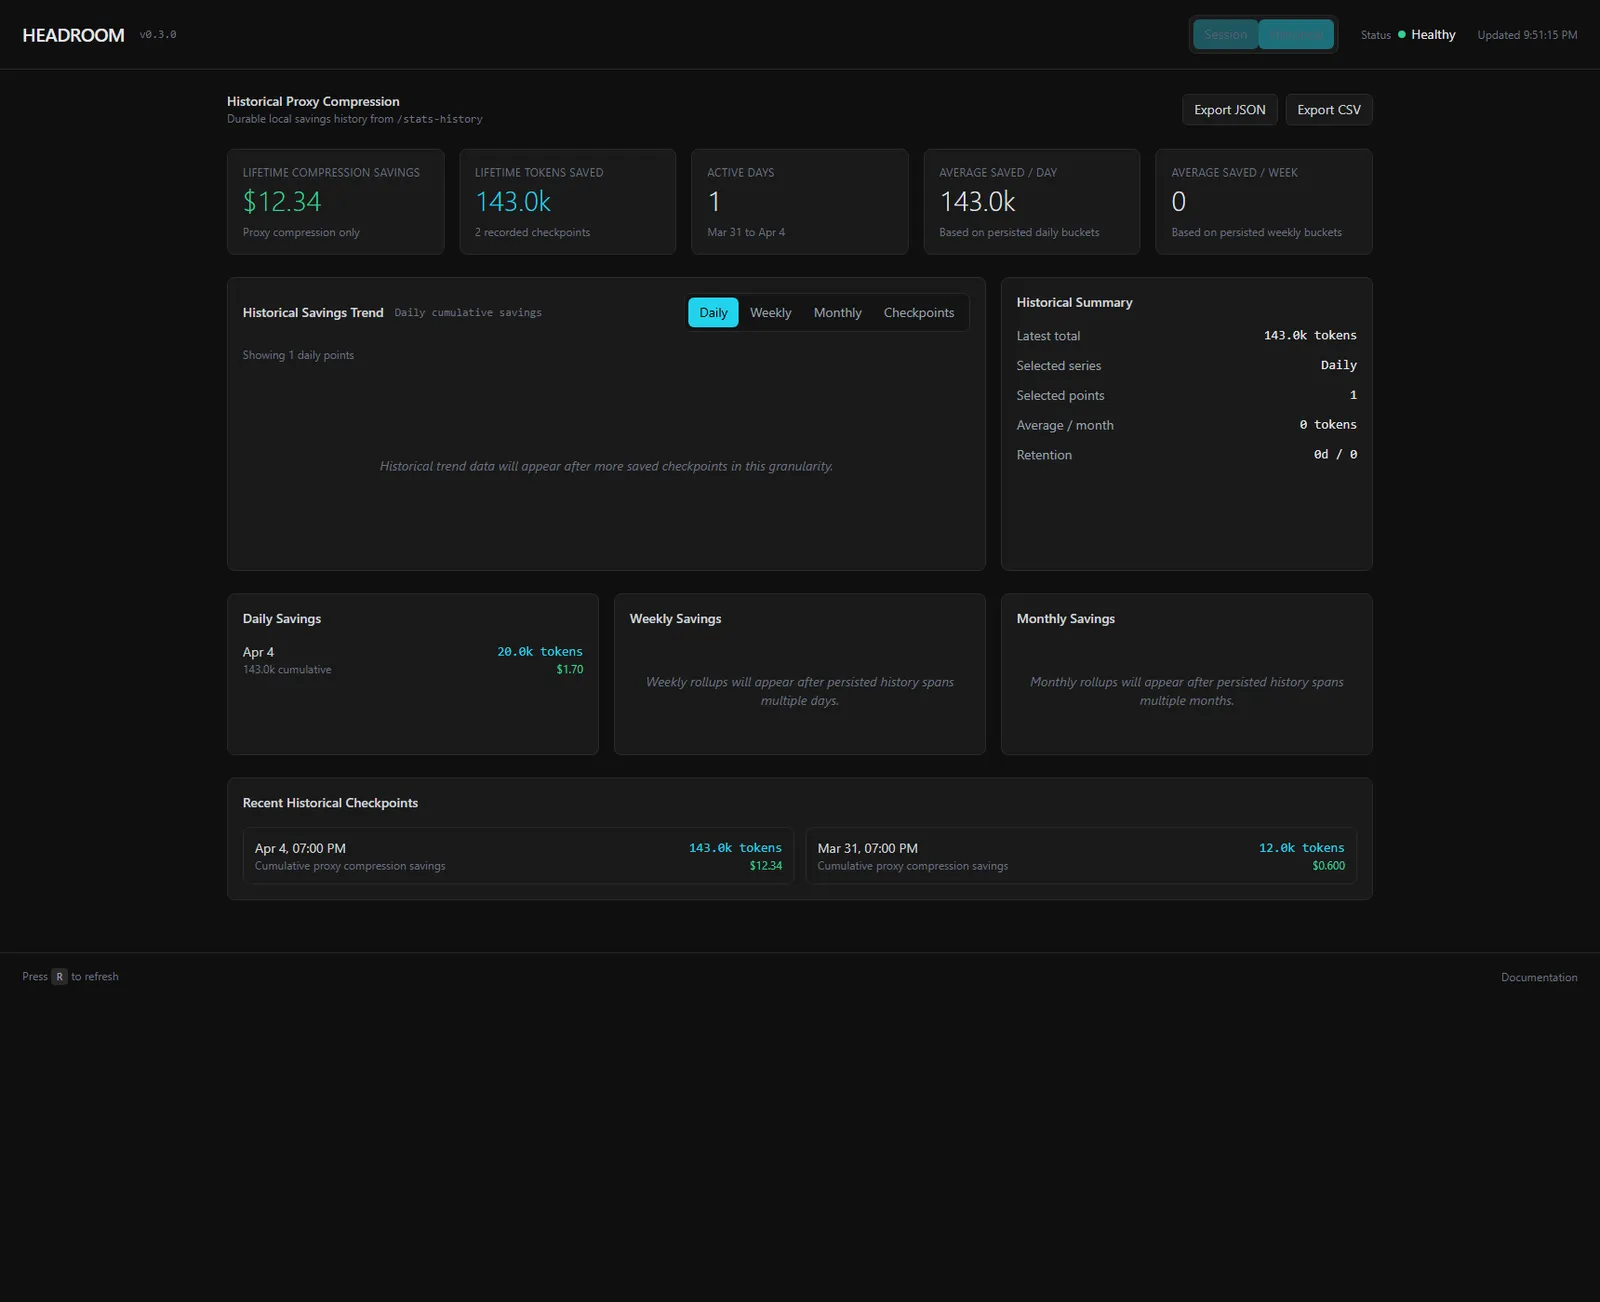
功能说明:启动 headroom dashboard 后可在浏览器实时查看 token 节省曲线、压缩比、命中率、缓存 TTL 等关键指标,所有指标按 Agent / 模型 / 内容类型维度聚合。
输入要求:proxy 模式运行 ≥ 1 小时。
输出效果:明确知道"这个月省了多少美元",量化投入产出比。
适用场景:企业 IT 评估 LLM 成本优化方案;个人用户追踪月度预算;技术博主录制"省 token 实测"素材。
场景 4:CCR 可逆压缩(兼顾省 token 与不失真)
功能说明:CCR(Content-Coded Retrieval)会在压缩时为原内容生成 <<ccr:HASH>> 短标记,LLM 需要看全文时可调用 headroom_retrieve(hash=...) 工具即时拉回。真正做到"省 token 但不失真",区别于 OpenAI / Anthropic 自带的"对话历史压缩"那种有损方案。
输入要求:使用 MCP 模式或 Python 库模式集成。
输出效果:模型既能享受压缩的成本优势,又能在关键判断时看到完整原文。
适用场景:金融/医疗/法律等不容许信息损失的领域;RAG 检索场景需要"召回精确"又"成本可控"。
用户群体总结
- ✅ AI 编程 Agent 重度用户:Claude Code / Codex / Cursor / Aider 每天 ≥ 3 小时
- ✅ 多 Agent 协作团队:希望 Claude、Codex、Cursor 之间共享记忆
- ✅ 企业 LLM 成本优化负责人:需要在不换模型的前提下把月度账单砍半
- ✅ RAG / 长上下文应用开发者:CCR 可逆压缩同时满足精度与成本
- ❌ 不推荐:只用单一厂商原生对话历史压缩、不需要跨 Agent 共享的用户
💰 定价方案
| 模式 | 费用 | 说明 |
|---|---|---|
| 开源 Apache-2.0 | 完全免费 | 自托管,无功能限制 |
| pip / npm / Docker | 免费 | 直接安装,无任何云依赖 |
| 企业级(ENTERPRISE.md) | 联系商业 | SLA、技术支持、私有部署 |
开源协议: Apache-2.0
💡 新用户福利:直接 pip install "headroom-ai[all]" 就能用,所有高级功能(CCR、MCP、跨 Agent 记忆、headroom learn)默认开启,没有任何"专业版"限制。
🎯 总结
Headroom 解决了一个所有 AI Agent 用户都头疼的问题:token 消耗失控。无论是 Claude Code 一晚上烧掉 50 美元,还是 Codex 长任务把月度预算吃光,Headroom 都能在不动一行现有代码的前提下,把 token 消耗砍到原来的 1/10 到 1/2。
它最大的差异化在于:本地运行 + 可逆检索 + 跨 Agent 共享记忆,这三件组合在一起,是目前任何云端压缩服务(Compresr、Token Co.)都做不到的。
推荐指数: ⭐⭐⭐⭐⭐(满分 5 星)
适合人群: AI 编程 Agent 重度用户 / 多 Agent 协作团队 / 企业 LLM 成本优化负责人 / RAG 开发者
立即体验: Headroom 官网
GitHub 仓库: headroomlabs-ai/headroom
PyPI 包: headroom-ai
npm 包: headroom-ai
数据截至 2026-06-25,最新信息请以官网为准。