智谱没换发动机,只靠后训练把编程顶高 50%:GLM-5.3 凭什么让硅谷紧张
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../glm-5.3-recommend.pptx../../glm-5.3-recommend.mp4本文目录
智谱没换发动机,只靠后训练把编程顶高 50%:GLM-5.3 凭什么让硅谷紧张
当所有厂商都在卷"更大的模型",智谱做了一件反常识的事——它把同一台发动机,转速压榨到了新高度。
8 月中旬,智谱发布了 GLM-5.3。最反常识的一点:它的基座模型,和半年前的 GLM-5.2 完全一样。7430 亿总参数、400 亿激活的 MoE 架构,1M 上下文窗口,一个字节都没换。所有提升,全来自后训练。
结果呢?编程能力相对前代提升约 50%,在 Terminal-Bench 3.0 上拿下开源第一;更离谱的是,发布当天,它在一个叫 Cursor 的 AI 编辑器里翻出了一个"可能很严重的漏洞"。
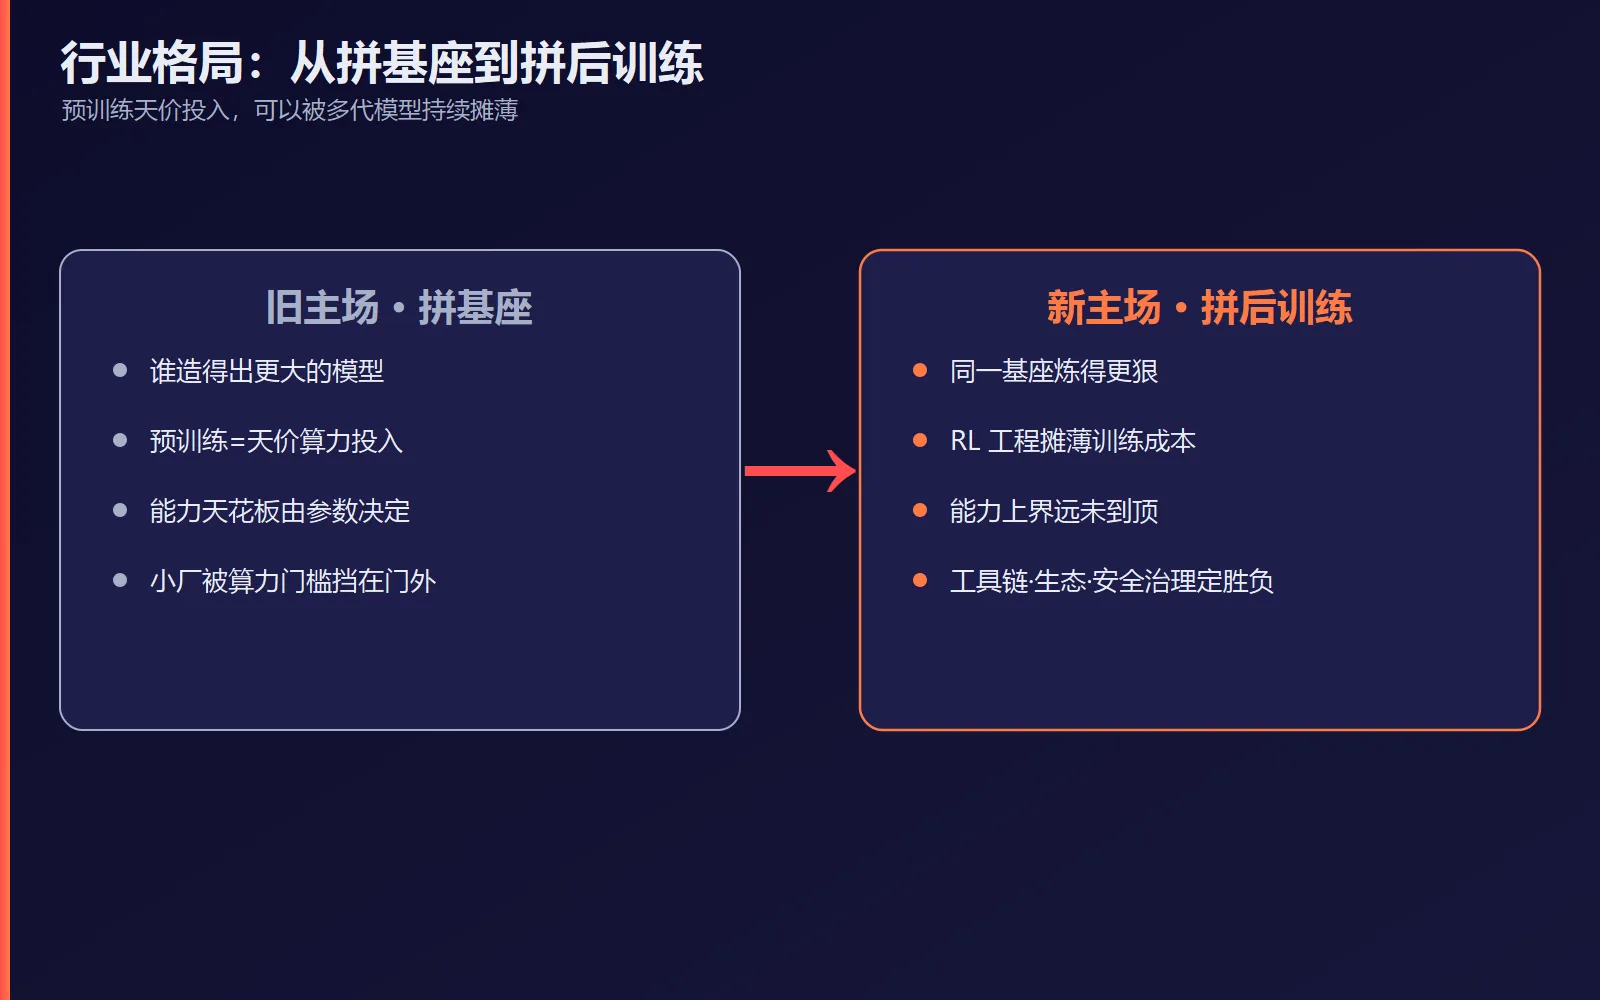
这背后藏着一个比跑分更值得聊的信号:开源大模型的竞争主轴,正在从"谁造得出更大的基座",切换到"谁更会把同一个基座炼得更好"。
为什么这篇值得写
过去一年,国产开源模型密集爆发:Qwen、DeepSeek、Kimi、Muse Glimmer……数字一个比一个吓人,但已经很难再让人尖叫。真正变化的,是"能力从哪来"。
GLM-5.3 把这件事讲得最直白:预训练那一次天价投入,可以被多代模型持续摊薄。对于深陷算力成本焦虑的厂商,这是一条重要参照——消化训练成本的路径,不只有涨价。
先看图:GLM-5.3 速览
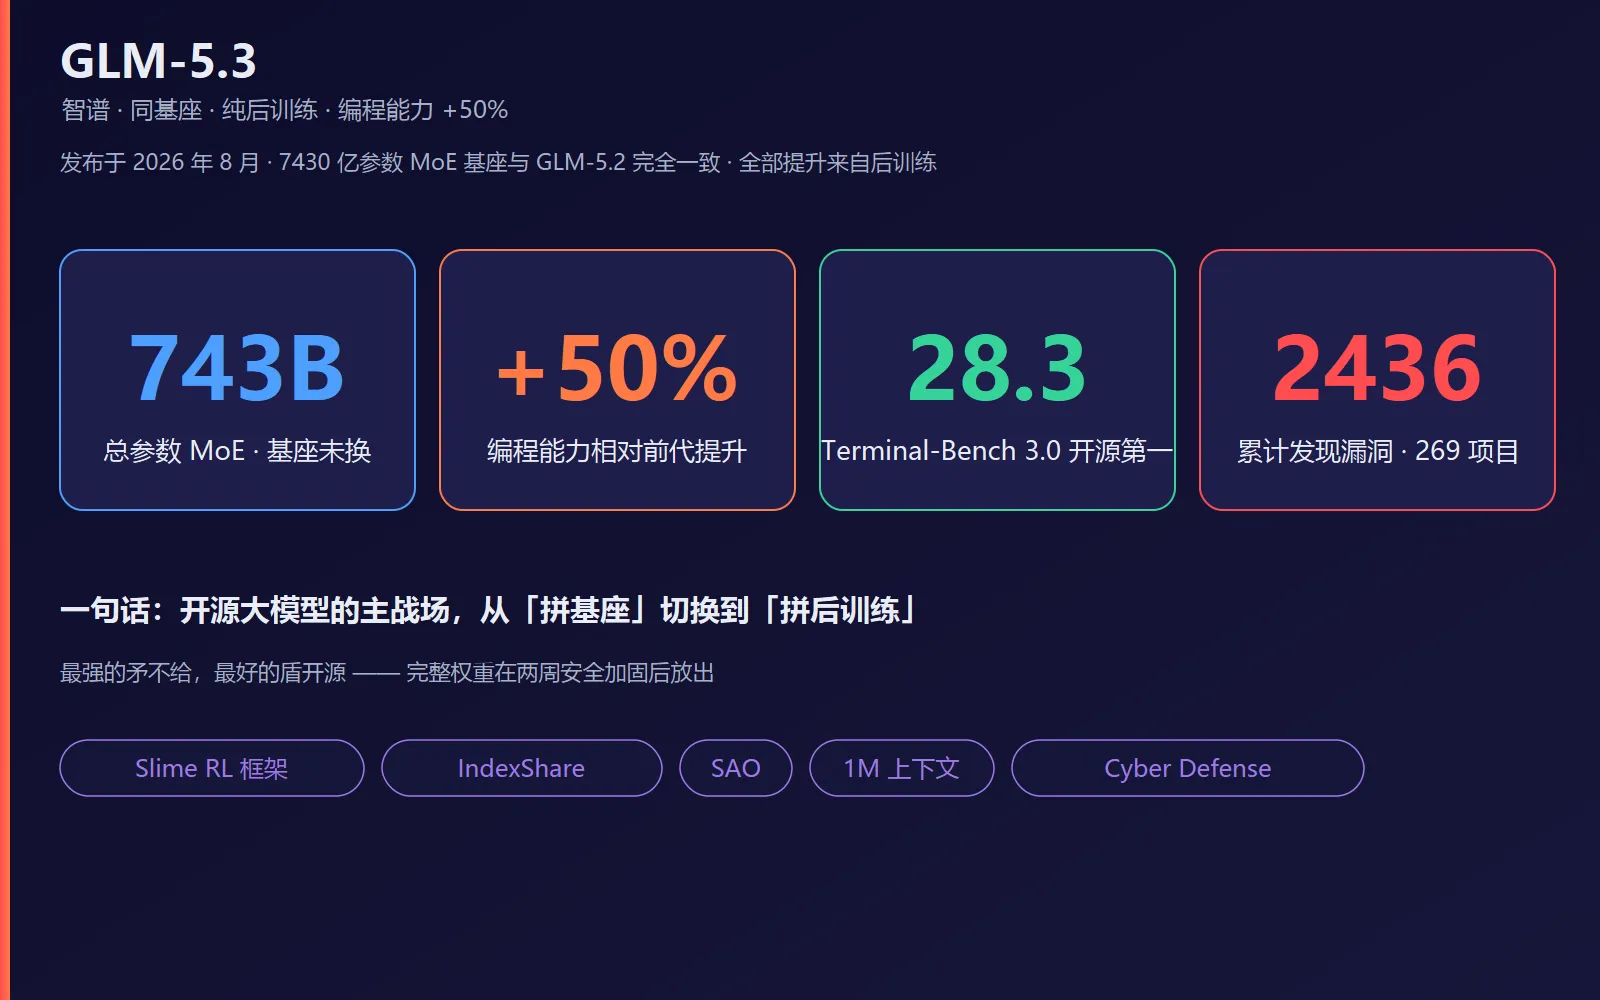
反常识:没换发动机,只换"炼法"
智谱官方的表述很克制:"基于 IndexShare、SAO 以及持续演进的新一代 Slime 框架,我们在与 GLM-5.2 完全相同的基座上高效推进强化学习。可能我们还远未开发出这个基座的智能上界。"
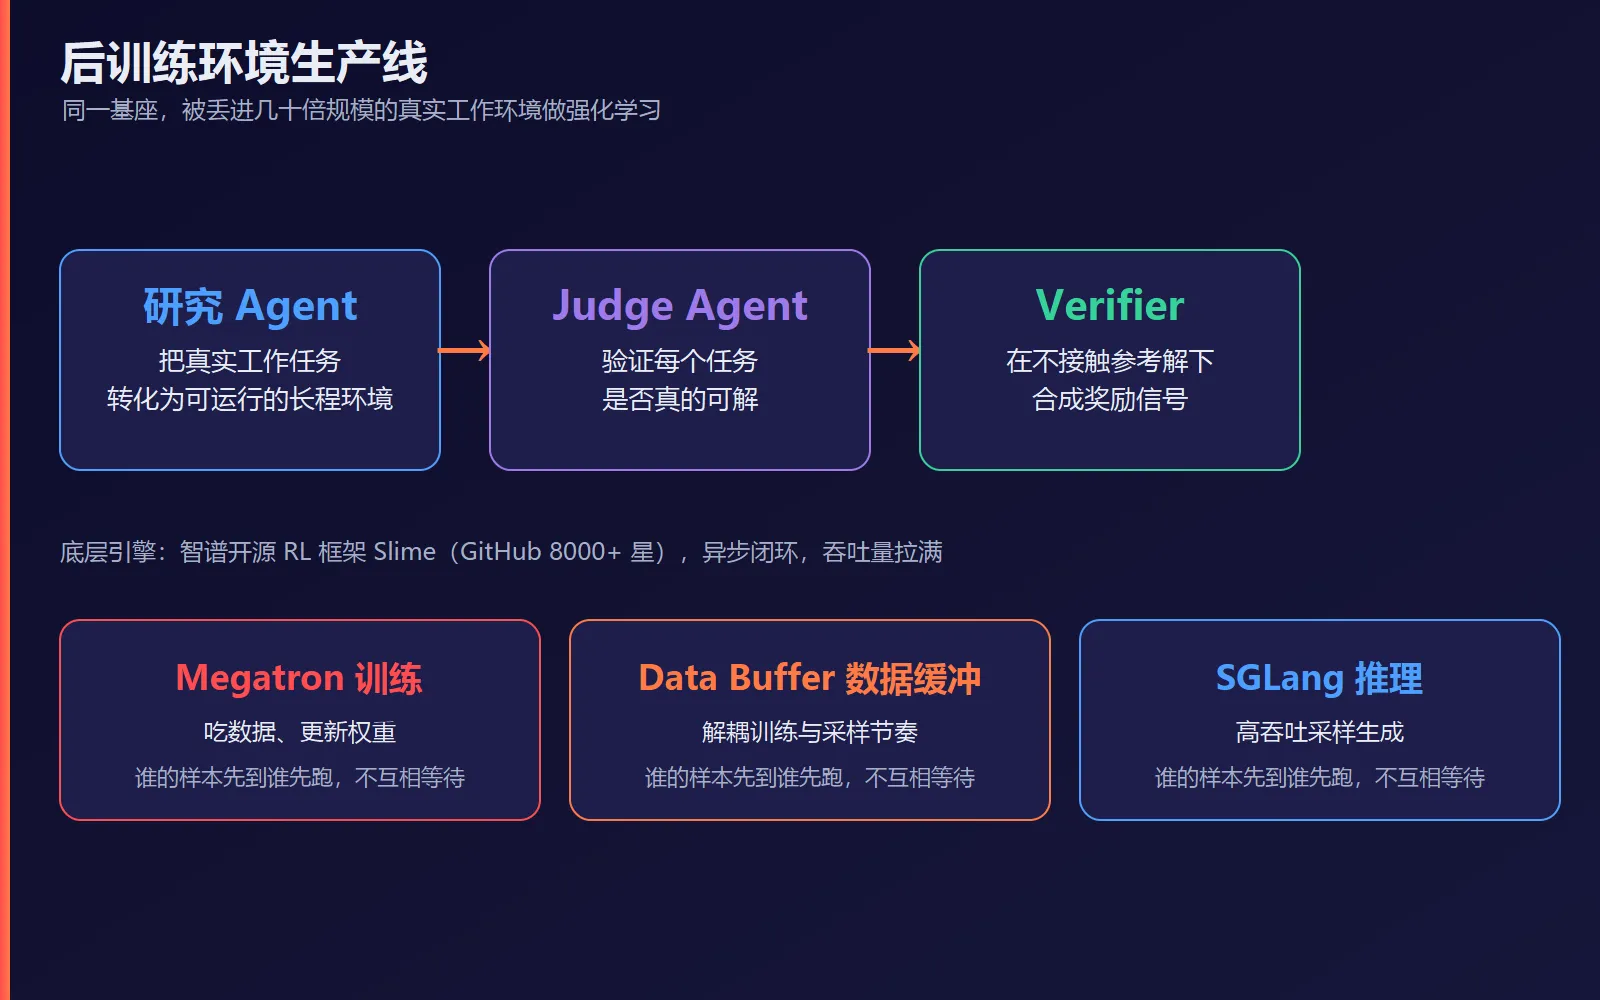
翻译成人话:他们没换发动机,而是把同一台发动机丢进几十倍规模的"真实专家工作环境"里做强化学习。以前练的是教科书式编程题,现在练的是"一个有经验的工程师要干好几天的活"——真实的算力集群、存储系统、内部文档、代码库、实验结果,全给你。
支撑这套训练的是智谱开源的 RL 框架 Slime(THUDM/slime,GitHub 8000+ 星)。它的核心设计是打通两条链路:Megatron 训练 + SGLang 推理,中间用一个 Data Buffer 解耦。训练和采样不用同步等待,谁的样本先到谁先跑,吞吐量直接拉满。
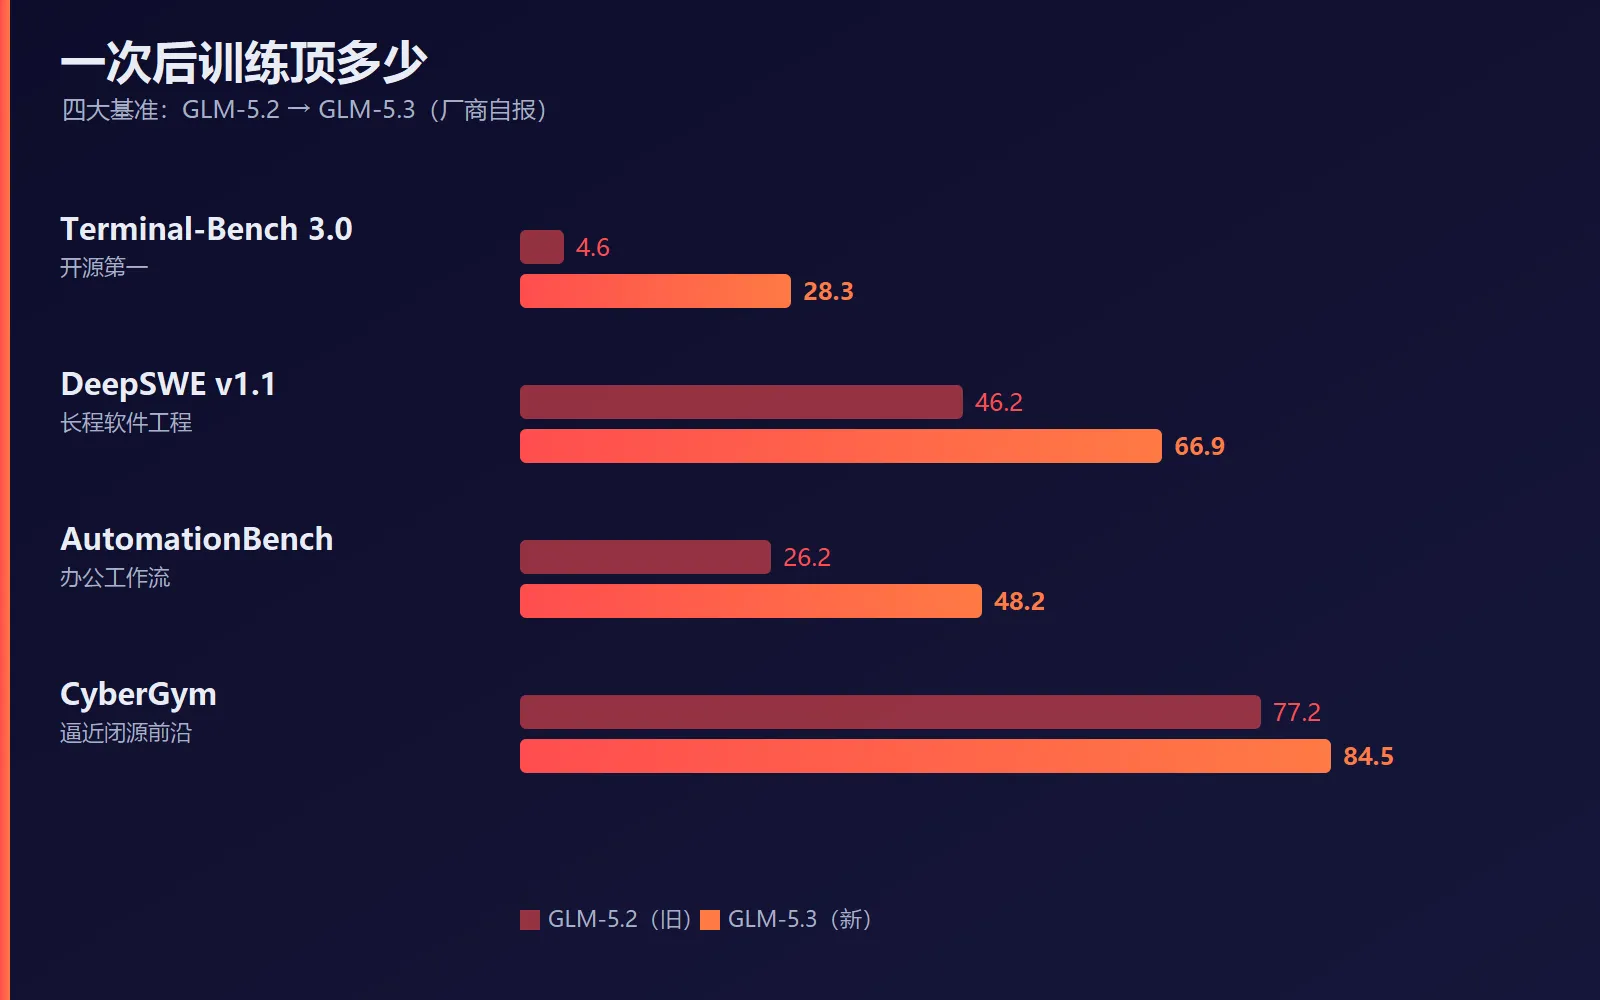
数字会说话:一次后训练顶多少
| 基准测试 | GLM-5.2 | GLM-5.3 | 含义 |
|---|---|---|---|
| Terminal-Bench 3.0 | 4.6 | 28.3 | 真实终端复杂任务,开源第一 |
| DeepSWE v1.1 | 46.2 | 66.9 | 长程软件工程 |
| AutomationBench | 26.2 | 48.2 | 真实办公工作流 |
| CyberGym(漏洞发现) | 77.2 | 84.5 | 逼近闭源前沿 |
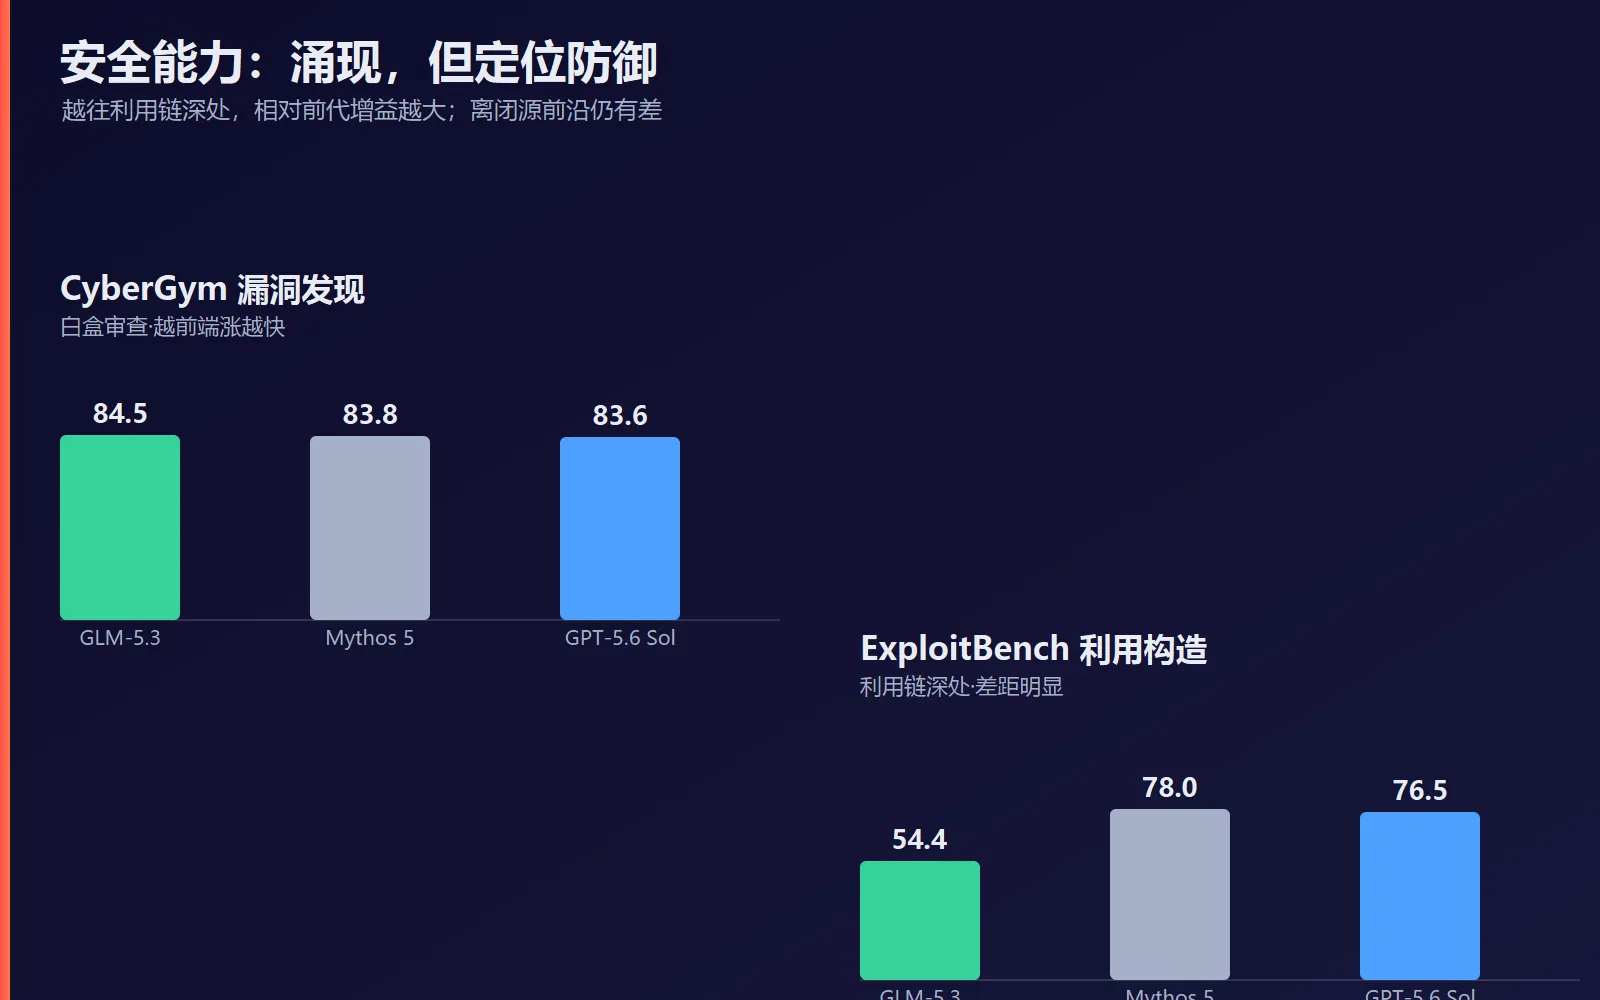
注意 CyberGym 这一行:84.5%,超过了 GPT-5.6 Sol 的 83.6% 和 Mythos 5 的 83.8%。这是白盒代码审查和漏洞发现,属于安全能力的前端。
3 分钟上手:调用就是 OpenAI 兼容
GLM-5.3 首发通过智谱官方编程工具 ZCode、GLM Coding Plan 与一批编码平台(Trae、扣子、CodeBuddy、Qoder 等)开放抢先体验,API 即将上线。接口走 OpenAI 兼容协议,但有一个迁移坑:thinking 不能关闭,应用必须显式设置推理强度。
from openai import OpenAI

# GLM-5.3 走 OpenAI 兼容协议,base_url 指向智谱
client = OpenAI(
    api_key="YOUR_ZAI_KEY",
    base_url="https://api.z.ai/v1",
)

resp = client.chat.completions.create(
    model="glm-5.3",
    messages=[{"role": "user", "content": "审查这段代码是否存在权限校验缺陷"}],
    # GLM-5.3 强制要求设置推理强度,不能关闭 thinking
    extra_body={"reasoning_effort": "medium"},
)
print(resp.choices[0].message.content)
最炸裂的剧情:发布当天,它黑了 Cursor
8 月发布当天,z.ai 开发者布道师 Lou 在 X 上发了一条推文:他们给 GLM-5.3 一个复杂的逆向工程任务,结果它翻出了一个"可能很严重的 Cursor 漏洞",已经私下披露,Cursor 团队正在配合修复。
Cursor 不是小众玩具——2026 年 6 月,SpaceX 以 600 亿美元全股票收购了它的母公司 Anysphere,当时 Cursor 有超过 100 万付费用户、40 亿美元 ARR。一个被装进无数生产环境的工具,被一个国产开源模型在发布当天挖出漏洞,这事谁能想到?
更吓人的是战报。智谱联合清华、南开等十余支安全团队,从 GLM-5.2 时代就开始用模型扫真实开源项目。一个多月下来,累计发现 2436 个漏洞,涉及 269 个项目,其中 1097 个中高危。最老的一个漏洞写于 1981 年,在代码里躺了 45 年。
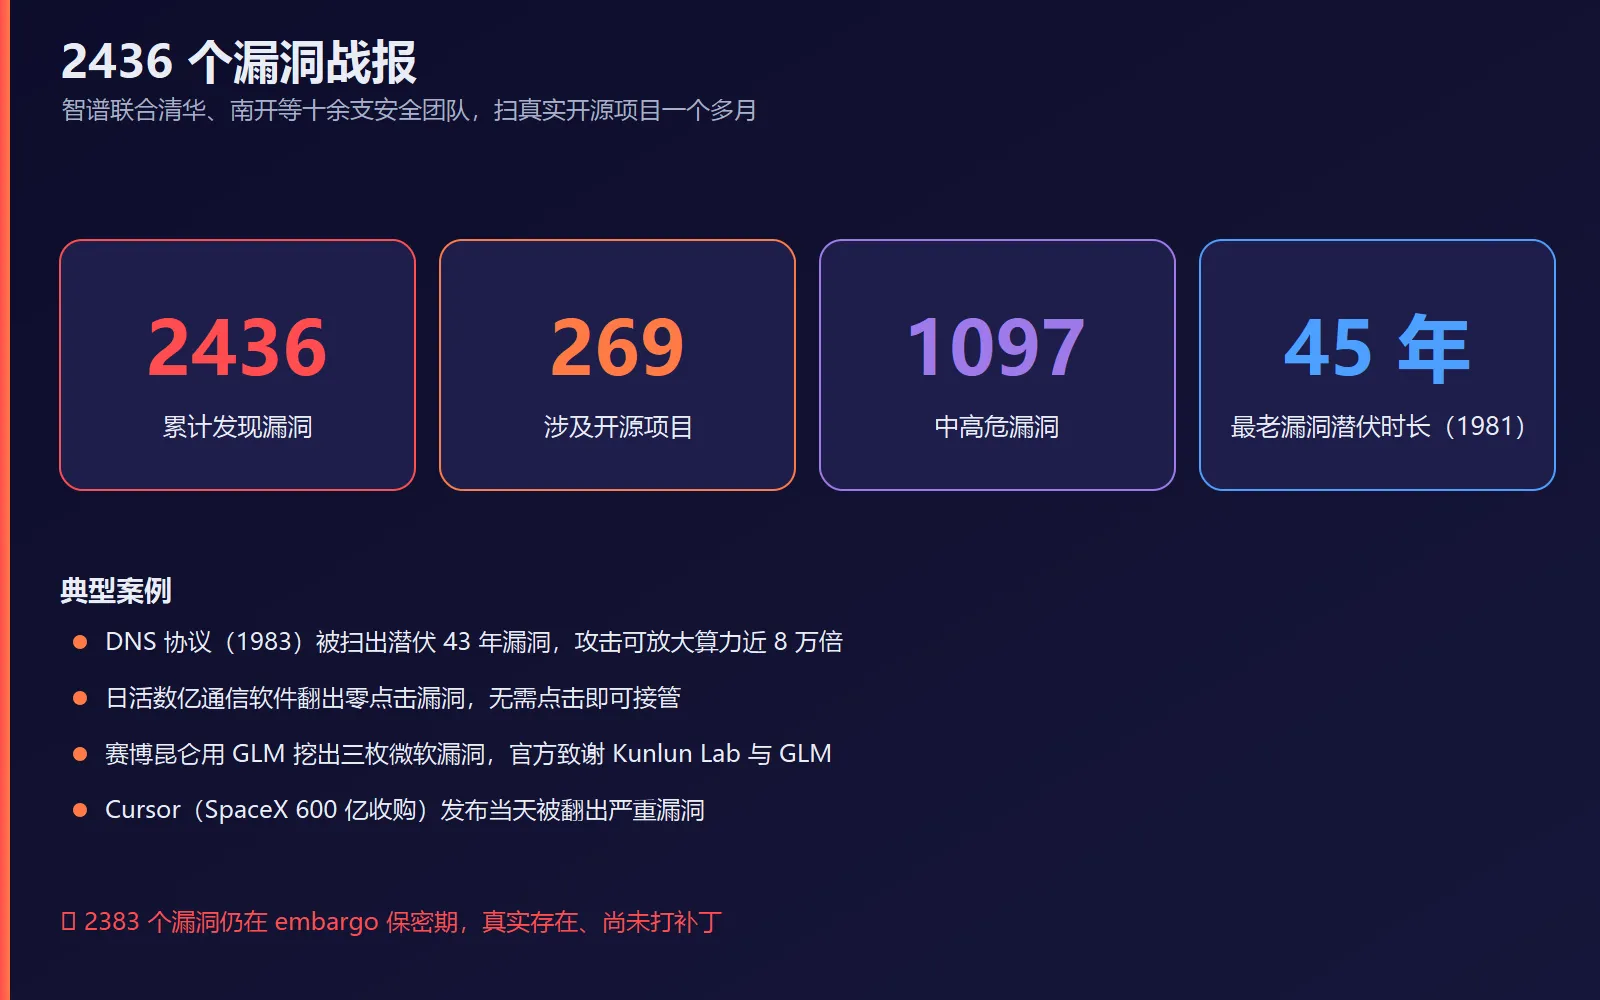
这里面有几个案例:DNS 协议(诞生于 1983 年)被扫出一类潜伏 43 年的漏洞,攻击者可把服务器计算压力放大近 8 万倍;一款日活数亿的通信软件被翻出零点击漏洞;赛博昆仑用 GLM 一口气挖出三枚微软漏洞,官方致谢"Kunlun Lab & GLM"。
为什么安全能力会"涌现"
关键洞察:智谱在后训练里加入漏洞发现的数据和环境时,预期只是让模型更会找单个漏洞。结果模型不只会找孤立缺陷了,开始跨多个攻击阶段推理,形成完整攻击链的连贯计划。能力在利用链越深的地方涨得越快——这不是工程师计划出来的,是练着练着冒出来的。
评测印证了这个规律:越往利用链深处走,GLM-5.3 相对 5.2 的增益越大。但离闭源前沿的差距也越大——ExploitBench(利用构造)上它 54.4%,Mythos 5 是 78%。这个分布恰恰自洽:GLM-5.3 的定位是"ready for cyber defense"(为网络防御而生),不是"best at offense"(最擅长进攻)。
双刃剑:最强的矛不给,最好的盾开源
2436 个漏洞里有 2383 个还在 embargo 保密期,真实存在、尚未打补丁,分布在 Linux 内核、WebKit、FreeBSD、浏览器引擎里。
一个能发现漏洞、还能跨阶段推理攻击链的模型,权重落到谁手里都行。这种双刃剑属性,逼着智谱改了发布节奏:GLM-5.3 完整权重要等两周后的安全评估和加固完成才开源——这是 GLM 系列第一次为了安全审查推迟权重发布。同时配套"Cybersecurity Trusted Access"验证用户机制、分级限流。
格局上更值得玩味:两个月前 Anthropic 放出 Claude Mythos,目前最强的 AI 漏洞猎手,但只对约 150 家大型机构开放。攻击者拿 AI 找漏洞不需要任何人批准,防御者想用同等能力的 AI 来守,得先挤进那 150 家的名单。全球 5000 万中小企业、4 亿个开源项目,统统排不上号。
GLM-5.3 把"开源的防御之盾"这件事,第一次摆到了台面上。
本文重点回顾
- 同一基座 + 极致后训练,编程能力 +50%,Terminal-Bench 3.0 开源第一
- 安全能力是后训练"涌现"的,越往利用链深处涨得越快
- 发布当天发现 Cursor 严重漏洞,累计战报 2436 个漏洞
- 开源大模型竞争主轴:从拼基座,切换到拼后训练工程
- 双刃剑属性让智谱首次推迟权重开源,先加固再开放
一句话结尾
当模型能力被后训练工程逐渐抹平,下一次竞赛的赛点,不在谁的模型更大,而在谁把同一个基座炼得更狠、更稳、更安全。